
深入讲解JavaScript获取URL查询参数的现代与兼容实现方案,详细剖析中文乱码产生的底层机制,并提供针对加号空格、二次编码及URIError异常的完整解决策略与生产级封装函数。

当前位置:首页 > JavaScript 基础 > 正文
JS获取URL参数并解决中文乱码问题
作者:异步漫步
时间:2026-11-16
浏览:668
文章目录
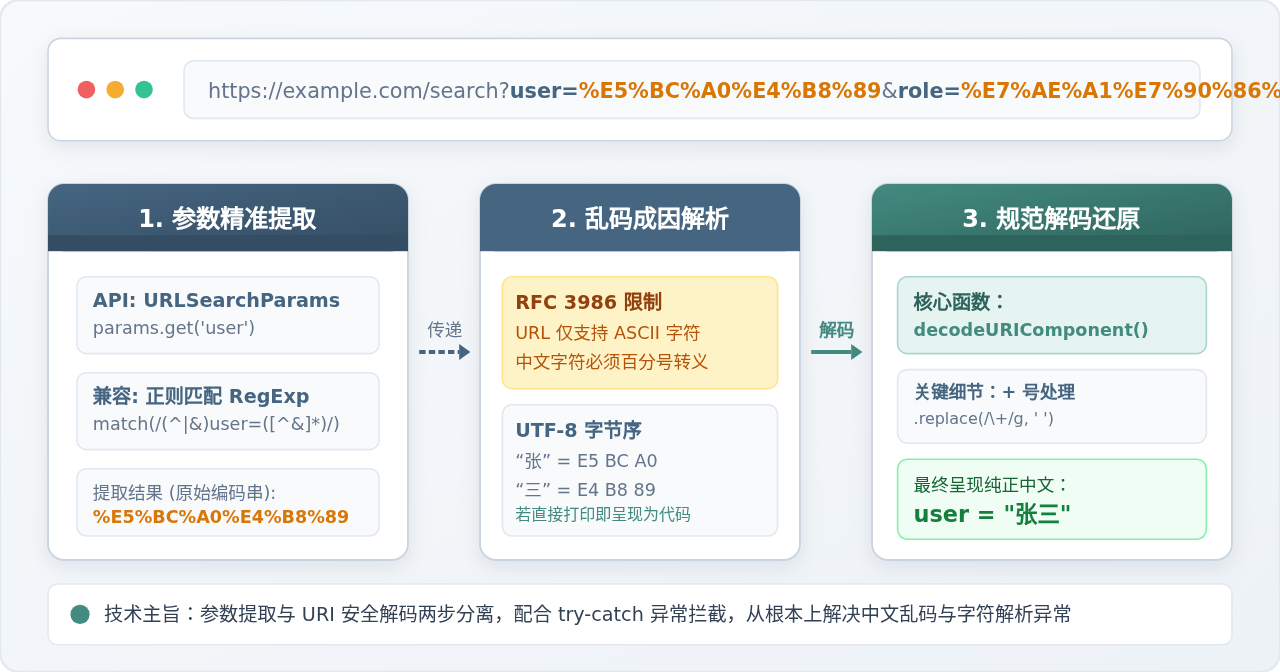
在 JavaScript 中获取 URL 查询参数最直接的方法是使用原生 URLSearchParams 接口,若需兼容旧版本浏览器则可通过正则表达式精准匹配。而参数中中文显示为 %E4%B8%AD%E6%96%87 或异常乱码的核心原因,是浏览器根据 RFC 3986 规范对非 ASCII 字符执行了 UTF-8 百分号编码(Percent-Encoding),但在脚本提取时未正确还原。解决中文乱码的标准做法是:在获取参数原始字符串后,先将代表空格的 + 号替换为普通空格,再通过 decodeURIComponent() 还原字符,并在外层使用 try...catch 防御畸形字符引发的 URIError。
一、URL 中文参数与乱码产生的底层原理
在深入编写代码之前,明确 URL 的字符规范能够帮助我们从根本上避开各种解码陷阱。根据统一资源标识符(URI)标准规范 RFC 3986,URL 中只允许包含无保留字符(字母、数字、-、_、.、~)以及部分具有特定语法的保留字符(如 ?、&、=、/)。
中文字符属于多字节的 Unicode 字符,超出了标准 ASCII 的表达范围。因此,当浏览器发送请求或在地址栏中构建带有中文参数的链接时,会自动将其转化为合法的百分号编码形式。以汉字“张三”为例:
- “张”在 UTF-8 编码下占用 3 个字节:
0xE5 0xBC 0xA0,在 URL 中表现为%E5%BC%A0; - “三”在 UTF-8 编码下同样占用 3 个字节:
0xE4 0xB8 0x89,在 URL 中表现为%E4%B8%89; - 因此
?user=张三实际传输的查询字符串为?user=%E5%BC%A0%E4%B8%89。
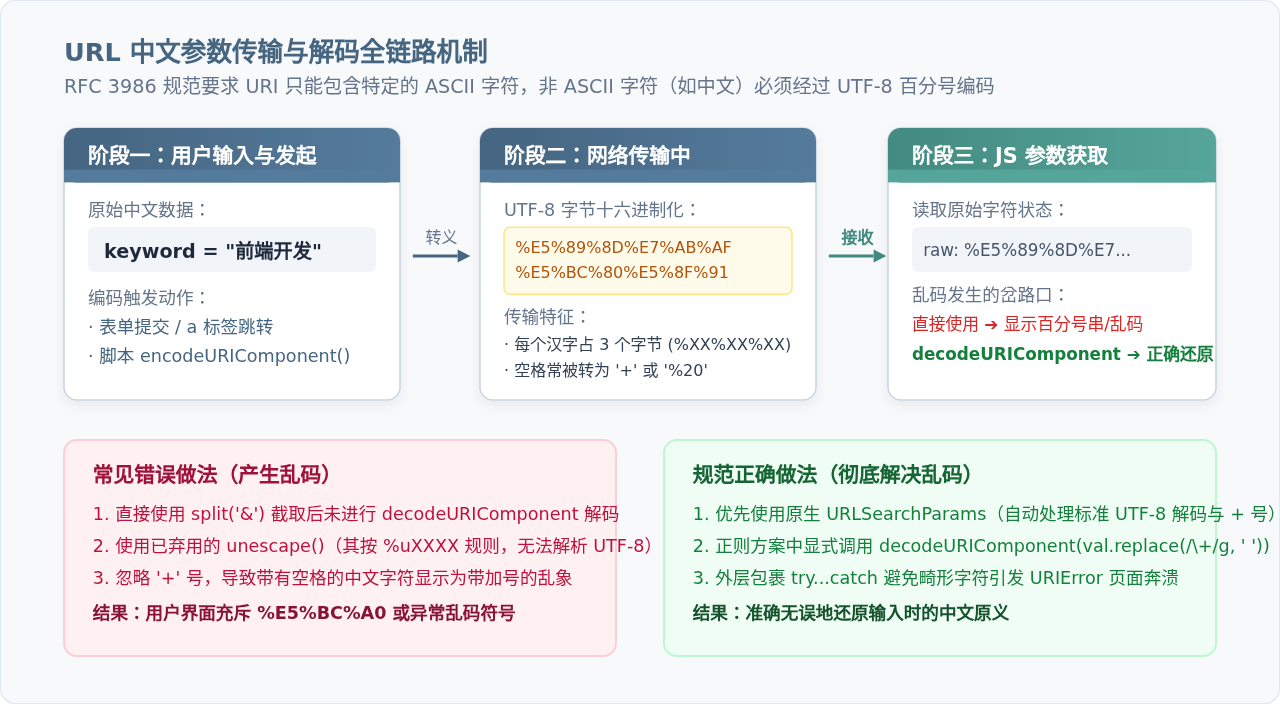
前端在处理 URL 参数时,中文乱码通常归结为以下四种具体场景:
- 未解码直接渲染:代码截取到了
%E5%BC%A0%E4%B8%89,但直接赋值给 DOM 节点,导致页面显示一串百分号代码。 - 加号未转为空格:按照
application/x-www-form-urlencoded规范,URL 查询参数中的空格常被编码为+。原生decodeURIComponent()不会将加号转换为空格,导致输出张+三。 - 二次编码(Double Encoding):在前端路由跳转或重定向过程中,如果上游调用了一次
encodeURIComponent,下游框架又调用了一次,参数值会变成%25E5%25BC...(%本身被转义为%25)。此时仅解码一次仍然会得到百分号编码串。 - 编码格式不一致:极少数旧系统采用 GBK 或 GB2312 编码服务端页面,其生成的十六进制字节流无法使用现代前端基于 UTF-8 的
decodeURIComponent解码,从而直接抛出运行时错误。
二、获取 URL 参数的三种实用方案
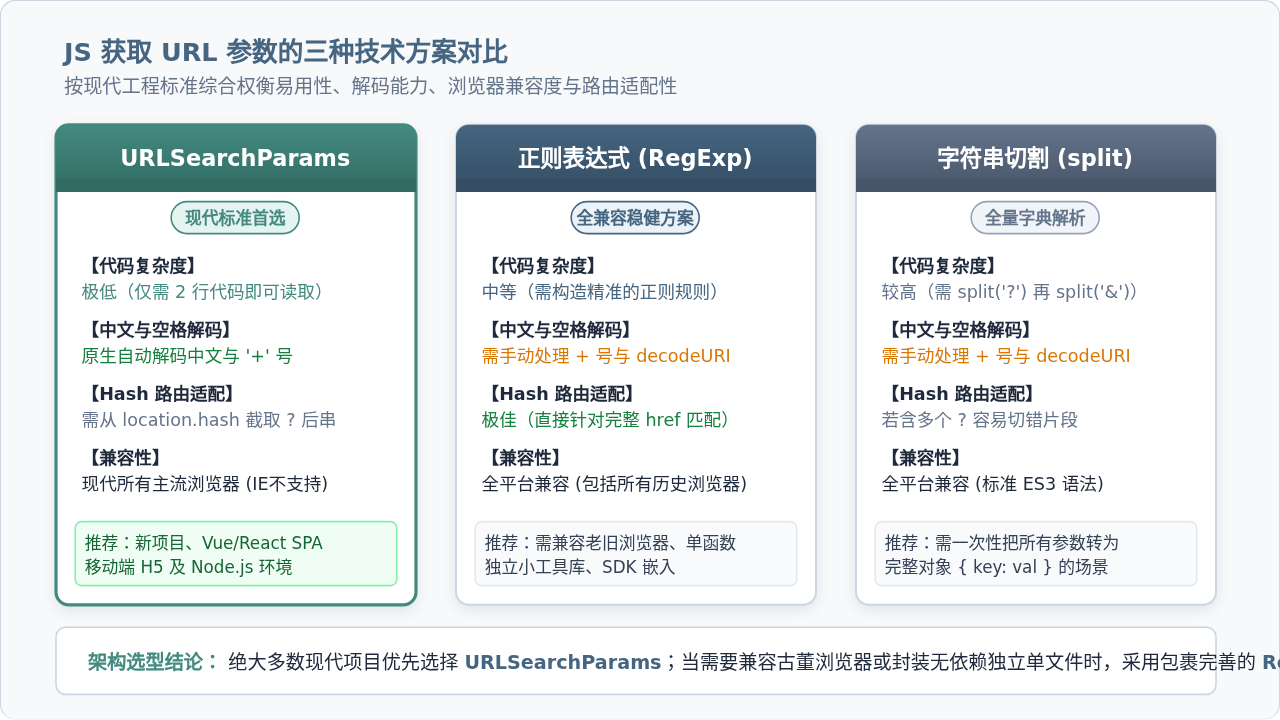
针对不同的工程环境(现代前端单页应用、旧系统维护、无框架轻量页面),获取 URL 参数主要有三种常用手段。
方案 1:现代浏览器原生 API —— URLSearchParams(首选)
URLSearchParams 是现代 Web 规范提供的标准查询参数解析接口。它不仅语法极其简洁,而且内置了对常规百分号编码与加号空格的自动解析机制。
// 假设当前页面完整地址为:https://example.com/index.html?name=%E5%BC%A0%E4%B8%89&city=%E5%8C%97%E4%BA%AC
const searchParams = new URLSearchParams(window.location.search);

// 获取单个参数(URLSearchParams 内部已完成 UTF-8 解码)
const name = searchParams.get('name');
const city = searchParams.get('city');

console.log(name); // 输出:"张三"
console.log(city); // 输出:"北京"

// 检查参数是否存在
if (searchParams.has('name')) {
  console.log('包含 name 参数');
}
单页应用(SPA)Hash 路由注意事项:
如果你的项目采用 Vue Router 或 React Router 的 Hash 模式(例如
https://example.com/#/detail?name=%E5%BC%A0%E4%B8%89),window.location.search 可能会是空字符串,因为 ? 位于 # 之后,被浏览器归类在 location.hash 内。此时需要从 location.hash 中截取:
const hashQuery = window.location.hash.split('?')[1] || '';
const params = new URLSearchParams(hashQuery);
方案 2:经典正则表达式提取(全兼容)
如果需要兼容不包含 URLSearchParams 的旧版宿主环境,或者希望封装一个不依赖任何外部对象的极小工具函数,正则表达式是最高效的选择。
function getParamByRegex(name, url = window.location.href) {
  // 构造匹配 key=value 的正规规则,兼顾 &、? 与行尾边界
  const reg = new RegExp('(?:[?&])' + name + '=([^&#]*)', 'i');
  const match = url.match(reg);

  if (!match) return null;

  // 提取原始字符串:注意正则抓出的是未解码的字符
  const rawValue = match[1];

  // 核心解决乱码与空格:1. 替换 + 为普通空格;2. 解码 UTF-8 字符
  try {
    return decodeURIComponent(rawValue.replace(/\+/g, ' '));
  } catch (e) {
    // 遇到非法畸形编码时,降级返回原始值,防止页面崩溃
    return rawValue;
  }
}
方案 3:全量字符串切割(split / 键值对字典)
当业务需要在页面初始化时将所有参数一次性解析为对象使用时,通过字符串切割是一种条理清晰的实现:
function parseAllParams(url = window.location.href) {
  const params = {};
  const queryString = url.indexOf('?') !== -1 ? url.split('?')[1].split('#')[0] : '';

  if (!queryString) return params;

  const pairs = queryString.split('&');
  for (let i = 0; i < pairs.length; i++) {
    if (!pairs[i]) continue;
    const parts = pairs[i].split('=');
    const key = parts[0];
    const val = parts.slice(1).join('='); // 防止参数值本身包含 '=' 字符

    try {
      params[key] = decodeURIComponent(val.replace(/\+/g, ' '));
    } catch (err) {
      params[key] = val;
    }
  }
  return params;
}
三、彻底解决中文乱码的关键步骤与避坑细节
获取到参数后,如何正确解码是决定中文能否正常呈现的核心。许多初学者常在此处遇到函数混淆或边界异常。
1. 认准核心解码函数:为什么必须是 decodeURIComponent?
JavaScript 历史上提供了三个相关的全局解码函数,但它们的分工与状态截然不同:
| 函数名 | 作用范围 | 中文解析能力 | 当前状态与建议 |
|---|---|---|---|
decodeURIComponent() |
解码单一查询参数组件(包括 &、=、中文等所有被编码符号) |
完美支持(按标准 UTF-8 序列解码) | 必须使用,获取单个参数的标准函数 |
decodeURI() |
解码完整 URI(保留 ?、&、= 等 URI 结构字符) |
支持中文,但跳过查询保留分隔符 | 仅用于解码整条完整网址,不适合解析具体参数值 |
unescape() |
早期的简单 ASCII / %uXXXX 转义解码 | 无法正确识别标准的 UTF-8 三字节序列 | 已严格废弃,会导致中文乱码,切勿使用 |
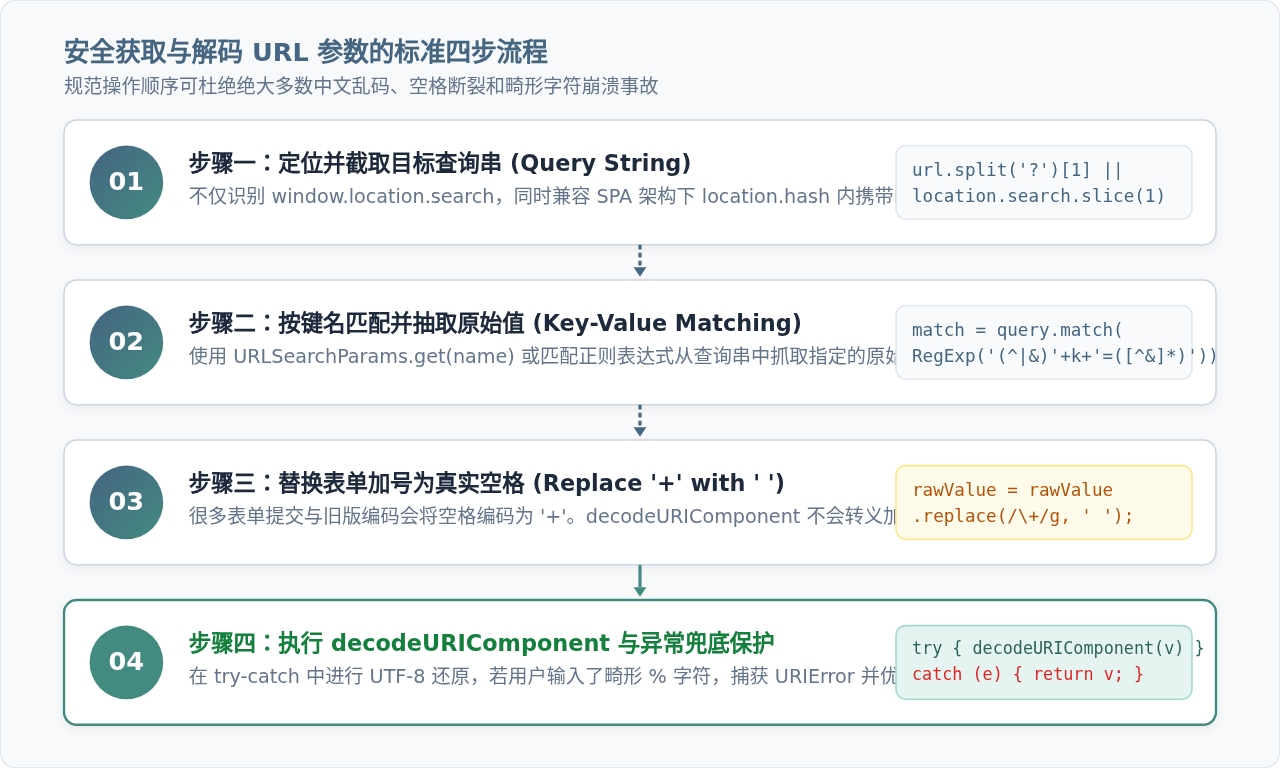
2. 避开加号(+)与空格的转换陷阱
在 HTML 表单提交(特别是 GET 方式)中,规范会将输入内容中的空格替换为 +。例如搜索 JavaScript 教程,发送的 URL 是 ?q=JavaScript+%E6%95%99%E7%A8%8B。
使用 decodeURIComponent("JavaScript+%E6%95%99%E7%A8%8B") 后,得到的返回值仍然是 "JavaScript+教程",其中的 + 并没有还原为空格。
解决方式:在调用 decodeURIComponent 之前,先执行 .replace(/\+/g, ' ')。原生 URLSearchParams 已经在内部遵循了此规则,但如果在正则或自建解析中处理,这一替换步骤必不可少。
3. 防御非法输入引发的 URIError 崩溃
decodeURIComponent() 要求传入的字符串必须符合合法的百分号编码格式。如果用户在浏览器地址栏手动编辑、复制截断、或者传入了不合规的百分号(例如 ?keyword=折扣80% 或畸形字节 %80),直接调用 decodeURIComponent 将立即抛出致命异常:
// 错误示例:未捕获异常导致代码中断
const raw = "80%";
const text = decodeURIComponent(raw); // Uncaught URIError: URI malformed
防御原则:生产环境中所有手动调用
decodeURIComponent 的地方,必须使用 try...catch 包裹,当捕获到 URIError 时安全回退,返回未解码的原串或空字符串,确保页面的主流程不被阻断。
四、生产级健壮封装与完整验证测试
结合上述所有要点与边界情况,我们可以封装一个既支持现代规范、又兼顾 SPA Hash 路由和老旧环境的通用函数 getUrlParam。
/**
 * 获取指定 URL 参数值并解决中文乱码与特殊字符问题
 * @param {string} name 需要获取的参数键名
 * @param {string} [customUrl] 可选的目标 URL,默认使用当前页面 window.location.href
 * @returns {string|null} 解码后的参数值,不存在时返回 null
 */
function getUrlParam(name, customUrl) {
  if (!name) return null;

  const targetUrl = customUrl || (typeof window !== 'undefined' ? window.location.href : '');
  if (!targetUrl) return null;

  // 优先尝试使用现代原生的 URLSearchParams
  if (typeof URLSearchParams !== 'undefined') {
    // 兼顾标准 Search 与 Hash 路由(提取最后出现的有效 query 部分)
    const queryIndex = targetUrl.indexOf('?');
    if (queryIndex !== -1) {
      const queryString = targetUrl.substring(queryIndex);
      const sp = new URLSearchParams(queryString);
      if (sp.has(name)) {
        return sp.get(name);
      }
    }
  }

  // 降级方案:高兼容性正则表达式(对键名进行字符转义,防御特殊字符注入)
  const escapedName = name.replace(/[[\]]/g, '\$&');
  const regex = new RegExp('(?:[?&]|#.*[?&])' + escapedName + '=([^&#]*)', 'i');
  const results = targetUrl.match(regex);

  if (!results || results.length < 2) {
    return null;
  }

  const rawVal = results[1];

  // 安全解码流程
  try {
    return decodeURIComponent(rawVal.replace(/\+/g, ' '));
  } catch (err) {
    console.warn('URL参数解码失败,采用原始值:', rawVal, err);
    return rawVal;
  }
}
测试用例验证
下面给出覆盖不同复杂情况的测试验证代码,读者可直接在控制台或测试环境中运行:
// 1. 标准中文参数测试
const url1 = "https://example.com/?title=%E5%89%8D%E7%AB%AF%E6%8C%87%E5%8D%97";
console.log(getUrlParam("title", url1));
// 预期输出: "前端指南"

// 2. 中文包含加号空格测试
const url2 = "https://example.com/?keyword=%E6%96%B0%E6%89%8B+%E5%85%A5%E9%97%A8";
console.log(getUrlParam("keyword", url2));
// 预期输出: "新手 入门"

// 3. SPA 单页应用 Hash 路由模式测试
const url3 = "https://example.com/#/user/profile?role=%E7%AE%A1%E7%90%86%E5%91%98";
console.log(getUrlParam("role", url3));
// 预期输出: "管理员"

// 4. 畸形非法编码容错测试
const url4 = "https://example.com/?tag=折扣80%";
console.log(getUrlParam("tag", url4));
// 预期输出: "折扣80%" (不崩溃,安全回退)
五、知识全景总结与速查清单
为了在日常开发中快速定位和杜绝 URL 中文乱码问题,可对照以下知识结构全景图与速查清单进行排查:
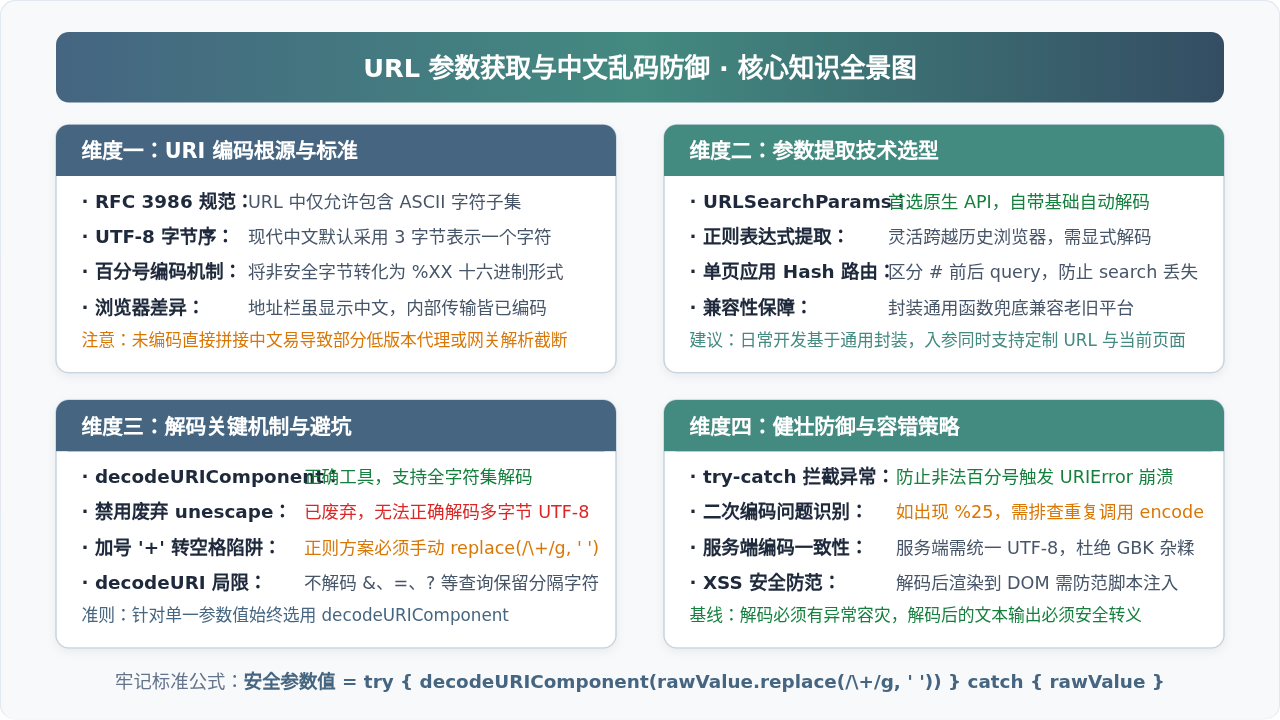
URL 中文参数排查速查清单(Checklist):
- 检查编码层级:发送端拼接 URL 时,单个参数值是否使用了
encodeURIComponent()?避免整个完整网址被错用encodeURIComponent导致http://中的冒号和斜杠被转义。 - 检查解码函数:接收端是否误用了
decodeURI()或废弃的unescape()?解析具体参数值必须使用decodeURIComponent()。 - 检查空格转换:自定义解析逻辑中,是否遗漏了
.replace(/\+/g, ' ')操作? - 检查异常捕获:解码调用是否置于
try...catch块中以抵御非法%字符? - 检查 Hash 路由:在 Vue/React 单页应用中,参数是位于
#之前还是之后?确保截取到了真正的 Query 串。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章