
深入讲解在JavaScript中使用indexOf配合splice按值删除数组元素的正确方法,剖析负索引删除末尾元素的经典陷阱,并提供单次删除、批量删除与封装复用的实用方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组按值删除元素:indexOf结合splice的正确用法
作者:小括号
时间:2026-11-16
浏览:224
文章目录
在 JavaScript 中按值删除数组元素,核心操作是两步走:先用 indexOf() 检索目标值在数组中的位置索引,在严格确认索引不为 -1 的前提下,再通过 splice(index, 1) 原地剔除该元素。如果省略存在性判断而直接调用,一旦检索的值不存在,indexOf 返回的 -1 将被 splice 识别为倒数第一个元素,从而误删数组末位元素。理解这一机制是写出可靠数组操作代码的关键。
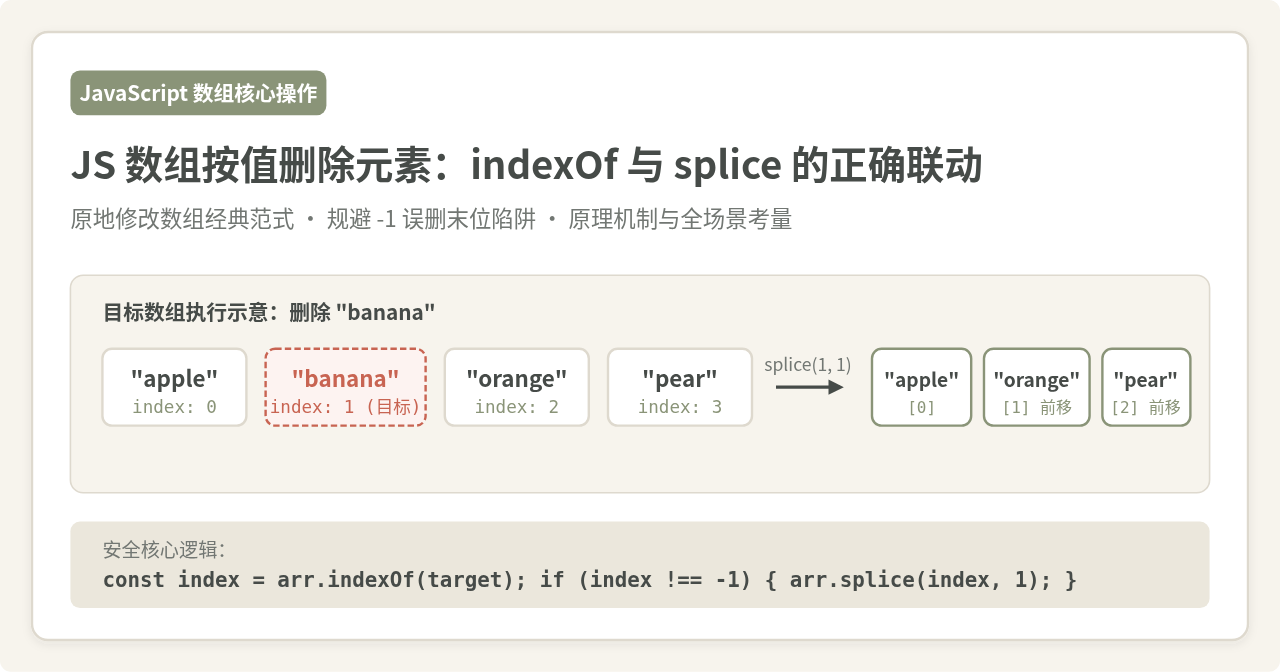
图 0:JavaScript 原地按值删除元素核心逻辑示意图
一、标准两步法与基本代码规范
JavaScript 的原生 Array 原型上没有提供类似 arr.remove(value) 这样的内置方法。当我们希望直接修改原数组(原地修改,In-Place Mutation)并剔除某一个指定的值时,最成熟、高效的模式就是将 indexOf 与 splice 串联起来。
规范的代码范式如下所示:
const list = ['apple', 'banana', 'orange', 'pear'];
const targetValue = 'banana';

// 第一步:定位元素在数组中的下标
const index = list.indexOf(targetValue);

// 第二步:防御式判断,确保目标存在于数组中
if (index !== -1) {
  list.splice(index, 1);
}

console.log(list); // 输出: ['apple', 'orange', 'pear']
这段代码仅执行了必要的两项工作:检查目标是否存在,以及在存在时精准剪切 1 个单位长度。为了便于在业务中多次复用,通常可以将其封装为一个精简的工具函数:
function removeArrayItem(arr, val) {
  if (!Array.isArray(arr)) return arr;
  const index = arr.indexOf(val);
  if (index !== -1) {
    arr.splice(index, 1);
  }
  return arr;
}
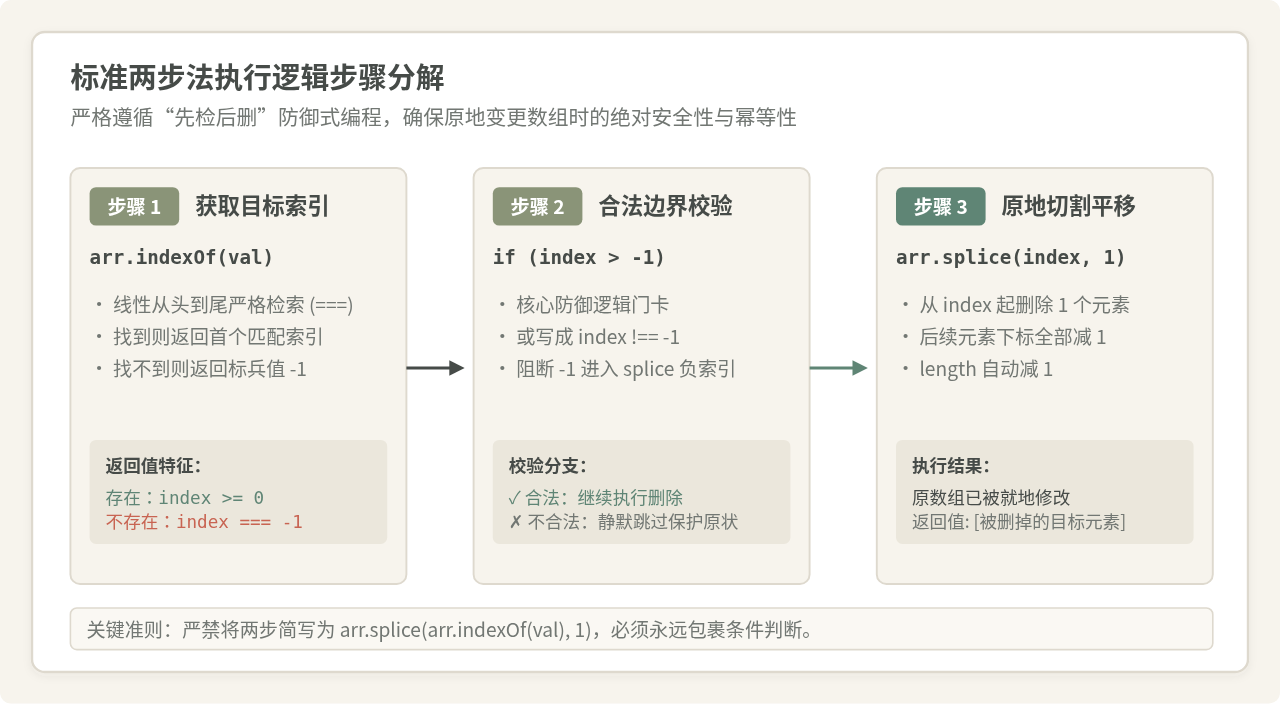
图 1:indexOf 与 splice 协同执行的两步法流程拆解
二、底层执行机制与工作原理
为了透彻理解为什么两步法必须这样写,我们需要厘清 indexOf 与 splice 在 ECMAScript 规范中的具体行为特征。
1. indexOf 的匹配规则与标兵值
arr.indexOf(searchElement[, fromIndex]) 会从指定下标(默认是 0)开始,由前往后逐项检索数组元素。它在内部使用的是严格相等比较算法(Strict Equality Comparison,即 ===)。
- 当找到第一个满足
item === searchElement的项时,立刻返回该项的非负整数索引(范围为0到length - 1)。 - 如果扫描完整个数组仍未匹配到对应元素,则返回标兵值(Sentinel Value)
-1。
2. splice 的原地修改与内存重排
arr.splice(start, deleteCount) 是一个典型的具破坏性(Mutating)方法。它直接在原数组的连续存储结构上进行切除:
- 从
start索引所指的位置开始,移除deleteCount个连续元素。 - 被删除位置之后的所有元素,其对应的索引下标都会依次向前平移 1 个单位(补齐空隙),数组的
length属性自动减 1。 - 该方法返回一个包含被移除元素的新数组;若未删除任何元素,则返回空数组
[]。
原理提示:时间复杂度说明
indexOf 需要最坏进行 $O(N)$ 次遍历对比;splice 在删除中间元素后,需要将后续的所有元素向前搬移,位移成本也是 $O(N)$。因此单次两步法的总时间复杂度为 $O(N)$,对于常规长度的数组非常轻量。
三、致命陷阱:为何绝不能简写为一行代码?
许多初学者或追求代码简洁的开发者,容易把上述逻辑合并为一行:
// 危险的常见错误写法!严禁在生产环境中使用!
arr.splice(arr.indexOf(targetValue), 1);
这种写法之所以具有极高的欺骗性,是因为在目标元素确实存在于数组时,它的运行结果完全正确。在单元测试或本地简单调试时,若只输入肯定存在的测试用例,这段代码会顺利通过测试,使隐患悄然潜入生产环境。
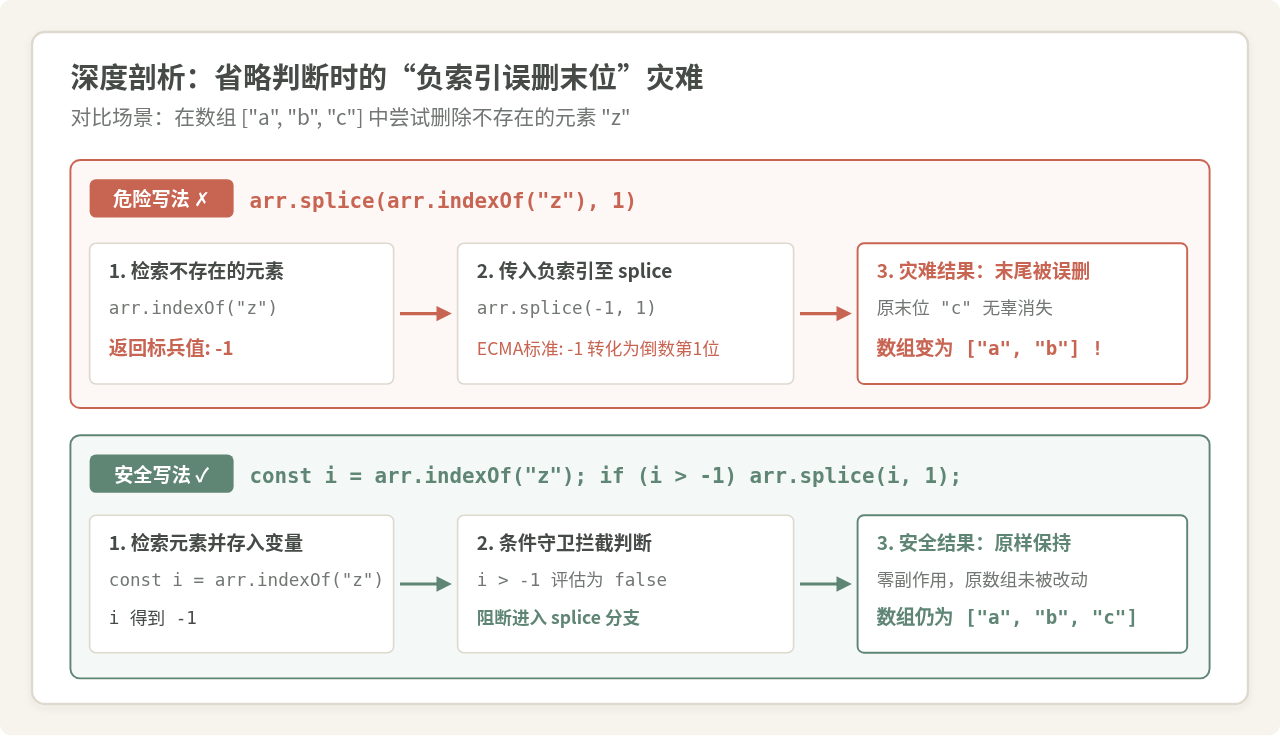
图 2:省略判断时引发的负索引误删末尾元素灾难对比
陷阱触发的因果推导
一旦待删除的值在数组中不存在,整个逻辑就会发生不可逆的严重偏差:
- 如果
targetValue并不在数组内,arr.indexOf(targetValue)将返回-1。 - 这行代码随即转变为:
arr.splice(-1, 1)。 - 根据 ECMAScript 官方规范,
splice的第一个参数start允许为负整数。当start < 0时,引擎内部计算的真实起始位置为max(length + start, 0)。 - 对于一个长度为 5 的数组,
length + (-1) = 4,正巧指向了数组的最后一个元素!
这就导致了一个荒谬且极难排查的 Bug:原本想要删除一个不存在的值,数组不但没有保持原样,反而无声无息地切掉了最后一个有效元素。以下反例清晰地呈现了该过程:
const users = ['Alice', 'Bob', 'Charlie'];

// 假设我们需要删除 'David',但他并未登录,不在列表中
const target = 'David';

// 错误的一行流写法
users.splice(users.indexOf(target), 1);

// 真实执行过程:users.splice(-1, 1)
console.log(users);
// 实际输出: ['Alice', 'Bob']
// 结果: 'David' 没删掉,无辜的 'Charlie' 却被永久删除了!
因此,条件判断 if (index !== -1) 或 if (index > -1) 是绝对不可妥协的护城河,必须在每一次调用 splice 之前显式存在。
四、进阶场景:删除数组中的全部重复项
indexOf 仅会返回首个匹配项的索引。如果数组中存在多个相同的值(例如 [1, 2, 2, 3, 2]),单次两步法只能删除第一个 2,剩下的重复项依然保留在原数组中。处理多重匹配时,需要警惕另一个由 splice 引起的经典陷阱——元素平移与索引跳位。
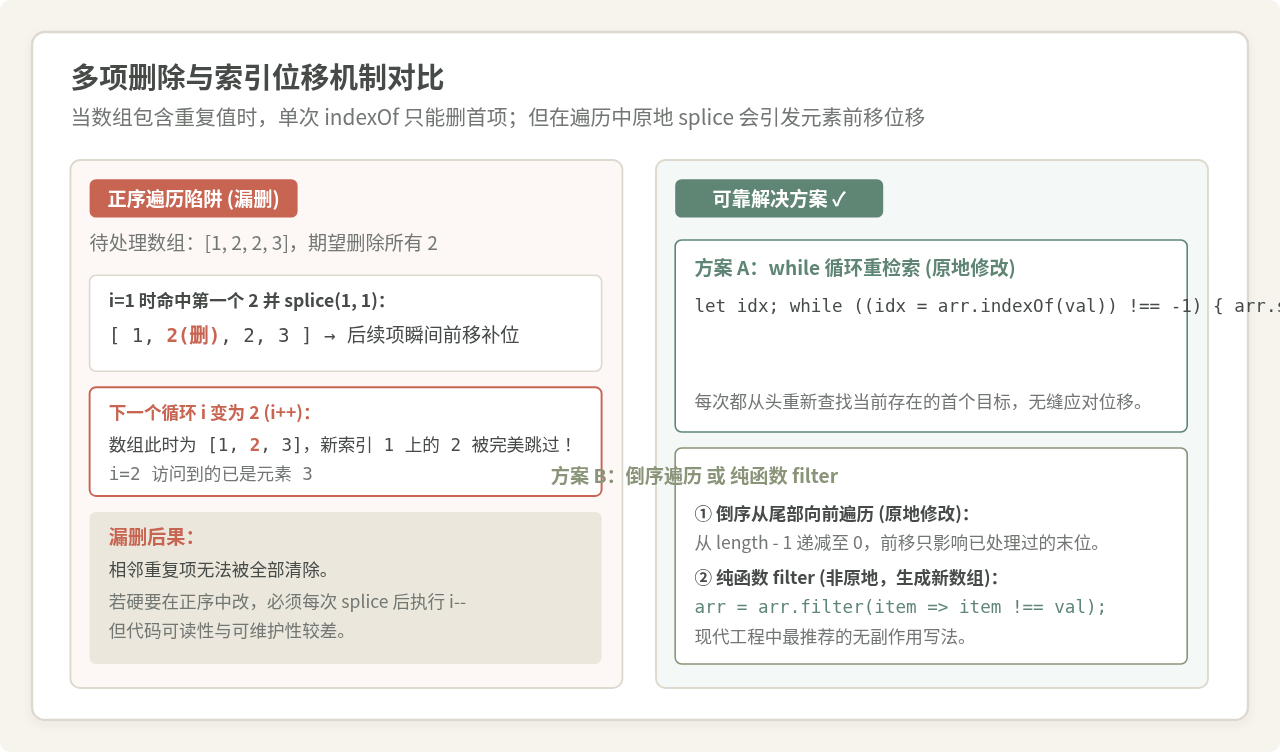
图 3:循环删除中的索引位移风险与三种主流应对方案
1. 正序 for 循环的“漏删陷阱”
初学者尝试删除多个重复项时,常写出如下正序循环:
const nums = [1, 2, 2, 3];

// 错误示范:正向遍历直接 splice
for (let i = 0; i < nums.length; i++) {
  if (nums[i] === 2) {
    nums.splice(i, 1);
  }
}

console.log(nums); // 实际输出: [1, 2, 3],漏删了第二个 2!
原因剖析:当 i = 1 删除了第一个 2 之后,后面的元素自动向前挪位,第二个 2 的下标从原本的 2 变成了当前的 1。然而循环体执行完毕后 i 会自增为 2,下一次循环直接检查索引 2(对应元素 3),导致停留在索引 1 上的第二个 2 被彻底漏检。
2. 原地删除多项的正确方案
针对就地修改(In-Place)的需求,有两种严谨的实现方式:
方案 A:使用 while 循环持续重检(推荐)
只要数组中还能搜出该值,就执行一次删除。由于每次 indexOf 都是基于修改后的最新数组状态重新检索,自然消除了索引偏移的不良影响:
const nums = [1, 2, 2, 3, 2];
const target = 2;

let idx;
while ((idx = nums.indexOf(target)) !== -1) {
  nums.splice(idx, 1);
}

console.log(nums); // 成功输出: [1, 3]
方案 B:倒序 for 循环从尾向前遍历
从末尾开始遍历,当删除某个元素时,受到下标平移影响的只有它后面的元素,而位于它前面的元素下标完全不受任何波动:
const nums = [1, 2, 2, 3, 2];
const target = 2;

for (let i = nums.length - 1; i >= 0; i--) {
  if (nums[i] === target) {
    nums.splice(i, 1);
  }
}

console.log(nums); // 成功输出: [1, 3]
3. 非原地修改的最佳现代解法:Array.prototype.filter
如果你在业务中并不强制要求保留原数组的内存引用(例如在 React 状态管理、Redux 或 Vue 的单向数据流中),纯函数 filter 是最推荐的现代化写法。它不会修改原数组,而是返回一个全新的数组:
const nums = [1, 2, 2, 3, 2];
const cleanNums = nums.filter(item => item !== 2);

console.log(cleanNums); // [1, 3]
console.log(nums);      // 原数组依然是 [1, 2, 2, 3, 2](无副作用)
五、边界条件与数据类型限制
在日常业务开发中,待删除的值并不局限于简单的数字和常规字符串。在遇到以下特殊边界值时,indexOf 会出现失效的情况,需要针对性地切换策略:
| 场景与数据类型 | indexOf 的表现 | 原因解释 | 推荐替代方案 |
|---|---|---|---|
| 基本类型 (数字/字符串/布尔) | 完美支持 | 直接基于 === 判定值是否相等。 |
indexOf + splice |
| 特殊数值 NaN | 返回 -1 (无法命中) |
JavaScript 中 NaN === NaN 恒等于 false。 |
改用 findIndex(Number.isNaN) |
| 对象与引用类型 | 仅同一引用有效,字面量失效 | 按内存堆地址比较,两个同形对象 {id:1} !== {id:1}。 |
改用 findIndex(item => item.id === targetId) |
| 大规模数组批量删除 | 频繁 splice 引起多次搬移,性能下降 | 在长度过万的数组中频繁 splice 存在 $O(N^2)$ 性能瓶颈。 |
采用双指针单次快慢覆盖遍历,或 filter |
对于对象数组或需要自定义比对条件的场景,将 indexOf 替换为 findIndex,后续判断逻辑保持完全一致:
const users = [
  { id: 101, name: 'Alice' },
  { id: 102, name: 'Bob' }
];

// 根据对象内部属性定位下标
const targetId = 101;
const index = users.findIndex(user => user.id === targetId);

if (index !== -1) {
  users.splice(index, 1);
}
六、全场景技术选型与综合决策
根据“是否原地修改”、“删除单项还是多项”以及“数据类型”三个核心维度,开发者可以根据以下决策树快速确定最佳实现方案:
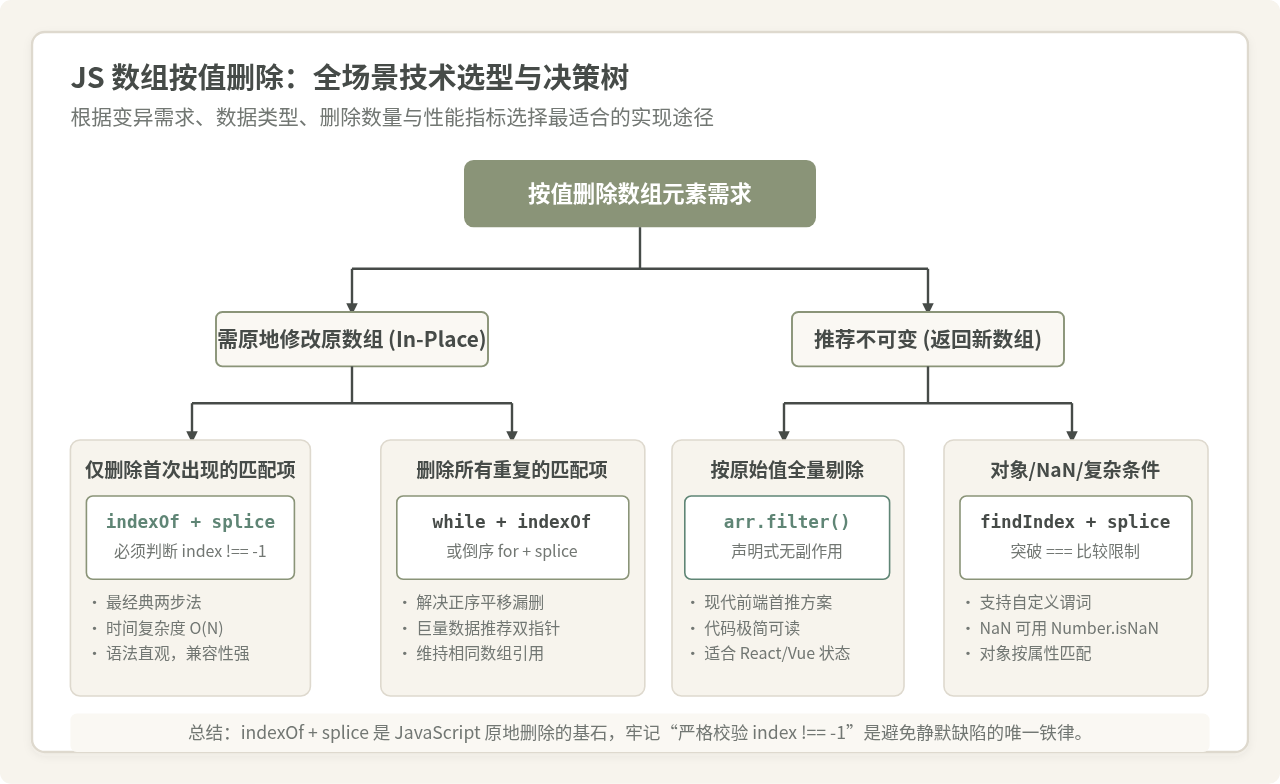
图 4:JavaScript 数组按值删除全场景选型决策树
核心要点归纳
- 单次原地删除:坚持
const idx = arr.indexOf(val); if (idx > -1) arr.splice(idx, 1);,严禁简写为单行以规避负索引误删末位。 - 多次原地删除:采用
while ((idx = arr.indexOf(val)) !== -1) arr.splice(idx, 1);,杜绝正序遍历因位移导致的漏删。 - 函数式编程与不可变数据:优先考虑
arr.filter(item => item !== val),语义明晰且无外部副作用。 - 对象及复杂匹配:优先选用
findIndex替代indexOf,解除严格相等限制。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章