
深入分析JavaScript中使用split('')等方法将字符串转为数组时出现Unicode乱码的根本原因,剖析UTF-16编码机制与代理对断裂原理,并提供Array.from与Intl.Segmenter等安全转换方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组Unicode乱码原因分析
作者:异步漫步
时间:2026-11-13
浏览:536
文章目录
在 JavaScript 开发中,使用 str.split('') 将字符串切分为单字符数组是非常直观的常规操作,但遇到用户输入生僻汉字(如“𠮷”)或 Emoji 表情(如“😀”)时,转换后的数组元素常会退化为 ['\ud842', '\udfb7'],甚至在界面上直接呈现为无法识别的问号乱码 �。本文将从 JavaScript 底层 UTF-16 存储模型出发,剖析代码单元截断与代理对破坏的微观机理,并提供在不同场景下安全切分字符数组的成熟解法。
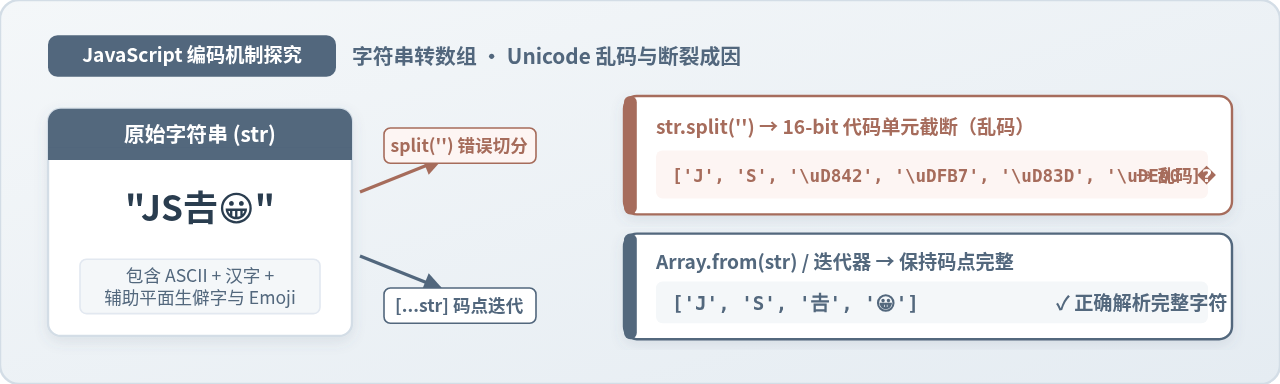
现象复现:看似简单的 split('') 为什么会碎裂?
很多开发者初次遇到这个问题,往往是在做姓名校验、敏感词过滤或字符数限制功能时。以一个包含普通汉字、生僻字与英文字母的字符串为例:
// 示例代码:使用 split('') 拆分字符串
const str = "字𠮷A";

console.log(str.length); // 输出:4,直觉上明明只有 3 个字符
const arr = str.split('');
console.log(arr);
// 示例输出:['字', '\ud842', '\udfb7', 'A']
console.log(arr[1]); // 控制台或终端显示:'�'(乱码)
console.log(arr[2]); // 控制台或终端显示:'�'(乱码)从代码执行结果可以看出两个反直觉的现象:其一,str.length 的返回值是 4 而不是 3;其二,split('') 并没有将“𠮷”作为一个独立字符放入数组,而是硬生生拆分成了两个十六进制编码片段。如果把拆出来的片段重新拼接或单独渲染到页面上,浏览器就会显示为两个不可识别的菱形问号字符(Unicode 替换字符 U+FFFD)。
要搞清楚这一现象,关键在于理解 JavaScript 字符串在内存中究竟是以什么形式存在的。
根源剖析:Unicode 码点与 UTF-16 存储机制
Unicode 是一个字符集标准,它为全世界每一种语言中的每一个符号都分配了一个唯一的数字标识,称为码点(Code Point),通常记作 U+XXXX。例如大写英文字母“A”的码点是 U+0041,常用汉字“中”的码点是 U+4E2D,而生僻汉字“𠮷”的码点是 U+20BB7,基础 Emoji “😀”的码点则是 U+1F600。
Unicode 的码点空间被划分为 17 个平面,每个平面包含 65,536 个码点:
- 基本多语言平面(BMP,Plane 0):码点范围从
U+0000到U+FFFF。涵盖了 ASCII 字符、绝大多数常用汉字(CJK 统一表意文字)、日文假名、希腊字母等绝大部分日常书写符号。 - 补充平面(SMP / SIP 等,Plane 1~16):码点范围从
U+10000到U+10FFFF。包含了历史文字、生僻汉字扩展区以及所有现代 Emoji 表情符号。
由于历史原因,JavaScript 诞生之初采纳了 16 位固定长度的 UCS-2 编码。随着 Unicode 字符突破 65,536 的上限,ECMAScript 标准转而规定字符串内部使用 UTF-16 进行物理编码。在 UTF-16 中,所有字符都以 16 位的代码单元(Code Unit)为基准进行线性存储:
- 位于 BMP 平面内的字符,数值小于
0xFFFF,刚好用 1 个 16 位代码单元表示。 - 超出 BMP 平面的补充字符(如
U+20BB7),16 位无法容纳,必须使用一对 16 位的代码单元来共同表示,这一对单元在规范中被称为代理对(Surrogate Pair)。
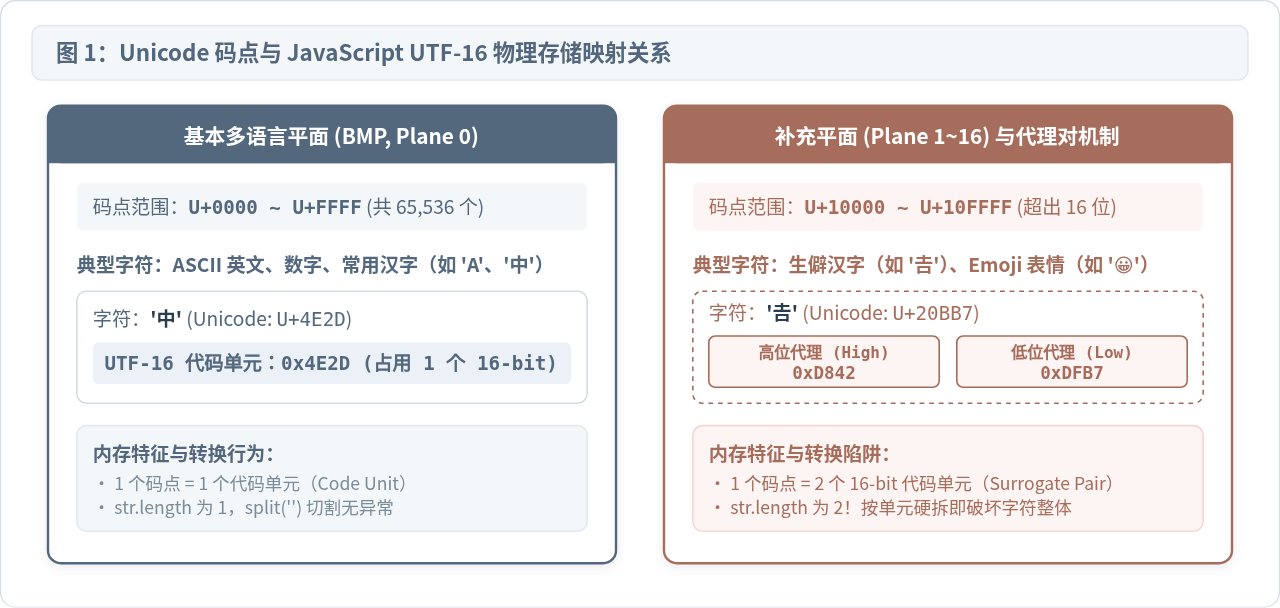
代理对由两个特定范围的代码单元组合而成:
- 高位代理项(High Surrogate):取值范围为
0xD800 ~ 0xDBFF(共 1,024 个可能值)。 - 低位代理项(Low Surrogate):取值范围为
0xDC00 ~ 0xDFFF(共 1,024 个可能值)。
Unicode 组织专门在 BMP 平面中预留了 0xD800 ~ 0xDFFF 这片区域,规定任何单一合法字符都不能占用该范围内的码点。这意味着当解析器连续遇到一个高位代理项紧跟一个低位代理项时,能够无歧义地通过计算公式将其还原为对应的真实补充平面码点:
// 代理对还原为码点的数学公式:
CodePoint = ((HighSurrogate - 0xD800) * 0x400) + (LowSurrogate - 0xDC00) + 0x10000;

// 以 '𠮷' 为例:High=0xD842, Low=0xDFB7
// ((0xD842 - 0xD800) * 0x400) + (0xDFB7 - 0xDC00) + 0x10000
// = (0x0042 * 0x0400) + 0x03B7 + 0x10000 = 0x10800 + 0x03B7 + 0x10000 = 0x20BB7
微观断裂:split('') 为什么会制造乱码?
搞清楚了 UTF-16 的存储原理,str.split('') 的乱码机制就一目了然了。
ECMAScript 规范中对 String.prototype.split 的定义非常古老。当传入空字符串 '' 作为分隔符时,它的底层算法并不是基于“语义上的字符”工作,而是机械地以 16 位代码单元(Code Unit)作为最小切分步长逐个提取。
当处理 "字𠮷A" 时,底层存储的 4 个代码单元分别为:
Unit[0] = 0x5B57(字符“字”)Unit[1] = 0xD842(“𠮷”的高位代理)Unit[2] = 0xDFB7(“𠮷”的低位代理)Unit[3] = 0x0041(字符“A”)
split('') 在执行时,不管 0xD842 是否需要低位代理配对,直接在 Unit[1] 和 Unit[2] 之间切了一刀。切分的结果是,原本紧密结合的代理对被强行分离,产出了两个独立的元素:"\uD842" 与 "\uDFB7"。
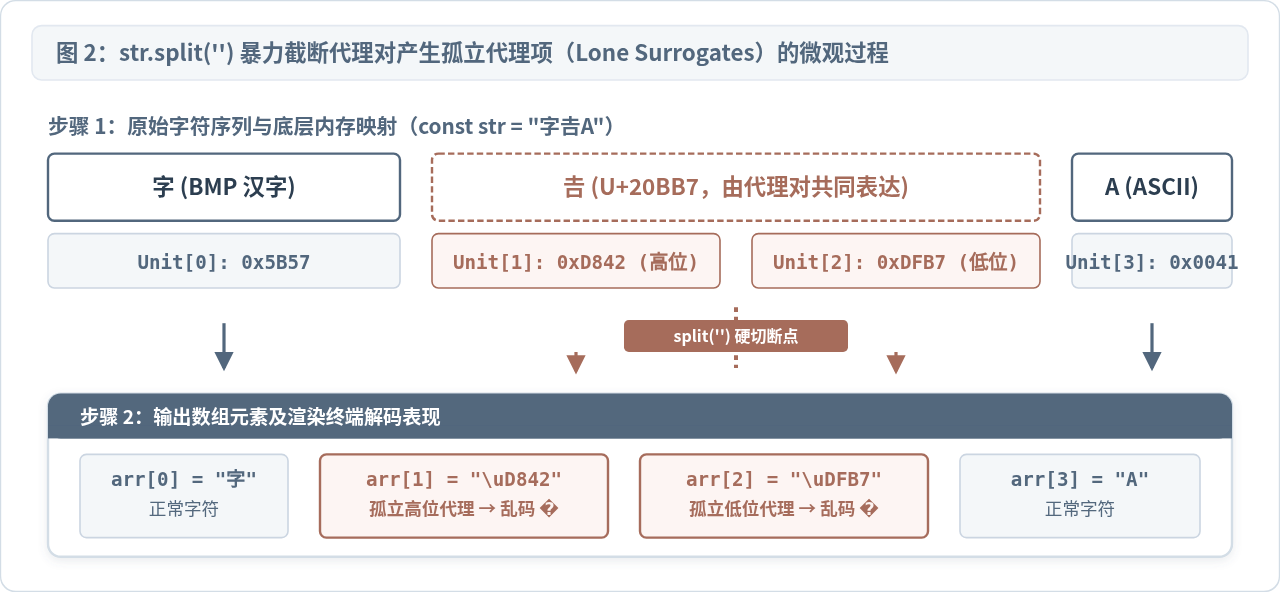
孤立代理项(Lone Surrogate)与乱码符号:
在 Unicode 标准中,失去另一半配对的高位或低位代理项被称为“孤立代理项”。因为 0xD800 ~ 0xDFFF 区间内本身没有任何独立字符映射,文本渲染引擎在遇到无法解码的孤立代理项时,只能采用容错策略,将其替换为 U+FFFD(REPLACEMENT CHARACTER,即黑色菱形带白色问号的 �)。这就是控制台与界面出现乱码的根源。
进阶陷阱:复合 Emoji 与字形簇(Grapheme Cluster)断裂
如果使用 ES6 引入的特性(例如扩展运算符 [...str]),能否解决所有切分问题呢?答案是:能解决生僻字和基础 Emoji,但无法完全解决复合 Emoji 和多音组合字符。
这是因为在 Unicode 规范中,“一个字”的层级有两重概念:
- 码点级别(Code Point):一个独立的 Unicode 编码,例如
'𠮷'是 1 个码点(虽然占 2 个代码单元)。 - 字形簇级别(Grapheme Cluster):人类视觉和书写认知上的一个完整文字或图标。一个字形簇可能由多个 Unicode 码点组合而成。
典型例子包括:
- 零宽连接符序列(ZWJ Sequence):例如家庭表情
👨👩👧👦。它在底层其实由 7 个码点组成:男人码点 +U+200D(ZWJ) + 女人码点 +U+200D+ 女孩码点 +U+200D+ 男孩码点。 - 肤色与修饰符:例如点赞表情
👍🏽,由基础手势码点U+1F44D加上中等深浅肤色修饰码点U+1F3FD组合而成。 - 组合附加变音符号(Combining Diacritical Marks):例如法文字母
é,如果采用分解形式存储,是由基础字母'e'(U+0065)后紧跟一个非退格扬抑符(U+0301)构成的。
如果使用仅仅面向码点的迭代器(如 [...str]),会把 👍🏽 拆解为两个数组元素,或者把 é 拆解为 'e' 和悬空的音标符号。虽然不会产生代理对乱码,但依然破坏了用户的视觉认知完整性。
安全方案:JavaScript 字符串转数组的实践与决策
根据具体的业务场景和字符输入范围,我们可以选择不同精度和性能的字符串切分策略:
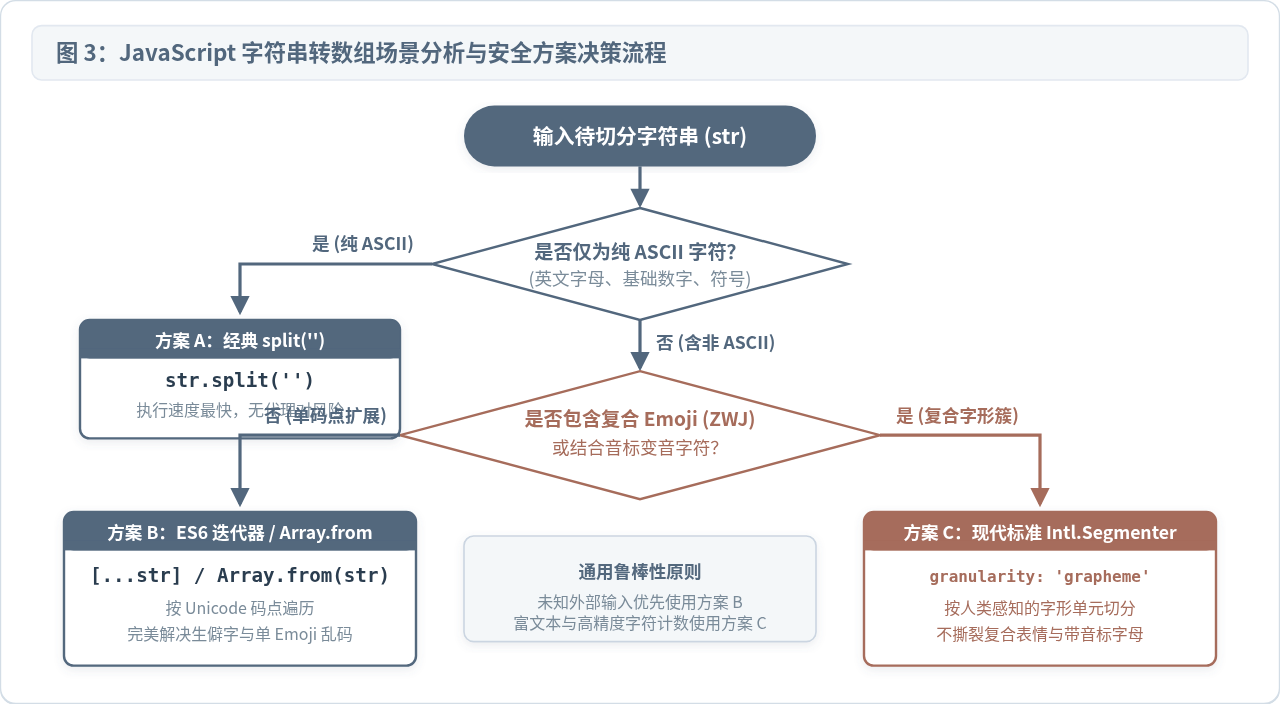
方案 1:ES6 扩展运算符与 Array.from(推荐的大多数场景)
ES6 为字符串实现了内置的 Symbol.iterator 迭代器。与 split('') 不同,该迭代器以 Unicode 码点 为单位迭代,能够自动识别并保留完整的 UTF-16 代理对:
// 示例:使用扩展运算符与 Array.from 保持生僻字与单 Emoji 完整
const text = "字𠮷😀";

// 方式 A:扩展运算符
const arrA = [...text];
console.log(arrA);
// 示例输出:['字', '𠮷', '😀'](数组长度为 3,不再产生乱码)

// 方式 B:Array.from
const arrB = Array.from(text);
console.log(arrB);
// 示例输出:['字', '𠮷', '😀']适用场景:绝大部分常规 Web 业务(用户名、文本检索、单字轮播等)。代码简洁,现代浏览器原生支持良好,能完全杜绝由代理对断裂产生的孤立代理项乱码。
方案 2:现代标准 Intl.Segmenter(复杂图元与精确字形处理)
如果业务涉及富文本编辑器、Emoji 表情键盘、精确字数统计或需要处理带音标的多语言字符,应当使用 ECMAScript 国际化标准提供的 Intl.Segmenter:
// 示例:使用 Intl.Segmenter 实现字形簇(Grapheme)级别的精确切分
const complexStr = "e\u0301👨👩👧👦👍🏽";
// 创建字形分词器(granularity 设置为 'grapheme')
const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' });
const segments = segmenter.segment(complexStr);
// 提取切分后的字符段文本
const graphemeArray = Array.from(segments, segment => segment.segment);
console.log(graphemeArray);
// 示例输出:['é', '👨👩👧👦', '👍🏽'](长度精确为 3,复合图元完全保留)Intl.Segmenter 是目前 JavaScript 官方规范中最权威、最健壮的字符串分词工具,它遵从 Unicode 文本分词标准(UAX #29),能精准识别 ZWJ 连接序列与组合音标,是处理用户输入文本的高级防护方案。
综合对比与总结
为了在实际架构中合理权衡性能与正确性,我们将常见字符串切分方式在各类字符下的表现整理为对比矩阵:
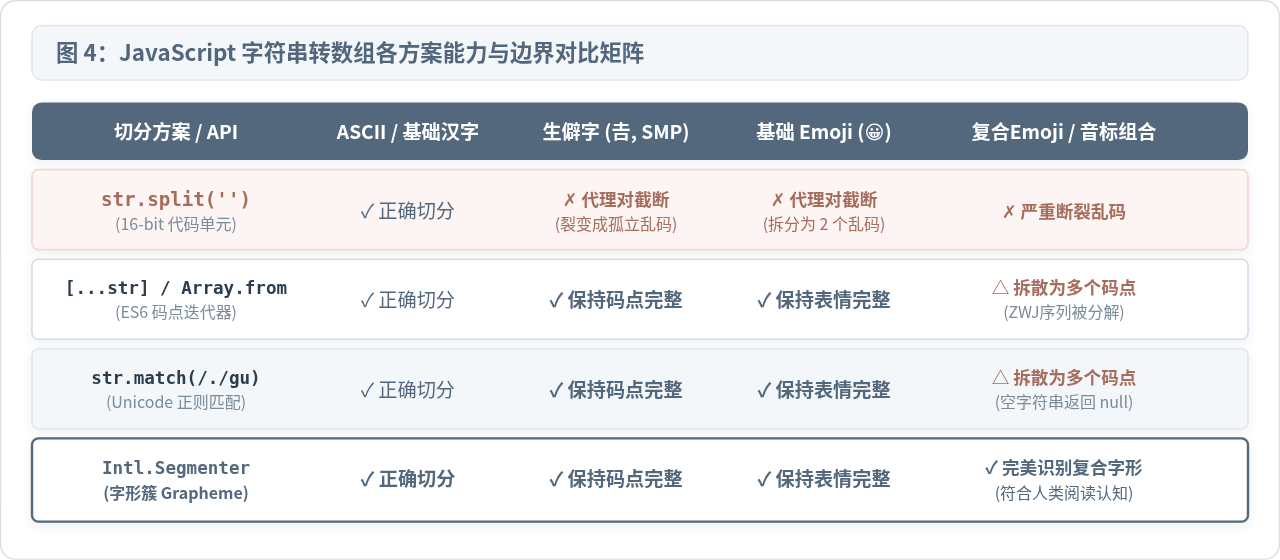
总结来说,JavaScript 中 str.split('') 导致的 Unicode 乱码,其本质是高层语义操作(字符切分)与底层硬件存储单位(16 位代码单元)之间的不匹配。在日常开发中:
- 坚决废弃使用
str.split('')切分可能包含中文生僻字或表情符号的外部用户输入; - 在普通的字符遍历与单字处理场景中,全面改用
[...str]或Array.from(str),消除代理对断裂; - 在需要高精度处理多语言文字、变音记号和复合 Emoji 的前端应用中,采用
new Intl.Segmenter('und', { granularity: 'grapheme' })保证最终呈现与人类直觉完全吻合。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章