
全面剖析Node.js的技术本质:澄清Node.js既不是单纯的前端也不是局限的后端,而是一个脱离浏览器沙箱的跨平台JavaScript运行时环境。通过架构对比、判断推导流程与实际场景,帮助开发者准确理解其在现代软件工程中的定位。

当前位置:首页 > Node.js 基础 > 正文
Node.js是前端还是后端?澄清JavaScript运行时的技术定位
作者:终端旅客
时间:2026-11-13
浏览:224
文章目录
技术原理
架构剖析
阅读时长:约 8 分钟
适用对象:初学者 / 前端工程师 / 全栈开发者
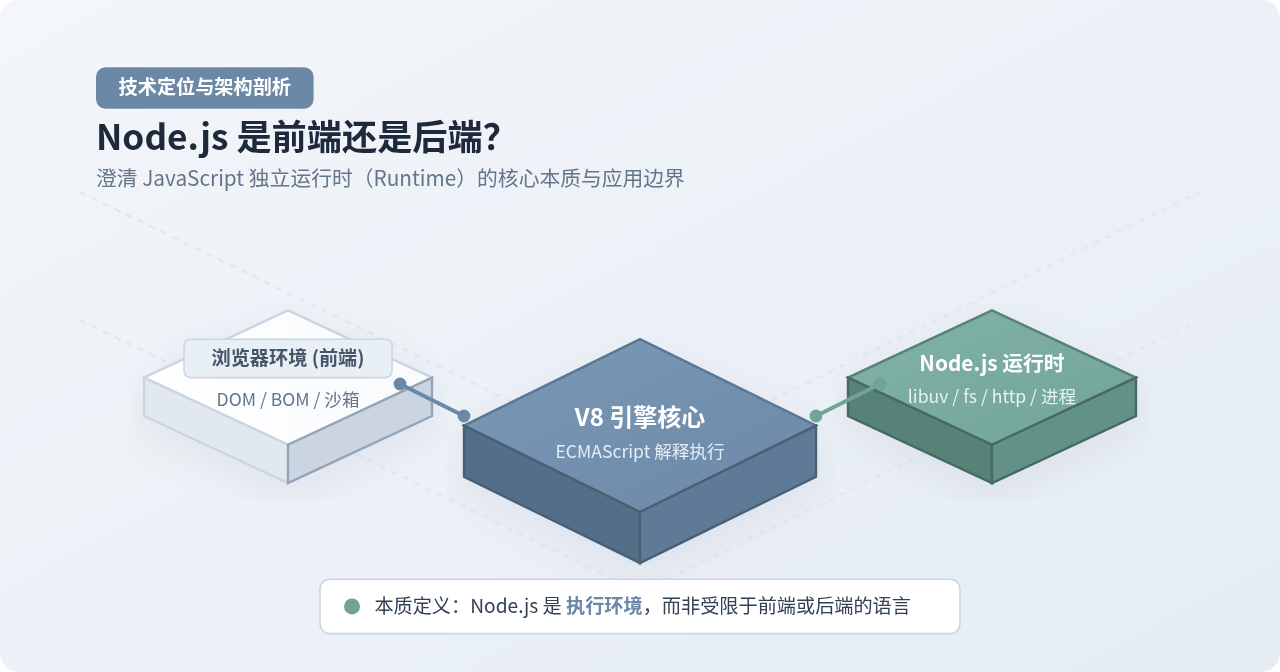
核心答案先行:从技术本质上讲,Node.js 既不是纯粹的“前端”,也不是一门专有的“后端语言”,而是一个跨平台的 JavaScript 运行时环境(Runtime Environment)。它把 Google Chrome 浏览器底层负责解释和编译代码的 V8 引擎抽取出来,结合开源异步 I/O 库 libuv 与底层 C++ 系统调用,打包成一个脱离浏览器独立运行的执行环境。你在架构中用它做什么,它就呈现出对应的技术形态:在前端开发中它充当工程化工具链与构建基座;在服务端开发中它充当高并发网络服务、BFF 聚合层与独立微服务。
一、为什么初学者极易误认为“Node.js 是前端”?
很多刚进入前端开发领域的同学,安装的第一个开发环境就是 Node.js。随后在开发 Vue、React 等单页面应用时,终端中频繁输入的也是 npm run dev 或 npm run build。这种日常开发体验极易让人产生一个直接的直觉联想:“我学的是前端,前端要装 Node.js,所以 Node.js 就是前端技术”。
要打破这种直觉偏差,必须明确区分两个概念:“代码最终运行的平台”与“辅助代码生产的工具环境”。
- 前端工程化工具链依赖 Node.js:现代浏览器并不认识
.vue、.jsx文件,也无法直接解析 TypeScript 静态类型或 Sass/Less 样式嵌套。因此,开发者需要在本地开发机上执行打包、编译、压缩等繁重任务。而执行 Vite、Webpack、Babel、ESLint 这些工具程序的宿主环境,恰恰就是本地安装的 Node.js。 - 最终产物脱离 Node.js 运行:经过上述工具链构建完成后,输出的只是一堆标准的 HTML、CSS 和经过转译的 JavaScript 静态文本文件。这些静态文件被上传到 Nginx 或 CDN 后,直接下载到终端用户的浏览器中执行。在整个线上访问环节,客户端浏览器内部根本不需要、也没有运行任何 Node.js 实例。
因此,对于传统的单页面应用(SPA)开发者来说,Node.js 实际上扮演的是“本地软件工厂的机床”,而不是流水线上最终交付给客户的零件本身。
二、浏览器运行时 vs Node.js 运行时:底层能力对照
为什么同一个 JavaScript 脚本,在浏览器里能弹出提示框、修改网页按钮,却无法读取电脑上的 C盘 文件夹;而在 Node.js 终端中,却能监听 8080 端口、读写数据库,但一写 window 或 document 就立即报错?
根本原因在于:JavaScript 这门语言本身只定义了语法规范(ECMAScript 标准),而真正赋予其外部通信能力的,是它所在的“宿主环境(Host Environment)”。
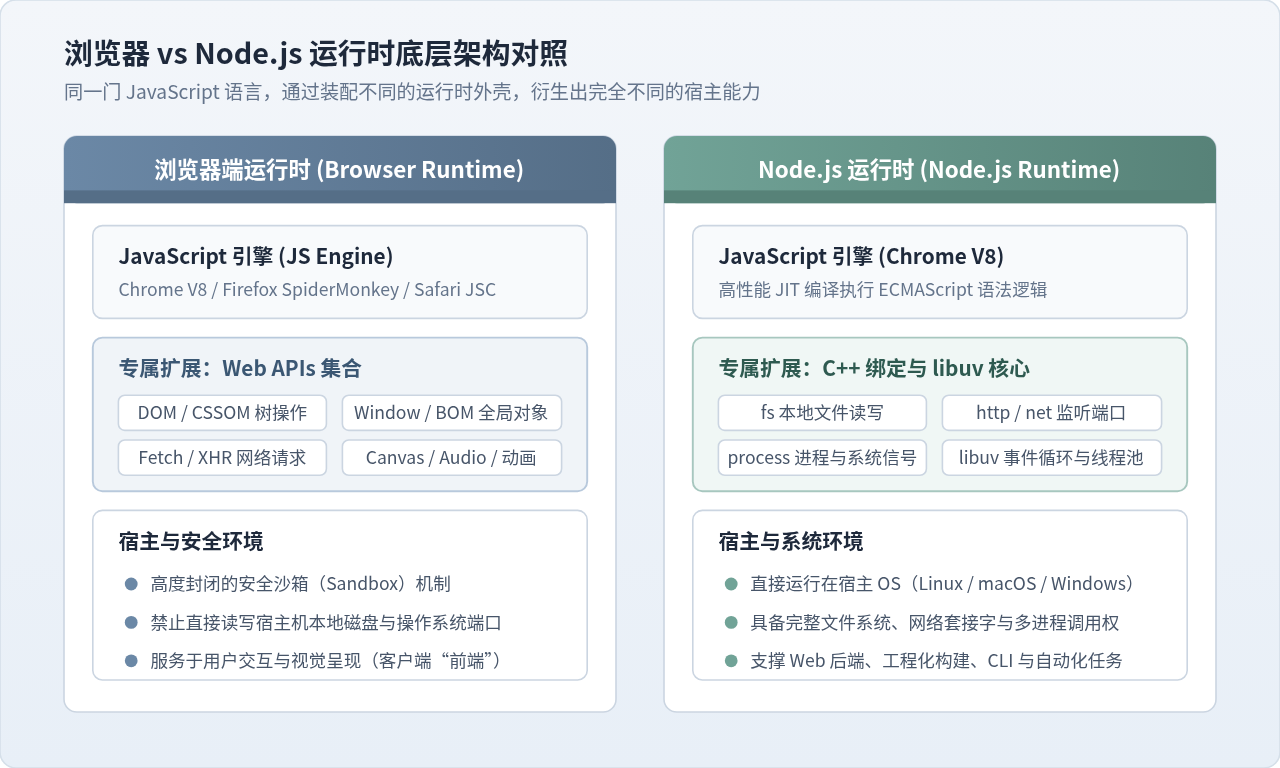
如上图所示,浏览器与 Node.js 均采用了相同的 Chrome V8 引擎来解析 ECMAScript 语法(如变量定义、箭头函数、Promise、闭包等),但它们在引擎外层包裹的“外部能力扩展包”截然不同:
| 对比维度 | 浏览器运行时 (Browser) | Node.js 运行时 (Node.js) |
|---|---|---|
| 全局核心对象 | window, document, history, location |
global, process, Buffer, __dirname |
| DOM / UI 渲染 | 完整支持(HTML 解析、重绘重排、事件绑定) | 无原生 DOM 环境(无需也无处进行视觉渲染) |
| 本地文件系统访问 | 受严格安全沙箱限制,无法任意读写本地磁盘 | 通过内置 fs / fs/promises 模块随意读写磁盘 |
| 网络端口监听与协议 | 仅能作为客户端发起 fetch / WebSocket 请求 |
内置 http, https, net, 可自由绑定端口作为服务器 |
| 进程与底层控制 | 无权干预系统进程与信号通信 | 通过 child_process, cluster, os 调度系统底层 |
| 主要工作归属 | 客户端交互呈现(传统“前端”) | 服务端服务、工程化构建、CLI自动化工具 |
核心启示:
只要 JavaScript 引擎被嵌入到具有操作系统系统调用能力的宿主程序中,它就天然具备了编写操作系统级应用与网络后端的全部能力。Node.js 的出现,正是把 JavaScript 彻底带出了浏览器的牢笼。
三、回归本质:Node.js 在“后端”能够做什么?
在纯正的后端工程中,Node.js 绝不是辅助工具,而是与 Java(Spring Boot)、Go、Python(Django/FastAPI)并驾齐驱的核心服务运行载体。得益于其基于单线程事件循环(Event Loop)与非阻塞异步 I/O(Non-blocking I/O)的设计哲学,Node.js 在处理高并发网络连接、I/O 密集型接口时展现出极高的吞吐效率和极低的内存占用。
下面是一个使用 Node.js 原生 API 编写的极简 HTTP 服务器示例。这段代码没有任何前端依赖,直接调用操作系统网络栈完成端口监听:
// server.js:纯原生 Node.js 后端服务示例
const http = require('http');
const os = require('os');

const server = http.createServer((req, res) => {
  // 记录请求元数据与访问日志
  const clientIp = req.socket.remoteAddress;
  console.log(`[${new Date().toISOString()}] 收到来自 ${clientIp} 的 ${req.method} 请求: ${req.url}`);

  // 返回 JSON 响应头与格式化数据
  res.writeHead(200, { 'Content-Type': 'application/json; charset=utf-8' });
  const payload = {
    code: 0,
    message: '欢迎访问 Node.js 原生后端服务',
    systemInfo: {
      platform: os.platform(),
      cpus: os.cpus().length,
      freeMemoryMB: Math.round(os.freemem() / 1024 / 1024)
    }
  };

  res.end(JSON.stringify(payload));
});

const PORT = 3000;
server.listen(PORT, () => {
  console.log(`Server is running at http://localhost:${PORT}/`);
});
当在终端中执行 node server.js 时,操作系统内核会为该 Node.js 进程分配独立的进程 ID(PID),并绑定宿主机的 3000 端口。此时,任何外部设备或浏览器都可以向该地址发起 HTTP 请求,Node.js 负责解析 TCP 报文、提取请求头、查询底层系统信息并返回响应流。这在任何标准定义下,都是教科书式的后端服务行为。
四、判断代码归属:四步推导与判定流程
在现代工程中,很多项目同时存在前端与后端代码,文件后缀全部是 .js 或 .ts。为了避免产生混淆,读者可以按照以下四步推导流程,清晰判断一段代码的具体技术定位:
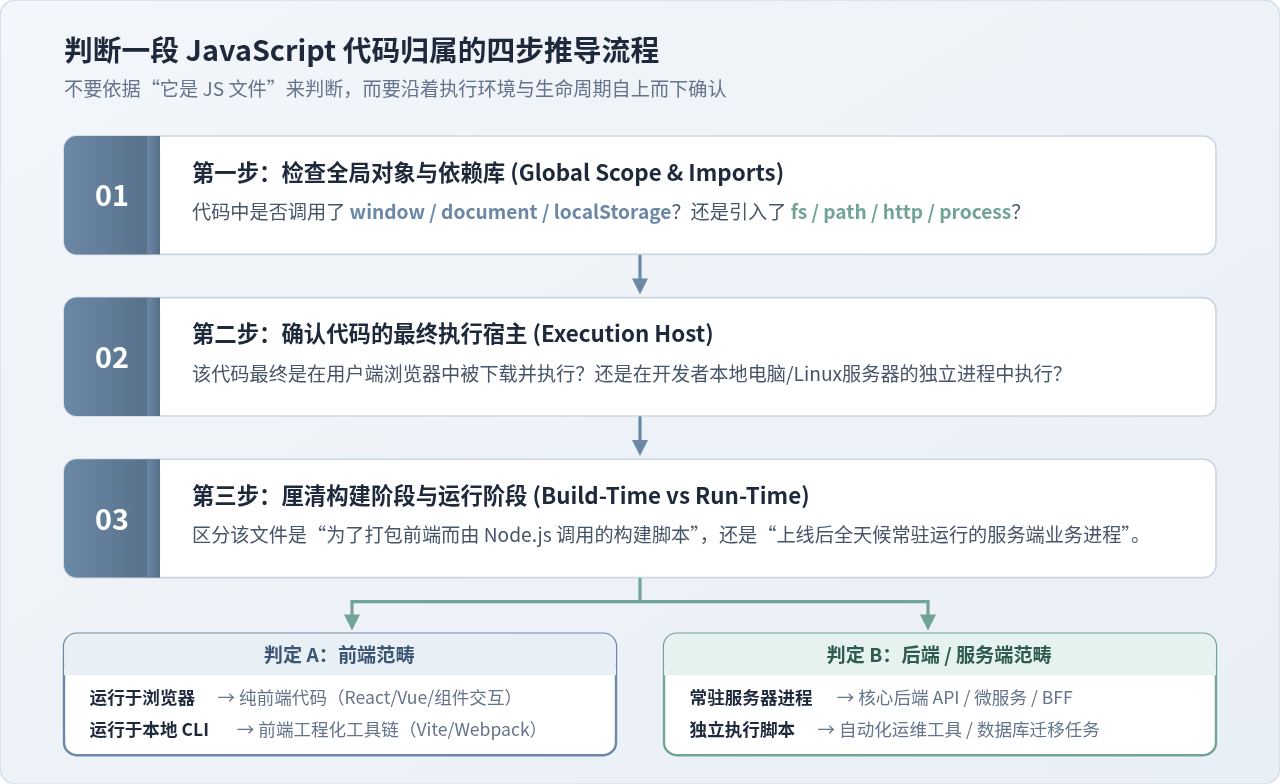
- 步骤一:检查全局作用域与引入模块。如果代码中使用了
window.addEventListener、document.getElementById、localStorage,说明它深度依赖浏览器 DOM/BOM 规范;反之,若使用了require('fs')、import http from 'http'或全局变量process.env,说明它运行在操作系统层级的 Node.js 运行时中。 - 步骤二:追踪代码的最终执行宿主(Execution Host)。确认该代码在最终生产上线后,是在千万用户的手机/PC 浏览器内存中执行,还是在云端 Linux 服务器的 Docker 容器中常驻执行。
- 步骤三:区分构建时(Build-Time)与运行时(Run-Time)。像
vite.config.ts、webpack.config.js、Babel 转译插件,虽然由前端开发者编写、服务于前端工程,但它们只在开发者的机器上编译阶段运行一次,执行宿主是本地的 Node.js,属于前端工程化构建工具。 - 步骤四:得出最终归属。根据宿主与生命周期,准确划分出前端业务代码、工程构建工具链、服务端核心 API 或运维自动化脚本。
五、架构分层视角:现代 Web 技术栈中 Node.js 的四大角色
脱离具体架构谈“前端”或“后端”往往会陷入概念争论。在工业级真实场景中,Node.js 的技术定位实际上覆盖了从开发终端到云端集群的多个层级:
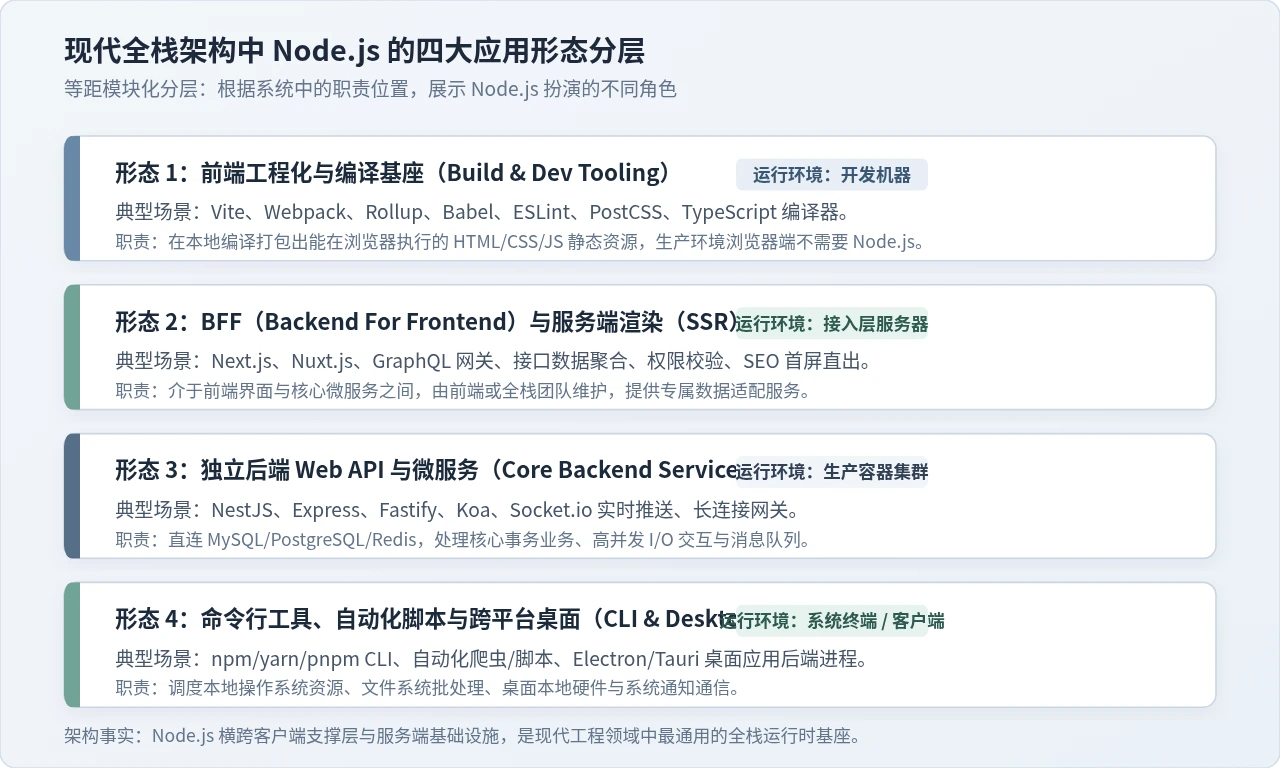
这四层具体分工如下:
- 1. 前端工程化基座(Build & Dev Tooling):负责代码降级(Babel)、模块依赖图解析与打包(Vite/Rollup/Webpack)、代码规范检查(ESLint/Prettier)。此层完全运行在开发者本地或 CI/CD 构建流水线上。
- 2. BFF 服务与服务端渲染中台(Backend For Frontend & SSR):在 Next.js、Nuxt 等全栈框架中,Node.js 充当前端界面的服务端延伸层。它负责首屏直出(提升首屏渲染速度与 SEO 抓取)、聚合多个微服务接口、清洗敏感字段以及处理登录 Cookie 鉴权。这一层通常由熟悉业务交互的前端/全栈团队直接主导。
- 3. 独立后端 API 与微服务系统(Core Backend Services):使用成熟企业级框架(如 NestJS、Fastify、Express),直连 PostgreSQL、MySQL、MongoDB 与 Redis,完成高并发业务逻辑处理,承载实时聊天(WebSocket)、支付回调、数据看板与业务中台。
- 4. 命令行工具与系统自动化(CLI & Desktop Tooling):借助 Node.js 的系统级调用能力,编写如代码生成器、自动化爬虫、云资源部署脚本;或配合 Electron、Tauri 开发跨平台的桌面客户端,在后台调度本地操作系统文件与硬件接口。
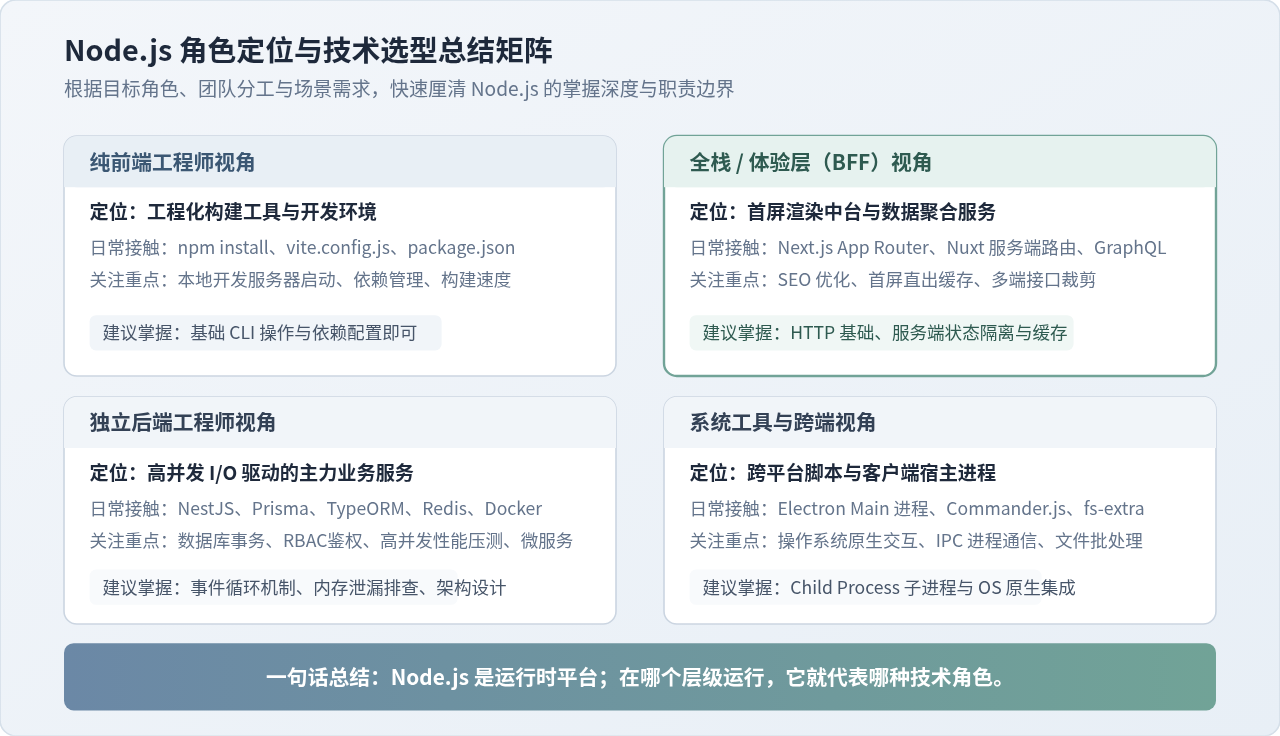
六、技术选型与认知矩阵
明确了技术定位之后,开发者应如何规划自己的技术栈深度?面对不同岗位的要求,应该把 Node.js 掌握到何种程度?下表总结了四类典型开发者在定位与选型上的决策路径:
七、常见高频认知误区与解答 (FAQ)
学会了 Node.js,是不是就自然学会了“完整的后端开发”?
答案是否定的。掌握 Node.js 的语法和 API(比如懂得调用
fs 读写文件或用 express 写个接口),只相当于掌握了后端的“编程语言工具”。真正的后端开发核心在于分布式架构系统知识,包括:关系型数据库设计与范式优化、SQL 事务与索引调优、缓存一致性与穿透防范(Redis)、消息队列(Kafka/RabbitMQ)、高并发锁与限流、容器化集群部署(Docker/K8s)以及安全攻防。语言从 Java、Go 换成 Node.js,这些底层后端工程知识依然是不可或缺的基石。
Node.js 适合做所有类型的后端服务吗?它的限制条件是什么?
Node.js 最擅长的场景是高并发 I/O 密集型应用(如即时通信、流媒体转发、数据聚合网关、RESTful API)。但对于CPU 密集型计算任务(如大规模音视频转码、图像算法处理、高密度数学矩阵计算、密码学破解),因为主线程运行机制会因长任务计算而被阻塞,导致后续网络请求排队甚至超时。虽然 Node.js 提供了 Worker Threads(工作线程池),但在超重型计算领域,通常更推荐选择 Go、Rust、C++ 或 Java。
Next.js、Nuxt 这种“全栈框架”里的 Node.js 到底算前端还是后端?
它们属于典型的全栈一体化应用。框架中的组件代码具有“同构渲染(Isomorphic Rendering)”的特性:在首屏请求时,代码运行在服务器的 Node.js 环境中完成 HTML 字符串拼接;客户端接收到页面并加载完脚本后,同一份组件逻辑在浏览器中完成“水合(Hydration)”并接管用户交互。因此,Next.js/Nuxt 里的 Node.js 承担的是正规的服务端(后端)计算任务。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章