
深入解析现代JavaScript数组核心方法includes、find和flat的运行机制、语法参数、实战示例、常见误区与性能选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
ES6新增JavaScript数组方法:includes、find和flat使用指南
作者:木棉
时间:2026-11-13
浏览:351
文章目录
在现代 JavaScript 业务开发中,数组是最基础也最高频的数据载体。过去开发者在做数组元素匹配、对象字段定位以及多层数据扁平化时,往往不得不依赖判断繁琐的 indexOf、开销较大的 filter 或手写递归降维函数。现代 ECMAScript 规范陆续引入的 includes、find(含 findIndex)与 flat(含 flatMap),分别精准解决了“标量存在性判断”、“高阶条件对象检索”以及“嵌套数组解构清洗”这三大高频痛点。本文将详细拆解这三个核心方法的内部机制、参数细节、实战用法与避坑原则,帮助你在实际项目中准确选型并写出高效简洁的数组处理代码。
一、现代数组方法的演进与核心分工
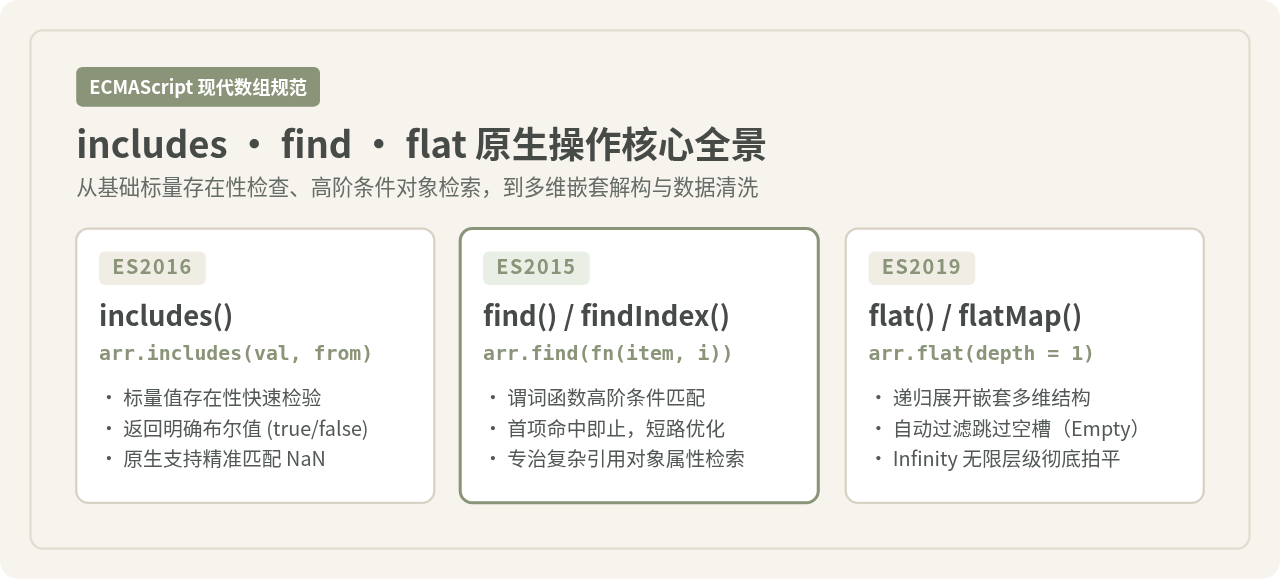
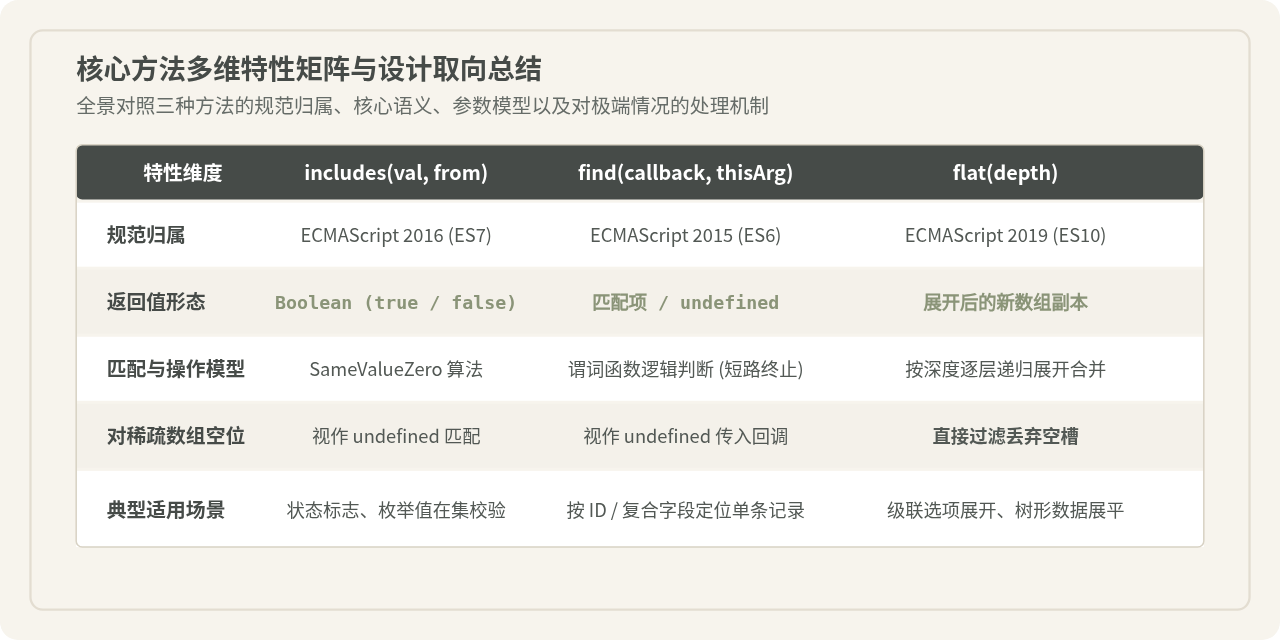
前端开发中,经常能听到“ES6 数组新方法”的统称。在严格的规范标准中,find 属于 ECMAScript 2015(即 ES6),includes 属于 ECMAScript 2016(ES7),而 flat 则是 ECMAScript 2019(ES10)正式定稿的特性。在业界习惯语境中,开发者往往把 ES2015 之后带来的现代原生语法统称为“现代 ES 语法”或广义的“ES6+ 拓展”。这三个方法之所以常被并提,是因为它们共同构建了现代前端在面对复杂数据流时最核心的“查”、“探”、“展”三个操作维度。
明确三者的职责边界是规范编码的前提:
includes:负责快速回答“有没有”。针对简单标量(数值、字符串、布尔、Symbol 等),以最简洁的语法返回布尔值(true或false),避免对-1下标做比较,并修复了传统方法无法查找NaN的历史缺陷。find:负责回答“具体是哪一个”。针对对象数组或需要自定义业务规则的场景,接收一个测试函数,在遍历到第一个满足条件的项时立即短路终止,直接返回该元素本身或undefined。flat:负责回答“如何把多层结构理顺”。将深层嵌套的树状或列表数据按照指定深度递归解构为单一维度的新数组,同时自动清除由于稀疏数组造成的空洞槽位(empty slot)。
二、Array.prototype.includes():标量存在性快速核验
在 includes 出现之前,判断数组是否包含某个元素通常使用 arr.indexOf(val) !== -1。这种方式不仅在语义上不够直观,而且在面对特殊数值(如 NaN)时会产生误判。includes 方法专门用于解决标量包含的语义表达与准确性问题。
1. 语法与参数规范
const isPresent = arr.includes(valueToFind[, fromIndex]);valueToFind:需要检索的目标值。fromIndex(可选):开始检索的索引位置,默认为0。如果传入负数,则按arr.length + fromIndex的偏移量向前回溯;若绝对值大于数组长度,则从0开始全面检索。
2. 基础示例与场景演示
// 1. 基础标量检查
const permissions = ['READ', 'WRITE', 'DELETE'];
const canEdit = permissions.includes('WRITE'); // 示例输出: true
const canAdmin = permissions.includes('ADMIN'); // 示例输出: false

// 2. 指定从后往前偏移的检索起点
const tags = ['js', 'ts', 'css', 'html'];
// -2 代表从 length - 2 即索引 2 ('css') 开始检索
const hasJsInTail = tags.includes('js', -2); // 示例输出: false
const hasHtmlInTail = tags.includes('html', -2); // 示例输出: true
关键差异:SameValueZero 比较算法与 NaN 的处理
传统的
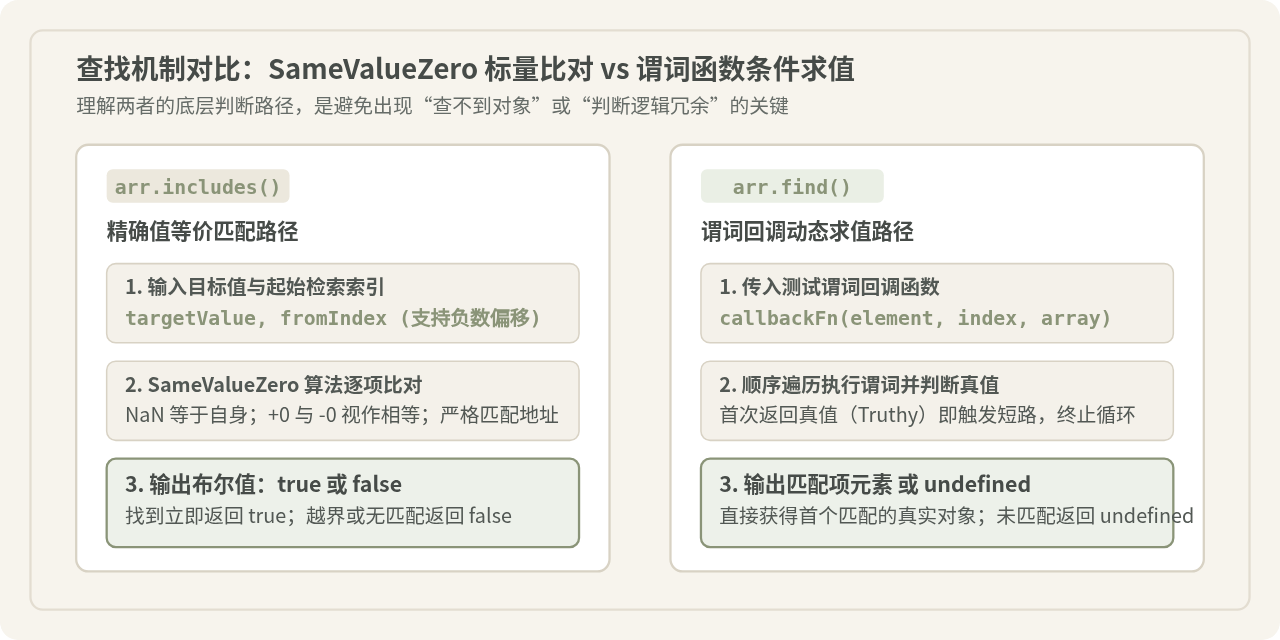
indexOf 内部采用严格相等算法(===)。在 JavaScript 规范中,NaN === NaN 返回 false,因此 [NaN].indexOf(NaN) 永远输出 -1。而 includes 遵循的是 SameValueZero 算法,认为 NaN 与 NaN 是等价的,同时认为 +0 与 -0 相等。因此 [NaN].includes(NaN) 正确返回 true。
三、Array.prototype.find() 与 findIndex():高阶条件与对象检索
当数组存储的是引用类型(如对象列表),或者判断依据不是简单的“等于某个具体值”,而是“满足某个动态规则”时,includes 便无法适用,此时需要使用 find 及其衍生方法 findIndex。
1. 语法与测试函数参数
const matchedElement = arr.find(function(element, index, array) {
  return /* 返回布尔真值表示命中 */;
}[, thisArg]);
测试函数(Predicate)会按升序遍历数组的每个下标。一旦测试函数返回真值(Truthy),find 就会立即终止循环并返回当前项。如果遍历完整个数组仍未命中,则返回 undefined。
2. 对象数组检索示例
const userList = [
  { id: 101, name: '张三', role: 'member', score: 72 },
  { id: 102, name: '李四', role: 'admin', score: 95 },
  { id: 103, name: '王五', role: 'editor', score: 88 }
];

// 查找第一个满足管理员身份的用户
const currentAdmin = userList.find(user => user.role === 'admin');
// 示例输出: { id: 102, name: '李四', role: 'admin', score: 95 }

// 查找首个分数超过 90 的用户名称(利用可选链避免 undefined 报错)
const topUserName = userList.find(u => u.score > 90)?.name ?? '未找到';
// 示例输出: '李四'
性能机制对比:为什么不建议使用 filter()[0] 代替 find()?
部分初学者在检索单项时习惯写成
arr.filter(predicate)[0]。这种写法有两个明显的性能缺陷:第一,filter 必须无条件完整遍历整个数组,无法享受提前命中的“短路优化”;第二,filter 会在内存中额外分配一个全新的数组用于存放所有匹配项。在数万条以上的数据规模下,find 的执行耗时和内存压力都明显低于 filter。
四、Array.prototype.flat() 与 flatMap():多维数据降维与清洗
在处理服务端返回的级联列表、树结构子节点集合或多选组件数据时,多维嵌套数组非常普遍。在 ES2019 之前,开发者通常要手写 reduce + 递归来展平数组。flat 提供了一行代码彻底解决嵌套数组的标准化方案。
1. 语法与 depth 深度控制
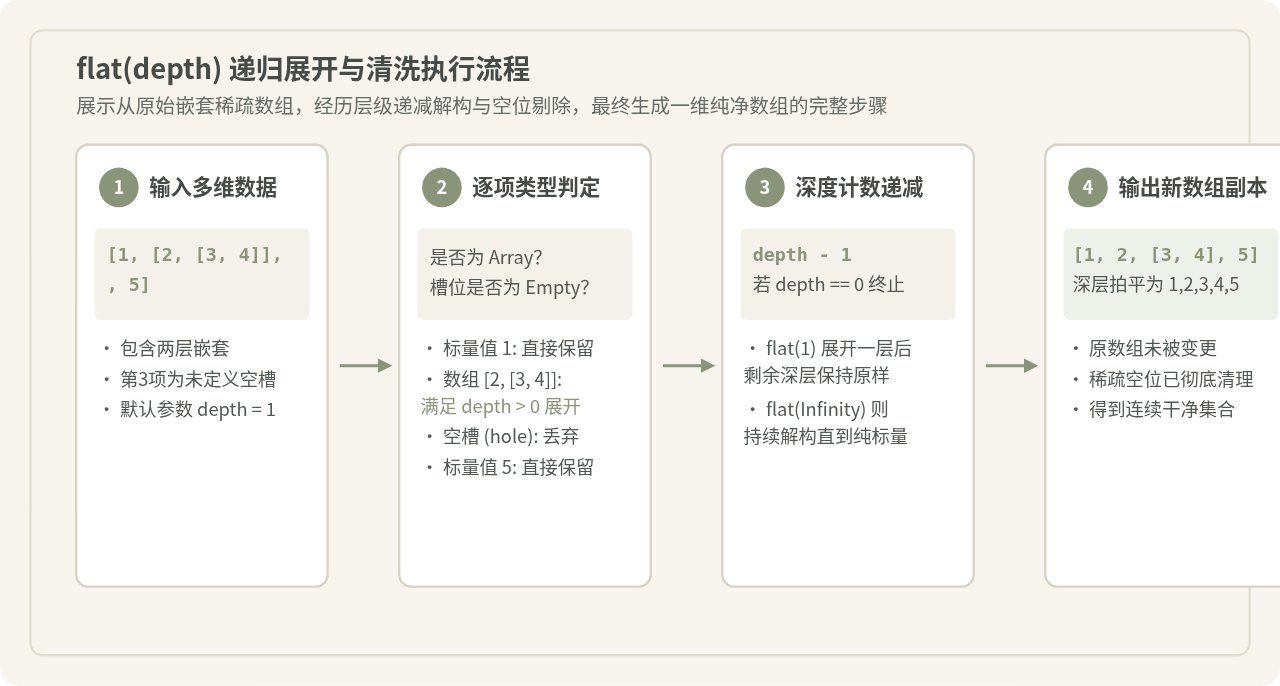
const flattenedArray = arr.flat([depth]);depth(可选):提取嵌套数组的结构深度,默认值为1。- 如果希望无论嵌套多深都全部拍平为一维,可以直接传入
Infinity。
2. 实战示例:分层展平与稀疏数组过滤
// 1. 默认展开 1 层
const matrix = [1, [2, [3, 4]]];
const flatOne = matrix.flat();
// 示例输出: [1, 2, [3, 4]]

// 2. 完全展平无限层级
const deepNested = ['a', ['b', ['c', ['d']]]];
const flatAll = deepNested.flat(Infinity);
// 示例输出: ['a', 'b', 'c', 'd']

// 3. 特性亮点:自动清除稀疏数组中的空洞(Empty Slot)
const sparseArr = [1, , 3, [4, , 6]];
const cleaned = sparseArr.flat(Infinity);
// 示例输出: [1, 3, 4, 6](原数组中的 empty 项被安全过滤)
3. 进阶拓展:flatMap() 的复合优势
flatMap 是 map() 与深度为 1 的 flat() 的有机结合。它在执行映射函数的同时将返回值直接展平一层,常用于文本分词、批量拆分或一对多映射处理:
const sentences = ['hello world', 'modern javascript guide'];
// 拆分单词并合并为一个扁平数组
const words = sentences.flatMap(s => s.split(' '));
// 示例输出: ['hello', 'world', 'modern', 'javascript', 'guide']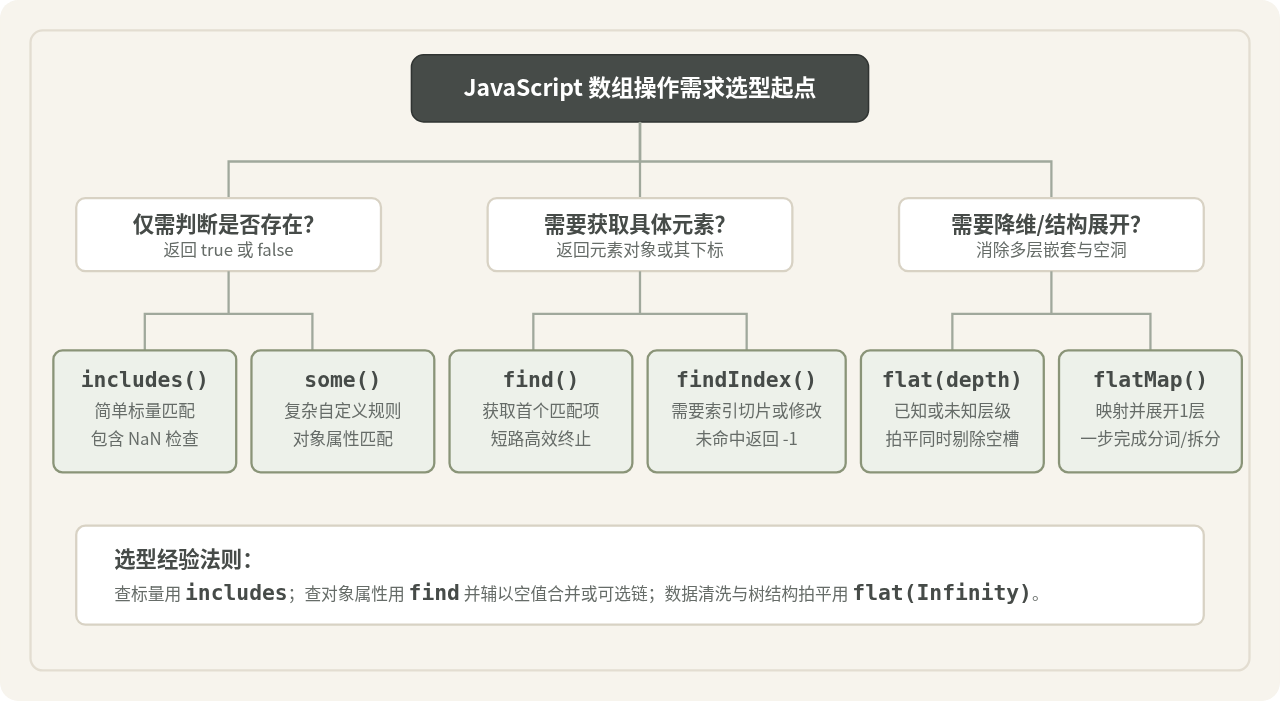
五、容易混淆的典型认知误区与实战辨析
误区一:“在对象数组中直接使用 includes 匹配目标对象”
常见写法:users.includes({ id: 101 })。
为什么看似合理:开发者直觉认为 { id: 101 } 已经写明了对象的属性特征,既然数组里有这项,理应返回 true。
为什么会失败:includes 使用 SameValueZero 比较值。在 JavaScript 中,每次以字面量形式书写的 { id: 101 } 都会在堆内存中开辟一个新的对象空间,两个对象的引用地址完全不同(即 { id: 101 } !== { id: 101 })。
修正方案:检索对象必须使用 find 检查属性(users.some(u => u.id === 101) 或 users.find(...)),或者确保传入的是同一个对象内存引用。
误区二:“把这三个方法都当成是 ES6(ES2015)发布的”
为什么看似合理:在日常工程交流和简历表述中,开发者习惯用“ES6”指代所有替代 ES5 的现代 JavaScript 语法扩展。
客观规范真相:三者分别发布于 ES2015(find)、ES2016(includes)和 ES2019(flat)。了解具体的发布年份有助于在配置 Babel 转译(如 @babel/preset-env)以及确定支持的 Node.js 运行时或浏览器基准版本时,准确引入对应的 Polyfill(如 core-js 模块)。
误区三:“无脑对所有多层数据使用 flat(Infinity)”
为什么看似省事:传入 Infinity 省去了手动计算或核对层级的麻烦。
潜在风险:如果数据源存在循环引用(例如某些链表或自引用对象构成的树结构),直接深度展平可能引发递归栈溢出;此外,如果数组内包含本就不该被拍平的元组或向量类型数组(如二维坐标点 [[x, y], [x2, y2]]),flat(Infinity) 会将坐标拆散成孤立标量,破坏数据原有的几何语义。应结合具体的业务结构传入明确的 depth。
六、场景选型速查与最佳实践总结
为了帮助在日常开发中迅速做出最准确的语法决策,以下整理了核心场景的判断依据表:
| 业务场景需求 | 推荐使用方法 | 替代方案缺陷 | 关键返回值特征 |
|---|---|---|---|
| 判断状态/标签是否在白名单中 | includes(item) |
indexOf !== -1 语义不够直观且不支持 NaN |
Boolean(true / false) |
| 根据主键 ID 查找单条用户数据 | find(item => item.id === id) |
filter()[0] 遍历全局且多分配临时数组 |
匹配对象 或 undefined |
| 获取符合条件的元素在数组中的下标 | findIndex(predicate) |
手写 for 循环代码繁琐且易写错边界 |
找到返回 0~N,未找到返回 -1 |
| 多层分类目录展开为统一列表 | flat(Infinity) |
手写递归逻辑繁琐且需额外维护深拷贝 | 全新的一维数组副本 |
| 对列表每个节点取子数组并合并 | flatMap(fn) |
map().flat() 多进行一次中间数组迭代 |
映射并拍平一层后的新数组 |
总结而言,现代 JavaScript 数组 API 的设计高度强调意图明确与性能短路:做标量包含判断首选 includes,做对象单项检索首选 find,做多层结构拍平与空位剔除首选 flat。在编写业务逻辑时,优先选用语义契合的原生方法,既能有效降低冗余代码量,也能使团队协同中的代码可读性与健壮性得到质的提升。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章