
深入讲解在JavaScript中将对象数组按指定属性转为逗号分隔字符串的标准做法,涵盖map与join组合、属性缺失与空值过滤、去重处理及性能选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS对象数组按指定属性转为逗号分隔字符串
作者:小括号
时间:2026-11-13
浏览:216
文章目录
JavaScript 开发技巧
在前端交互与后端 API 协作中,常需将包含多个对象的数组提取出某一字段并组装成逗号分隔格式(例如批量删除接口传递 ID 集合、表格多选参数组装等)。在 JavaScript 中,最清晰且标准的原生做法是使用 map() 方法提取目标字段,紧接着调用 join(',') 进行拼接。本文将详细拆解该模式的执行原理、常见边界情况处理方案及在各类数据特征下的选型建议。
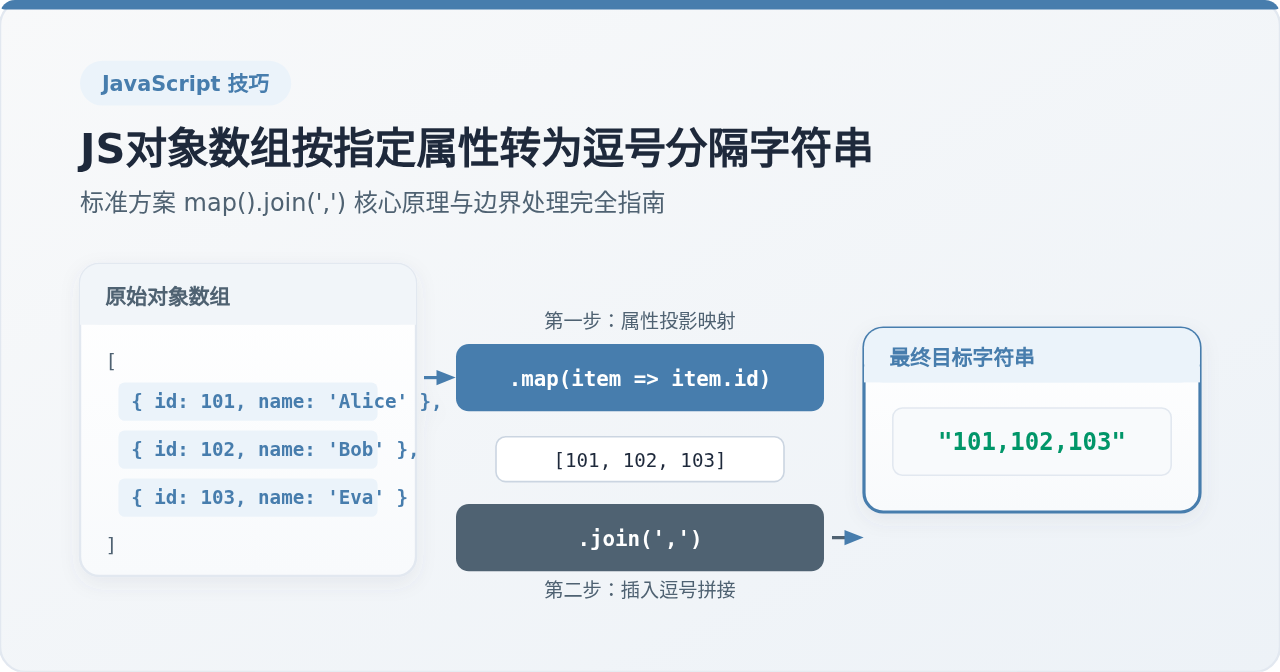
核心方案:map() 投影配合 join() 拼接
将对象数组转换为逗号分隔字符串分为两个核心动作:首先从结构化对象中提取出指定属性的值,形成由标量值(数字或字符串)组成的一维数组;随后在各元素间穿插指定的分隔符并组合为单个字符串。
// 1. 准备示例数据:用户对象列表
const userList = [
  { id: 101, name: 'Alice', role: 'dev' },
  { id: 102, name: 'Bob', role: 'qa' },
  { id: 103, name: 'Eva', role: 'ops' }
];

// 2. 提取 'id' 属性并拼接为逗号分隔字符串
const idsString = userList.map(item => item.id).join(',');
console.log(idsString);
// 输出示例: "101,102,103"

// 3. 提取 'name' 属性
const namesString = userList.map(item => item.name).join(',');
console.log(namesString);
// 输出示例: "Alice,Bob,Eva"
该方案的执行逻辑非常直观:
userList.map(item => item.id):遍历原数组的每一项,将返回的值按顺序放入一个全新的一维数组中,此时得到[101, 102, 103]。.join(','):将该数组的各项元素隐式转换为字符串,并以逗号作为定界符串联起来。该方法的一个关键特性是:仅在相邻元素之间插入定界符,首尾均不会出现多余的逗号;如果数组为空数组[],则直接返回空字符串""。
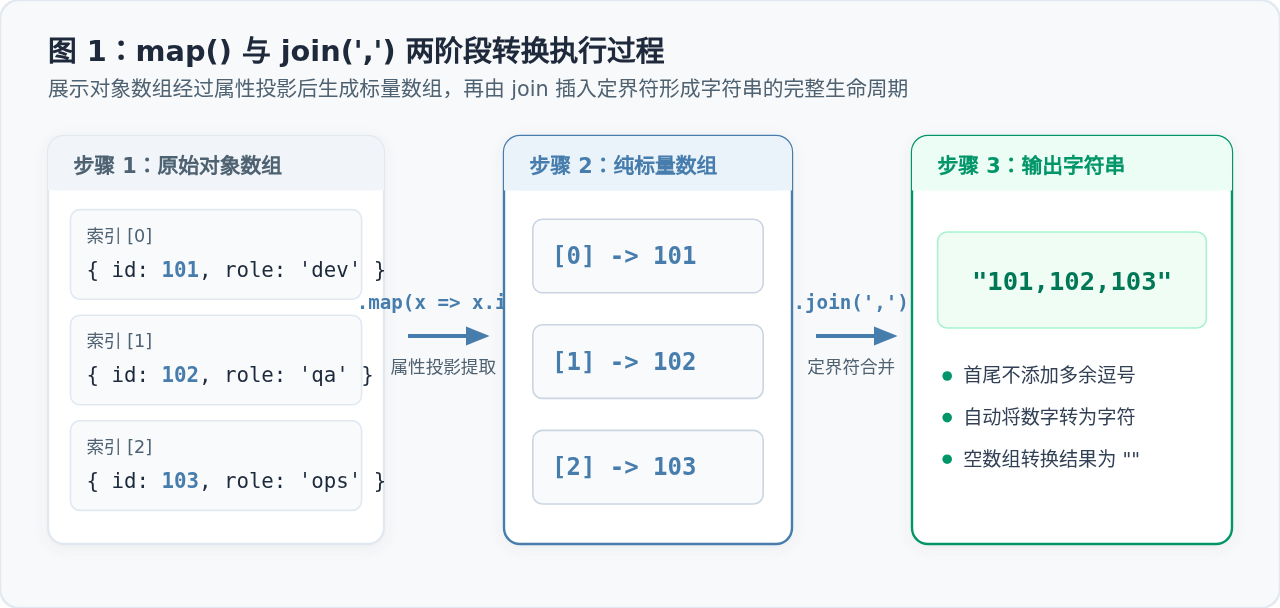
边界情况与健壮性处理
在真实的业务接口与用户输入环境中,原始数组往往包含残缺数据、属性不存在、空值(null / undefined)或重复数据。直接调用基础方案可能导致字符串中出现连续逗号(如 "101,,103")或报错。因此在生产代码中,需要针对以下场景增加防护。
1. 属性缺失与空值过滤
当数组中某个对象缺少目标属性,或其属性值为 null / undefined 时,join(',') 会将 null 与 undefined 视为空字符串处理,从而产生 "Alice,,Eva"。若需要跳过无效项,可使用 .filter() 进行清理:
const rawItems = [
  { id: 1, tag: 'Vue' },
  { id: 2, tag: null },
  { id: 3, tag: 'React' },
  { id: 4 }, // tag 属性缺失
  { id: 5, tag: 'Node' }
];

// 使用可选链提取,并通过 filter(Boolean) 剔除空值
const validTags = rawItems
  .map(item => item?.tag)
  .filter(Boolean)
  .join(',');

console.log(validTags);
// 输出示例: "Vue,React,Node"
注意:布尔过滤器的边界
如果目标属性的合法值可能包含数字 0 或空字符串 "",直接使用 filter(Boolean) 会将 0 一并过滤。此时应采用显式判断:.filter(val => val !== undefined && val !== null)。
2. 去除重复属性值(De-duplication)
在许多统计或查询场景中,提取出的属性可能存在重复(例如从订单列表中提取客户类型),此时需要借助 ES6 的 Set 集合去重后再拼接:
const records = [
  { role: 'Admin' },
  { role: 'User' },
  { role: 'Admin' },
  { role: 'Editor' }
];

// 利用 Set 去重后转回数组并 join
const uniqueRoles = [...new Set(records.map(r => r.role))].join(',');

console.log(uniqueRoles);
// 输出示例: "Admin,User,Editor"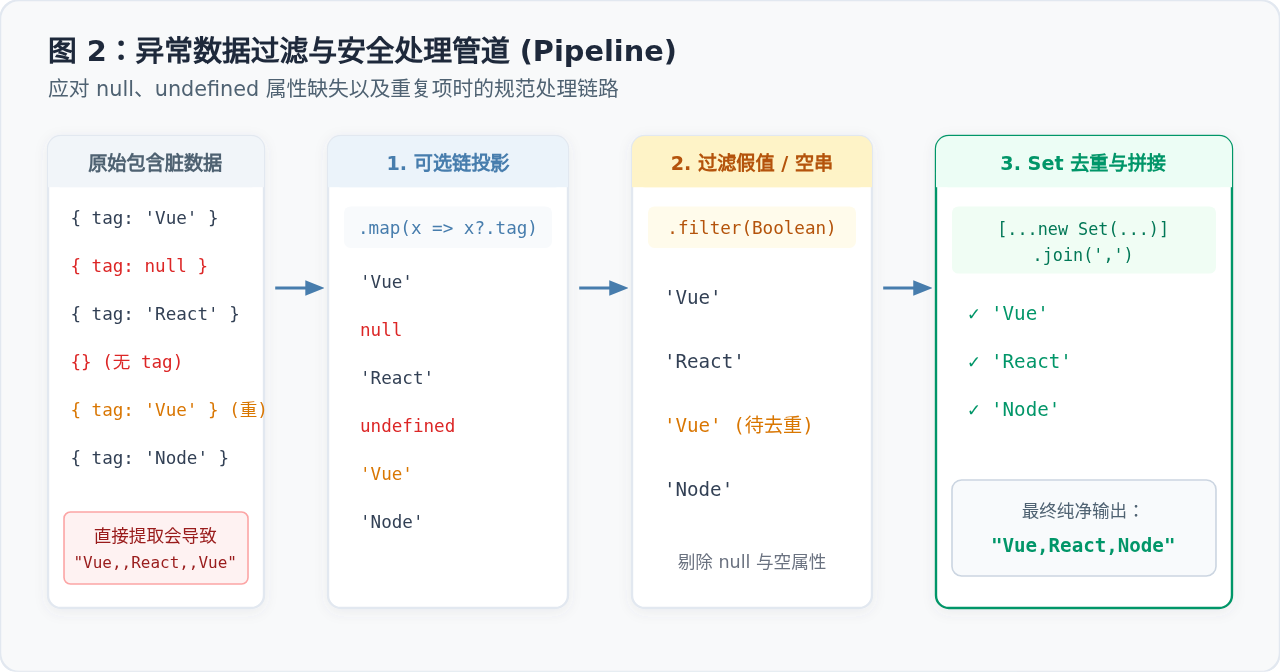
单次遍历方案:reduce() 与传统 for 循环
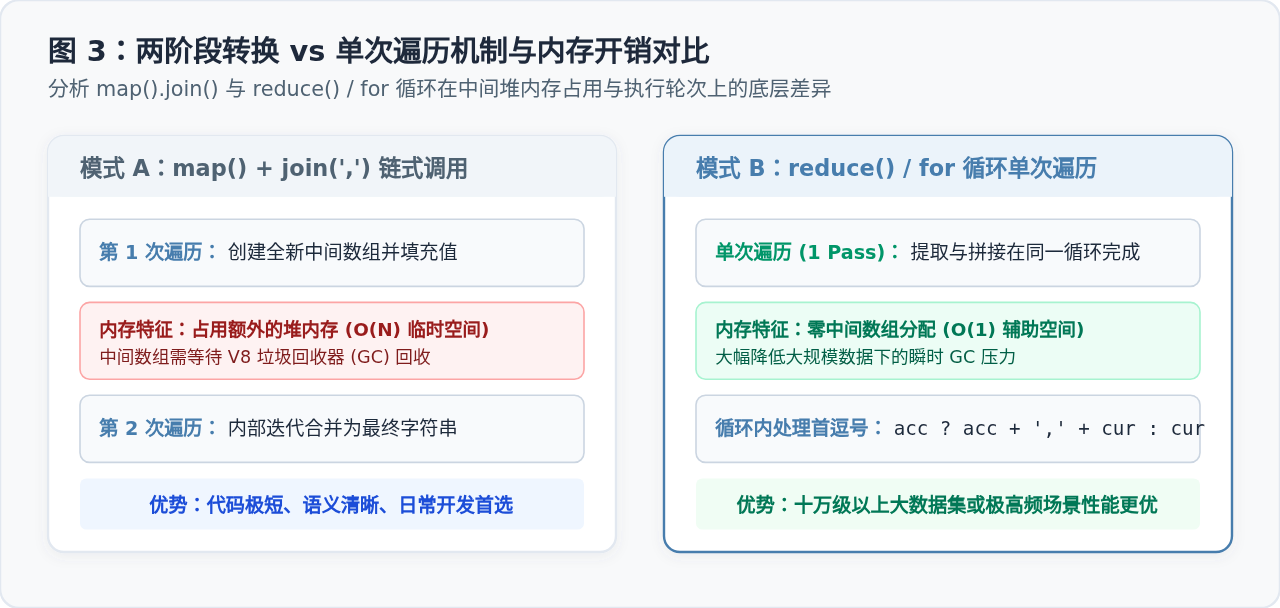
map().join() 链式调用由于语义清晰,是日常编码的首选。然而从底层实现来看,它至少遍历了两次数组,并且在第一阶段会创建一个大小为 N 的中间数组。在大多数百条、千条数据的常规业务中,这一额外开销微不足道。但在高频执行或包含数十万条大对象数组的场景下,可以考虑单次遍历(Single-pass)方式。
使用 Array.prototype.reduce()
const list = [{ id: 1 }, { id: 2 }, { id: 3 }];

const result = list.reduce((acc, cur) => {
  return acc ? `${acc},${cur.id}` : String(cur.id);
}, '');

console.log(result);
// 输出示例: "1,2,3"
使用 for...of 循环(大数据量极端优化)
若数据量达到几十万级别,字符串频繁拼接会产生大量的短暂中间字符串对象。此时使用数组手动缓冲或传统的 for 循环,其执行效率与内存可预测性最高:
function extractToDelimitedString(arr, propKey, separator = ',') {
  if (!Array.isArray(arr) || arr.length === 0) return '';

  let str = '';
  let isFirst = true;

  for (let i = 0; i < arr.length; i++) {
    const val = arr[i]?.[propKey];
    if (val !== undefined && val !== null) {
      if (!isFirst) {
        str += separator;
      } else {
        isFirst = false;
      }
      str += val;
    }
  }
  return str;
}
实现方案对比与选型指南
在编写生产环境代码时,应平衡“代码可读性”与“运行性能”。下表汇总了不同技术手段在不同业务场景下的特点:
| 方案 | 适用场景 | 代码简洁度 | 内存开销 | 空值/脏数据容忍度 |
|---|---|---|---|---|
map().join() |
常规业务开发(95% 场景) | 极高(单行) | 产生 1 个中间数组 | 需配合 filter 过滤 |
Set + map().join() |
存在重复属性且需去重 | 高(单行) | 产生 Set 与临时数组 | 需配合 filter 过滤 |
reduce() |
希望单次遍历合并 | 中等 | 无中间数组,但有临时字符串拼接 | 可在累加器内过滤 |
for 循环封装 |
超大数据集(十万级以上)或性能瓶颈热点代码 | 较低(需封装函数) | 极低,可预控内存 | 可在循环内同时做校验与格式化 |
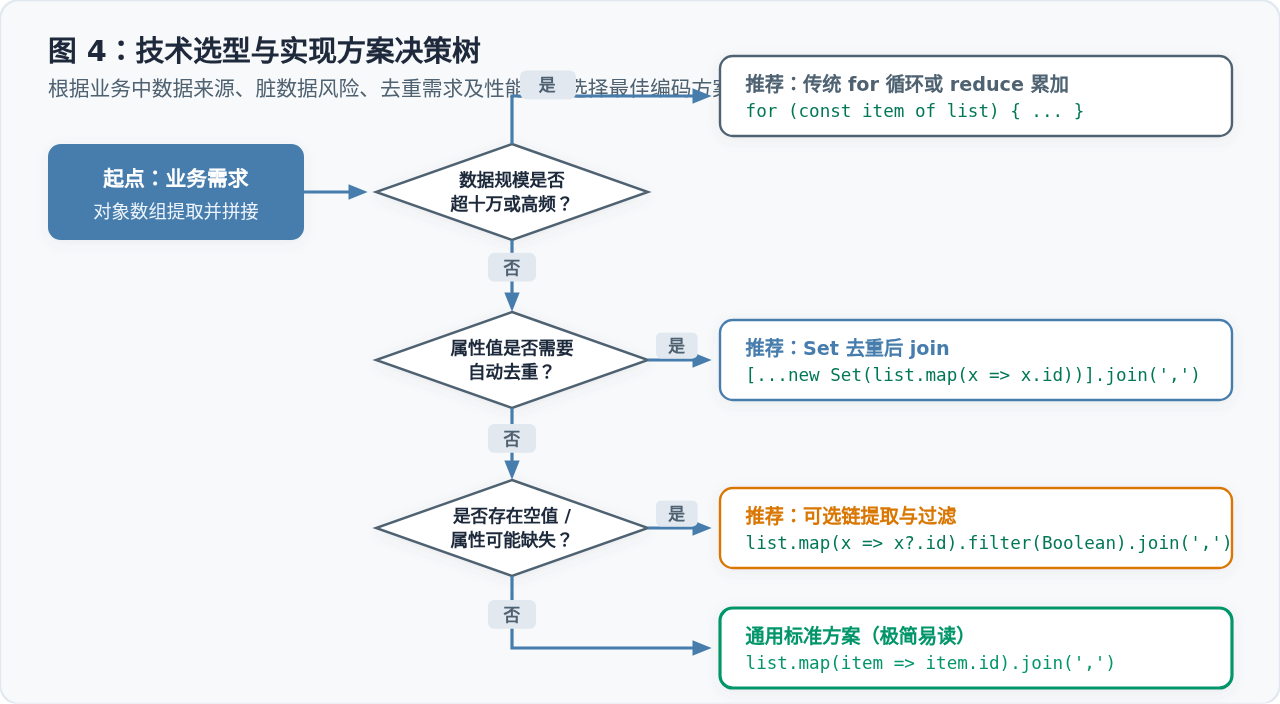
综合建议:绝大多数前端与日常 Node.js 业务中,优先使用标准且具备明确表达力的 list.map(item => item[prop]).join(',');当数据源不可靠时补上可选链 ?. 与 .filter(Boolean);唯有在性能监控或 Profiling 明确提示该处为内存或计算瓶颈时,再考虑替换为单次循环实现。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章