
全面整理JavaScript数组核心方法:按照增、删、改、查、遍历分类,系统解析原数组变异性、返回值差异、使用场景、代码示例及开发避坑要点。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组常用方法速查:增删改查与遍历操作详解
作者:小括号
时间:2026-11-12
浏览:141
文章目录
在 JavaScript 日常开发中,数组(Array)是最基础也是操作最频繁的复合数据结构。面对数十个内置的原型方法,记忆与选型的核心并非孤立背诵每个 API,而是把握两条主线:一是具体的操作意图(增、删、改、查、遍历),二是方法是否会产生副作用——即“是否修改原数组”。本文紧扣这两条脉络,提供详实的操作机制、返回值对比、代码示例及常见陷阱速查。
一、分类基石:原数组变异性与方法分类
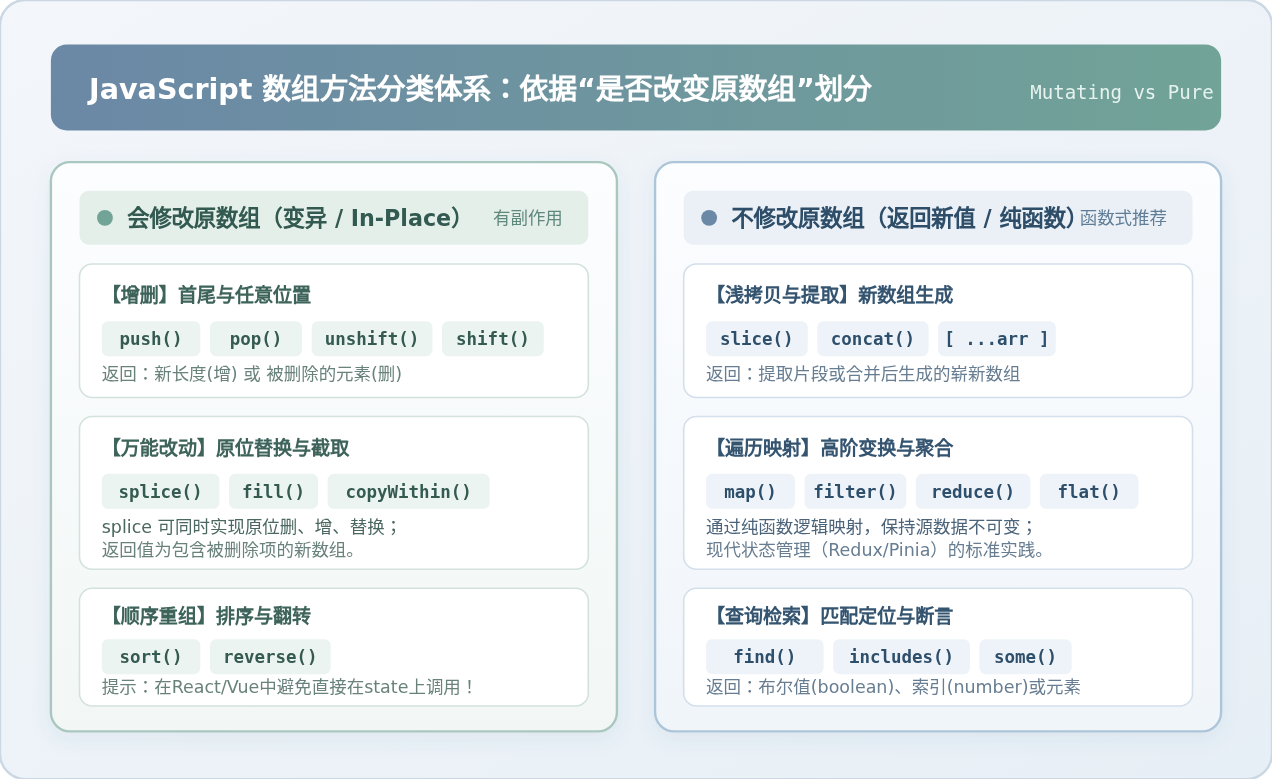
JavaScript 数组的方法在内存处理方式上存在本质分歧。一部分方法会直接修改原数组内存地址中的数据(被称为 Mutating / 变异方法);另一部分方法则不会触碰原数组,而是计算后返回一个全新的数组或结果标量(被称为 Non-mutating / 纯函数方法)。
在现代前端框架(如 React、Vue 3)的状态管理中,组件的重新渲染往往依赖浅层引用对比(Shallow Compare)。如果在状态上直接调用了变异方法,会导致对象内存引用未变而引发视图不更新;反之,若在需要就地排序的大数据量场景中反复创建新数组,则会带来不必要的垃圾回收开销。因此,明确每个方法的变异属性是写出稳健代码的第一步。
二、数组的“增”与“删”操作
数组元素的增加与删除可以发生在头部、尾部或中间任意位置。不同位置的操作在底层索引维护与执行效率上有着显著差异。
1. 尾部增删:push() 与 pop()
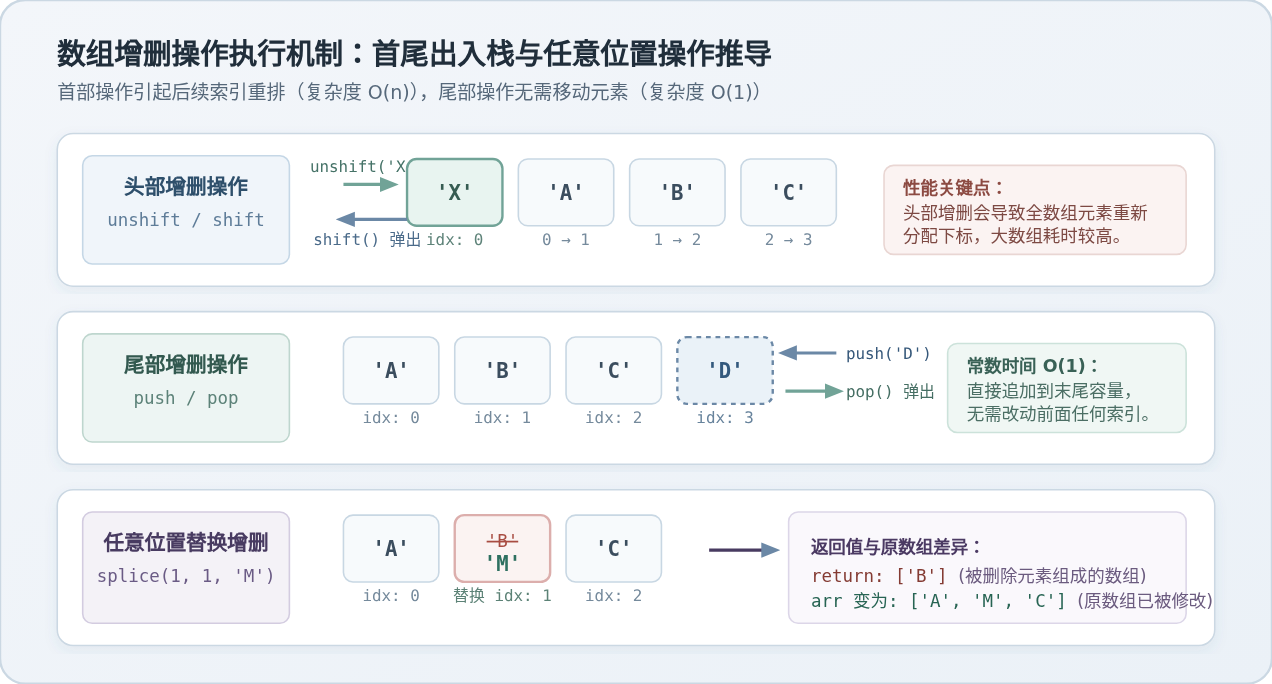
将数组当作后进先出(LIFO)的“栈”来使用。由于数组在内存中是连续分配或优化的线性结构,尾部操作不需要移动已有元素的下标位置,因而时间复杂度为 O(1),执行性能最高。
// 示例:末尾添加与弹出
const stack = ['苹果', '香蕉'];

// push():向数组末尾添加一个或多个元素,【返回修改后的数组新长度】
const newLen = stack.push('橙子', '桃子');
console.log(newLen); // 示例输出: 4
console.log(stack);  // 示例输出: ['苹果', '香蕉', '橙子', '桃子'] (原数组改变)

// pop():删除数组末尾最后一个元素,【返回被删除的元素】
const removedItem = stack.pop();
console.log(removedItem); // 示例输出: '桃子'
console.log(stack);       // 示例输出: ['苹果', '香蕉', '橙子'] (原数组改变)
2. 头部增删:unshift() 与 shift()
与 push/pop 结合可构成先进先出(FIFO)的“队列”结构。需要注意:在数组头部插入或删除元素时,引擎必须将后续所有元素的下标依次向前或向后挪动一位,时间复杂度为 O(n)。在包含成千上万条记录的超大数组中,应尽量避免频繁进行头部增删。
// 示例:头部添加与移除
const queue = ['任务B', '任务C'];

// unshift():在数组开头插入一个或多个元素,【返回修改后的数组新长度】
const lenAfterUnshift = queue.unshift('任务A');
console.log(lenAfterUnshift); // 示例输出: 3
console.log(queue);          // 示例输出: ['任务A', '任务B', '任务C'] (原数组改变)

// shift():移除并返回数组头部的第一个元素
const firstTask = queue.shift();
console.log(firstTask); // 示例输出: '任务A'
console.log(queue);     // 示例输出: ['任务B', '任务C'] (原数组改变)
⚠️ 返回值易混淆警示
初学者极易误认为 push() 和 unshift() 返回的是修改后的原数组,从而写出 const list = arr.push('新项') 的错误代码,导致 list 实际被赋值为数值类型的长度!切记:添加类返回新长度数字,删除类(pop、shift)返回被剔除出来的元素。
3. 任意位置增删改:splice()
splice() 是 JavaScript 数组中最灵活、功能最强大的原位修改方法。它接收三个阶段的参数:arr.splice(startIndex, deleteCount, ...itemsToAdd)。
// 示例:使用 splice 增、删、换
const letters = ['A', 'B', 'C', 'D'];

// 纯删除:从索引 1 开始删除 2 个元素
const deleted = letters.splice(1, 2);
console.log(deleted); // 示例输出: ['B', 'C'] (返回被删除项组成的数组)
console.log(letters); // 示例输出: ['A', 'D'] (原数组改变)

// 纯插入:从索引 1 开始删除 0 个元素,并插入新项
letters.splice(1, 0, 'X', 'Y');
console.log(letters); // 示例输出: ['A', 'X', 'Y', 'D']

// 替换:从索引 2 开始删除 1 个元素,并就地换成新值
letters.splice(2, 1, 'Z');
console.log(letters); // 示例输出: ['A', 'X', 'Z', 'D']
4. 纯函数不可变增删:concat()、扩展运算符与 slice()
若业务场景要求保持原数据绝对不可修改(如 Redux Reducer、Vuex 或 React 状态更新),必须使用返回新数组的纯函数方案。
- 不可变增加:使用 ES6 展开运算符
[...arr, newItem]或arr.concat(newItem)。 - 不可变删除:使用
arr.slice(start, end)浅拷贝指定区间切片,或使用arr.filter(item => item.id !== targetId)过滤生成新数组。
// 示例:不可变增删方案
const original = [1, 2, 3];

// 纯函数添加:原数组保持不变
const added = [...original, 4];
console.log(added);    // 示例输出: [1, 2, 3, 4]
console.log(original); // 示例输出: [1, 2, 3]

// 纯函数删除:剔除索引为 1 的元素
const removed = original.filter((_, idx) => idx !== 1);
console.log(removed);  // 示例输出: [1, 3]
console.log(original); // 示例输出: [1, 2, 3]
三、数组的“改”:原地修改与投影替换
对数组现有内容的修改分为“单值替换”、“批量填充”和“不可变数据转换”三种典型场景。
1. 原地修改:索引赋值、fill() 与 copyWithin()
最直接的修改方式是通过下标直接重写元素:arr[index] = newValue。除此之外,标准库还提供了批量修改方法:
// 示例:批量填充与内部复制
const buffer = [1, 2, 3, 4, 5];

// fill(val, start, end):将指定范围内的元素批量替换为固定值
buffer.fill(0, 1, 4);
console.log(buffer); // 示例输出: [1, 0, 0, 0, 5] (原数组改变)

// copyWithin(targetIndex, start, end):在数组内部复制序列并覆盖到 targetIndex
const seq = ['a', 'b', 'c', 'd', 'e'];
seq.copyWithin(0, 3, 5); // 将下标 3~4 的 ['d', 'e'] 拷贝到从下标 0 开始的位置
console.log(seq); // 示例输出: ['d', 'e', 'c', 'd', 'e']
💡 避坑:fill 填充对象类型的引用共享陷阱
当执行 new Array(3).fill({}) 时,三个位置填充的是同一个对象的内存引用!对其中一个对象的属性赋值,其他两处会同步变化。若需要初始化各自独立的对象数组,请使用 Array.from({ length: 3 }, () => ({}))。
2. 不可变更新:map() 投影替换
在处理业务对象列表时,我们通常需要“修改某个特定 ID 的项,并生成完整的新列表”,此时推荐使用 map() 结合对象浅拷贝:
// 示例:不可变修改对象数组中某一项
const users = [
  { id: 1, name: '张三', active: false },
  { id: 2, name: '李四', active: false }
];

const targetId = 2;
const updatedUsers = users.map(user =>
  user.id === targetId ? { ...user, active: true } : user
);

console.log(updatedUsers[1].active); // 示例输出: true
console.log(users[1].active);        // 示例输出: false (原数组未被污染)
四、数组的“查”:精准定位、包含判定与条件断言
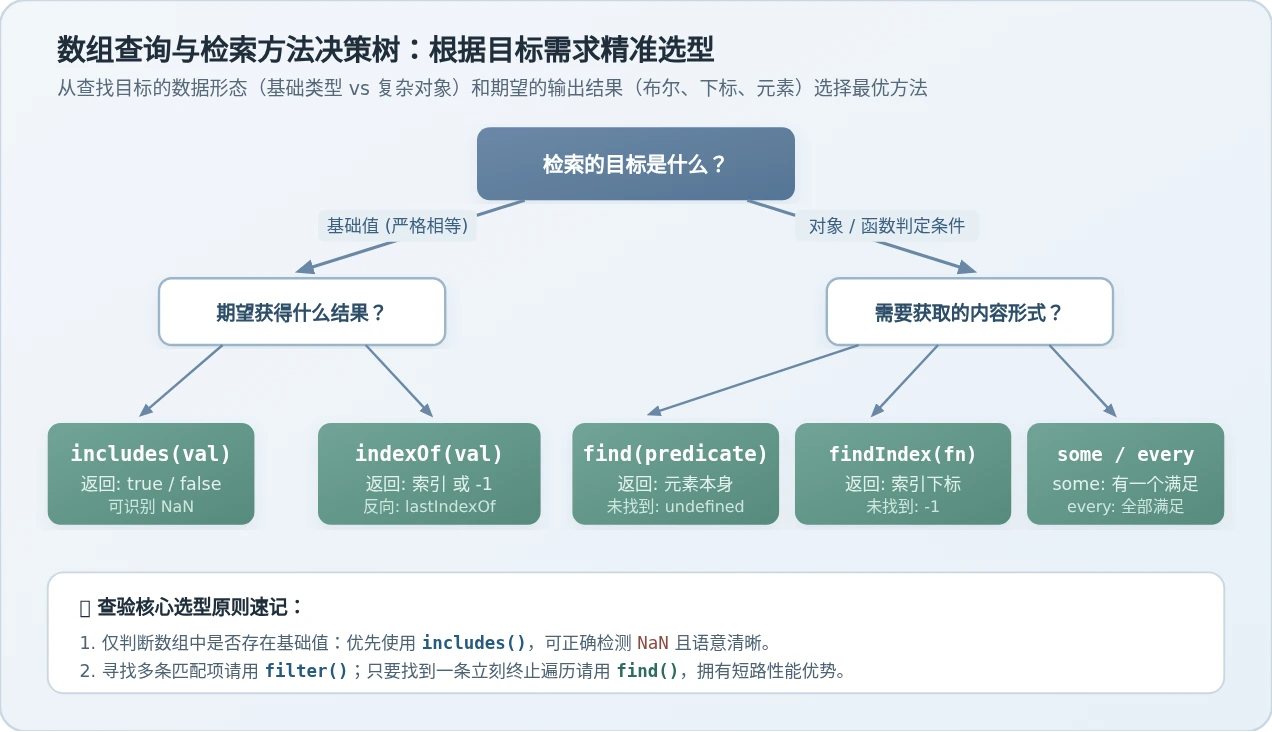
根据查询的目标是“简单基本值”还是“复杂条件对象”,以及期望返回的是“布尔值”、“下标索引”还是“元素自身”,JavaScript 提供了层次分明的检索 API。
1. 简单值检索:indexOf()、lastIndexOf() 与 includes()
indexOf(item, fromIndex):从前向后查找,基于严格相等(===)比对,返回首个匹配项索引,未找到返回-1。lastIndexOf(item, fromIndex):从后向前反向检索首个匹配项索引。includes(item, fromIndex):ES2016 引入,直接返回布尔值(true/false),且能够正确识别NaN([NaN].includes(NaN) === true,而[NaN].indexOf(NaN) === -1)。
// 示例:基础值查找对比
const fruits = ['apple', 'banana', 'orange', 'apple'];

console.log(fruits.indexOf('apple'));     // 示例输出: 0
console.log(fruits.lastIndexOf('apple')); // 示例输出: 3
console.log(fruits.includes('banana'));   // 示例输出: true
console.log(fruits.includes('grape'));    // 示例输出: false
2. 复杂条件检索:find()、findIndex() 与 findLast()
当数组元素是对象,或者需要按特定谓词函数(Predicate)查找时,必须使用接受回调函数的方法。它们具备“短路求值”特性——只要找到第一个符合条件的元素,就会立即终止遍历。
// 示例:条件查找
const accounts = [
  { id: 101, balance: 50 },
  { id: 102, balance: 320 },
  { id: 103, balance: 800 }
];

// find():返回第一个满足条件的元素;若没有匹配项,返回 undefined
const rich = accounts.find(acc => acc.balance > 300);
console.log(rich); // 示例输出: { id: 102, balance: 320 }

// findIndex():返回第一个满足条件的元素索引;若没有,返回 -1
const richIdx = accounts.findIndex(acc => acc.balance > 300);
console.log(richIdx); // 示例输出: 1
3. 集合状态断言:some() 与 every()
用于对整组数据进行逻辑判断,返回布尔值:
some(callback):只要数组中至少有一个元素满足条件就返回true,全不满足返回false(遇到 true 立即短路退出)。every(callback):要求数组中所有元素都满足条件才返回true,一旦遇到不满足项立即短路返回false。
💡 特殊逻辑:空数组上的 every 与 some
对空数组调用 [].every(fn) 将无条件返回 true(真空理论,没有任何元素违反断言);而 [].some(fn) 则无条件返回 false。在校验前置表单时须特别注意该行为。
五、数组的高阶遍历与聚合计算
遍历是数组处理中最核心的环节。传统 for 循环侧重命令式过程控制,而函数式高阶方法则侧重声明式数据流转换。
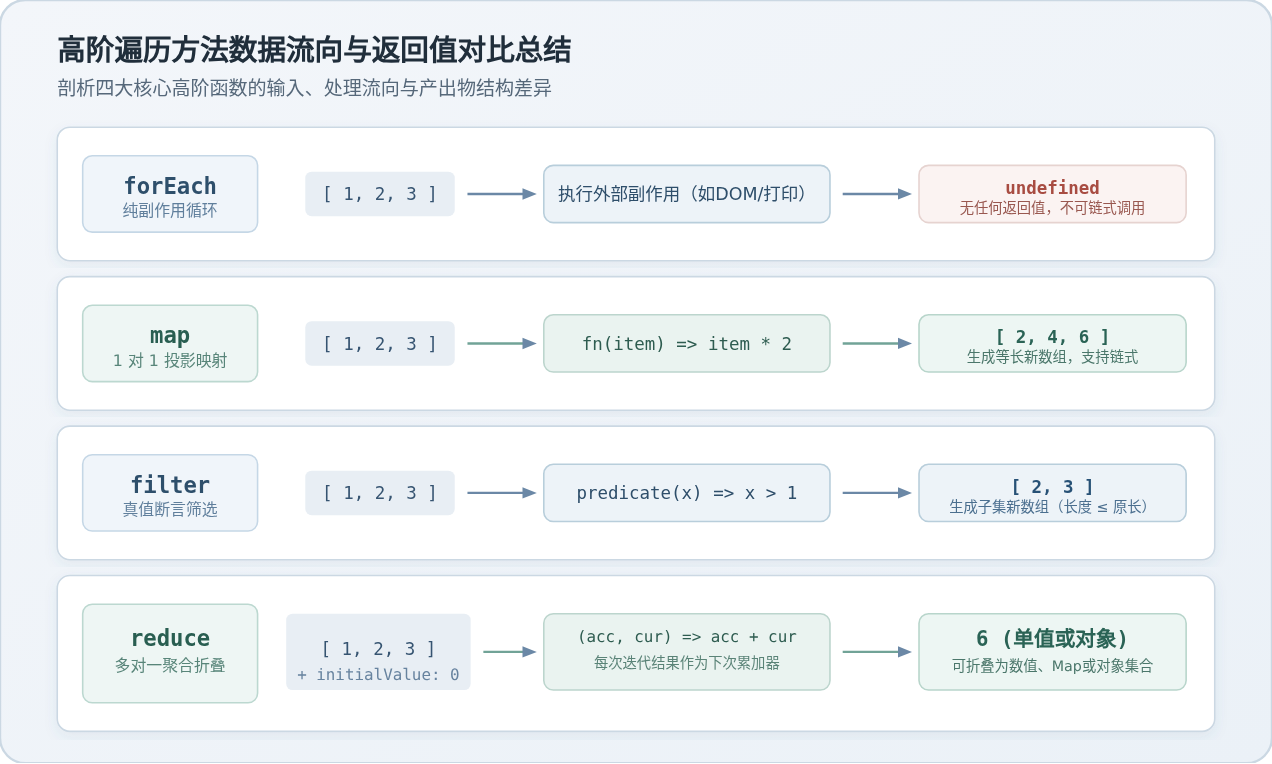
1. 纯副作用循环:forEach()
forEach() 对数组每个元素执行一次提供的函数,其特点是始终返回 undefined,且无法通过 break、continue 或 return 提前中止循环。如果需要在满足条件时提前退出循环,请使用常规 for、for...of,或者使用 some() / every()。
// 示例:forEach 仅用于产生外部副作用
const logs = ['警告A', '错误B'];
logs.forEach((log, index) => {
  console.log(`第 ${index + 1} 条: ${log}`);
});
// 示例输出:
// 第 1 条: 警告A
// 第 2 条: 错误B
2. 数据流变换:map() 与 filter()
map() 用于将原数组中的每一项经过函数映射转换为新值,生成一个等长的新数组;filter() 则根据断言函数的真假值进行过滤,生成一个长度小于等于原数组的新数组。两者均不修改原数组,非常适合链式组合:
// 示例:过滤并投影
const rawScores = [45, 88, 92, 59, 76];

// 筛选及格分数并格式化文案
const passedLabels = rawScores
  .filter(score => score >= 60)
  .map(score => `成绩: ${score}分`);

console.log(passedLabels);
// 示例输出: ['成绩: 88分', '成绩: 92分', '成绩: 76分']
3. 万能折叠聚合器:reduce()
reduce() 能够接收一个累加器(accumulator)函数和一个初始值(initialValue),通过遍历将数组多项收敛为单一结果(数值、对象、Map 或分组集合)。
// 示例 1:累加求和
const prices = [10, 25, 40];
const total = prices.reduce((sum, curr) => sum + curr, 0);
console.log(total); // 示例输出: 75

// 示例 2:按类别分组(GroupBy)
const goods = [
  { name: '苹果', category: '水果' },
  { name: '白菜', category: '蔬菜' },
  { name: '香蕉', category: '水果' }
];

const grouped = goods.reduce((acc, item) => {
  const key = item.category;
  if (!acc[key]) acc[key] = [];
  acc[key].push(item.name);
  return acc;
}, {});

console.log(grouped);
// 示例输出: { '水果': ['苹果', '香蕉'], '蔬菜': ['白菜'] }
⚠️ 严禁省略 reduce 的初始值参数
如果不提供 initialValue,reduce 会默认将数组第一个元素作为初始值,并从第二个元素开始循环。这在处理对象数组时会导致严重类型错误,而在空数组上调用省略初始值的 reduce 会直接抛出运行时异常:TypeError: Reduce of empty array with no initial value。
六、核心常用方法速查对照表
下表汇集了日常开发中使用频率最高的核心数组方法,供快速查阅变异性、参数与返回值特征:
| 方法名 | 操作归类 | 修改原数组? | 返回值类型 | 典型应用场景 |
|---|---|---|---|---|
push(...items) |
增(尾部) | 是 | Number(新长度) | 向尾部追加数据(栈进操作) |
pop() |
删(尾部) | 是 | Any(被删除项) | 弹出末尾数据(栈出操作) |
unshift(...items) |
增(头部) | 是 | Number(新长度) | 向开头插入项(需注意 O(n) 开销) |
shift() |
删(头部) | 是 | Any(被删除项) | 从开头出队项(队列机制) |
splice(i, del, ...add) |
增 / 删 / 改 | 是 | Array(被删项集合) | 原地任意位置截取、替换与插入 |
slice(start, end) |
查 / 截取 | 否 | Array(子切片) | 浅拷贝原数组或提取指定区间 |
concat(...items) |
增 / 拼接 | 否 | Array(新合并数组) | 不可变合并两个或多个数组 |
map(fn) |
改 / 遍历 | 否 | Array(等长新数组) | 一对一映射数据模型、提取属性 |
filter(predicate) |
查 / 过滤 | 否 | Array(子集新数组) | 条件筛选、不可变删除项 |
find(predicate) |
查(单项) | 否 | Any / undefined | 按特定条件查找首个匹配元素 |
findIndex(predicate) |
查(索引) | 否 | Number(索引或 -1) | 查找符合条件的项所在的索引位置 |
includes(val) |
查(包含) | 否 | Boolean | 检测简单值是否存在,支持 NaN |
reduce(fn, init) |
遍历 / 聚合 | 否 | Any(折叠单值或集合) | 数值累加、数据统计、多对一归并 |
sort(compareFn) |
排序(改序) | 是 | Array(原数组引用) | 就地重排元素(必须显式传比较函数) |
七、常见避坑总结
sort()默认字典序陷阱:[10, 2, 5].sort()的排序结果是[10, 2, 5]而非数值顺序!因为默认行为是将元素转化为字符串再按 UTF-16 码点比对。进行数值排序时,必须显式传递比较函数:arr.sort((a, b) => a - b)。splice与slice辨析:记住字母更多的splice是“做手术”,会直接改动原数组并返回被切掉的内容;而slice只是“切片拍照”,返回切下的新数组,绝不破坏原数组。map遗漏 return 语句:在箭头函数中使用大括号arr.map(item => { item.id })时,若未写return,生成的新数组将全为undefined。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章