
深入剖析JavaScript中负数使用parseInt与按位运算(如~~、| 0)取整时结果异常的底层原因,对比向下取整与向零截断的本质区别、ECMAScript ToInt32规范及科学计数法解析机制,并提供现代JavaScript取整的最佳选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JS取整陷阱:为什么负数用parseInt或位运算结果不对
作者:小括号
时间:2026-11-12
浏览:359
文章目录
JavaScript 技术专栏
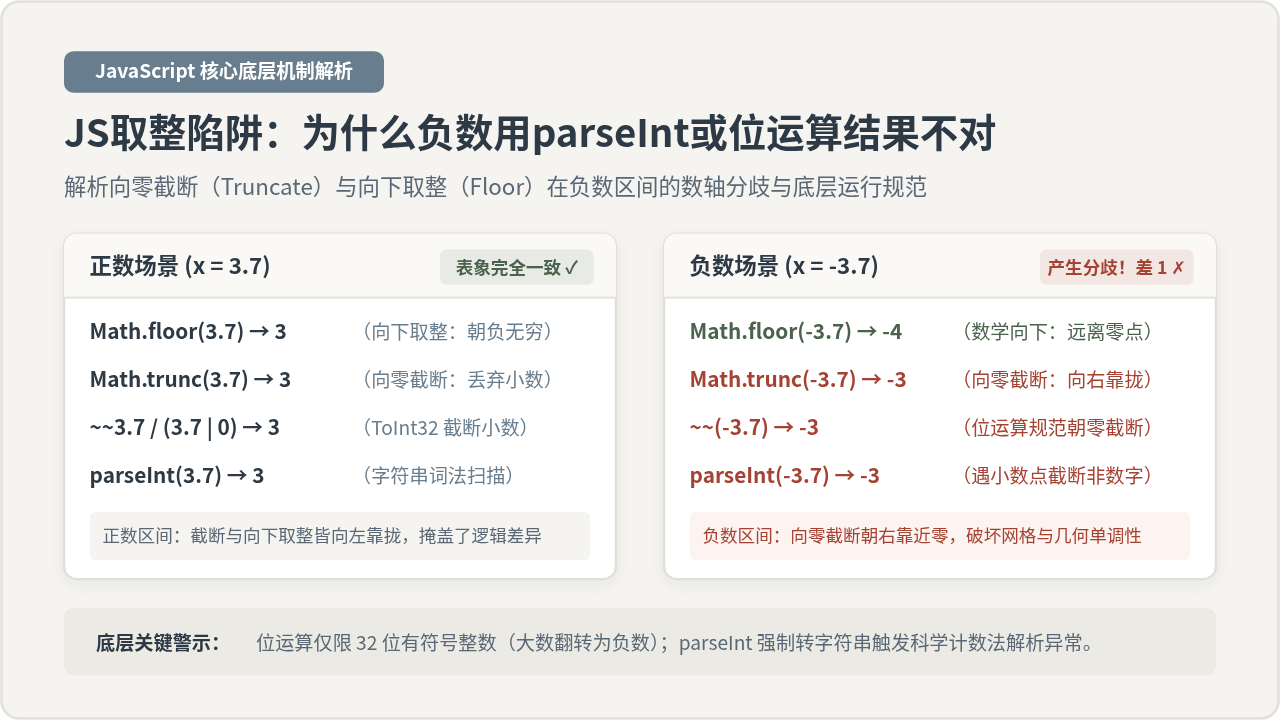
图 0:正数与负数在向下取整与向零截断时的表象重合与深层分歧
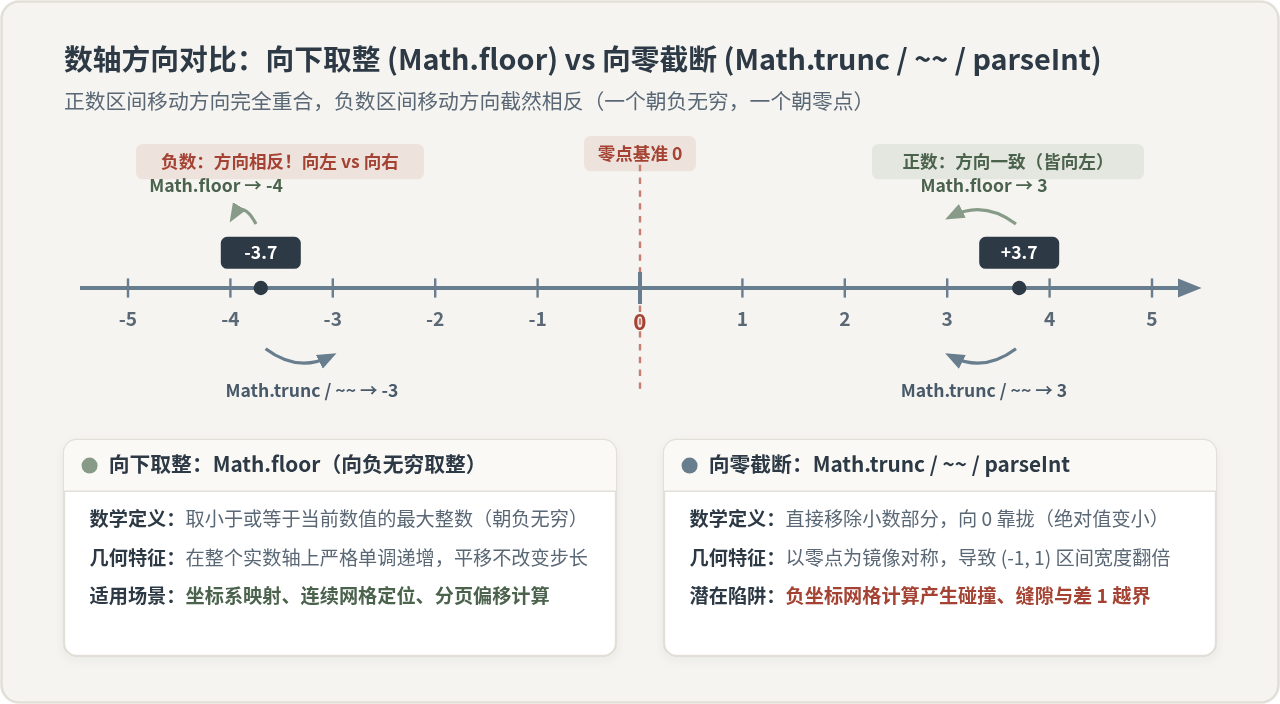
图 1:数轴上向下取整(向负无穷)与向零截断(向零点)的移动方向对比
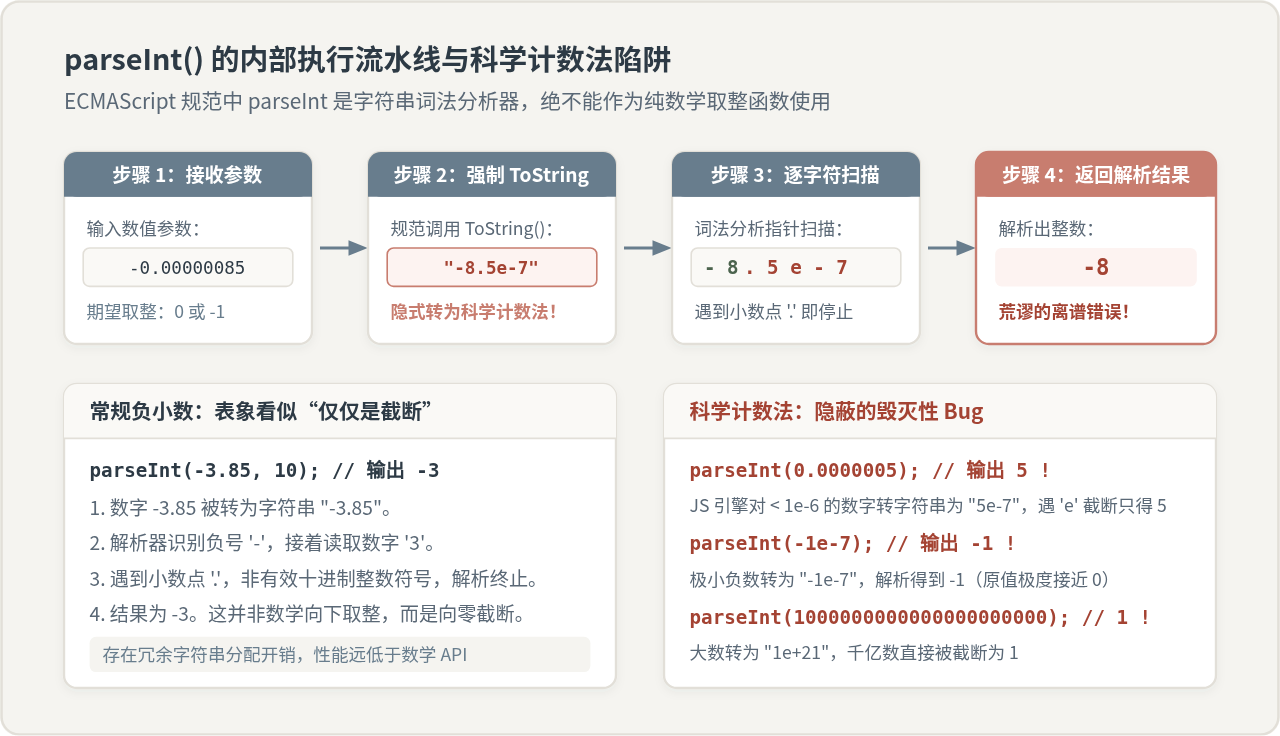
图 2:parseInt() 的字符流分析管线及科学计数法导致的灾难性错误
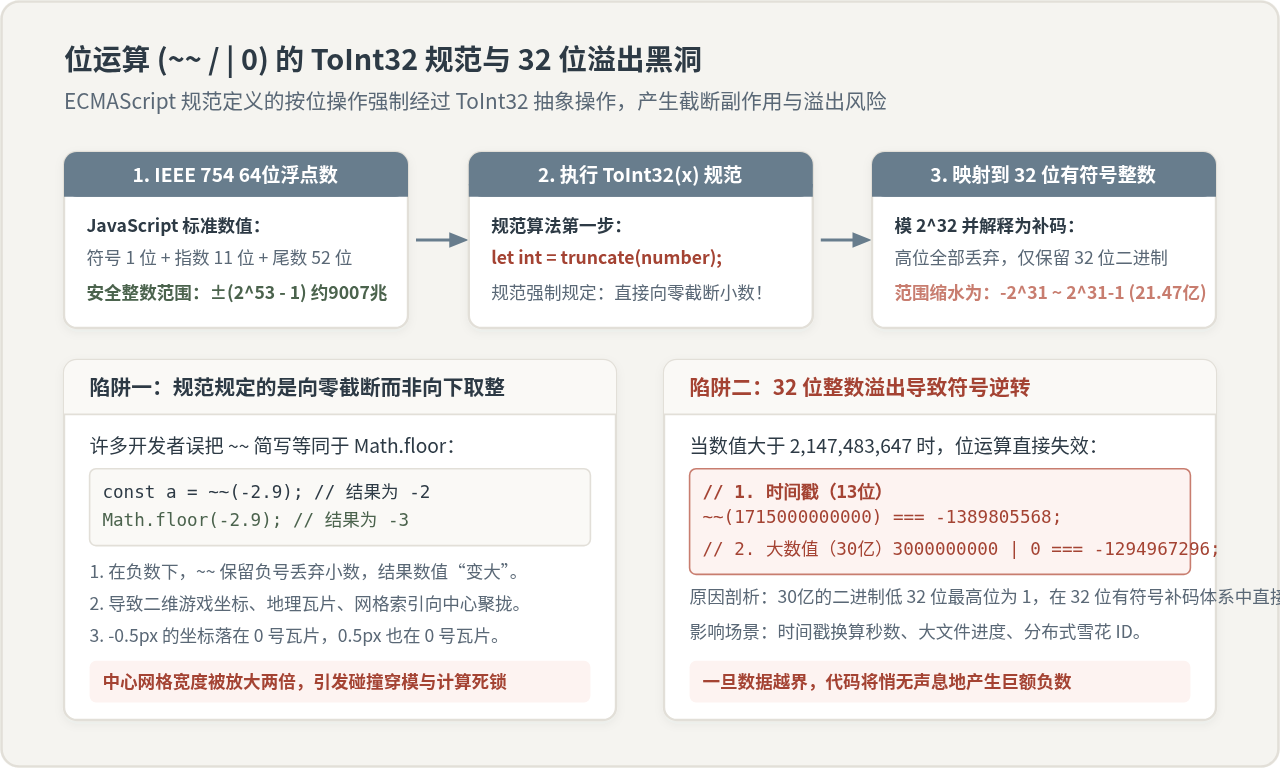
图 3:位运算执行 ToInt32 规范的处理流水线与 32 位补码溢出符号翻转机制
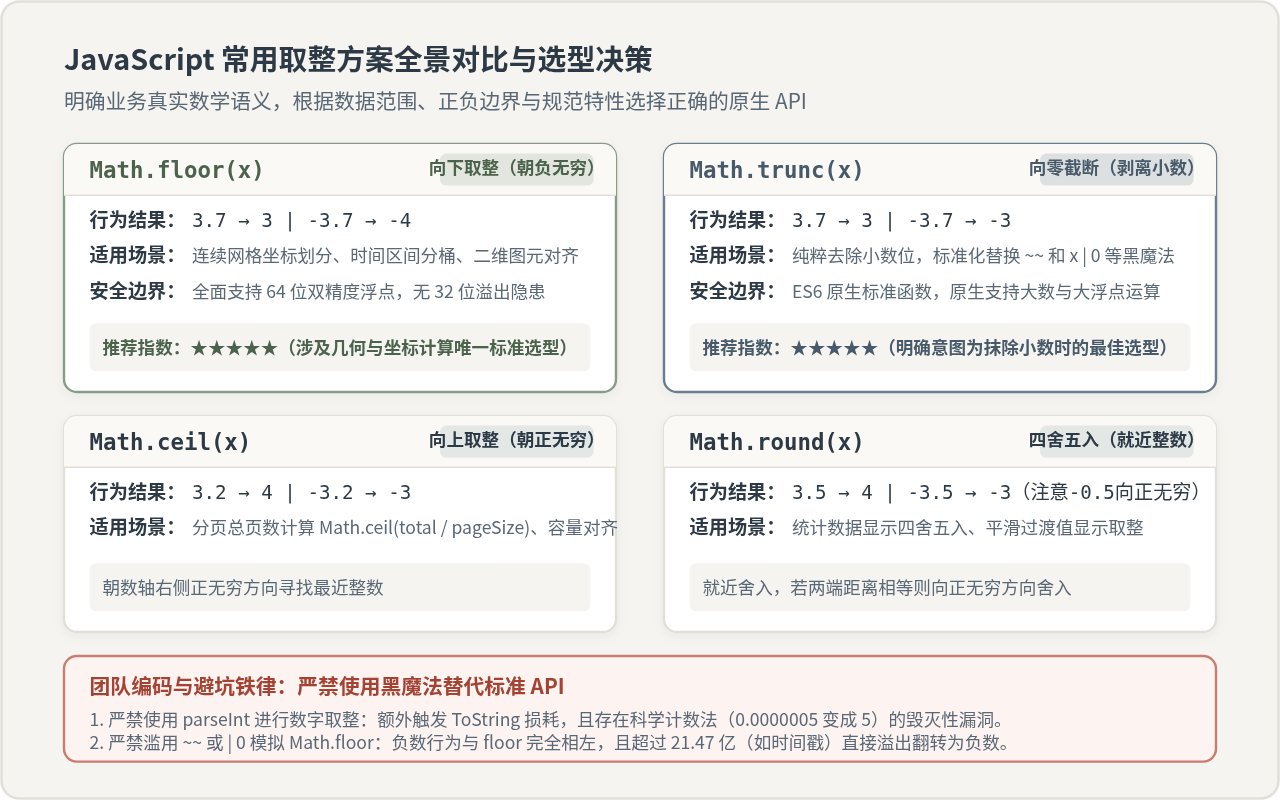
图 4:JavaScript 常用数值取整 API 选型全景矩阵与避坑决策树
在 JavaScript 中,许多开发者习惯随手使用 parseInt(x) 或双按位非 ~~x 对浮点数取整。在正数场景下,它们与数学上的向下取整表现完全一致;然而一旦遇到负数,代码便会频繁出现“差 1”的隐蔽缺陷。本文将直接剖析这一现象的核心根源:parseInt 和位运算在底层执行的是“向零截断”(truncate towards zero)而非真正的“向下取整”(floor),并结合 ECMAScript 规范阐明类型强制转换、科学计数法解析与 32 位补码溢出的机制与正确选型。
一、现象对比:为什么正数“好用”而负数“失灵”?
在快速开发中,我们经常能看到类似 ~~x、x | 0 或 parseInt(x) 的取整简写。当输入为正数时,这些方法看起来完美无瑕,但一旦输入包含负数,各方法的计算结果就会立刻产生分化:
// 正数场景:看似每种方法都输出了相同的整数 3
Math.floor(3.7);  // 3(向下取整:朝负无穷取整)
Math.trunc(3.7);  // 3(向零截断:抹除小数位)
~~3.7;            // 3(位运算执行 ToInt32 截断)
3.7 | 0;          // 3(按位或同样执行 ToInt32)
parseInt(3.7);    // 3(转换为字符串并扫描字符)

// 负数场景:分歧瞬间爆发!
Math.floor(-3.7); // -4(向下取整:向负无穷靠拢,值变小)
Math.trunc(-3.7); // -3(向零截断:直接扔掉 .7,向 0 靠拢)
~~(-3.7);         // -3(位运算按规范向零截断,不是 -4)
-3.7 | 0;         // -3(向零截断)
parseInt(-3.7);   // -3(向零截断)
这个差异之所以会演变成严重故障,是因为许多开发者在潜意识中将“取整”默认等同于“向下取整”(Floor)。在正数区间,朝负无穷方向取整(向左移动到 3)与向零点靠拢截断(向左移动到 3)恰好是同一个方向,因此掩盖了两种算法的本质差异。
而在负数区间,负无穷在数轴的最左侧,零点却在数轴的右侧。此时,数学上的向下取整必须向左远离零点(-3.7 走向 -4);而向零截断则是向右靠近零点(-3.7 走向 -3)。如果程序基于网格切片、连续日历行或二维地图瓦片进行坐标映射,向零截断会导致原本应该均匀分布的区间在 0 附近产生重叠与宽度翻倍,引发物体碰撞穿模或索引越界的严重错误。
业务场景警示:如果你的代码涉及坐标转换(如 Canvas 像素对齐、游戏网格索引、GIS 瓦片计算),任何从浮点数到单元格坐标的映射必须使用严格单调递增的
Math.floor。若误用 ~~x,负坐标区域的每个单元格都将整体向右错位 1 格,且 [-1, 1] 之间的中心单元格宽度会膨胀为两倍。
二、parseInt 的底层机制与隐蔽陷阱
很多初学者认为 parseInt 是 JavaScript 的通用整数提取函数,但根据 ECMAScript 官方规范,parseInt(string, radix) 实际上是一个针对“字符串文本”的字符流词法分析器,根本不是设计用于数学运算的截断工具。
当我们将一个数字传入 parseInt 时,引擎在底层经历以下完整执行阶段:
- 强制类型转换:引擎首先调用抽象操作
ToString(argument),将传入的数字强制转换为纯文本字符串。 - 前导字符与符号判定:跳过前导空白符,检查并记录首字符的正负符号(
+或-)。 - 词法逐字符解析:按照指定的进制(默认十进制)从左到右依次读取有效数字字符。一旦遇到任何不属于该进制的非数字字符(例如小数点
.、字母、科学计数法指数标记e),解析器便立即终止读取。 - 基数运算与返回:将已扫描的数字子串转换为整数数值返回。
1. 科学计数法导致的致命错误
由于第一步是无条件的 ToString 转换,一旦浮点数的绝对值极小(小于 1e-6)或极大(大于等于 1e21),JavaScript 引擎在输出字符串时会自动采用科学计数法表示。这一特性会导致 parseInt 给出完全背离常识的荒谬结果:
// 案例一:极小数值的灾难
const smallNumber = 0.0000005;
console.log(String(smallNumber));  // 输出 "5e-7"
console.log(parseInt(smallNumber)); // 输出 5 !(极小值取整竟然变成了 5)

// 案例二:极小负数的取整崩溃
const smallNegative = -1e-7;
console.log(String(smallNegative));  // 输出 "-1e-7"
console.log(parseInt(smallNegative)); // 输出 -1 !(原本极度接近 0 的负数,被解析成了 -1)

// 案例三:超大数值的截断失真
const largeNumber = 1000000000000000000000; // 10^21
console.log(String(largeNumber));  // 输出 "1e+21"
console.log(parseInt(largeNumber)); // 输出 1 !(千亿数值直接被削成 1)
2. 性能损耗与类型转换冗余
不仅逻辑脆弱,在现代 V8 等 JavaScript 引擎中,使用 parseInt 处理浮点数还会带来沉重的性能包袱。原本纯粹在 CPU 浮点寄存器内完成的数学指令,被强制降级为:分配堆字符串内存 → 格式化为 ASCII 字符串 → 逐字节遍历比对字符 → 再按十进制还原为整数。因此,无论从正确性还是运行效率考量,都绝不应该把 parseInt 当作数学取整函数。
三、位运算(~~、| 0)的底层原理与 32 位溢出黑洞
在很多老旧的 JavaScript 性能优化教程中,经常推荐使用双按位非 ~~x 或按位或 x | 0。开发者们之所以热衷于此,是因为在旧版引擎中位运算能绕过浮点函数调用开销。然而,这一写法背后隐藏着更为危险的规范限制。
1. 规范强制执行 ToInt32 抽象操作
根据 ECMAScript 规范,JavaScript 中所有的按位逻辑运算符在操作前,都必须先对操作数执行抽象操作 ToInt32(argument)。该规范的具体算法明确规定:
- 首先计算
let int = truncate(number),即在第一步就明确执行向零截断; - 随后对数值进行模
2^32计算,仅提取该整数在二进制补码下的最低 32 位; - 如果第 31 位(最高位,符号位)为
1,则将其解释为负整数;否则解释为正整数。
由此可见,位运算本身就不是“向下取整”(Floor),它的规范定义从底层第一步开始就是“向零截断”(Truncate)。因此负数使用 ~~(-3.8) 只能得到 -3。
2. 32 位有符号整数溢出:正数翻转为负数
JavaScript 的数字类型(Number)采用标准的 IEEE 754 双精度 64 位浮点格式,能够安全且精确地表示高达 9,007,199,254,740,991(约 9007 兆,即 2^53 - 1)的整数。
然而,位运算只支持 32 位有符号整数,其有效数值范围被死死锁死在 [-2^31, 2^31 - 1],即 [-2,147,483,648, 2,147,483,647](约 21.47 亿)。一旦处理的数值跨越了 21.47 亿的边界,高位数据就会被强制截断,原本为 0 的第 31 位如果被高位数值填充为 1,整个数字将直接翻转为毫无逻辑的负数:
// 陷阱一:现代 13 位毫秒级时间戳取整直接崩溃
const timestamp = 1715000000000; // 实际时间戳
console.log(~~timestamp);        // 输出 -1389805568 !(翻转为负数)
console.log(timestamp | 0);      // 输出 -1389805568

// 陷阱二:大文件传输字节(例如 3GB 视频文件)
const fileSize = 3 * 1024 * 1024 * 1024; // 3,221,225,472 字节
console.log(fileSize | 0);               // 输出 -1073741824 !(字节数变成负数)

// 正确做法:必须使用原生的 Math 标准函数
console.log(Math.floor(timestamp));      // 正确输出 1715000000000
console.log(Math.trunc(fileSize));       // 正确输出 3221225472
在今天的 Web 应用中,时间戳(以毫秒计早已破万亿)、文件断点续传字节、雪花算法 ID、大金额分币换算随处可见。在代码中保留 ~~ 或 | 0,如同在系统中埋下了一颗不知何时被特定大数引爆的定时炸弹。
四、如何正确选择 JavaScript 原生取整方法
ES6(ECMAScript 2015)早在多年前就正式引入了标准的 Math.trunc(),补齐了 JavaScript 原生数学库长期缺失“标准向零截断”的短板。在现代开发中,根本不需要依赖任何位运算黑魔法或 parseInt 字符转换。开发者只需根据真实的业务数学意图,直接选用对应的标准 API:
| 方法 | 数学取整意图 | 正数示例 (3.7) | 负数示例 (-3.7) | 核心适用业务场景 |
|---|---|---|---|---|
Math.floor(x) |
向下取整(朝负无穷) | 3 |
-4 |
空间坐标映射、网格定位、连续分桶计算 |
Math.trunc(x) |
向零截断(直接剥离小数) | 3 |
-3 |
纯粹丢弃小数部分,替代 ~~ 和 parseInt |
Math.ceil(x) |
向上取整(朝正无穷) | 4 |
-3 |
分页总数计算:Math.ceil(total / size) |
Math.round(x) |
标准四舍五入(就近) | 4 |
-4 (-3.7) / -3 (-3.5) |
报表汇总展示、百分比数值修约 |
现代引擎优化提示:在当代 V8(Chrome / Node.js)、JavaScriptCore(Safari)以及 SpiderMonkey(Firefox)引擎中,
Math.floor() 与 Math.trunc() 均会被 JIT 编译器直接编译为单个硬件级 CPU 汇编指令(如 x86-64 的 ROUNDSD 指令或 ARM64 的 FRINTM / FRINTZ 指令)。位运算早已没有任何运行速度优势,反而失去了代码可读性与大数安全性。
五、结论与编码规范建议
回到文章的核心问题:为什么负数使用 parseInt 或位运算结果不对?
- 取整方向不一致:两者的本质行为都是“向零截断”,在数轴负数区会朝右靠近零点;而大多数算法预期的取整是向数轴左侧无限延伸的“向下取整(Floor)”,两者在负数区方向相反,必然产生差 1 错误。
- 语义与规范约束:
parseInt面临隐式转字符串、丢失性能和科学计数法断裂的严重隐患;位运算(~~、| 0)则受到 32 位有符号补码范围的死板制约,数值越界即符号翻转。
在团队编码实践中,建议在 ESLint 中开启 no-bitwise 规则以禁止无明确位运算需求的 ~~ 和 | 0 操作,同时通过代码评审杜绝向 parseInt 传递非字符串参数。需要向零抹除小数时,一律使用语义清晰的 Math.trunc(x);需要向下离散对齐时,统一使用数学一致性可靠的 Math.floor(x)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章