
深入讲解JavaScript中包含中文的字符串转16进制不乱码的核心原理与实现方案,详细对比UTF-16码元与UTF-8字节流的本质区别,提供TextEncoder现代标准实现与老旧环境降级方法。

当前位置:首页 > JavaScript 基础 > 正文
JS含中文的字符串怎么转16进制不乱码
作者:清欢
时间:2026-11-13
浏览:480
文章目录
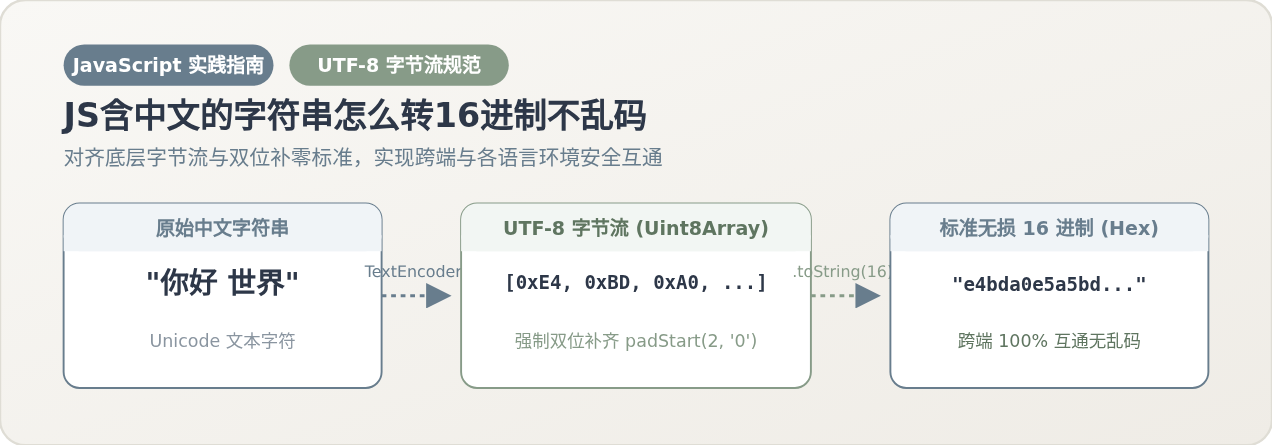
在 JavaScript 中,将包含中文字符的字符串转换为十六进制(Hex)时出现乱码,根本原因并不在十六进制计算本身,而在字符编码规范的不匹配:JavaScript 内部使用 UTF-16 内存码元表示字符,如果直接使用 charCodeAt() 提取字符数值,得到的是 UTF-16 内存码元;而网络传输、数据库持久化及各后端语言(Go、Python、Java 等)默认均严格基于 UTF-8 字节流 进行解析。解决跨端乱码的直接且标准的路径非常清晰:先使用现代规范的 TextEncoder 将字符串编码为标准的 UTF-8 字节序列(Uint8Array),再将每个字节转换为补齐双位的十六进制字符;反向解析时同样按每两位切片重组字节数组,并通过 TextDecoder 还原。本文将详细讲解这一完整转换流程、底层编码差异、关键避坑细节及老旧环境兼容方案。
一、为什么含中文的字符串转 16 进制容易产生乱码?
要彻底避免乱码,首先需要了解乱码产生的位置。许多初学者在转换字符串时,常常写出类似 str.charCodeAt(i).toString(16) 的代码。这种写法在处理英文字母和普通数字(ASCII 范围)时能够正常工作,因为 ASCII 字符在 UTF-8 和 UTF-16 中数值完全一致且都在单个字节范围内。然而,一旦遇到中文或特殊符号,两者就会出现致命脱节。
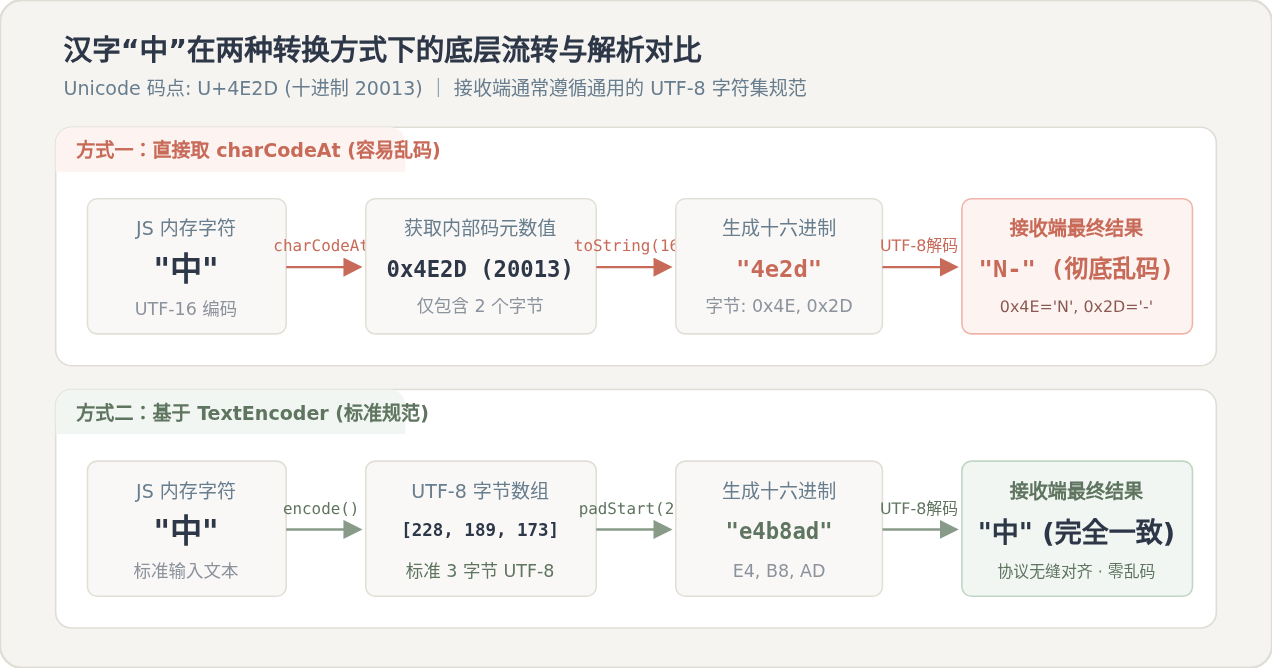
我们以常用汉字“中”为例,在一致的测试条件下观察两种处理方式的关键差异:
- 方式 A:直接提取 UTF-16 内存码元(
charCodeAt)
汉字“中”在 Unicode 中的码点是U+4E2D,十进制数值为20013。通过charCodeAt(0).toString(16),会得到十六进制字符串"4e2d"。这仅代表两个字节序列:0x4E和0x2D。当把这个结果发给后端(例如 Python 的bytes.fromhex("4e2d").decode('utf-8')或 Java、Go 服务),后端按 UTF-8 规则读取首字节0x4E(落在 ASCII 可见字符'N'的范围),随后的0x2D被解析为'-'。原本的“中”字被错误还原为"N-",甚至因后续非法字节直接触发解码崩溃。 - 方式 B:标准化转换为 UTF-8 字节流(
TextEncoder)
在标准的 UTF-8 编码规则中,汉字“中”占用 3 个字节:0xE4、0xB8、0xAD。转换后的十六进制字符串应为"e4b8ad"。接收端读取到0xE4(二进制高位以1110开头),明确识别这是三字节 UTF-8 序列的首字节,依次组合后续两个字节,便能 100% 精准无损地恢复汉字“中”。
此外,如果字符串中包含超出基本多语言平面的扩展字(如生僻字“𠮷”或 Emoji 表情),JavaScript 内部会使用两个 16 位码元(代理对 Surrogate Pair)存储,直接调用 charCodeAt() 只能读到单独的高代理项,导致数据直接断裂损坏。
二、标准解决方案:基于 TextEncoder 的完整转换
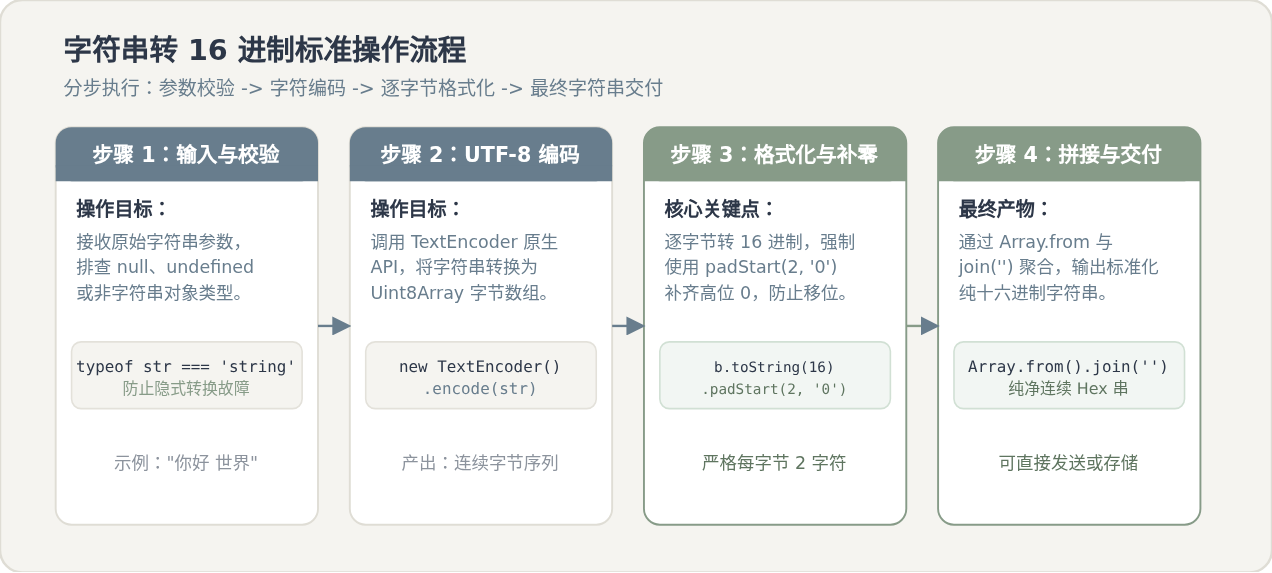
在所有现代浏览器环境以及 Node.js(从 Node.js 11 起全面原生支持)中,标准且高效的方案是使用 TextEncoder。整个转换可分为 4 个操作步骤:
- 参数防御校验:检查输入数据是否为合法字符串,防御性阻断
null、undefined或对象误传,防止运行时异常。 - 编码为 UTF-8 字节流:调用
new TextEncoder().encode(str),原生硬件级将字符串直接转换为Uint8Array字节数组。 - 逐字节转 16 进制并强制补零:遍历字节数组,对每个取值范围在
0 ~ 255的字节调用b.toString(16),并使用.padStart(2, '0')强制补齐为两位字符。 - 拼接与产出:使用
Array.from()配合.join(''),无缝拼接成纯净的十六进制长字符串。
1. 完整实现代码
/**
 * 将包含中文的字符串安全转换为十六进制字符串(基于 UTF-8)
 * @param {string} str 待转换的原始字符串
 * @returns {string} 十六进制字符串(全小写,每字节固定两位)
 */
function stringToHex(str) {
  if (typeof str !== 'string') {
    throw new TypeError('输入参数必须是字符串类型');
  }
  // 步骤一:创建 UTF-8 编码器并生成字节数组
  const encoder = new TextEncoder();
  const bytes = encoder.encode(str);

  // 步骤二与三:逐字节转换为双位十六进制字符并拼接
  return Array.from(bytes, byte => byte.toString(16).padStart(2, '0')).join('');
}
2. 执行验证示例
我们在控制台运行上述函数,观察输入与输出的精确对照:
// 示例 1:纯汉字转换
console.log(stringToHex("你好"));
// 示例输出: "e4bda0e5a5bd"
// 分析: "你" -> [e4, bd, a0] (3字节), "好" -> [e6, a5, bd] (3字节),共 12 位十六进制字符

// 示例 2:中英文及符号混合
console.log(stringToHex("Hello, 世界!"));
// 示例输出: "48656c6c6f2c20e4b896e7958c21"
// 分析: 英文与符号按单字节输出,中文"世界"按每字 3 字节输出,无缝衔接

// 示例 3:含扩展字符与 Emoji
console.log(stringToHex("你好👍"));
// 示例输出: "e4bda0e5a5bdf09f918d"
// 分析: Emoji "👍" 占 4 字节 [f0, 9f, 91, 8d],完美编码
三、逆向还原:16 进制安全转回中文字符串
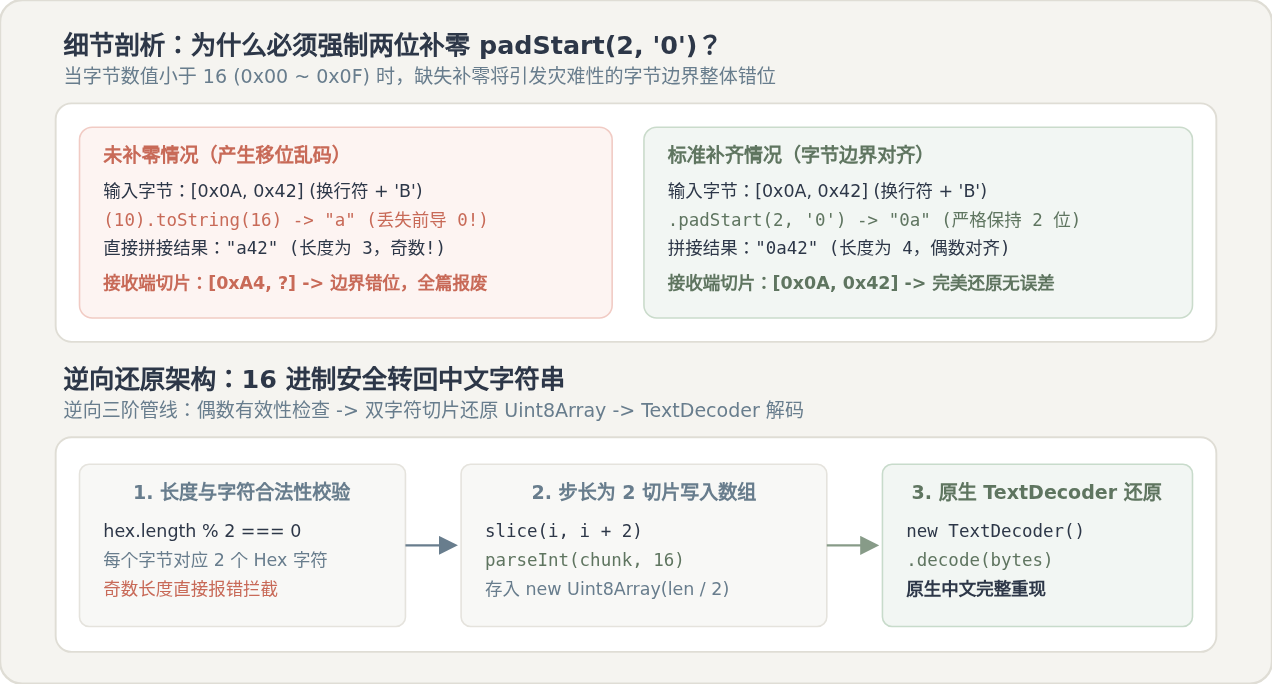
数据完成传输或存储后,接收端或逆向业务必须能够将十六进制精确还原为原始中文字符。逆向流程的核心是**“每两位还原为一个字节”**,重新填入 Uint8Array,最后由 TextDecoder 统一解码。
1. 完整逆向还原函数
/**
 * 将 UTF-8 十六进制字符串安全还原为原始中文字符串
 * @param {string} hex 十六进制字符串
 * @returns {string} 还原后的原始中文字符串
 */
function hexToString(hex) {
  if (typeof hex !== 'string') {
    throw new TypeError('输入参数必须是字符串类型');
  }
  // 清洗可能存在的空白符或 '0x' 前缀
  const cleanedHex = hex.trim().replace(/^0x/i, '').replace(/\s+/g, '');

  // 校验合法性:必须是偶数长度
  if (cleanedHex.length % 2 !== 0) {
    throw new Error('无效的十六进制字符串:长度必须为偶数');
  }

  const byteLength = cleanedHex.length / 2;
  const bytes = new Uint8Array(byteLength);

  for (let i = 0; i < cleanedHex.length; i += 2) {
    const byteHex = cleanedHex.slice(i, i + 2);
    const byteVal = parseInt(byteHex, 16);
    if (Number.isNaN(byteVal)) {
      throw new Error(`在位置 ${i} 检测到非法十六进制字符: "${byteHex}"`);
    }
    bytes[i / 2] = byteVal;
  }

  // 使用 TextDecoder 还原 UTF-8 字符串
  const decoder = new TextDecoder('utf-8');
  return decoder.decode(bytes);
}
2. 关键避坑细节:为什么必须强制两位补零?
在转换逻辑中,.padStart(2, '0') 绝不是可有可无的格式修饰,而是保证字节边界对齐的生命线。
移位灾难演示:
假设字符串中包含一个控制字符(如换行符
如果省略补零,
当逆向函数按照两位一切割时,前两位被识别为
假设字符串中包含一个控制字符(如换行符
,ASCII 码为 10,十六进制为 0x0A),紧接着一个字母 'B'(ASCII 码 66,十六进制为 0x42)。如果省略补零,
(10).toString(16) 只会返回单字符 "a"。拼装后的字符串变成 "a42"。当逆向函数按照两位一切割时,前两位被识别为
"a4"(十进制 164),剩下的 "2" 无法配对。原本独立的两个字节全部被错位扭曲,导致其后的全部中文序列整体错位 1 位,彻底沦为无法恢复的乱码。
四、老旧环境兼容降级方案
如果业务项目运行在非常特殊的历史环境(如旧版 WebView 或极低版本的嵌入式运行时),缺乏原生的 TextEncoder 和 TextDecoder 支持,可以利用经典的 encodeURIComponent 机制进行无依赖降级。
encodeURIComponent 原生按照 UTF-8 规范将非 ASCII 字符转换为百分号编码(例如“中”转为 "%E4%B8%AD")。利用这一天然特性,我们可以提取出纯净的 UTF-8 十六进制:
// 兼容老旧环境:字符串转 16 进制
function stringToHexLegacy(str) {
  const uriComponent = encodeURIComponent(str);
  let hex = '';
  for (let i = 0; i < uriComponent.length; i++) {
    const char = uriComponent[i];
    if (char === '%') {
      hex += uriComponent.slice(i + 1, i + 3).toLowerCase();
      i += 2;
    } else {
      hex += char.charCodeAt(0).toString(16).padStart(2, '0');
    }
  }
  return hex;
}

// 兼容老旧环境:16 进制还原为字符串
function hexToStringLegacy(hex) {
  const cleaned = hex.trim().replace(/^0x/i, '').replace(/\s+/g, '');
  let uriComponent = '';
  for (let i = 0; i < cleaned.length; i += 2) {
    uriComponent += '%' + cleaned.slice(i, i + 2);
  }
  return decodeURIComponent(uriComponent);
}
五、跨语言联调与常见问题排查
在实际生产中,前端用 JavaScript 生成十六进制后,往往需要发送到服务端进行解密、验证或入库。以下是主流后端语言的标准对齐方式:
| 语言/环境 | 逆向还原(Hex 转中文字符串) | 正向转换(中文字符串转 Hex) |
|---|---|---|
| Python 3 | bytes.fromhex(hex_str).decode('utf-8') |
s.encode('utf-8').hex() |
| Node.js (Buffer) | Buffer.from(hex_str, 'hex').toString('utf8') |
Buffer.from(str, 'utf8').toString('hex') |
| Go | b, _ := hex.DecodeString(s); str := string(b) |
hex.EncodeToString([]byte(str)) |
| Java | new String(HexFormat.of().parseHex(s), StandardCharsets.UTF_8) |
HexFormat.of().formatHex(s.getBytes(StandardCharsets.UTF_8)) |
联调过程中若依然遇到乱码,建议按以下三点依次排查:
- 排查 1:字节数是否对应。以常用汉字为例,每个汉字在 UTF-8 下应对应 6 位十六进制字符(3 个字节)。若每字仅有 4 位(2 字节),说明前端仍误用了
charCodeAt。 - 排查 2:十六进制字符串长度是否为偶数。若长度为奇数,必然是前导补零缺失或传输截断。
- 排查 3:文本首尾是否含有干扰符。某些系统导出的十六进制带有
0x前缀、空格或换行符,在解析前应使用正则表达式先行清洗。
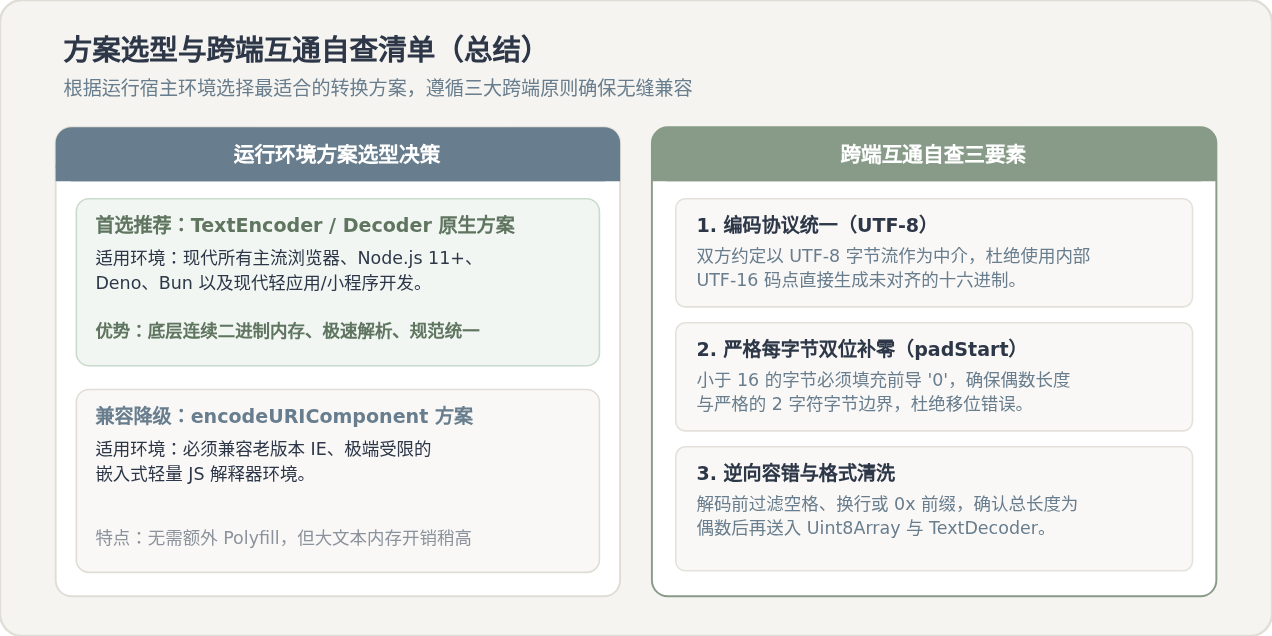
综上所述,处理含中文字符串转 16 进制的核心原则是以 UTF-8 字节流为基准、双位补零对齐边界。在现代项目中优先选用 TextEncoder 和 TextDecoder 原生 API,即可完全杜绝中文乱码,实现跨平台无缝互通。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章