
深入解析在JavaScript中循环拼接大量字符串时推荐使用Array.prototype.join的根本原因,从字符串不可变性、底层内存分配机制、V8引擎Rope结构及垃圾回收压力等维度进行全面剖析与代码实践对比。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS循环拼接大量字符串为何推荐用array.join
作者:巡夜人
时间:2026-11-12
浏览:272
文章目录
在 JavaScript 中,如果需要在循环中拼接大量字符串(如成千上万次),推荐使用
Array.prototype.join(即先将各部分字符串推入数组,最后统一 arr.join('')),其核心原因在于底层内存分配机制与垃圾回收(GC)效率。由于 JavaScript 字符串属于不可变的基元类型,传统的循环 += 拼接容易在底层引发频繁的内存重新申请、旧字符串二次拷贝以及大量的临时内存垃圾;而 array.join 可以在最后合并时一次性预计算整体容量,仅执行单次目标内存分配与顺序拷贝,从而提供稳定可预测的线性 \(O(N)\) 执行效率。
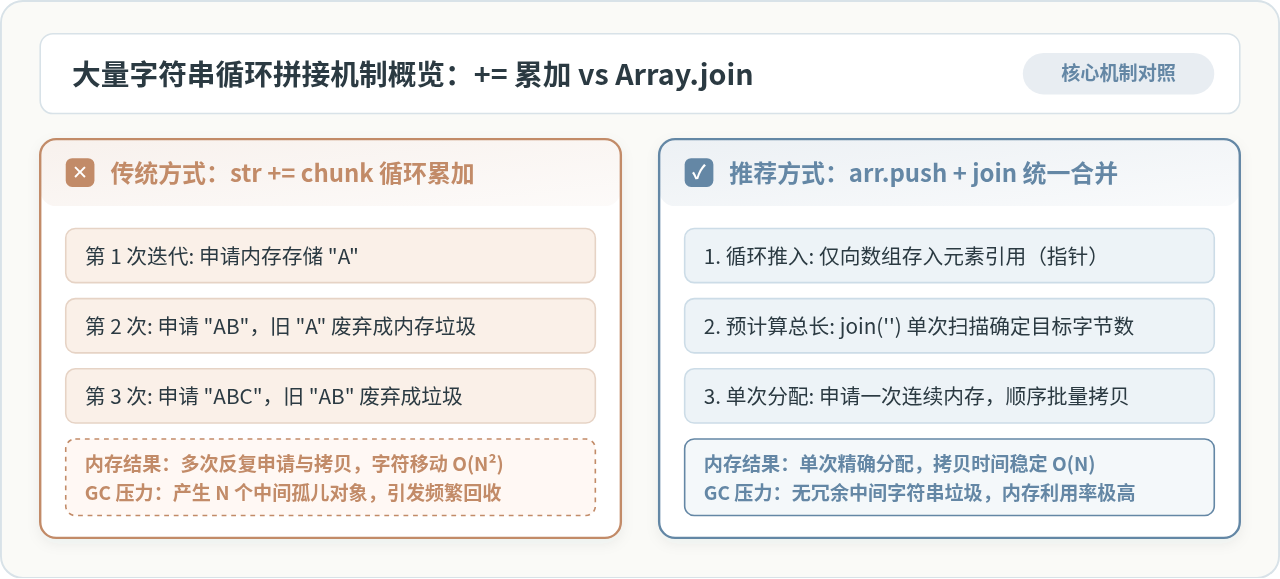
一、字符串不可变性与 += 循环累加的内存代价
要理解为什么不推荐在循环中使用 += 拼接大量字符串,首先需要明确 JavaScript 中字符串的底层特性。在 ECMAScript 规范中,字符串是不可变基元类型(Immutable Primitive)。这意味着一旦在堆内存中创建了一个字符串实体,它的字符内容与长度就不能被直接原地修改。
当执行简单的 str = str + chunk 操作时,运行时引擎并不能直接在原 str 的内存尾部追加字符。在传统的内存分配模型中,引擎必须执行以下三步:
- 计算新字符串的长度,向堆内存申请一块足以容纳两者的新内存缓冲区;
- 将原
str的内容完整复制到新内存的前半部分,再将chunk的内容拷贝到后半部分; - 将变量引用指向这块新分配的内存,原本的旧
str实例失去引用,沦为孤儿内存垃圾。
如果在一次循环中连续执行 \(N\) 次这样的拼接,每次循环都要把之前已经拷贝过的所有字符再次完整复制一遍。第 1 次拷贝 1 份,第 2 次拷贝 2 份,直到第 \(N\) 次拷贝 \(N\) 份。整个过程累计拷贝的字符量呈等差数列增长,公式为 \(rac{N(N+1)}{2}\),时间复杂度退化为 \(O(N^2)\)。
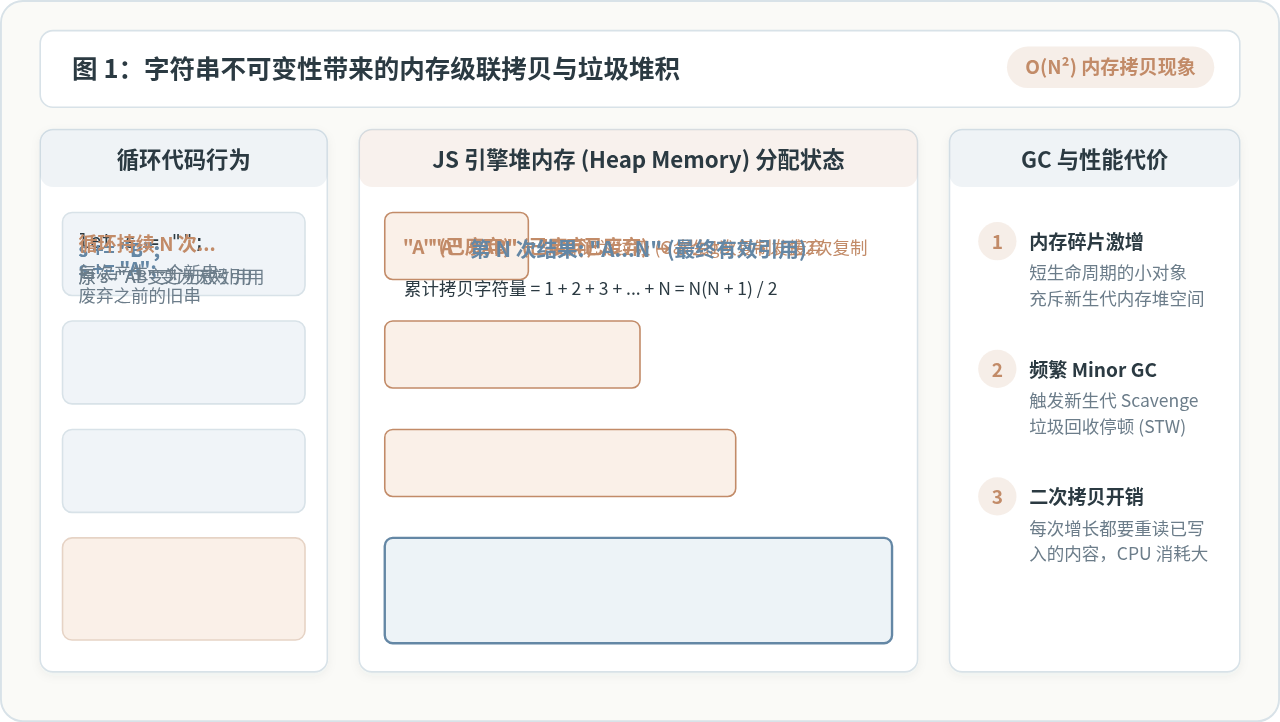
除了高昂的 CPU 拷贝开销外,更严重的隐患在于垃圾回收(Garbage Collection)压力。在循环体内,每次拼接都会产生一个生命周期极短的废弃字符串。在现代 JavaScript 引擎(如 Google V8)中,这些小对象会迅速填满新生代堆内存(New Space),从而频繁触发 Minor GC(Scavenge 算法)。垃圾回收器在清理和整理内存页时会导致主线程出现“Stop-The-World”停顿,直观表现就是页面掉帧或服务响应延迟飙升。
二、array.join 的运行原理与单次分配机制
与字符串的不可变性截然不同,JavaScript 中的数组(Array)是专为动态增删元素设计的集合结构。使用 arr.push() 配合 arr.join(''),本质上是将“连续多次动态内存申请”拆分为“轻量引用收集”与“集中单次分配”两个明确分离的阶段。
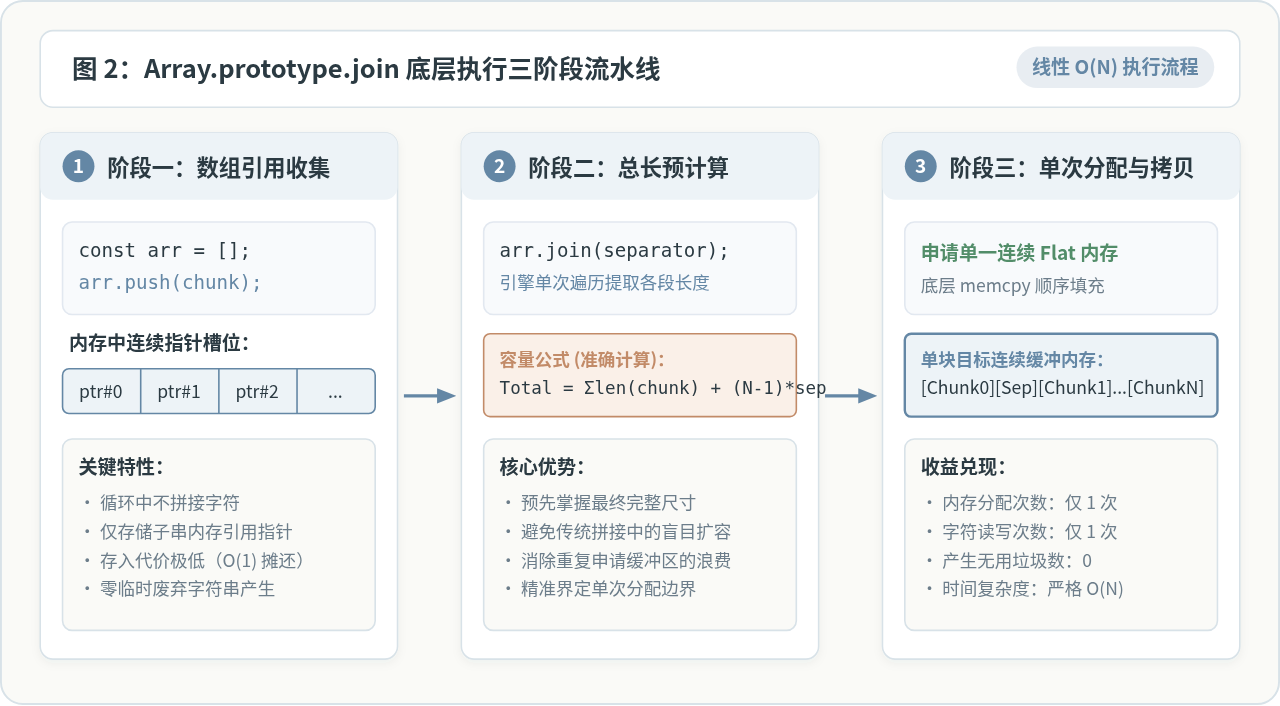
具体来说,array.join 的执行可以细分为三个关键阶段:
-
阶段一:引用收集(push)
在循环体内,调用arr.push(chunk)时,引擎仅仅是将字符串的内存指针(通常为 4 字节或 8 字节)写入数组连续的元素缓冲区中。此阶段不会发生任何字符串合并计算,也没有任何旧字符串被废弃,操作耗时摊还为 \(O(1)\)。 -
阶段二:总长预计算(pre-calculate)
当循环结束并执行arr.join(separator)时,引擎在底层 C++ 实现中首先进行一次快速的线性扫描,遍历数组中所有元素的指针,直接统计出每一个子串的确切字符长度,并加上分隔符所需的总长度。此时,目标字符串最终需要的内存字节数被一次性精准计算得出。 -
阶段三:单次分配与顺序填充(allocate & copy)
引擎直接向堆内存申请一块满足最终总长度的单一连续内存块(Flat String Buffer)。接着,引擎通过高效的底层内存批量拷贝函数(如memcpy),顺序将各个分段数据写入目标区域。这一过程每个字符仅被写入一次,无任何重复读写与临时对象,时间复杂度为严格的 \(O(N)\)。
三、现代 JS 引擎的 Rope 优化及其现实瓶颈
有的读者可能会问:现代浏览器和 Node.js 运行在高度优化的 V8 或 SpiderMonkey 引擎上,难道引擎没有对 += 进行优化吗?
答案是:引擎确实引入了优化,最典型的就是 V8 中的 Rope(绳索)结构,在 V8 源码中称为 ConsString。
当执行 s = s + chunk 时,V8 并不立即进行内存拷贝,而是创建一个轻量的二叉树节点 ConsString,该节点仅包含指向左子树 s 和右子树 chunk 的两个指针。通过这种延迟合并(Lazy Concatenation)策略,单次 + 操作被优化到了近似 \(O(1)\)。
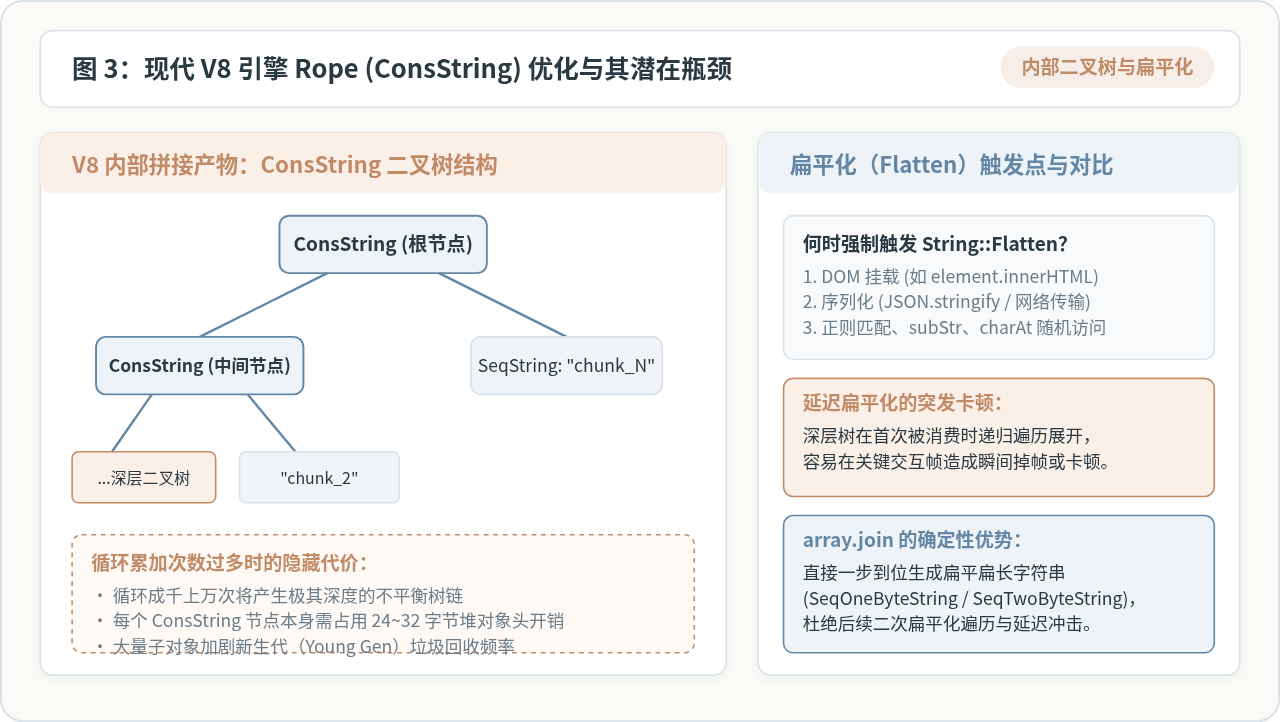
尽管 Rope 结构优化了拼接瞬间的耗时,但在循环拼接大量字符串时,它依然存在无法忽视的工程瓶颈:
-
树结构过深与节点内存开销:如果循环执行成千上万次,会生成一棵极其庞大且严重倾斜的非平衡二叉树。每个
ConsString节点本身是一个独立的 JavaScript 堆对象,包含对象头(Map/Shape 指针)和属性槽位(占用 24 到 32 字节)。大量小节点同样会给新生代垃圾回收造成沉重负担。 -
延迟扁平化(Flatten)带来的突发停顿:绳索树不能无限期保持二叉树状态。当最终字符串被消费——例如赋值给
element.innerHTML、通过网络发送、传给JSON.stringify、进行正则表达式匹配或随机索引访问charAt()时,引擎必须强制调用String::Flatten。该方法需要深度递归遍历整棵树,并在瞬间分配大内存完成合并。这种延迟执行的开销很容易在用户交互或关键业务帧上造成毫秒级的突发卡顿。 -
引擎去优化与跨平台差异:Rope 的深度限制和优化阈值在不同的引擎(如 Safari 的 JavaScriptCore、Firefox 的 SpiderMonkey 以及嵌入式 QuickJS)中各不相同。如果拼接过程中混入数字隐式转换或复杂作用域,引擎极易放弃 Rope 优化回退到物理拷贝。而
array.join在所有现代和传统引擎中都具有一致且稳定的线性执行路径。
四、典型代码模式与实现对比
在实际业务开发中,我们通常会遇到两种处理大批量数据的拼接场景:传统的命令式循环与现代函数式链式调用。下面通过具体代码展示推荐与不推荐的编写模式。
1. 循环构建场景:+= 模式 vs push + join 模式
// ❌ 不推荐:在大型循环中直接 +=
function buildReportBad(records) {
  let output = "";
  for (let i = 0; i < records.length; i++) {
    // 每次迭代产生废弃旧串与深层 ConsString 树
    output += `<tr><td>${records[i].id}</td><td>${records[i].name}</td></tr>
`;
  }
  return output;
}

// ✅ 推荐:收集到数组后统一 join
function buildReportGood(records) {
  const buffer = [];
  for (let i = 0; i < records.length; i++) {
    // 仅将子串指针入栈,零多余垃圾对象
    buffer.push(`<tr><td>${records[i].id}</td><td>${records[i].name}</td></tr>
`);
  }
  // 一次性计算总长度,单次分配并顺序拷贝
  return buffer.join("");
}
2. 函数式数据转换场景:map + join 惯用模式
在处理数据集合转换时,结合数组的高阶方法 Array.prototype.map 和 join,不仅性能优异,而且代码结构更紧凑、语义更声明化:
// ✅ 现代前端推荐的声明式拼装方式
function renderUserList(users) {
  return users
    .map(user => `<li class="user-item" data-id="${user.id}">${user.username}</li>`)
    .join("
");
}
注意细节:避免循环体内嵌套调用 join
array.join 的性能收益建立在“最后统一单次调用”的前提下。若在循环体内部反复构造小数组并调用 join(例如 for (...) { s += [a, b].join('-'); }),反而会反复创建数组实例与中间字符串,造成双重开销。
五、选型决策指南与方案对比
强调 array.join 的优势,并不意味着在所有场景下都应抛弃加号 + 或 ES6 模板字符串。不同规模与结构的字符串生成需求,应当匹配最适合的工具。
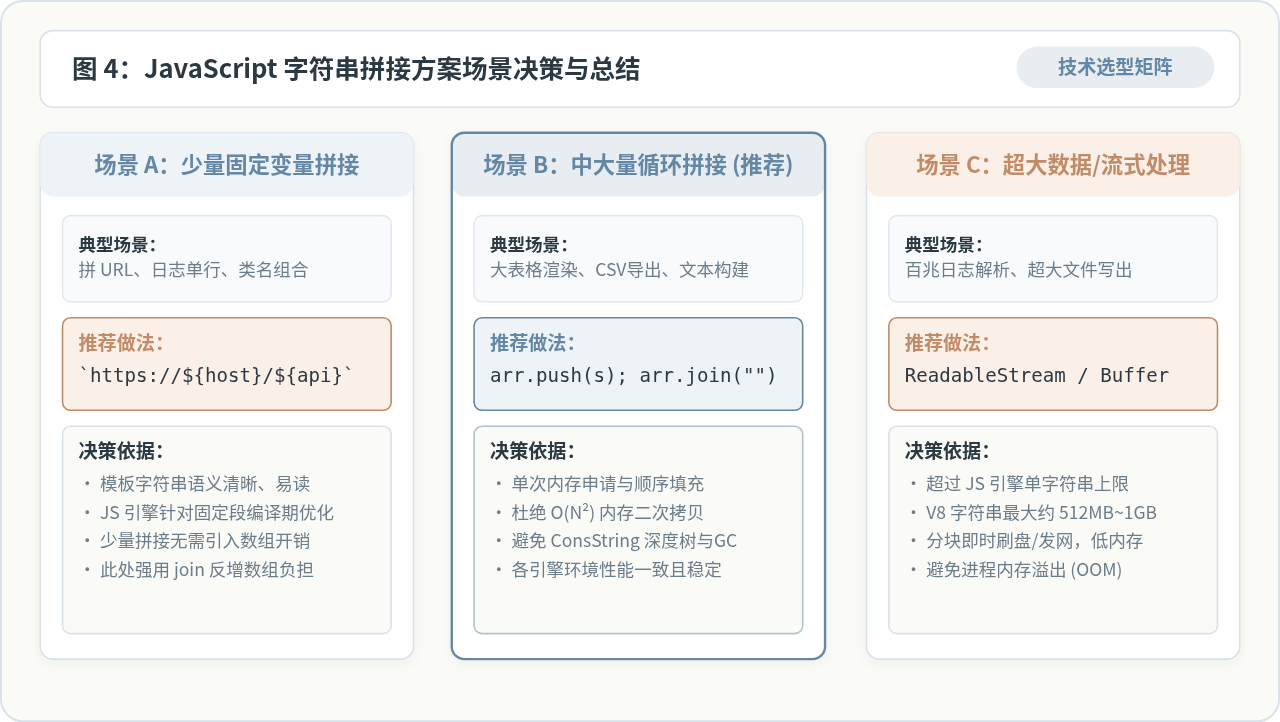
| 技术方案 | 适用数据规模 | 内存分配特征 | GC 影响 | 最佳实践建议 |
|---|---|---|---|---|
| 模板字符串 (``) / + | 少量固定变量(1~20次) | 编译期静态优化,就地拼接 | 几乎无影响 | 用于 URL 构建、报错信息、单行格式化,代码可读性最高。 |
| Array.push + join | 动态循环、成千上万项 | 预计算总长,单次连续分配 | 极低(无中间废弃串) | 批量 HTML 生成、表格渲染、大文本及 CSV 文件构建的标准首选。 |
| Stream / Buffer | 超大规模(数十兆至数G) | 定长分块流式处理,即时释放 | 平稳可控 | 服务端 Node.js 导出大文件、网络报文转发,避免单字符串溢出 V8 上限。 |
六、总结
总结来说,推荐在循环拼接大量字符串时使用 Array.prototype.join,主要源于以下三点客观事实:
- 尊重不可变性规则:避免了
+=累加过程中不断抛弃旧串所产生的 \(O(N^2)\) 字符拷贝代价与内存碎片; - 确定性的单次分配:
join能够在合并前精准统计总字符长度,一次性申请最终内存并执行底层批量拷贝,运行表现呈严格的线性 \(O(N)\); - 减轻 GC 压力与规避卡顿:即便现代引擎提供了 Rope 优化,过深的二叉树节点依然会占用大量对象头并引发滞后的扁平化卡顿,而
array.join直接产出连续平铺字符串,保障了全链路的执行平稳性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章