
深入解析前端页面如何实现JSON数据的高亮格式化展示。从JSON.stringify缩进排版到正则语法分词、XSS实体安全转义、CSS色彩映射,以及第三方库选型与生产性能优化,提供完整可落地的纯原生代码和实践指南。

当前位置:首页 > JavaScript 基础 > 正文
前端页面怎么实现JSON数据的高亮格式化展示
作者:巡夜人
时间:2026-11-05
浏览:642
文章目录
前端工程
JavaScript 原生实现
Web 安全防御
阅读时长:约 8 分钟
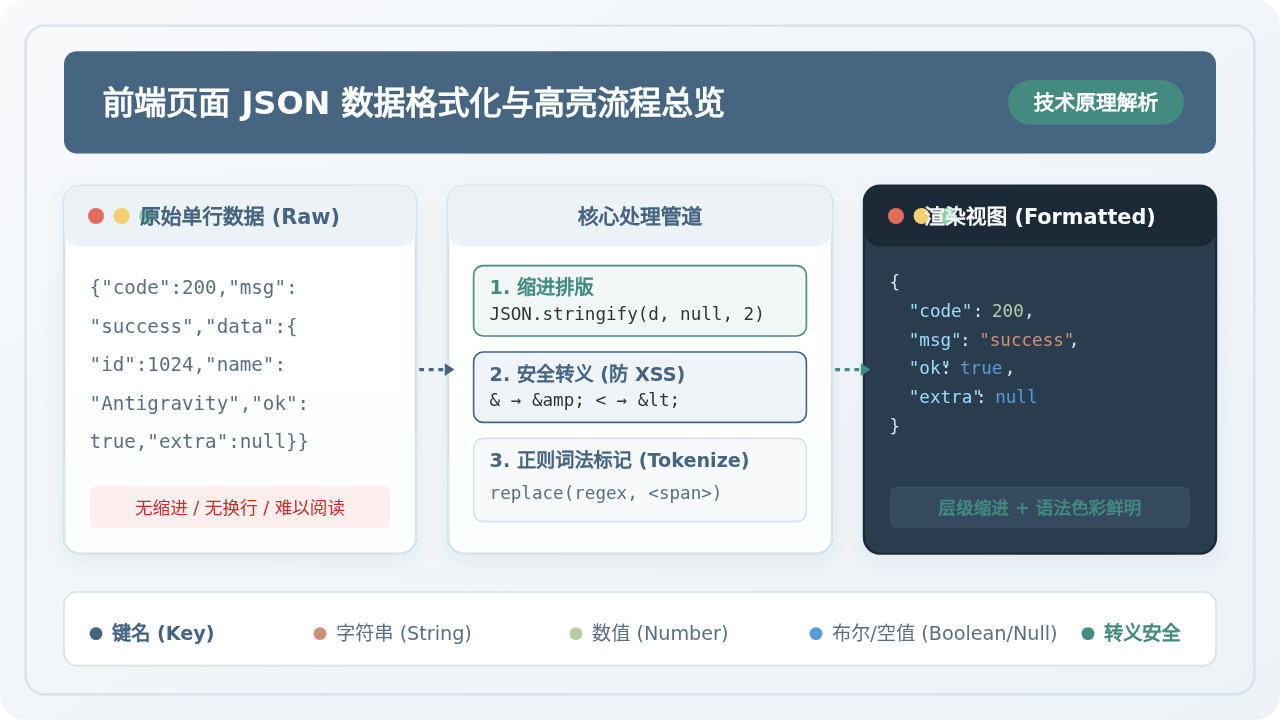
在前端页面中完整呈现美观、易读的 JSON 数据,需要解决两个核心问题:结构缩进格式化与语法元素高亮标记。原生 JavaScript 提供了
JSON.stringify(data, null, 2) 解决层次换行排版,而语法高亮则需要在先完成 HTML 实体转义(彻底杜绝 XSS 漏洞)的前提下,通过正则表达式匹配键名、字符串、数值、布尔值与空值,分别用对应类名的 <span> 标签包裹并结合 CSS 样式进行色彩渲染。
一、格式化与语法高亮的核心原理
在前后端交互调试、后台日志追踪或 API 文档呈现等场景中,接口返回的数据往往是压缩成单行的纯文本或原生 JavaScript 对象。如果直接将其输出到页面容器(如 <div>),由于 HTML 默认合并连续空格并忽略换行符,用户只能看到一团紧密堆叠的字符串,难以定位嵌套关系与字段类型。
实现清晰可视化的标准处理管道由以下四个环节依次串联:
- 序列化排版(Serialization):调用
JSON.stringify(value, replacer, space),利用第三个参数设置缩进字符数(如2或4),生成具备标准层级与换行符的格式化字符串。 - 安全转义(HTML Escaping):在向 DOM 注入任何 HTML 字符串前,必须先将
&、<、>等特殊符号转换为 HTML 字符实体,阻断可能混入 JSON 字段中的跨站脚本(XSS)。 - 语法分词着色(Lexical Tokenization):使用正则表达式逐行扫描,区分“对象的键名(Key)”与“属性值(String、Number、Boolean、Null)”,并在它们外层包裹附带语义 Class 的
<span>标签。 - 容器与样式呈现(Rendering):将构造好的 HTML 注入到使用
<pre><code>包裹的容器中,利用white-space: pre维持换行与缩进,并应用等宽字体与专属色盘。
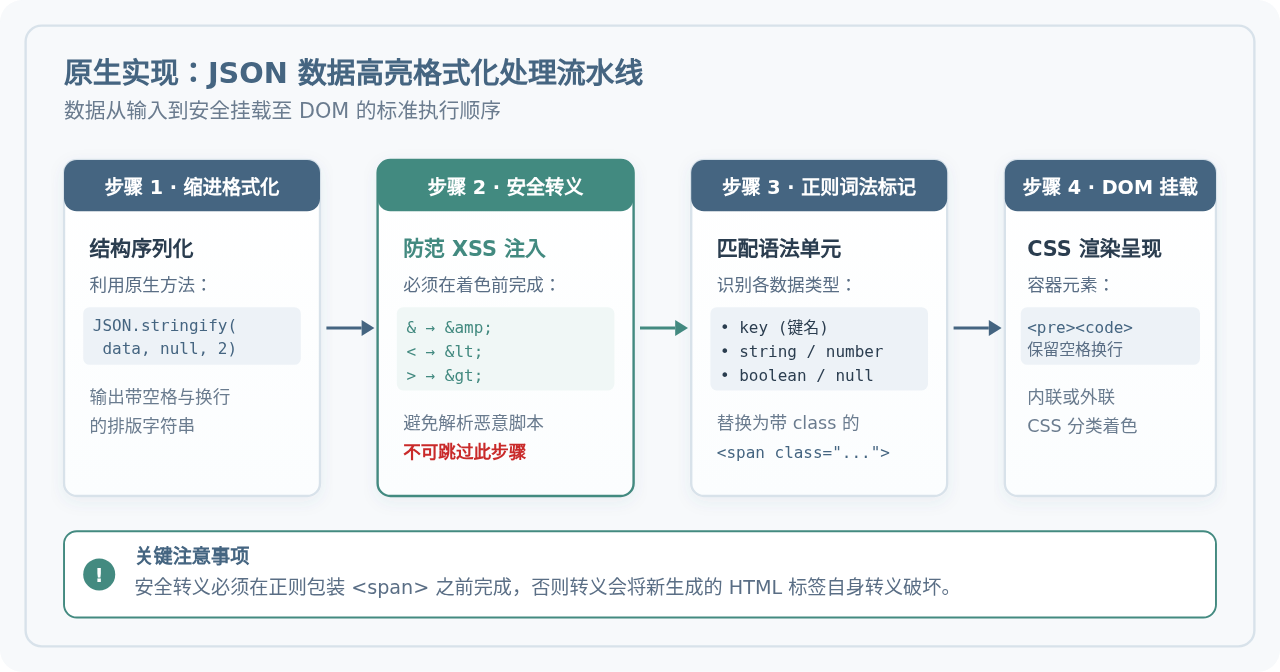
为什么必须在“正则替换”前先执行“安全转义”?
如果在正则着色生成了 <span class="json-key"> 之后再去执行 HTML 转义,转义逻辑会把刚刚插入的 < 和 > 也变成 < 与 >,导致整个页面直接显示出混乱的 HTML 源码标签;反之,若完全不转义,当 JSON 内部含有诸如 "<script>alert(1)</script>" 或带有 onerror 属性的图片标签时,使用 innerHTML 挂载就会直接触发脚本执行漏洞。
二、纯前端原生实现步骤与代码落地
无需引入体积庞大的第三方语法解析器,借助现代浏览器内置的 JavaScript 引擎与正则替换,即可在 30 行以内实现高效稳定的轻量高亮渲染器。
1. 正则分词与捕获规则
JSON 语法结构高度规则,合法的数据单元仅包括:双引号包裹的键名、双引号包裹的字符串值、数值(支持负数、小数、科学计数法)、布尔值(true / false)以及 null。
我们采用如下单条正则表达式统一捕获所有待着色单元:
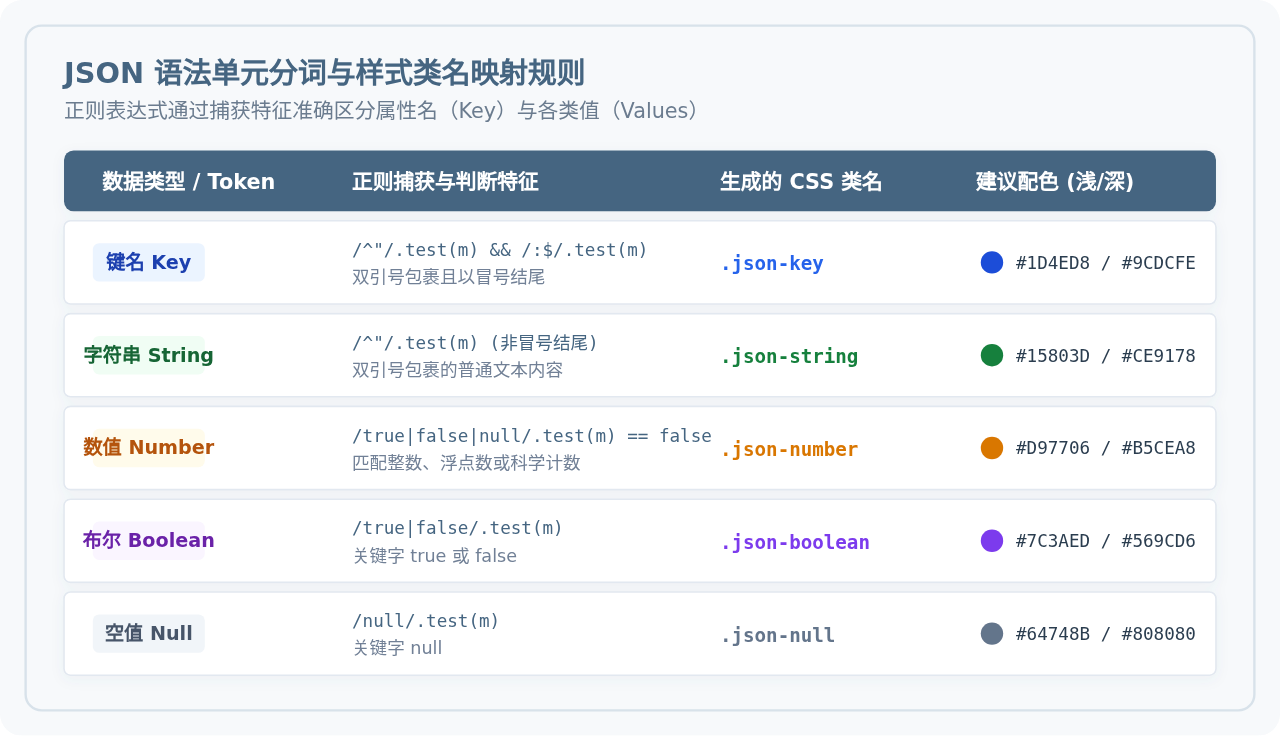
/("(\u[a-zA-Z0-9]{4}|\[^u]|[^\"])*"(\s*:)?|(true|false|null)|-?\d+(?:\.\d*)?(?:[eE][+\-]?\d+)?)/g该正则通过捕获特征与后缀区分不同语法单元:
- 如果匹配项以
"开头且以:结尾,说明当前是对象的键名(Key); - 如果匹配项以
"开头但结尾不是冒号,说明当前是普通的字符串值(String); - 如果匹配项命中
true或false,则标记为布尔值(Boolean); - 如果命中
null,则标记为空值(Null); - 其余匹配到的数字字符序列(含正负号、浮点与指数)标记为数值(Number)。
2. 核心函数与完整实现代码
下面是可以直接复制并在现代浏览器中运行的纯前端原生实现代码。包含输入数据规范化、HTML 字符转义、正则替换及 CSS 样式映射:
/**
* 将任意 JavaScript 对象或合法 JSON 字符串格式化并高亮输出为 HTML 片段
* @param {object|string} json - 原始数据
* @returns {string} 包含语法类名 span 标签的 HTML
*/
function highlightJSON(json) {
if (typeof json !== 'string') {
json = JSON.stringify(json, null, 2);
} else {
try {
// 若传入的是紧凑 JSON 字符串,先解析再重新缩进排版
json = JSON.stringify(JSON.parse(json), null, 2);
} catch (e) {
// 传入非标准 JSON 字符串时保留原样并告警
console.error('Invalid JSON string passed to highlightJSON', e);
}
}
// 第一步:安全转义(杜绝 XSS)
json = json
.replace(/&/g, '&')
.replace(/</g, '<')
.replace(/>/g, '>');
// 第二步:通过正则匹配语法 Token 并赋予对应 class
const tokenRegex = /("(\u[a-zA-Z0-9]{4}|\[^u]|[^\"])*"(\s*:)?|(true|false|null)|-?\d+(?:\.\d*)?(?:[eE][+\-]?\d+)?)/g;
return json.replace(tokenRegex, function (match) {
let cls = 'json-number';
if (/^"/.test(match)) {
if (/:$/.test(match)) {
cls = 'json-key';
} else {
cls = 'json-string';
}
} else if (/true|false/.test(match)) {
cls = 'json-boolean';
} else if (/null/.test(match)) {
cls = 'json-null';
}
return `<span class="${cls}">${match}</span>`;
});
}3. 实际渲染效果预览
将上述函数输出的 HTML 内容注入到 <pre><code> 容器中,并配合深色控制台风格的 CSS 样式,呈现的效果如下:
preview-result.json
只读渲染视图
{
"status": 200,
"message": "数据请求成功",
"data": {
"project": "Antigravity Highlighting Engine",
"version": "2.4.0",
"active": true,
"retryCount": 0,
"rateLimit": 1.25e-3,
"extraPayload": null,
"tags": [
"前端工程",
"JSON可视化"
]
}
}
三、技术方案选型与场景对比
在实际项目开发中,选择何种高亮展示方案取决于数据规模、交互深度以及打包体积要求。并非所有场景都需要引入外部依赖,也并非原生方案能满足一切复杂交互。
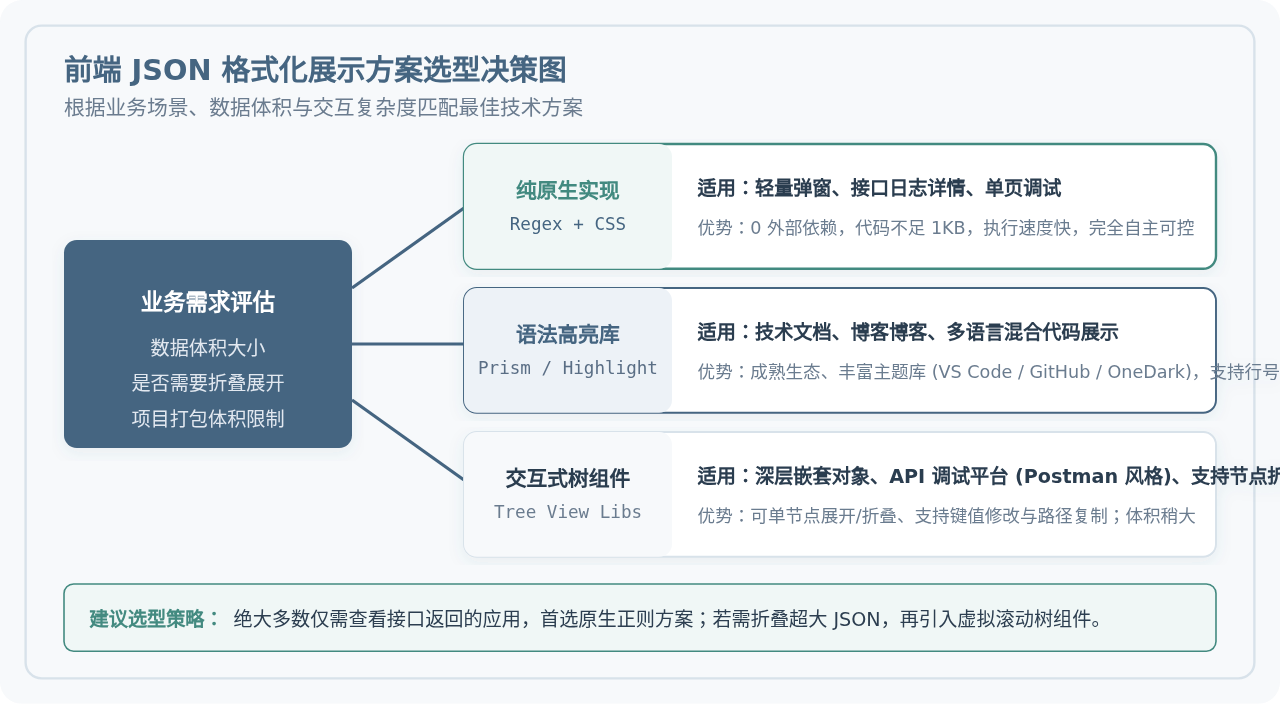
| 方案类型 | 代表技术 / 库 | 包体积占用 | 核心优势 | 适用典型场景 |
|---|---|---|---|---|
| 纯原生正则实现 | 原生 JavaScript + CSS | < 1 KB (零依赖) | 极其轻量、首屏无阻塞、无需任何打包构建配置,完全自主可控 | 接口调试弹窗、报错信息展开、轻量级运营后台、移动端页面 |
| 代码语法高亮库 | Prism.js / Highlight.js | 约 15 KB ~ 40 KB | 具备完备的主题生态(VS Code、OneDark 等),内置行号插件与语言扩展能力 | 技术博客、开发人员文档、支持多种编程语言代码片段混合展示的系统 |
| 交互式树形组件 | json-tree-view / vue-json-viewer / react-json-view | 约 30 KB ~ 80 KB | 支持节点单层折叠展开、键值编辑、搜索高亮、点击直接复制 JSONPath | Postman/Apifox 类似接口测试平台、深层复杂配置项可视化、数据分析看板 |
四、生产环境避坑指南与实战细节
在生产系统直接上线 JSON 展示组件时,仅仅跑通基础示例是不够的。以下四个边界问题是最常见的故障来源:
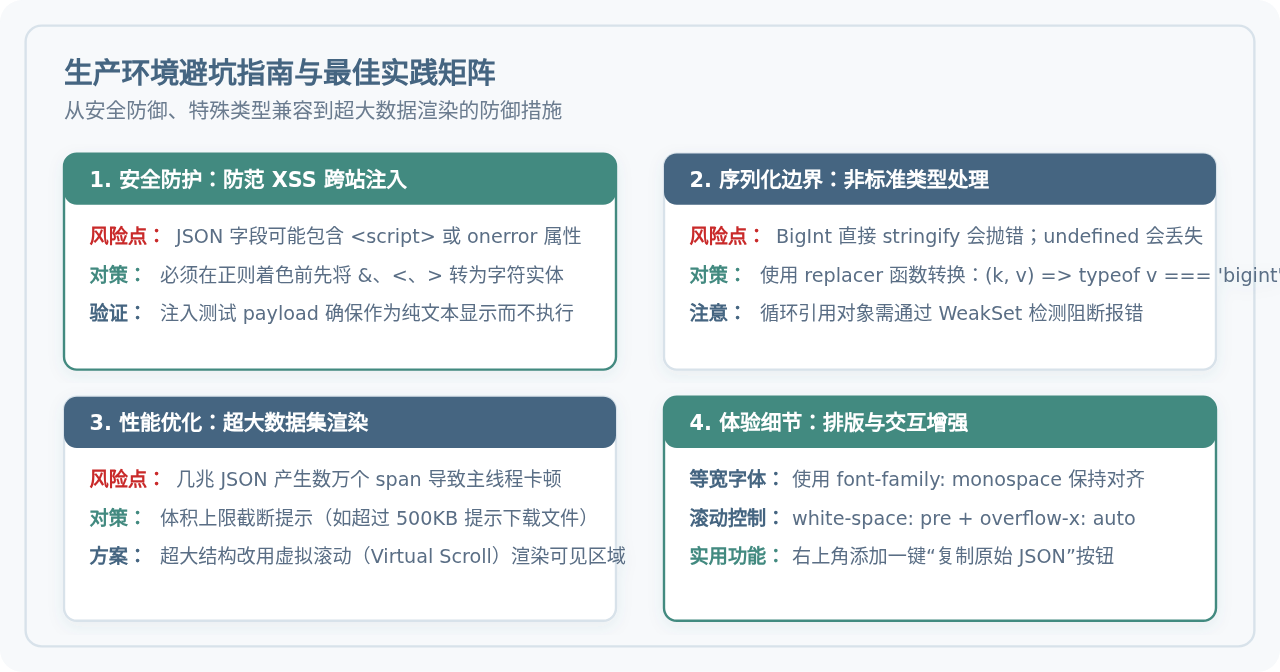
1. 严格防范 XSS 漏洞隐患
前端展示的 JSON 很多来源于外部用户输入或第三方公开 API。攻击者可能在文本字段中植入恶意 payload,例如:
{ "userName": "<img src=x onerror=alert(document.cookie)>" }
如果未先调用 .replace(/</g, '<') 转义,直接通过 innerHTML 挂载高亮字符串,浏览器会在构建 DOM 树的同时触发 img 的 onerror 回调,造成严重的跨站脚本漏洞。开发时应把“转义优先”列为硬性检查规范。
2. 非标准 JavaScript 数据类型的序列化异常
标准的 JSON.stringify 在遇到以下常见类型时会产生意外行为:
- BigInt 类型:ES2020 引入的大整数直接传入
JSON.stringify会抛出TypeError: Do not know how to serialize a BigInt异常,阻断主流程; undefined与Function:在对象属性中会被静默剔除,在数组中则会被转换为null;- 循环引用对象:若对象自身存在环形嵌套,会抛出
TypeError: Converting circular structure to JSON。
优雅应对方案:可以在 JSON.stringify 的第二个参数传入自定义 replacer 处理函数,统一转换特殊类型:
function safeStringify(data, space = 2) {
  const seen = new WeakSet();
  return JSON.stringify(data, (key, value) => {
    // 兼容 BigInt
    if (typeof value === 'bigint') {
      return value.toString() + 'n';
    }
    // 拦截循环引用
    if (typeof value === 'object' && value !== null) {
      if (seen.has(value)) {
        return '[Circular Reference]';
      }
      seen.add(value);
    }
    return value;
  }, space);
}
3. 海量数据体积下的 DOM 爆炸与性能崩溃
当接口返回数十兆、包含数万条记录的超大 JSON 时,如果直接进行全量正则分词,会生成数十万个 <span> DOM 节点。这会导致浏览器的排版与渲染引擎直接卡死或内存溢出。
生产环境防御阈值建议
在执行高亮渲染前,先检查字符串长度:如果序列化后的字符数超过阈值(如 100 KB 或 2000 行),应只截取前 500 行进行高亮预览,并在底部给出明确提示:“数据体积较大,已折叠剩余部分,请点击【下载完整 JSON 文件】查看”。
4. 页面排版与移动端交互细节
- 等宽字体对齐:必须指定等宽字体栈(如
font-family: ui-monospace, SFMono-Regular, Menlo, Monaco, Consolas, monospace),确保每一列的缩进空格宽度完全一致,避免层级错位。 - 横向滚动防换行:外层
<pre>必须设置white-space: pre; overflow-x: auto;。避免因为长字符串在视口边缘自动折行而破坏原本的缩进对齐结构。 - 一键复制原始数据:语法高亮后的 DOM 节点包含了大量的
<span>标签,如果用户手动框选复制,可能会带入不可见的格式化杂质。在右上角配置一个“复制纯文本 JSON”按钮(利用navigator.clipboard.writeText)能大幅提升使用便利性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章