
深入讲解如何使用JavaScript原生数组方法与Set集合高效实现数组去重与多维扁平化,涵盖flat、reduce、filter及对象数组处理,附底层原理分析与精美SVG示意图。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
怎么使用JavaScript数组方法实现数据去重和扁平化?
作者:纸飞机
时间:2026-11-12
浏览:77
文章目录
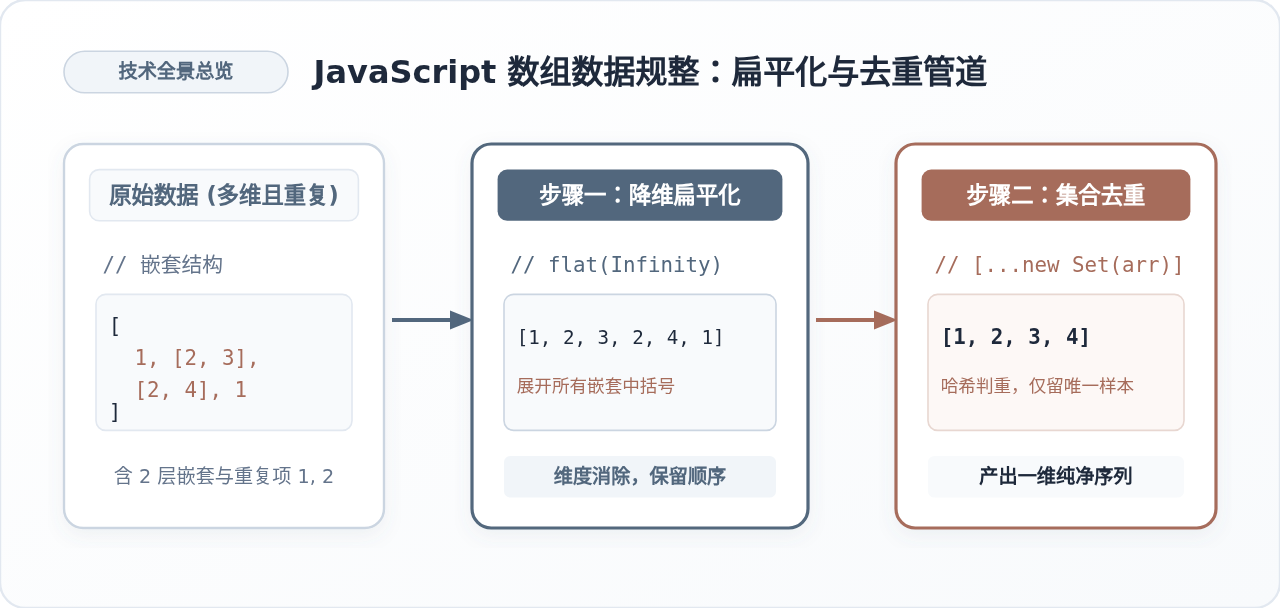
在处理接口返回的树状列表、层级标签或用户多选结果时,常会遇到元素多重嵌套且伴有冗余重复项的问题。要解决这一痛点,核心路径是两步走:先利用 Array.prototype.flat() 将多层嵌套数组降至单一维度,再利用 Set 集合或 filter() 搭配 indexOf() 完成值域筛选;针对复杂对象数组,则通过 reduce() 配合哈希表或 Map 依据业务主键进行精准去重。
一、数组去重的常见方法与底层原理
去重本质上是判断新读入的元素在已知集合中是否已存在。在 JavaScript 中,判断逻辑是基于哈希查找还是线性扫描,直接决定了代码执行效率与适用边界。
1. 原始类型首选:扩展运算符结合 Set 集合
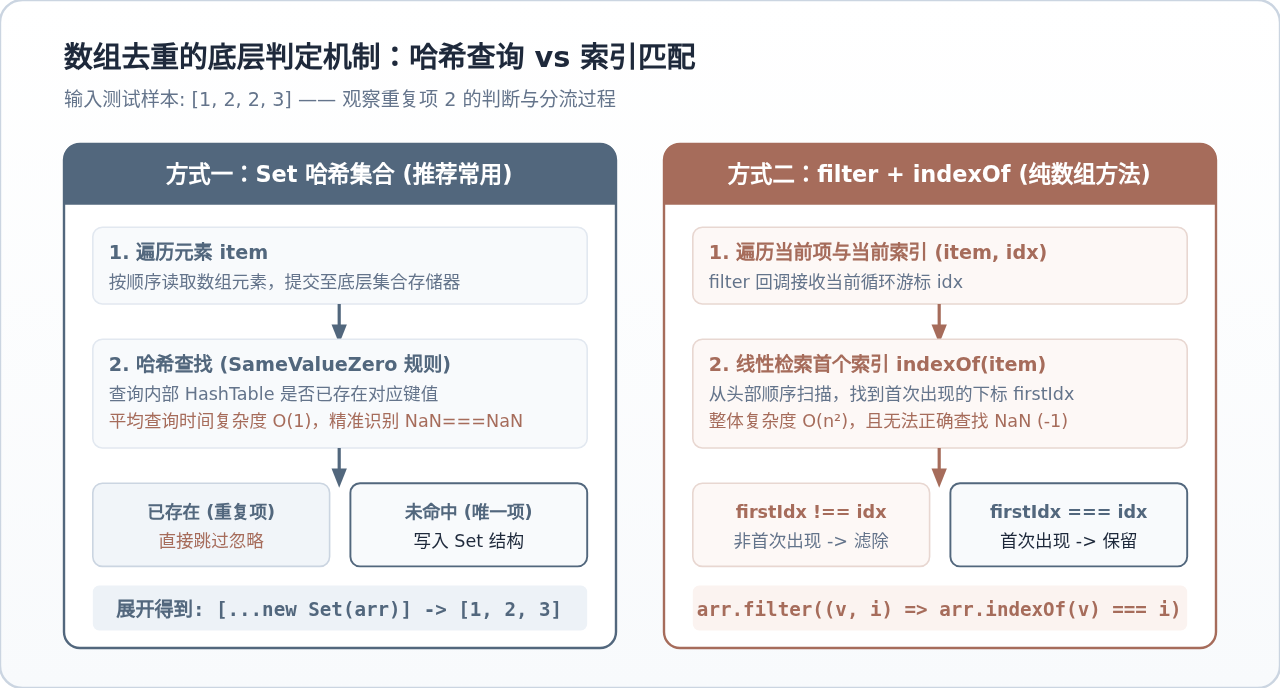
对于只包含数字、字符串或布尔值的常规数组,最简洁且性能最优的方案是利用 ES6 的 Set 结构。Set 内部使用 SameValueZero 比较算法,允许快速建立唯一值哈希表:
const rawNumbers = [1, 2, 2, 3, 4, 4, 5, NaN, NaN];

// 使用扩展运算符展开 Set
const uniqueNumbers = [...new Set(rawNumbers)];
// 输出: [1, 2, 3, 4, 5, NaN]

// 或者使用 Array.from
const uniqueByArrayFrom = Array.from(new Set(rawNumbers));值得注意的是,Set 能够准确将重复的 NaN 视作相同值进行剔除,这比早期的全等判断更加安全。然而,Set 的局限在于比较对象时比较的是内存引用地址。如果数组中存在两个内容相同但引用不同的对象(例如 { id: 1 } 和 { id: 1 }),Set 会判定二者为独立元素。
2. 纯数组原生方法:filter() 结合 indexOf()
如果不依赖 ES6 的 Set 数据结构,仅使用纯数组方法,最经典的写法是通过 filter() 过滤出当前遍历索引与首次出现索引一致的元素:
const list = ['apple', 'banana', 'apple', 'orange', 'banana'];

const uniqueList = list.filter((item, index) => {
  // 当元素首次出现的位置等于当前索引时保留,否则说明此前已出现过
  return list.indexOf(item) === index;
});
// 输出: ['apple', 'banana', 'orange']这种写法的直观性很好,但存在两个必须注意的技术细节:第一是性能开销,filter() 外层循环与 indexOf() 内部线性扫描形成嵌套,时间复杂度为 O(n²),在面对万级以上数据量时容易出现卡顿;第二是 indexOf() 无法检索 NaN(始终返回 -1),若原数组包含 NaN,会导致其被全部过滤丢弃。
3. 业务对象数组去重:reduce() 结合 Map
在实际业务中,数组元素大多是带有 id 或 code 属性的对象。此时无法直接依赖原始值判断,最稳健的做法是利用 reduce() 累加器并维护一个 Map 充当主键索引缓存:
const userList = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' },
  { id: 101, name: '张三(重复提交)' }
];

const seenMap = new Map();
const uniqueUsers = userList.reduce((accumulator, current) => {
  if (!seenMap.has(current.id)) {
    seenMap.set(current.id, true);
    accumulator.push(current);
  }
  return accumulator;
}, []);
// 输出只保留首次出现的 id=101 与 id=102 记录
去重选择提醒
原始类型数据优先使用 [...new Set(arr)];纯数组方法场景使用 filter 配合条件判断;包含明确业务键的对象数组,则推荐 reduce + Map,时间复杂度维持在 O(n)。
二、数组扁平化的核心方法与层级控制
扁平化(Flatten)指将多维嵌套数组转换为一维或更低维度的数组结构。在处理多级评论、分类树或级联选项的数据拍平时,层级控制尤为关键。
1. 原生内置方法:Array.prototype.flat()
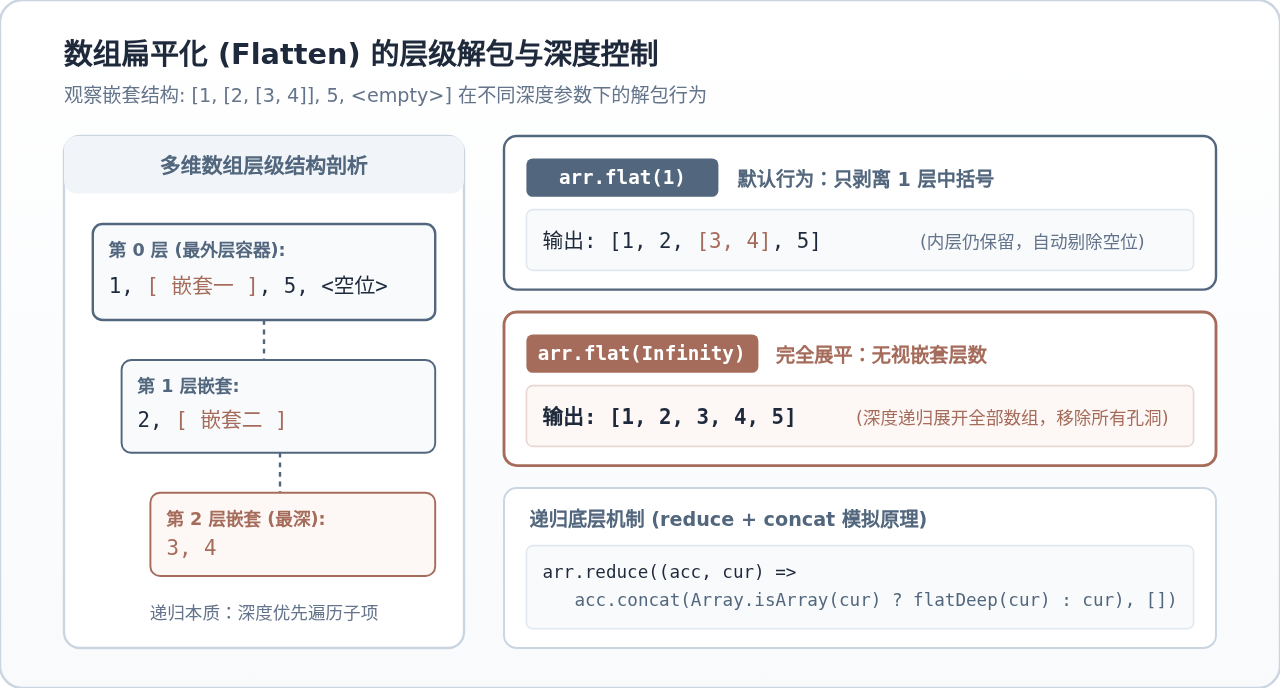
现代 JavaScript 原生提供了 flat() 方法。它接受一个可选的深度参数 depth,默认值为 1,表示仅解除一层嵌套中括号:
const nested = [1, [2, [3, [4]]]];

// 默认扁平化 1 层
const flatLevel1 = nested.flat();
// 输出: [1, 2, [3, [4]]]

// 扁平化指定 2 层
const flatLevel2 = nested.flat(2);
// 输出: [1, 2, 3, [4]]

// 传入 Infinity,展开无限嵌套层级
const flatAll = nested.flat(Infinity);
// 输出: [1, 2, 3, 4]
flat() 还有一个非常实用的附带功能:它会在展开过程中自动丢弃稀疏数组中的空位(empty slots)。例如 [1, 2, , 4, [5, , 6]].flat() 会自动净化为 [1, 2, 4, 5, 6],无需额外编写判空代码。
2. 映射同时展平:Array.prototype.flatMap()
如果在扁平化之前需要对每个元素做一次映射转换,使用 flatMap() 相比先 map() 再 flat() 效率更高,因为内部只进行一次数组分配:
const sentences = ["hello world", "javascript array methods"];

// 将句子切分成单词并展平为一维数组
const words = sentences.flatMap(str => str.split(" "));
// 输出: ["hello", "world", "javascript", "array", "methods"]需要提醒的是,flatMap() 仅支持 1 层的深度展平,等同于 map().flat(1),不能通过传参来展开深层嵌套。
3. 自定义递归实现:reduce() 配合 concat()
在需要完全掌控遍历过程或兼容旧运行环境时,利用 reduce() 结合递归可以清晰展示扁平化的底层运作:
function flattenDeep(arr) {
  return arr.reduce((accumulator, current) => {
    // 如果当前项依然是数组,则递归展平,否则直接拼入累加器
    return accumulator.concat(
      Array.isArray(current) ? flattenDeep(current) : current
    );
  }, []);
}

const deepArray = [1, [2, [3, [4, 5]]]];
const flattenedResult = flattenDeep(deepArray);
// 输出: [1, 2, 3, 4, 5]
三、去重与扁平化的组合实战:构建数据处理管道
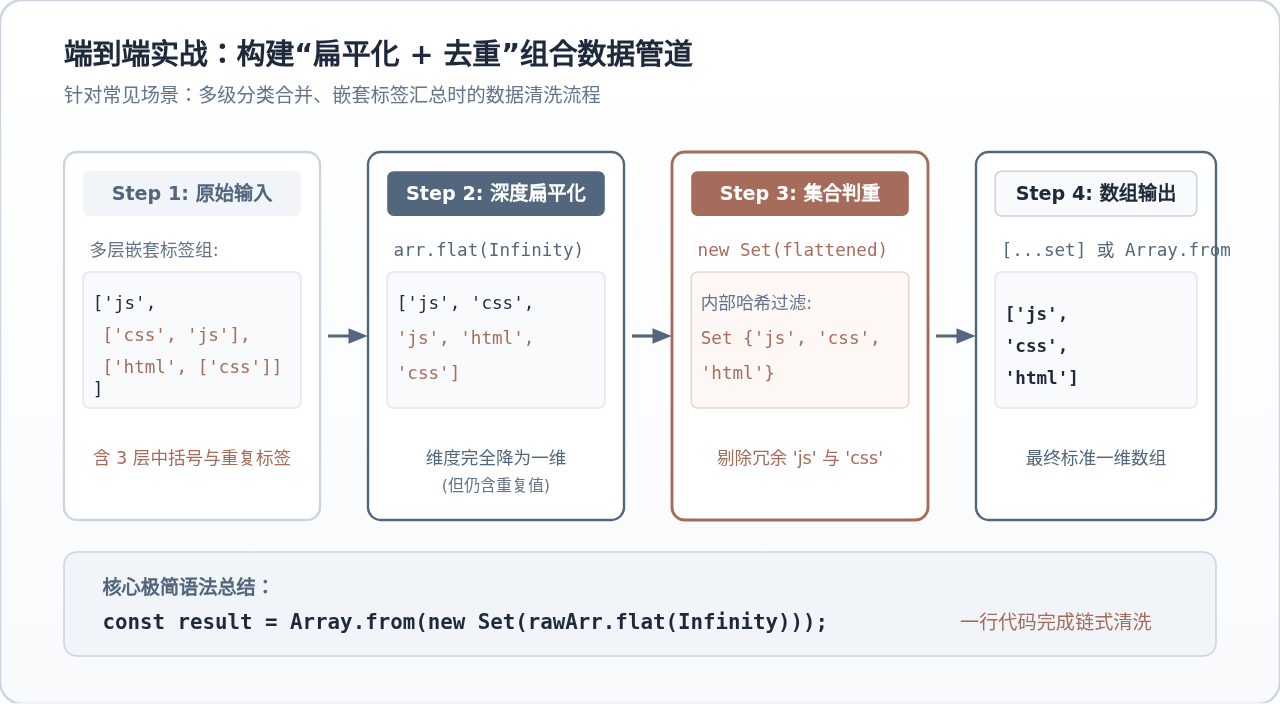
在面对既有多层中括号嵌套、又存在重复脏数据的真实场景时,推荐的执行顺序是“先扁平化降维,后执行去重”。如果颠倒顺序,去重逻辑在处理未展开的内层子数组时,会因为引用不同而误判为独立项,导致去重失效。
1. 原始类型嵌套数据的极简单行管道
对于混合多维嵌套的基础值数组,将 flat(Infinity) 与 new Set() 链式组合是最直接的工业级写法:
const rawTags = [
  'javascript',
  ['frontend', 'javascript'],
  ['web', ['frontend', 'react']]
];

// 一行代码完成完全扁平化与全量去重
const cleanTags = Array.from(new Set(rawTags.flat(Infinity)));
// 输出: ['javascript', 'frontend', 'web', 'react']
2. 嵌套对象结构的降维清洗实战
当接口返回组织架构树或多部门人员多维列表时,数据结构往往是多维嵌套的对象。此时先用 flat(Infinity) 拆解维度,再按主键 id 去重:
const departmentEmployees = [
  [
    { id: 1, name: 'Alice' },
    { id: 2, name: 'Bob' }
  ],
  [
    [
      { id: 2, name: 'Bob (跨部门重叠)' },
      { id: 3, name: 'Charlie' }
    ]
  ]
];

// 第一步:完全展平至一维对象列表
const flattenedList = departmentEmployees.flat(Infinity);

// 第二步:借助 Map 记录唯一键 id
const uniqueEmployeeMap = new Map();
const finalEmployees = flattenedList.filter(emp => {
  if (uniqueEmployeeMap.has(emp.id)) {
    return false;
  }
  uniqueEmployeeMap.set(emp.id, true);
  return true;
});
// 最终输出: 包含 Alice(1), Bob(2), Charlie(3) 的纯净数组
四、方法选型与性能权衡
在面对不同体量的数据时,盲目追求代码简短可能会导致隐性性能瓶颈。例如在几十万级数据场景中,数组方法多次深拷贝或二次遍历可能引起显著的内存抖动。
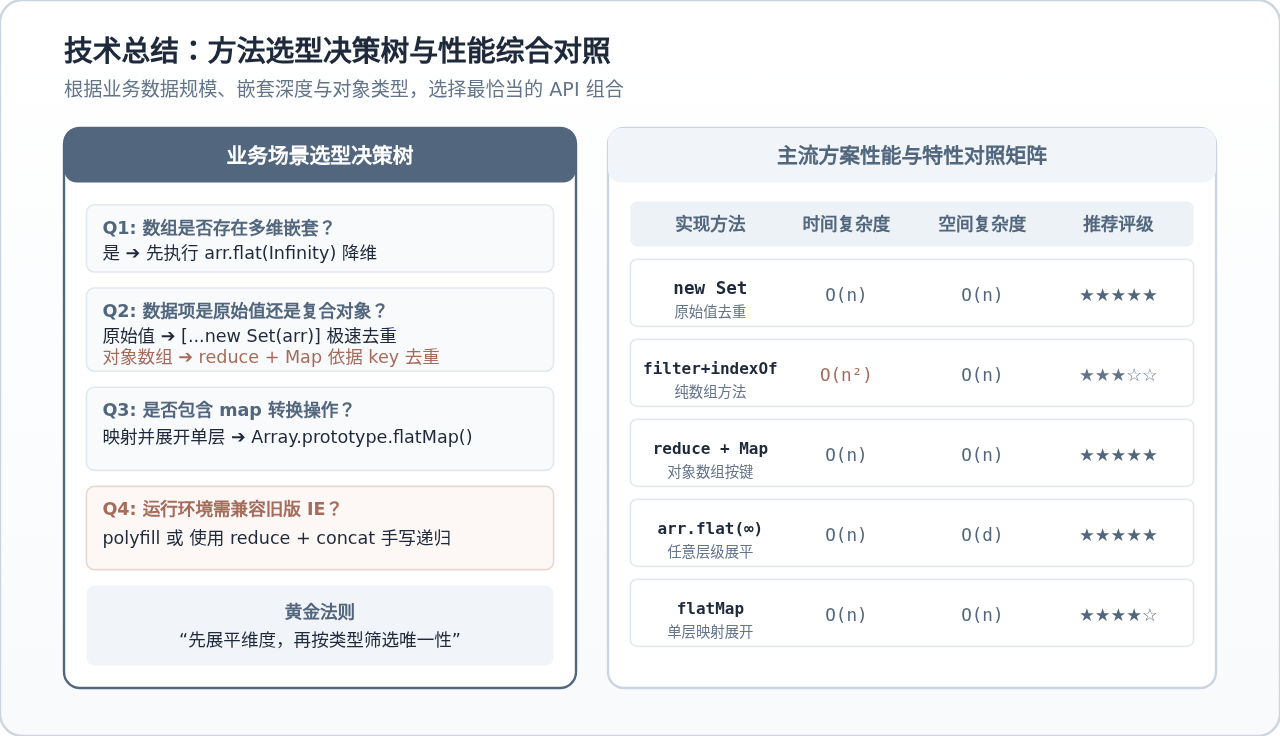
| 处理方案 | 对应场景 | 时间复杂度 | 空间复杂度 | 主要优势与注意项 |
|---|---|---|---|---|
[...new Set(arr)] |
一维基础值去重 | O(n) | O(n) | 语法极简,支持 NaN 去重;无法区分不同引用的同内容对象 |
filter + indexOf |
纯数组方法去重 | O(n²) | O(n) | 兼容性极高;但大数据量下性能较差,且无法正确匹配 NaN |
reduce + Map |
复合对象数组按键去重 | O(n) | O(n) | 业务开发最稳健方案,可自定义主键去重规则 |
arr.flat(Infinity) |
未知深度的数组扁平化 | O(n) | O(depth) | 引擎原生实现,性能优良且自动忽略空位;需现代浏览器环境 |
reduce + 递归 |
自定义层级控制或旧环境兼容 | O(n) | O(depth) | 逻辑高度可定制;深层嵌套时需注意调用栈深度限制 |
工程落地建议
日常业务中绝大部分需求,可直接使用 Array.from(new Set(rawArr.flat(Infinity))) 解决;若需要按特定属性去重,先使用 flat(Infinity) 展平,再用 reduce + Map 过滤,便能在兼顾代码可读性的同时,保持优秀的 O(n) 运行效率。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章