
详细介绍JavaScript中合并多个数组并进行去重的完整实现方案,涵盖ES6 Set展开运算、传统filter与indexOf线性过滤、对象数组基于唯一属性Key的Map去重以及特殊边界值处理与性能选型。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript合并数组并去重的实现方法
作者:纸飞机
时间:2026-11-12
浏览:651
文章目录
合并数组并去重是前端数据流处理中的高频操作。解决该需求的核心路径可概括为两个明确步骤:先将分散的多个数组连接为单个连续序列,再通过特定机制滤除重复元素。对于数字、字符串等基础类型,直接使用
[...new Set([...arr1, ...arr2])] 能够在毫秒级内完成处理;对于包含复杂属性的对象数组,则应以数据唯一标识(如 id)为基准,利用 Map 字典进行精确的键值去重。
一、基础数据类型数组合并与去重首选:ES6 Set 展开运算
在 ECMAScript 2015 (ES6) 及更高版本的现代 JavaScript 环境中,合并并去重基础数据类型(如 Number、String、Boolean)的标准推荐做法是结合展开运算符(Spread Operator)与 Set 集合对象。
这一方案由两部分无缝衔接完成:
- 数组合并阶段:利用
[...arr1, ...arr2]或arr1.concat(arr2)将两个或多个数组解构合并为包含完整项的新列表。 - 集合过滤阶段:将合并后的数组作为参数传递给
new Set(...)。由于Set原生要求其成员的值必须唯一,重复出现的项在存入时会自动被拦截剔除。 - 结构还原阶段:再次使用外层展开运算符
[...]或Array.from(),将不可重复的Set迭代对象迅速重新包装为纯 JavaScript 数组。
// 完整示例:合并多个基础类型数组并去重
const listA = [1, 2, 3, 5];
const listB = [3, 4, 5, 6];
const listC = [5, 6, 7];

// 执行合并并去重
const result = [...new Set([...listA, ...listB, ...listC])];

console.log(result);
示例输出:
[ 1, 2, 3, 5, 4, 6, 7 ]
[ 1, 2, 3, 5, 4, 6, 7 ]
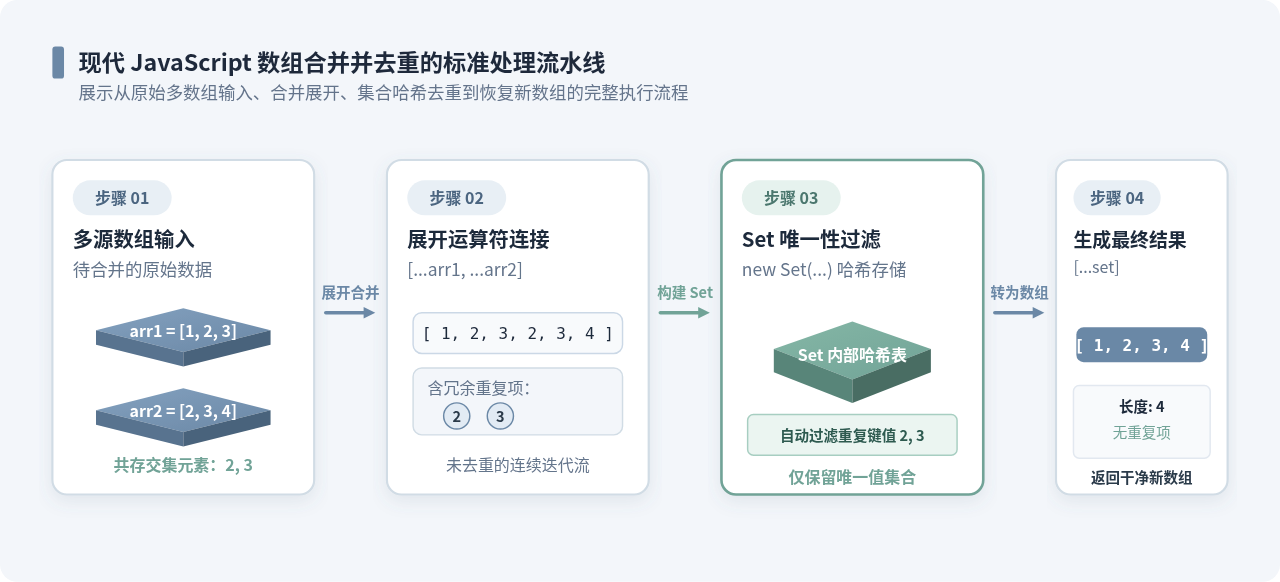
图 1:现代 JavaScript 数组合并并去重的标准处理流水线与状态流转
通过该图可以清晰看到数据在内存中的流转细节:原数组中的交集元素(如数值 3 和 5)在展开合并时虽然依次出现,但在进入 Set 实例后触发了内部去重机制,最终输出长度缩减且顺序保真的全新数组副本,原数组不会发生任何变更。
二、传统方案与兼容实现:filter 配合 indexOf
在需要兼容 Internet Explorer 等旧式浏览器、或者无法使用 Babel 转译的特定受限环境中,可以采用 ES5 引入的原型方法 Array.prototype.concat 与 Array.prototype.filter 来实现合并与去重。
该方法的核心判断逻辑在于利用 indexOf 的查找特性:indexOf(item) 永远只返回元素在整个数组中第一次出现的位置下标。在 filter 遍历时,若当前元素的遍历索引 index 大于其首次出现的索引,便证明该元素此前已经出现过,属于重复项,判定条件返回 false 予以过滤。
// 完整示例:传统 filter + indexOf 方式
var arr1 = ["apple", "banana", "orange"];
var arr2 = ["banana", "grape", "apple"];

// 1. 先用 concat 连接数组
var merged = arr1.concat(arr2);

// 2. 用 filter 根据首次出现索引去重
var uniqueList = merged.filter(function(item, index, self) {
  return self.indexOf(item) === index;
});

console.log(uniqueList);
示例输出:
[ "apple", "banana", "orange", "grape" ]
[ "apple", "banana", "orange", "grape" ]
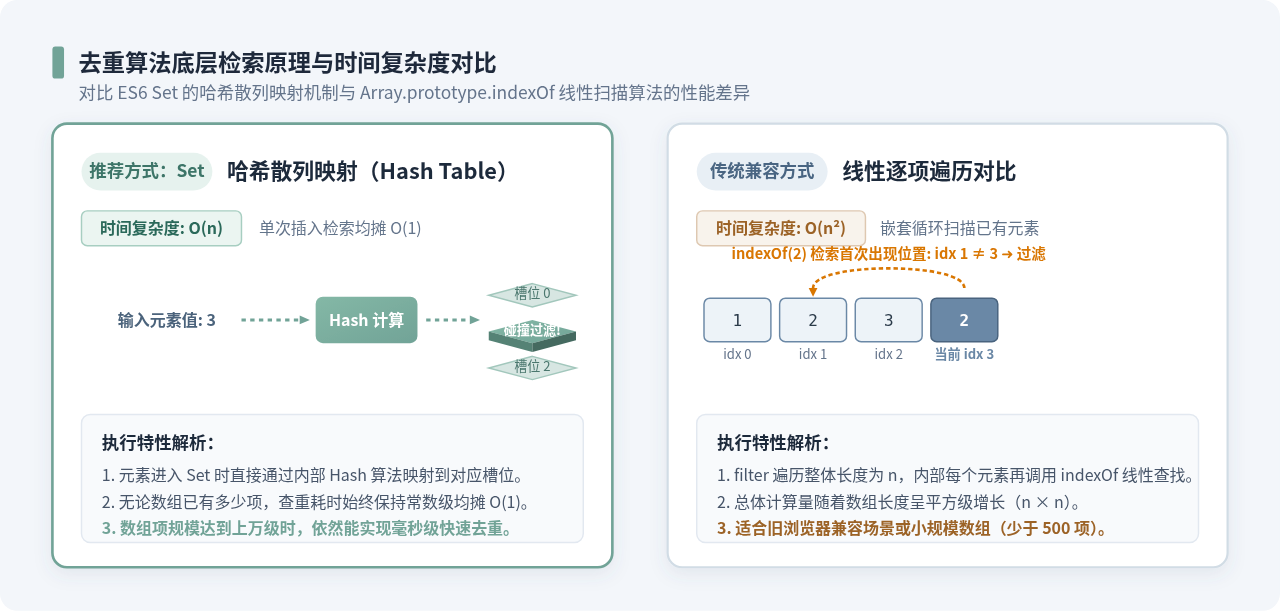
图 2:Set 哈希散列映射机制与 indexOf 线性遍历查找的底层原理与时间复杂度对比
算法复杂度提醒:
filter + indexOf 的嵌套逻辑本质上是一个双重循环,时间复杂度为 O(n²)。当数组总长度达到数万项时,页面容易出现明显掉帧或卡顿。而 Set 底层采用 Hash Table(散列表),每次判断和插入的均摊时间复杂度为 O(1),整体复杂度仅为 O(n)。因此在常规业务开发中,务必优先选用 Set。
三、对象数组合并并去重:基于唯一属性(Key / ID)
在实际业务中,我们经常遇到从多个 API 接口获取列表数据后合并展示的场景,例如商品列表、用户信息或权限清单。这类数据由引用类型的对象组成(如 { id: 1, name: "Admin" })。
需要明确的是:直接使用 new Set() 无法对对象数组去重。因为在 JavaScript 中,对象按照内存引用地址进行比较。即使两个对象的所有键值完全相同,只要它们开辟了不同的内存空间(引用地址不同),Set 就会判定它们为不同值,从而保留所有重复项。
正确高效的解法是:利用 ES6 的 Map 对象,以每一项对象的核心唯一字段(例如 id 或 code)作为 Map 的键,以对象本身作为值。后存入的数据会自动覆盖前序相同键的值,从而实现高效去重。
// 完整示例:按对象的 id 字段合并并去重
const localUsers = [
  { id: 101, name: "张三", role: "Viewer" },
  { id: 102, name: "李四", role: "Editor" }
];

const remoteUsers = [
  { id: 101, name: "张三(最新)", role: "Admin" }, // 重复 ID,需合并去重
  { id: 103, name: "王五", role: "Viewer" }
];

// 步骤一:合并所有项并创建 Map
const userMap = new Map();
[...localUsers, ...remoteUsers].forEach(item => {
  userMap.set(item.id, item); // 相同 id 会自动更新覆盖为后者
});

// 步骤二:提取去重后的对象数组
const finalUsers = Array.from(userMap.values());

console.log(finalUsers);
示例输出:
[
{ id: 101, name: "张三(最新)", role: "Admin" },
{ id: 102, name: "李四", role: "Editor" },
{ id: 103, name: "王五", role: "Viewer" }
]
[
{ id: 101, name: "张三(最新)", role: "Admin" },
{ id: 102, name: "李四", role: "Editor" },
{ id: 103, name: "王五", role: "Viewer" }
]
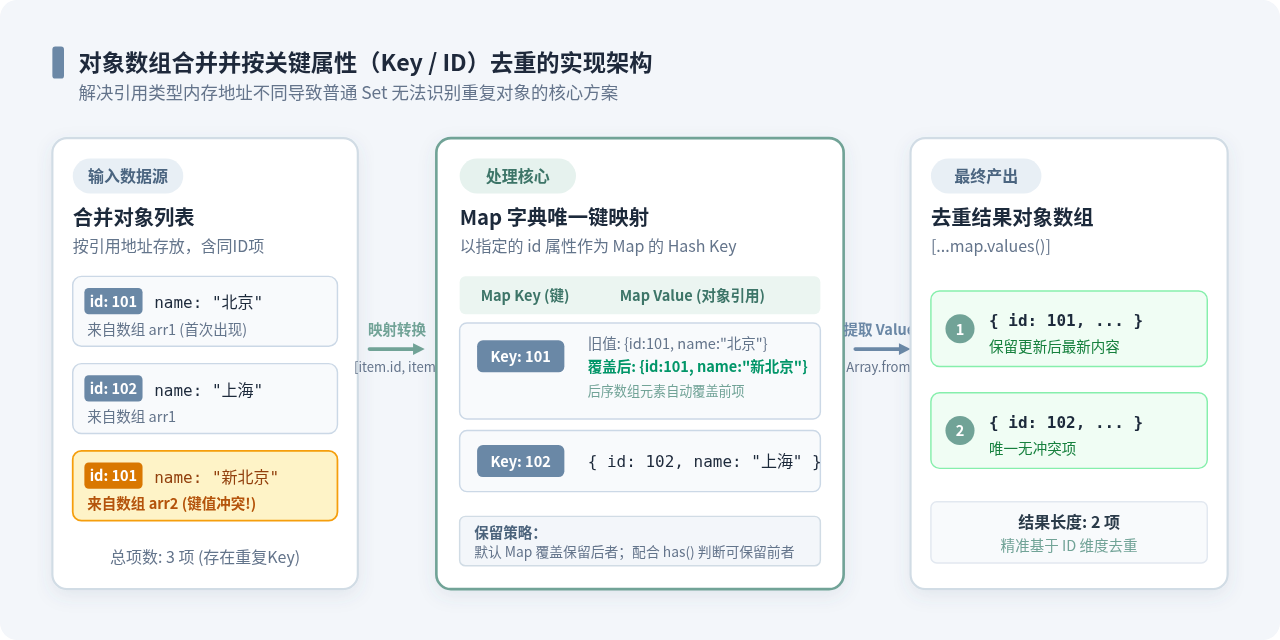
图 3:对象数组合并并按关键属性进行 Map 字典映射去重的架构流程
覆盖策略选择:保留首次出现还是最新出现?
Map.prototype.set(key, val) 默认会在 Key 重复时采用“后者覆盖前者”的行为。如果业务要求“保留最先出现的对象,丢弃后续重复项”,则可以在存入时使用 map.has() 做一次前置判断:
// 保留首次出现的对象,忽略后序相同 ID 项
const keepFirstMap = new Map();
[...localUsers, ...remoteUsers].forEach(item => {
  if (!keepFirstMap.has(item.id)) {
    keepFirstMap.set(item.id, item);
  }
});
const uniqueKeepFirst = [...keepFirstMap.values()];
四、去重过程中的特殊数据类型边界与陷阱
在合并数组中包含特殊 JavaScript 运行时数值时,不同去重手段的行为存在本质区别,编写代码时需紧密结合实际数据特征:
1. NaN(Not a Number)的去重差异
在 JavaScript 原生语法中,NaN === NaN 的评估结果始终为 false。同时,[NaN].indexOf(NaN) 的返回值为 -1。
- 使用 filter + indexOf:由于
indexOf(NaN)永远为-1,表达式self.indexOf(item) === index永远不成立,因此数组中的所有NaN都会被直接丢弃,造成非预期的数据丢失。 - 使用 Set:ECMAScript 规范专门针对
Set规定了 SameValueZero 相等性比较算法。在该算法下,无论数组中有多少个NaN,Set均能正确判定它们为相同值并精准去重,最终安全保留一个NaN。
const arrWithNaN1 = [1, NaN];
const arrWithNaN2 = [NaN, 2];

// Set 能够正确去重 NaN
console.log([...new Set([...arrWithNaN1, ...arrWithNaN2])]);
// 输出: [1, NaN, 2]

// filter + indexOf 会全部错误过滤 NaN
const badResult = arrWithNaN1.concat(arrWithNaN2).filter((item, idx, arr) => arr.indexOf(item) === idx);
console.log(badResult);
// 输出: [1, 2] (NaN 被完全丢失)
2. undefined 与 null 的表现
Set 和 filter + indexOf 均能正确识别并去重 undefined 与 null。合并后的数组只会出现一个 null 或一个 undefined。
五、综合对比与选型决策指南
为了帮助读者根据项目运行平台与具体业务结构快速做出技术选型,下表对各类主流合并去重方案进行了多维度客观对比:
| 实现方式 | 核心 API | 时间复杂度 | 兼容环境 | 适用数据场景 | 综合推荐度 |
|---|---|---|---|---|---|
| Set + 展开运算 | [...new Set([...a, ...b])] |
O(n) | 现代浏览器 / Node.js 6+ | 基础数据类型、NaN、null | 首选最高 |
| Map 字典键映射 | new Map(merged.map(...)) |
O(n) | 现代浏览器 / ES6+ | 对象数组按指定 ID / Key 去重 | 对象首选 |
| filter + indexOf | concat().filter(...) |
O(n²) | 所有环境 (IE8+) | 遗留项目、小规模纯数值/字符串 | 保底备用 |
| reduce + includes | concat().reduce(...) |
O(n²) | ES5+ 环境 | 需要连带执行累加计算的流程 | 普通适用 |
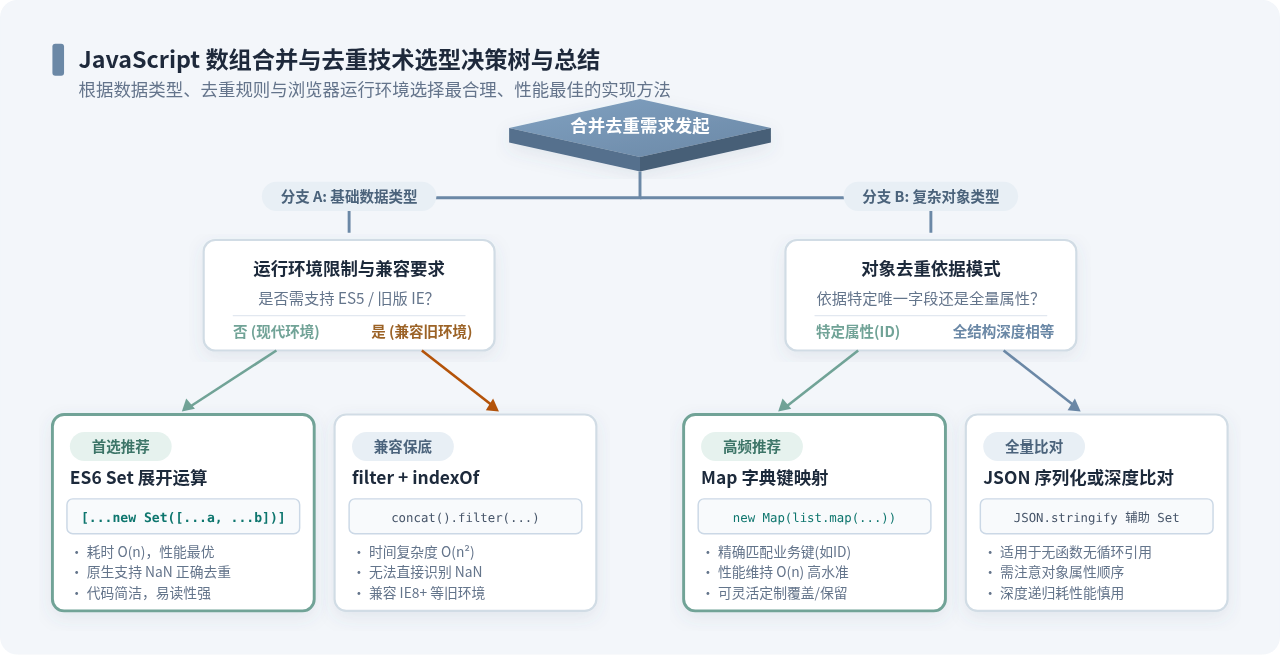
图 4:JavaScript 数组合并与去重技术选型决策树与总结建议
六、总结与关键实践建议
通过本文的推导与实例验证,可以总结出两条清晰直接的操作定则:
- 对于基础类型数组(数字、字符串等),无需任何冗余封装,直接一行代码使用
[...new Set([...arr1, ...arr2])],在代码可读性、执行性能以及特殊值(如NaN)兼容上均达到最优。 - 对于业务对象数组,必须明确去重所依据的业务主键,优先采用
Map结构以item.id为 Key 遍历收集,最后通过Array.from(map.values())输出干净结果,杜绝因引用地址不同而导致去重失效的问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章