
详细讲解如何在JavaScript函数中验证data参数的结果是否正确,涵盖类型检查、结构校验、边界值测试、Schema验证等实用方法,并配有完整代码示例。

当前位置:首页 > JavaScript 基础 > 正文
js函数里面的data参数的结果怎么验证是否正确
作者:木棉
时间:2026-11-08
浏览:230
文章目录
在JavaScript开发中,函数接收的data参数往往来自接口返回、用户输入或其他模块传递,它的内容是否符合预期直接决定后续逻辑能不能正常执行。验证data是否正确,核心思路是:先确认类型,再检查结构和值,最后在关键路径用断言或单元测试兜底。下面按实际操作顺序,把常用的验证方法逐步讲清楚。
一、先搞清楚"正确"指什么
拿到data参数时,"正确"通常包含三层含义:
- 类型正确——比如期望对象却收到了
null或字符串。 - 结构正确——对象里该有的字段是否都在,嵌套层级对不对。
- 值正确——字段的具体值是否在合法范围内,比如年龄不能是负数、邮箱格式要对。
验证的时候按照这三层从外到内做检查,能避免漏掉问题,也方便定位出错位置。
二、基础类型验证
最直接的做法是用typeof和instanceof判断data的类型。比如你写了一个处理用户信息的函数:
function processUser(data) {
  // 验证 data 是否为非 null 的对象
  if (data === null || typeof data !== 'object' || Array.isArray(data)) {
    throw new TypeError('data 必须是一个普通对象');
  }

  // 验证关键字段的类型
  if (typeof data.name !== 'string') {
    throw new TypeError('data.name 必须是字符串');
  }
  if (typeof data.age !== 'number' || Number.isNaN(data.age)) {
    throw new TypeError('data.age 必须是有效数字');
  }

  // 通过验证,执行业务逻辑
  console.log(`处理用户:${data.name},年龄:${data.age}`);
}这里有两个容易踩坑的地方。第一,typeof null返回的是"object",所以要单独排除null。第二,NaN的类型也是"number",需要用Number.isNaN()额外判断。
如果data可能是数组,用Array.isArray(data)来判断比instanceof Array更可靠,因为后者在跨iframe场景下可能失效。
三、结构和字段完整性检查
类型没问题之后,接下来确认data的内部结构。一个实用的做法是列出必须存在的字段,逐个检查:
function validateUserData(data) {
  const requiredFields = ['name', 'age', 'email'];
  const missingFields = requiredFields.filter(field => !(field in data));

  if (missingFields.length > 0) {
    throw new Error(`缺少必要字段:${missingFields.join(', ')}`);
  }

  // 检查嵌套结构
  if (data.address) {
    if (typeof data.address !== 'object' || !data.address.city) {
      throw new Error('address 字段结构不完整,缺少 city');
    }
  }
}注意用field in data而不是data[field] !== undefined来判断字段是否存在。两者的区别在于,如果某个字段的值被显式设置为undefined,in运算符仍然返回true,而后者会误判为"不存在"。当然,在多数业务场景下差别不大,但在做严格校验时值得留意。
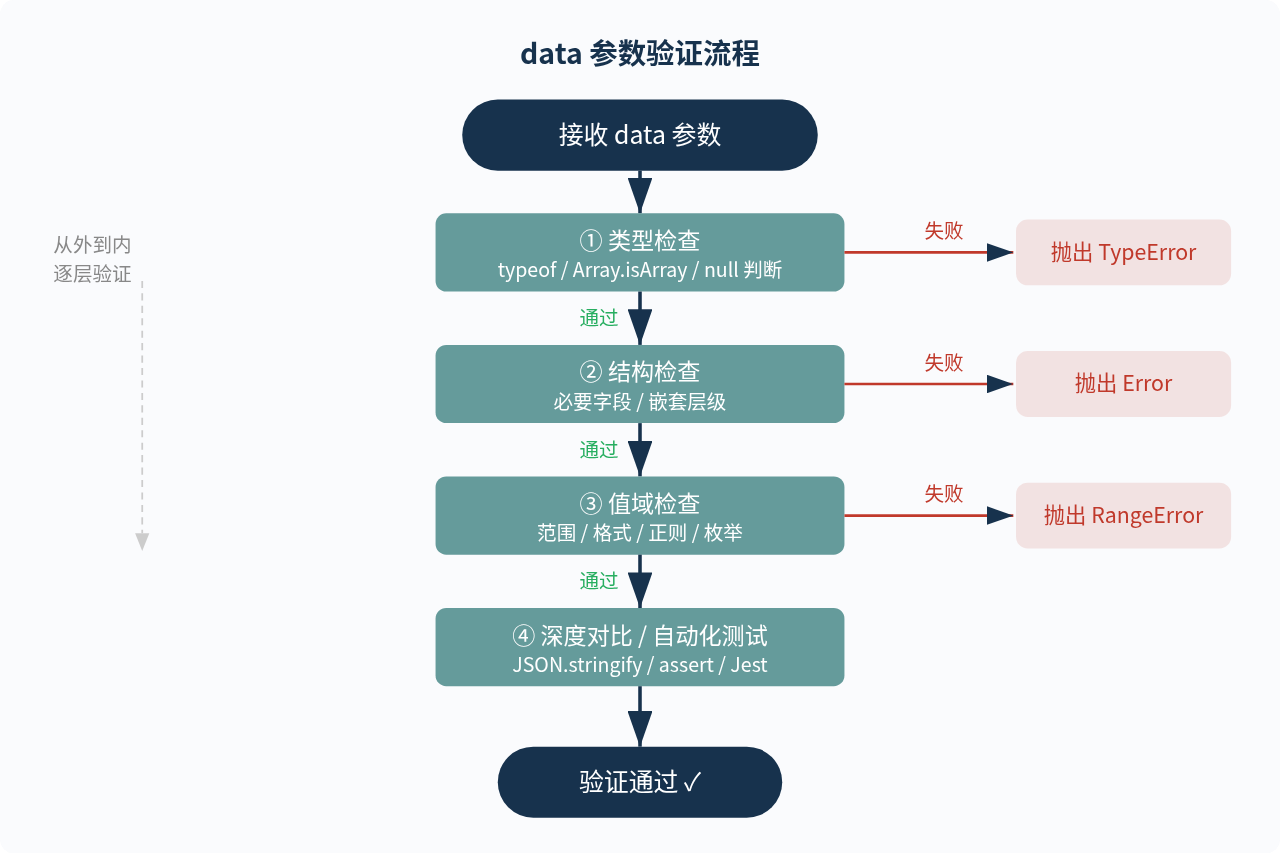
图1:data 参数验证流程——从类型到值域逐层检查
四、值域与格式验证
确认字段存在之后,还要看具体的值是否合理。常见的做法包括范围判断、正则匹配、枚举校验:
function validateValues(data) {
  // 年龄范围
  if (data.age < 0 || data.age > 150) {
    throw new RangeError('age 不在合理范围内(0-150)');
  }

  // 邮箱格式(简单校验)
  const emailReg = /^[^\s@]+@[^\s@]+\.[^\s@]+$/;
  if (!emailReg.test(data.email)) {
    throw new Error('email 格式不正确');
  }

  // 状态枚举
  const validStatus = ['active', 'inactive', 'pending'];
  if (data.status && !validStatus.includes(data.status)) {
    throw new Error(`status 必须是 ${validStatus.join(' / ')} 之一`);
  }
}
邮箱的正则这里用的是一个简化版本,只检查基本结构。如果业务对格式要求严格,可以参考 RFC 5322 标准或者使用专门的验证库。不过对大多数前端场景来说,这个简化正则已经够用了。
五、用深度对比验证整体结果
有时候你需要验证函数处理后的data是否和预期结果完全一致。直接用===比较对象只会比较引用,不会比较内容。最简单的深度对比方式是JSON.stringify:
const expected = { name: '张三', age: 28, email: 'zhangsan@example.com' };
const result = processAndReturn(rawData);

if (JSON.stringify(result) === JSON.stringify(expected)) {
  console.log('验证通过:data 结果与预期一致');
} else {
  console.log('验证失败:data 结果与预期不一致');
  console.log('期望:', expected);
  console.log('实际:', result);
}JSON.stringify有一个局限:对象属性的顺序不同会导致字符串不一样,即使内容相同。如果对象结构比较复杂或属性顺序不确定,更稳妥的做法是写一个递归对比函数:
function deepEqual(a, b) {
  if (a === b) return true;
  if (typeof a !== typeof b) return false;
  if (a === null || b === null) return false;
  if (typeof a !== 'object') return false;

  const keysA = Object.keys(a);
  const keysB = Object.keys(b);
  if (keysA.length !== keysB.length) return false;

  return keysA.every(key => deepEqual(a[key], b[key]));
}

// 使用
if (deepEqual(result, expected)) {
  console.log('深度对比通过');
}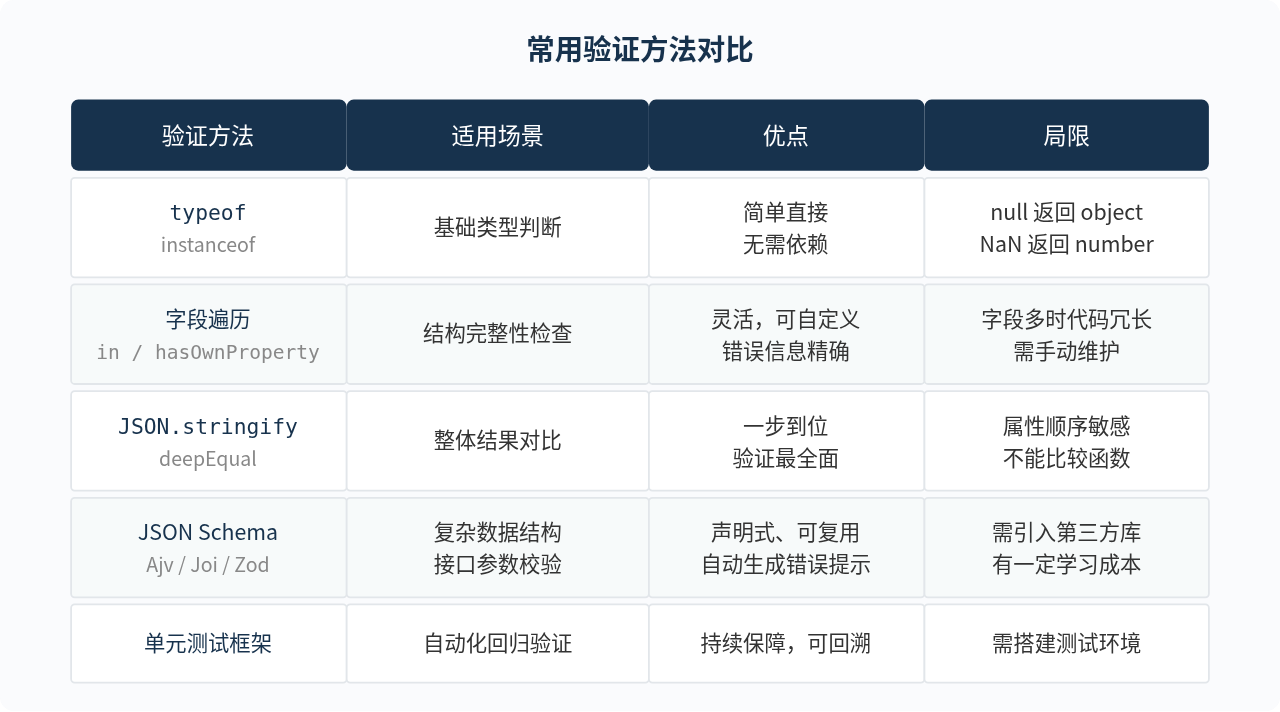
图2:五种验证方法的适用场景、优点和局限对比
六、用 Schema 验证复杂结构
当data参数的字段很多、嵌套层级深时,手写检查代码会变得又长又难维护。这时候可以用Schema验证的方式,把"数据应该长什么样"用一个描述对象定义好,然后交给验证引擎自动检查。
以 Ajv(一个轻量的 JSON Schema 验证库)为例:
import Ajv from 'ajv';

const ajv = new Ajv();

// 定义 data 应有的结构
const schema = {
  type: 'object',
  properties: {
    name:  { type: 'string', minLength: 1 },
    age:   { type: 'number', minimum: 0, maximum: 150 },
    email: { type: 'string', format: 'email' },
    tags:  { type: 'array', items: { type: 'string' } }
  },
  required: ['name', 'age', 'email'],
  additionalProperties: false
};

const validate = ajv.compile(schema);

function handleData(data) {
  if (!validate(data)) {
    console.error('data 验证失败:', validate.errors);
    return;
  }
  // data 结构和值都合规,继续处理
  console.log('验证通过,处理数据...');
}
Schema的好处是,验证规则和业务逻辑分离,改规则不用动业务代码。Ajv 还会自动生成带定位信息的错误列表,比如告诉你/age字段不满足minimum约束,调试起来非常方便。
如果项目已经使用了TypeScript,也可以考虑 Zod。它的写法更贴近 TypeScript 类型,还能自动推导出类型定义:
import { z } from 'zod';

const UserSchema = z.object({
  name: z.string().min(1),
  age: z.number().int().min(0).max(150),
  email: z.string().email(),
  tags: z.array(z.string()).optional()
});

function handleData(data: unknown) {
  const result = UserSchema.safeParse(data);
  if (!result.success) {
    console.error('验证失败:', result.error.issues);
    return;
  }
  // result.data 已有正确的类型推导
  console.log(result.data.name);
}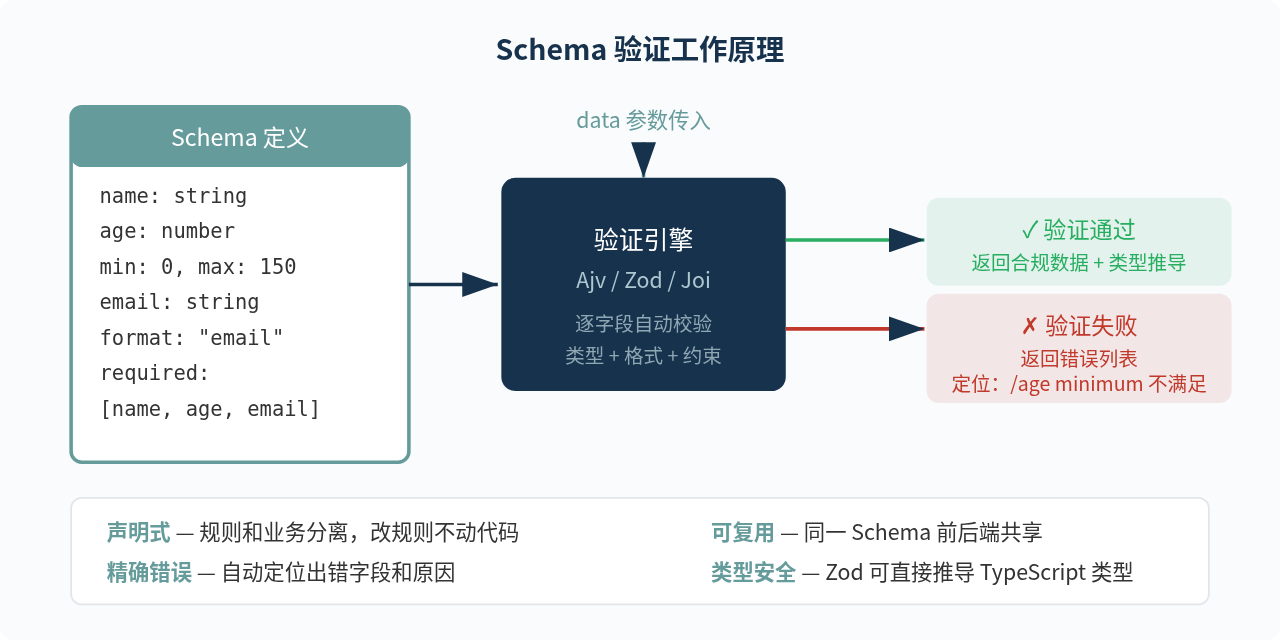
图3:Schema 验证的工作原理——将数据定义和自动校验分离
七、用单元测试持续验证
手动验证只能在开发时用,没办法保证后续修改代码时data仍然正确。把验证逻辑写成单元测试,才能在每次提交时自动回归。下面是一个用Jest写的示例:
// processUser.test.js
const { processUser } = require('./processUser');

describe('processUser data 参数验证', () => {
  test('正常数据应通过验证', () => {
    const data = { name: '张三', age: 28, email: 'zs@test.com' };
    expect(() => processUser(data)).not.toThrow();
  });

  test('data 为 null 时应抛出 TypeError', () => {
    expect(() => processUser(null)).toThrow(TypeError);
  });

  test('缺少 name 字段时应抛出错误', () => {
    const data = { age: 28, email: 'zs@test.com' };
    expect(() => processUser(data)).toThrow('name');
  });

  test('age 为负数时应抛出 RangeError', () => {
    const data = { name: '张三', age: -1, email: 'zs@test.com' };
    expect(() => processUser(data)).toThrow(RangeError);
  });

  test('email 格式错误时应抛出错误', () => {
    const data = { name: '张三', age: 28, email: 'invalid' };
    expect(() => processUser(data)).toThrow('email');
  });
});
测试用例的思路是覆盖几种典型情况:正常输入、空值/null、缺少字段、值越界、格式错误。你不需要穷举每一种可能的输入,但至少要覆盖边界情况和最容易出问题的场景。
八、封装一个通用验证函数
如果项目中多个函数都需要验证data参数,可以把验证逻辑抽取出来复用:
function validateData(data, rules) {
  if (data === null || typeof data !== 'object' || Array.isArray(data)) {
    return { valid: false, errors: ['data 必须是普通对象'] };
  }

  const errors = [];

  for (const [field, rule] of Object.entries(rules)) {
    const value = data[field];

    // 必填检查
    if (rule.required && !(field in data)) {
      errors.push(`缺少必要字段:${field}`);
      continue;
    }
    if (!(field in data)) continue;

    // 类型检查
    if (rule.type && typeof value !== rule.type) {
      errors.push(`${field} 应为 ${rule.type},实际为 ${typeof value}`);
      continue;
    }

    // 范围检查
    if (rule.min !== undefined && value < rule.min) {
      errors.push(`${field} 不能小于 ${rule.min}`);
    }
    if (rule.max !== undefined && value > rule.max) {
      errors.push(`${field} 不能大于 ${rule.max}`);
    }

    // 正则检查
    if (rule.pattern && !rule.pattern.test(value)) {
      errors.push(`${field} 格式不正确`);
    }
  }

  return { valid: errors.length === 0, errors };
}

// 使用示例
const rules = {
  name:  { required: true, type: 'string' },
  age:   { required: true, type: 'number', min: 0, max: 150 },
  email: { required: true, type: 'string', pattern: /^[^\s@]+@[^\s@]+\.[^\s@]+$/ }
};

const result = validateData(userData, rules);
if (!result.valid) {
  console.error('验证不通过:', result.errors);
}
这样每次只要定义一组规则对象就行,验证逻辑只维护一处。
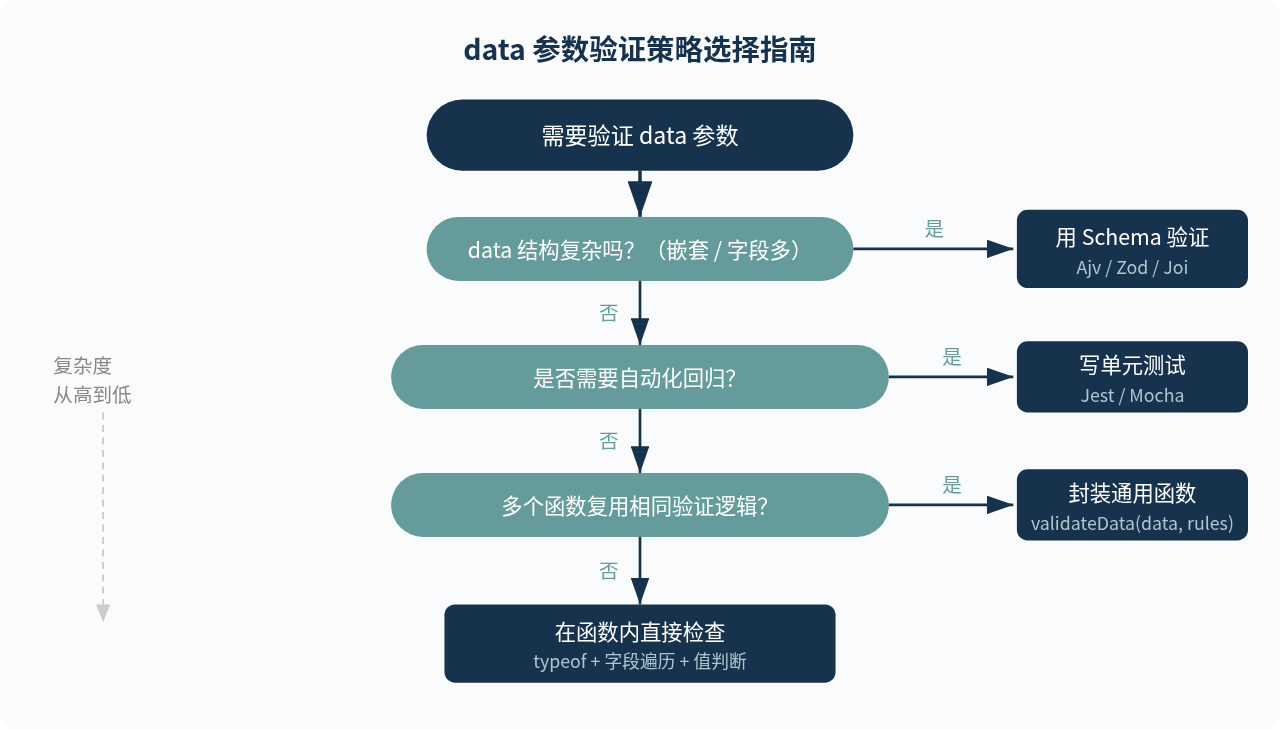
图4:根据实际需求选择合适的验证策略
九、几点容易忽略的细节
空字符串和0的处理。 用if (!data.name)做判断时,空字符串""和数字0都会被当成"没有"。如果业务允许空字符串或0作为合法值,改用data.name === undefined或data.name === null。
可选字段不要强制验证。 并不是data里的每个字段都需要检查。只有用到的字段和影响结果正确性的字段才需要验证。过度校验会让代码膨胀且脆弱——调用方多传了一个字段就报错,反而不好用。
验证时机。 最好在函数入口就做验证,通过后再进入业务逻辑。不要等到用data的中途才发现问题,那时可能已经产生了副作用(比如写入了一半数据)。
错误信息要有定位价值。 抛出的错误应该说明是哪个字段有什么问题,而不只是一句"参数错误"。这会在调试时省下大量时间。
总结一下:验证
data参数的结果是否正确,从简单到完善依次是——手动类型检查 → 字段结构校验 → 值域与格式验证 → Schema声明式验证 → 单元测试持续保障。根据项目规模和data的复杂程度选择合适的层级,关键是先做起来,别等到线上出了问题才后悔没验证。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章