
深入对比 JavaScript 中 reduce、for 循环以及 map/filter 链式调用的性能与可读性。解析 V8 底层执行机制、中间内存分配、常见心智反模式及工程选型决策指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS reduce与for循环、map/filter的性能及可读性对比
作者:代码拾荒
时间:2026-11-06
浏览:177
文章目录
在日常 JavaScript 开发中,数组操作是出现频率最高的任务之一。面对相同的数据处理需求,选择命令式的
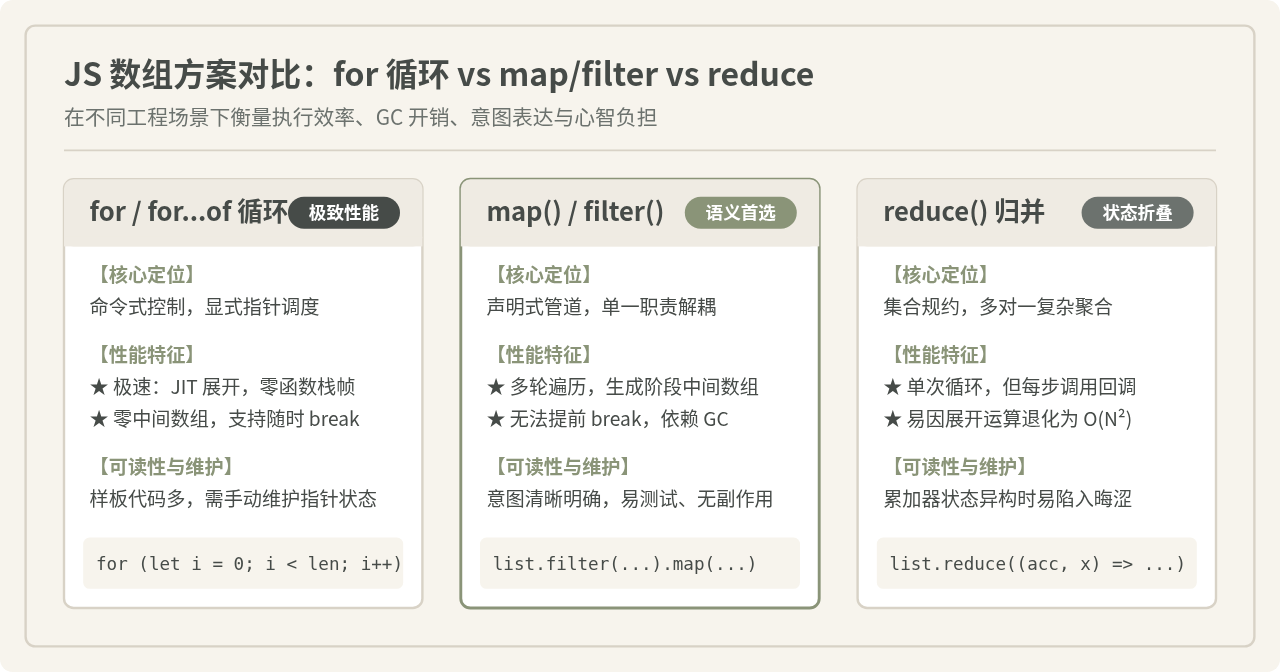
for 循环、声明式的链式调用 filter().map(),还是功能强大的 reduce(),直接决定了代码的维护成本与运行效率。核心结论可以明确概括为:在绝大多数常规前端业务场景下,filter() + map() 职责单一、意图清晰,可读性显著优于其他两者;而在海量数据批处理、游戏循环或需要提前中断迭代的极高频场景中,原生 for 循环以极低的抽象开销、零中间数组分配和灵活的 break 控制稳居性能榜首;reduce() 的正规适用领域是多对一的归并聚合(如求和、构建字典索引),强行用 reduce() 替代 map/filter 来追求所谓的“单次循环”往往会导致代码心智负担剧增,甚至因展开运算符的误用而引发灾难性的性能倒退。
一、核心范式与语法意图的分野
为了理清三者的适用边界,首先需要理解它们在程序设计范式上的本质差异。JavaScript 既吸收了 C 语言的命令式过程控制,又深度融合了函数式编程的声明式范式,这三类语法结构恰好处于不同的抽象层次上。
1. 原生 for 循环:底层命令式调度
for 循环(以及 for...of)是标准的命令式结构。开发者需要显式管理迭代指针(索引 i)、循环终止边界以及每一步的步进规则。它的核心特征在于控制权完全在开发者手中:
- 完全的过程控制:可以使用
break提前退出,使用continue跳过当前项,使用return直接返回上层函数。 - 零抽象惩罚:不需要为每一个元素创建执行函数栈帧,无闭包环境捕获,数据直接在当前局部作用域内完成计算与写入。
- 认知缺陷:需要引入额外的可变变量(如用于存储结果的空数组,并在循环体中反复调用
push),代码冗长且无法直观表达业务目的。
2. map / filter:纯函数式的声明式管道
Array.prototype.map 与 Array.prototype.filter 是典型的声明式高阶函数。它们向开发者隐藏了具体的指针递增细节,只要求传入一个纯函数来表达业务规则:
filter接受断言函数(Predicate),明确表示“按条件保留子集”;map接受投影函数(Transform),明确表示“一对一形态转换”。
将二者通过链式调用组合时,代码结构就像一条工业装配线,读者无需进入底层细节就能立刻理解整段代码的输入与输出意图。
3. reduce:集合规约与状态折叠
Array.prototype.reduce 的理论根基是函数式编程中的折叠操作(Fold)。它的核心特征是维护一个跨迭代传递的“累加器”(Accumulator)。每一个输入项结合当前的累加器状态,计算出下一阶段的累加器状态。
reduce 的能力极其通用——理论上 map 和 filter 都可以作为 reduce 的特例实现。但也正因为它的万能性,累加器的类型与形态可以是数字、字符串、数组、对象乃至更复杂的结构。一旦累加器被赋予过多职责,代码就会迅速滑向晦涩难懂的深渊。
二、执行机制与内存开销剖析
很多开发者在讨论性能时,往往把视角停留在“循环了多少次”这个单一维度上。然而在现代 JavaScript 引擎(如 V8)中,内存分配、函数调用开销与垃圾回收(Garbage Collection)对最终执行时间的影响,往往远远超过循环计数本身。
1. 为什么 map + filter 会产生额外开销?
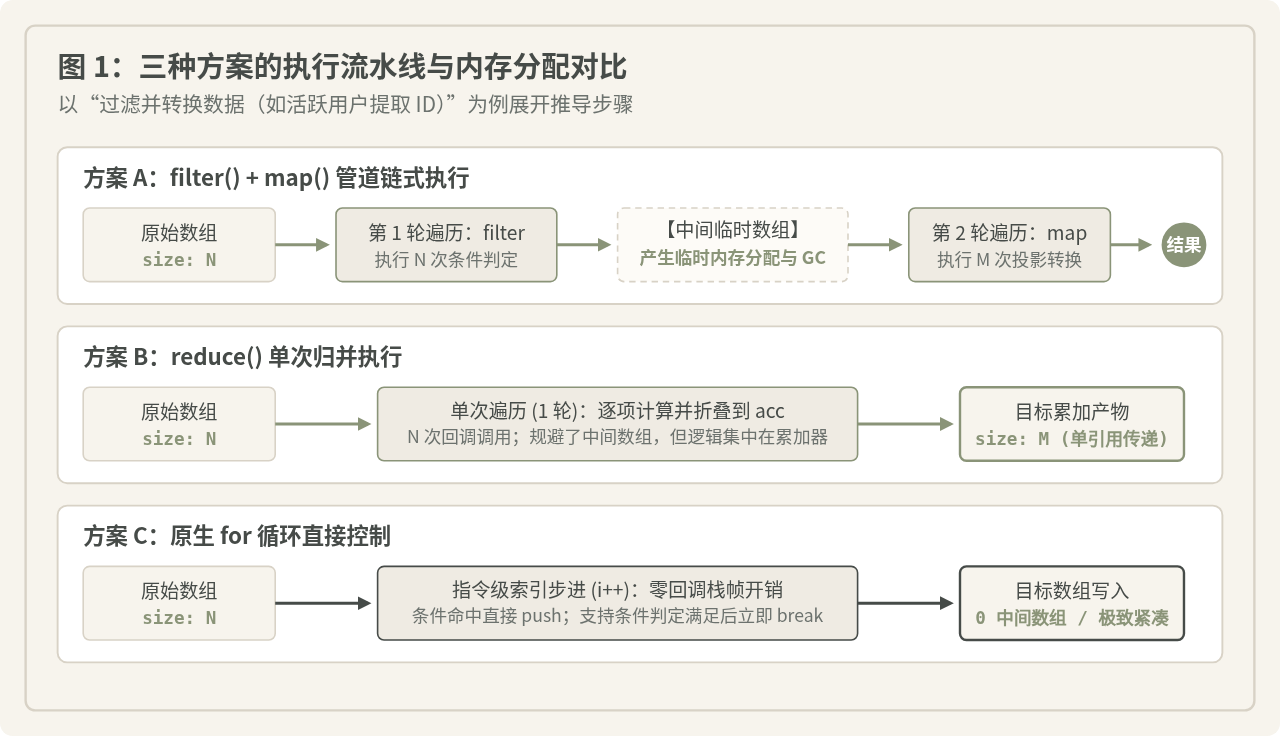
观察链式调用 list.filter(fn1).map(fn2) 的推导流程:
- 第一阶段:
filter遍历整个长度为 $N$ 的数组,分配一块全新的连续内存区域,将符合条件的 $M$ 个元素推入该临时数组。 - 第二阶段:
map接收上述临时数组,再次进行长度为 $M$ 的第二轮遍历,并分配另一个全新的最终数组。 - 后置处理:第一阶段生成的长度为 $M$ 的临时数组在链式调用结束后即失去引用,变为无用内存,进入 V8 新生代垃圾回收(Young Generation Scavenge)的待回收队列。
这构成了链式调用的固有代价:双重遍历($N + M$ 次函数调用)与一次中间临时数组的堆内存分配与垃圾回收压力。
2. reduce 的单次遍历真相与内存反模式
直觉上,使用 reduce 可以把过滤和转换压缩进单次循环,从而“节约 50% 的迭代开销”。但事实上,单次遍历并不等于零开销:
reduce仍然需要在每一轮循环中调用一次回调函数,伴随着函数入栈、出栈与参数传递。- 如果在回调内部编写了不当的状态累加,不仅无法提升性能,反而会引发严重的性能坍塌。最典型的例子就是在
reduce内部使用对象展开运算符(Spread Operator)或数组拼接:
// 严重反模式:看似简洁的不可变写法
const activeUsersMap = users.reduce((acc, user) => {
  if (!user.isActive) return acc;
  return { ...acc, [user.id]: user }; // 致命缺陷:每一轮迭代都在浅克隆整个累加器对象!
}, {});
复杂度陷阱剖析:
在上述代码中,每次
...acc 都会遍历并复制当前累加器中的所有键值对。当数组有 $N$ 项时,总拷贝次数为 $1 + 2 + 3 + \dots + N pprox rac{N^2}{2}$。算法复杂度直接从预期的 $O(N)$ 退化为可怕的 $O(N^2)$。当数据量从 1,000 项增长到 20,000 项时,代码执行时间会从几毫秒飙升至数秒,彻底摧毁应用性能。
3. 原生 for 循环的高性能支柱
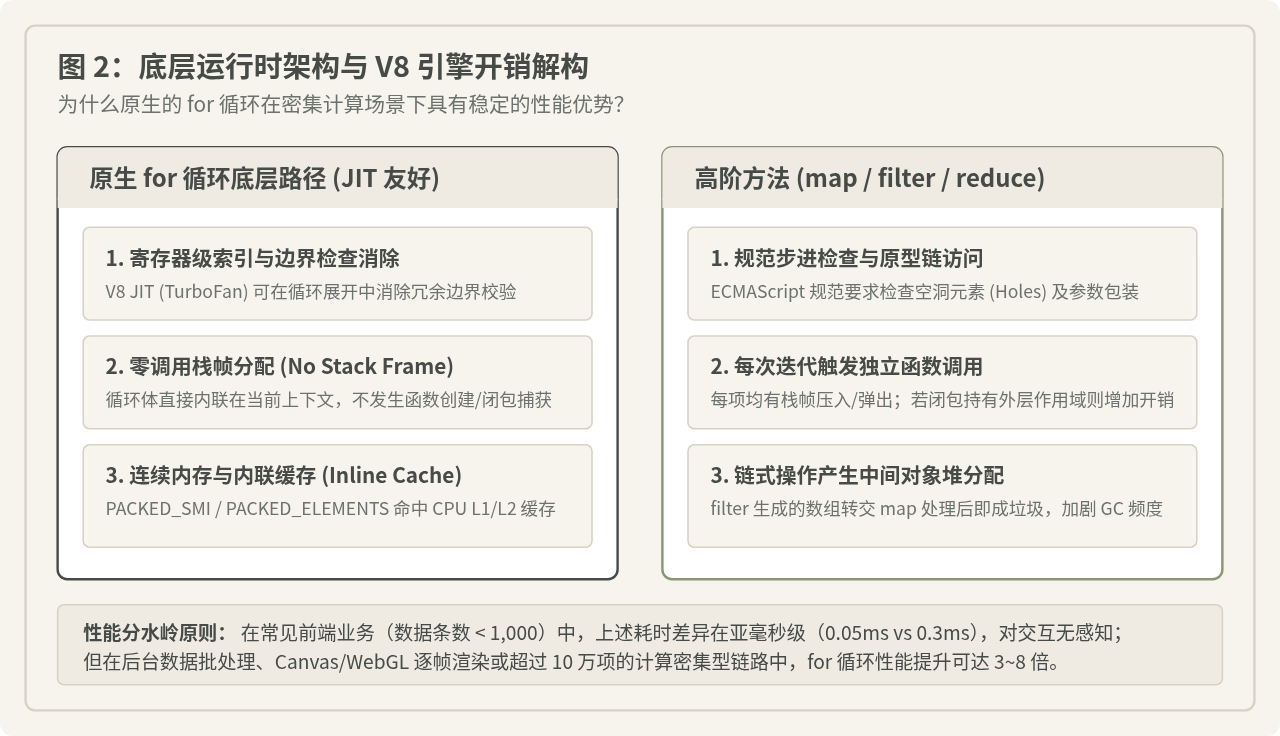
与之对比,原生 for 循环在编译为底层字节码时享有得天独厚的优化空间:
- 零栈帧开销:循环体直接内联在调用方上下文,无需在堆栈间切换调用帧。
- 零多余内存分配:直接在循环前预设结果数组,按需使用
push填入数据,完全避开了中间临时数组的分配。 - 短路能力:一旦满足某些业务条件(例如查找到首个符合项或达到分页上限),可以立即执行
break终止循环,将最坏情况的 $O(N)$ 降低为平均情况的 $O(K)$。高阶函数如map、filter和reduce均无法原生提前中断,必须全量跑完数组。
三、V8 引擎与真实基准性能对比
为了客观衡量上述机制对实际运行时间的影响,必须结合现代 JavaScript 引擎的优化器特性进行具体分析。脱离数据规模和执行环境谈性能是没有工程意义的。
1. JIT 优化机制的影响
现代 V8 引擎(如 Chrome、Node.js 中的 TurboFan 优化编译器)会对代码进行推测性优化。如果一个原生 for 循环处理的是密集打包的小整数(PACKED_SMI_ELEMENTS)或双精度浮点数(PACKED_DOUBLE_ELEMENTS),JIT 编译器能够生成极其紧凑的机器码,甚至实现循环展开(Loop Unrolling)并消除多余的数组越界检查。
相反,对于高阶函数,由于回调函数参数多样、存在 this 绑定及稀疏数组检查(ECMAScript 规范要求严格跳过空洞元素),引擎必须执行一系列合规性校验。尽管现代引擎对内置高阶函数进行了大量内联优化,但原生 for 循环在计算密集型路径上依然保持着绝对的速度基线。
2. 数据规模下的耗时表现阶梯
在标准 V8 运行时中,针对“过滤偶数并将值乘以二”这一标准操作,不同方案在不同数据规模下的相对表现呈现出清晰的阶梯特征:
| 方案分类 | 小规模数组 (100 项) | 中等规模 (5,000 项) | 大规模数据 (100,000 项) | 提前中断支持 (Break) |
|---|---|---|---|---|
| 原生 for 循环 (带预分配或 push) | ~0.01 ms (基准) | ~0.15 ms (基准) | ~2.8 ms (快 2.5 ~ 4 倍) | 支持(毫秒级瞬时退出) |
| map().filter() 链式 | ~0.03 ms | ~0.42 ms | ~8.9 ms (多出中间数组 GC) | 不支持(必须遍历全部项) |
| reduce() 正规原地 push | ~0.02 ms | ~0.38 ms | ~7.1 ms (函数调用开销稳定) | 不支持(需抛出异常或外部标志) |
| reduce() 展开运算符反模式 | ~0.25 ms | ~180.0 ms (严重退化) | 浏览器卡死 / 超时崩塌 | 不支持 |
从上述基准数据中可以得出关键的工程推论:
在前端常规 UI 渲染中(例如渲染一个包含 50 条记录的表格或列表),for 循环与 map/filter 的绝对耗时差异通常在 0.02 毫秒 级别。而人类对界面的感知阈值通常在 16 毫秒(60fps 帧间隔)以上。因此在常规业务代码中,以牺牲可读性为代价换取这 0.02 毫秒的提升,属于典型的无收益过度优化。
四、可读性与团队协作心智负担对比
代码被阅读的次数远远多于被编写的次数。所谓“可读性”,本质上指的是维护者在理解这段代码时,工作记忆(Working Memory)中需要维系的状态数量。
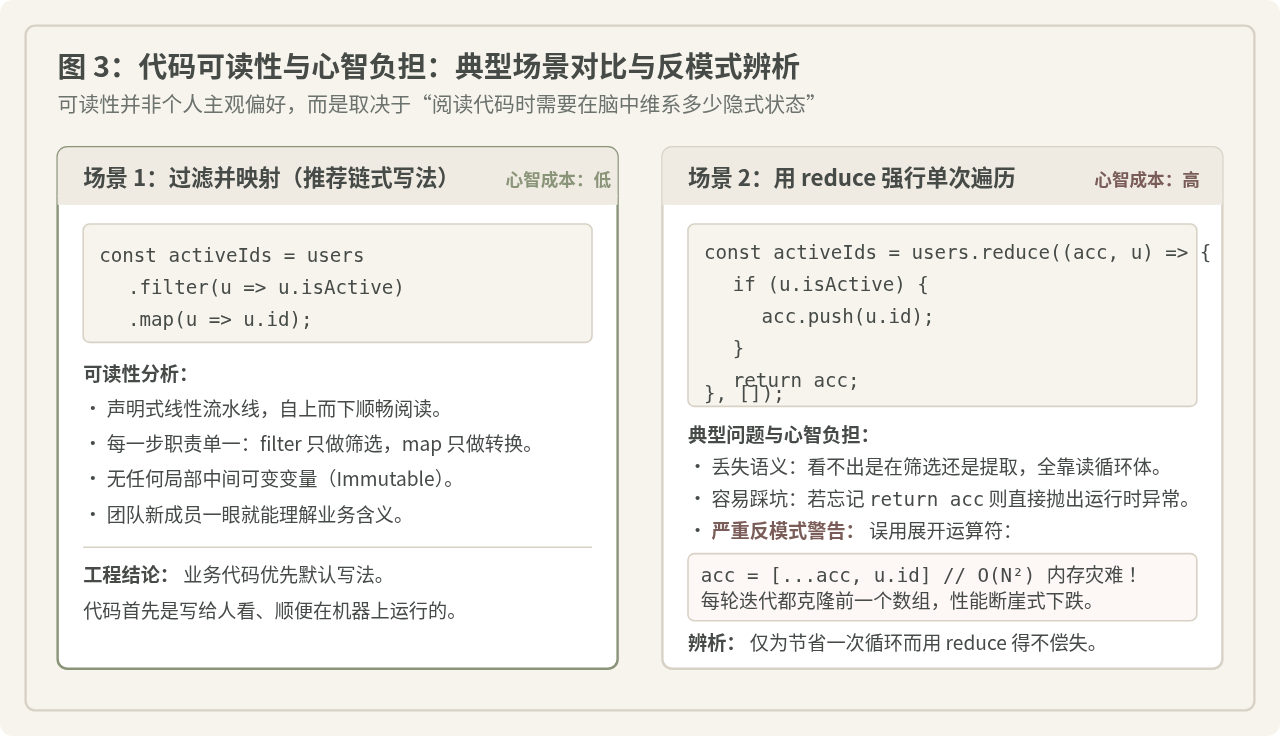
1. 场景 A:从用户列表中获取活跃用户的名称
对比以下两种实现方式:
// 方式一:声明式链式(推荐)
const activeUserNames = users
  .filter(user => user.isActive)
  .map(user => user.name);

// 方式二:强行合并到 reduce
const activeUserNames = users.reduce((acc, user) => {
  if (user.isActive) {
    acc.push(user.name);
  }
  return acc;
}, []);
在阅读方式一时,读者的思维路径是线性的:第一行知道在过滤活跃用户,第二行知道在提取名字,没有任何分支跳转,每一步都保证没有副作用。
而在阅读方式二时,读者必须在脑海中建立一个临时的上下文变量 acc,观察其初始化值是什么、条件分支中是否正确推入了数据、在每个分支(包括潜在的隐式分支)中是否都老老实实地执行了 return acc。一旦代码逻辑稍微增加两三行,漏写 return acc 导致产物变成 undefined 的低级 Bug 屡见不鲜。
2. 场景 B:何时 reduce 才是无可替代的可读利器?
这并不意味着 reduce 一无是处。当业务的目标本身就是“将一组离散数据归纳折叠为一个新形态的单一结构”时,reduce 拥有极高的表达力:
// 典型契合场景:根据分类将商品分组为字典
const productsByCategory = products.reduce((acc, item) => {
  const key = item.category;
  if (!acc[key]) {
    acc[key] = [];
  }
  acc[key].push(item);
  return acc;
}, {});
在这个场景中,目标产物是一个以分类为键的聚合字典,既不是简单的同维数组映射,也不是单纯的过滤。此时如果强行用 forEach 并在外层声明一个全局可变对象 let result = {},反而破坏了作用域封闭性。reduce 将状态严格限制在表达式内部,此时它的语义是精准且无可争议的。
3. 常见认知误区辨析
社区中常有一种流行观点:“能用 reduce 解决的问题,就不要用 map 和 filter,因为少跑了一次循环。”
为什么这种说法看似合理?因为在基础算法教学中,时间复杂度与循环次数正相关,直觉上减少一次遍历理所应当更快。
为什么在实际工程中它经常需要修正?
- 首先,它忽略了函数式编程中“关注点分离”带来的巨大工程红利。将过滤逻辑与转换逻辑拆开后,每个小函数都是独立的纯函数,能够被极其方便地单独抽离并进行单元测试。
- 其次,在数据量不大时,两轮循环的纯计算时间远不及开发者排查
reduce累加器逻辑分支所耗费的心智成本。 - 最后,一旦有新手开发者为了追求“不可变纯函数风格”,在
reduce中顺手写下[...acc, item],性能立刻出现断崖式滑坡,原本试图节省的微秒级收益变成了毁灭性的性能事故。
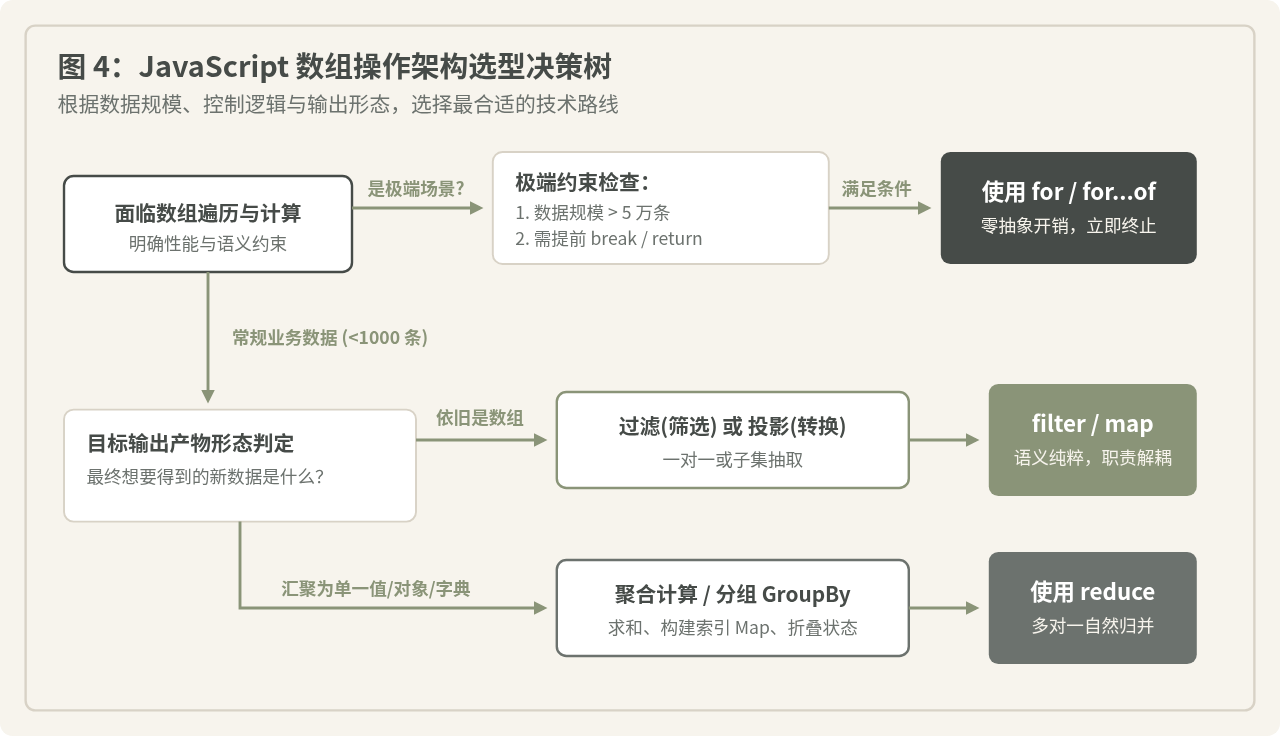
五、工程落地选型指南与实施守则
为了在团队协作与日常开发中建立统一的标准,可以遵循以下四条清晰的操作守则:
守则 1:业务数据流转,默认选用 map 与 filter
在绝大多数常规前端业务(API 数据回显、列表展示、表单字段清洗)中,直接选用 filter()、map() 的链式组合。保持每个函数的纯粹与语义直观,将代码的心智负担降到最低。
守则 2:仅在输出形态发生折叠汇聚时使用 reduce
只有当最终产物与输入数组在维度或形态上发生根本性变化时(例如:数值累加、多维数组扁平化汇总、数组转查找 Map、树结构构建),才使用 reduce。同时切记:累加器必须采用原地变更并返回,严禁在迭代中对累加器执行展开复制(...acc)。
守则 3:海量数据或需提前退出时,坚决回退到 for / for...of
当遇到以下三类特定场景时,应当毫不犹豫地使用原生 for 循环:
- 单次处理数据超过数万条:例如处理导出大文件、处理离线 Canvas 像素点阵或复杂的科学计算矩阵;
- 位于极端高频渲染链路:例如
requestAnimationFrame驱动的高性能动画或可视化图表更新; - 需要提前中断迭代:如果只要找到符合条件的一组数据后就停止遍历,原生循环配合
break可以节省绝大部分无效计算。
守则 4:警惕“过早优化”与“伪优化”
如果一个系统确实出现了性能瓶颈,应当优先通过 Chrome DevTools 的 Performance 面板捕获调用火焰图(Flame Graph)。几乎所有真实业务中的性能卡顿,都来自于不合理的 DOM 频繁重绘、未防抖的网络请求、或者 $O(N^2)$ 的嵌套查找,而绝非因为你在百条数据的处理上多执行了一次 filter。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章