
系统解析在JavaScript遍历数组过程中修改原数组常见的漏项、死循环与副作用问题,深入剖析for、forEach与迭代器底层机制,并提供倒序遍历、双指针原地压缩及纯函数替代等最佳实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS遍历数组时修改原数组的注意事项与副作用
作者:代码拾荒
时间:2026-11-05
浏览:123
文章目录
主题:JavaScript 核心语法与内存机制
阅读时长:约 8 分钟
代码规范:ES6+ / ES2023
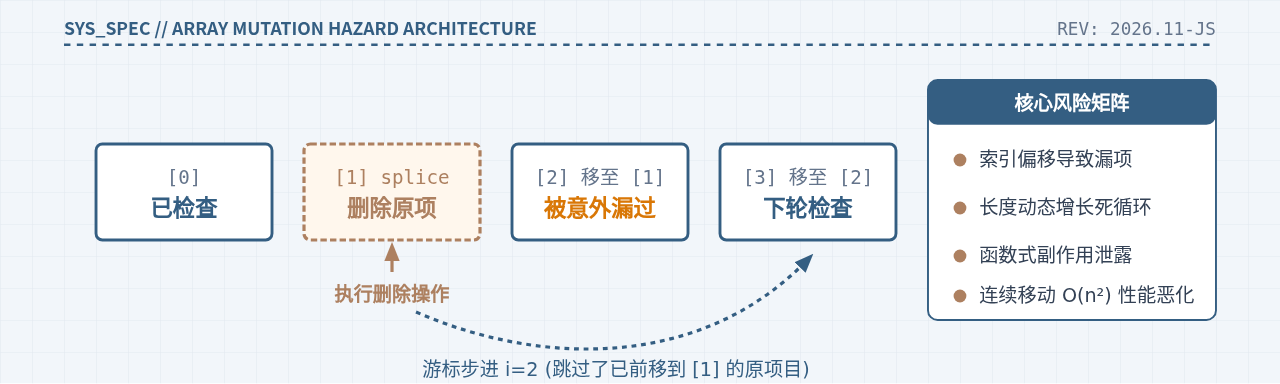
图 0:JavaScript 遍历变异原数组的核心冲突与位移风险概览
在 JavaScript 中遍历数组的同时对原数组进行增删或重排,极易引发索引漏项、死循环、不可预知的迭代截断以及 O(n²) 内存频繁搬移。其根本原因在于:大多数循环结构依据固定的步进游标或预设长度执行,而原数组的长度与元素索引在变异(Mutation)操作发生后会实时改变。理解这种内部索引与引用状态的脱节,是编写高质量业务代码的必要基础。
一、为什么遍历中修改原数组会引发异常?
JavaScript 数组属于变长对象,内存表现通常由连续的内存缓冲区或带哈希映射的元素存储字典支持。无论是经典的 for 循环、迭代器语法(for...of),还是原型方法(forEach、map、filter),遍历过程本质上都维护着一个用于定位下一个元素的内部推进游标(Cursor / Current Index)。
当我们在循环体中调用 splice()、shift()、pop()、unshift() 或 push() 时,数组内部的索引排布和 length 属性会立刻发生改变。然而,外部控制循环的计数变量通常按照原本设定的规则继续递增,此时游标所指的下标与实际需要访问的元素位置产生了位移脱节。
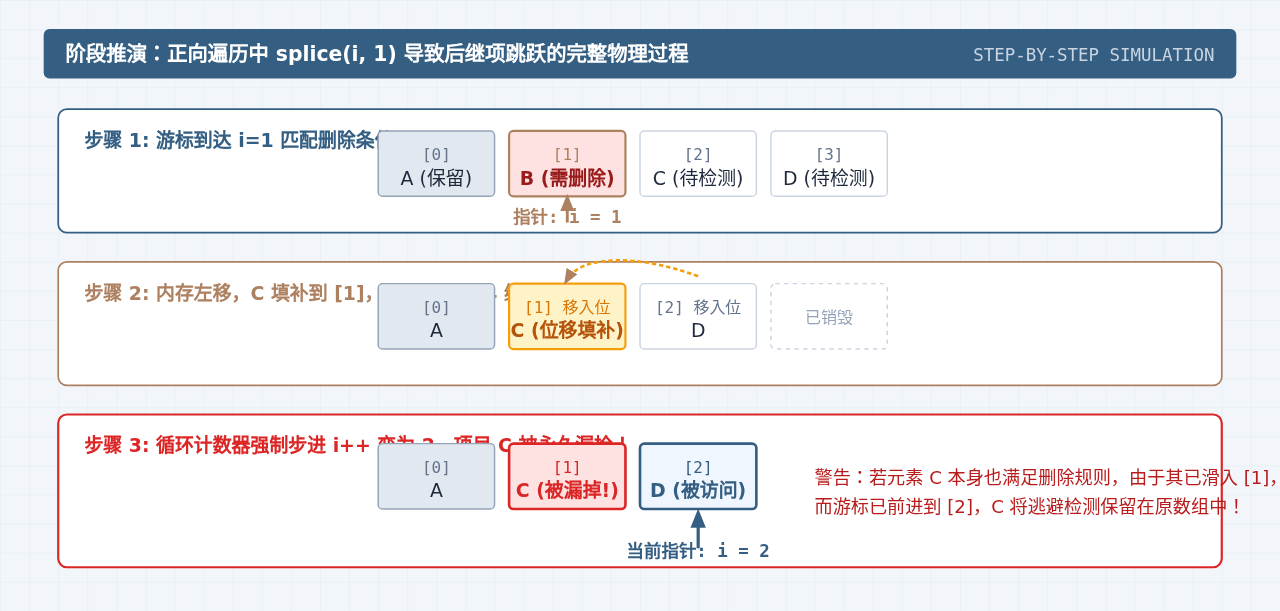
图 1:正向遍历中执行 splice 导致后续相邻元素被完全跳过(漏检)的物理机理
二、典型副作用与常见故障模式
1. 正向遍历删除时的“漏项”陷阱(Element Skipping)
这是生产环境中最常见也是最隐蔽的缺陷。当两个满足删除条件的元素恰好在数组中相邻排列时,正向 for 循环将必定漏掉后一个元素。
// 示例场景:过滤掉所有大于 10 的偶数
const list = [10, 12, 14, 15, 18];

for (let i = 0; i < list.length; i++) {
  if (list[i] > 10 && list[i] % 2 === 0) {
    list.splice(i, 1);
  }
}

// 预期结果: [10, 15]
// 实际输出: [10, 14, 15]  --- 元素 14 被漏删了!
执行推演如下:
- 当
i = 1时,list[1]为12,满足条件被删除。后面的元素14自动向左移动,占用下标1。 - 循环末尾触发
i++,i递增为2。 - 下一轮访问
list[2],此时该位置存储的是15。刚才移入下标1的元素14从未被传入if检查条件,导致数据清洗不彻底。
2. 动态追加元素导致的死循环(Infinite Loop)
如果在循环体内向原数组末尾追加元素(如 push()),并且终止条件依赖于 i < arr.length,每次迭代都会使得 arr.length 增加 1。
const queue = [1, 2, 3];

// 危险代码:遍历中向末尾追加关联任务
for (let i = 0; i < queue.length; i++) {
  if (queue[i] === 2) {
    queue.push(4); // 每次处理都可能导致 length 增长
  }
}
如果业务逻辑在后续迭代中继续满足追加分支条件,queue.length 的增长速度将始终大于或等于 i 的自增速度,导致主线程卡死、浏览器无响应或 Node.js 进程耗尽堆内存(OOM)。
3. 高阶迭代方法中修改原数组的控制力缺失
在 forEach()、map()、filter() 等函数式方法中,开发者无法干预其内部维护的索引递增机制。
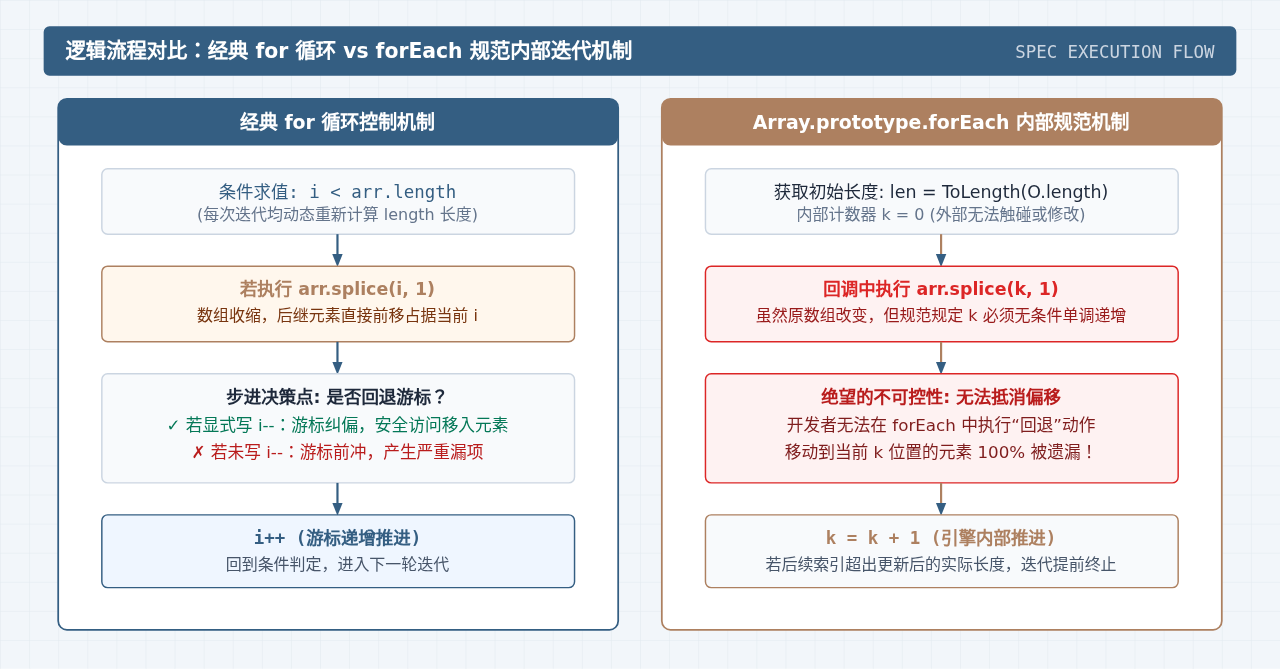
图 2:for 循环与 forEach 底层规范在遭遇数组变异时的控制力流向对比
ECMAScript 规范提示:根据 ECMA-262 标准关于
Array.prototype.forEach 的规范说明:遍历的元素范围在第一次调用回调函数前就已确定。在调用开始后追加到数组中的元素不会被回调函数访问;而如果已经存在的元素被修改,它们传给回调函数的值是 forEach 访问它们那一刻的值;被删除的元素将不会被访问。
4. 浅层引用的属性修改 vs 数组结构变异
区分修改数组中对象元素的属性与修改数组本身的物理槽位至关重要:
- 修改元素内部属性(允许且安全):如
item.status = 'done'。这只修改了堆内存中对象自身的属性,数组本身保存的对象指针没有变化,数组的length和下标索引完全保持原样,不会对后续循环产生干扰。 - 改变数组形态(危险):如通过下标直接修改非对象元素、调用
splice()改变总长度、删除槽位或重排序(sort/reverse)。这直接改变了遍历器的前进基准。
三、性能副作用:循环删除中的 O(n²) 内存损耗
除了业务逻辑上的漏洞,如果在长度为 $N$ 的大数组中正向遍历并频繁使用 splice(i, 1),会引发严重的性能滑坡。
在 V8 等现代 JavaScript 引擎中,快速数组(Fast Elements)在底层通常映射为一块连续的线性内存空间。每当在下标 $i$ 处执行一次删除操作,引擎必须将处于 $[i + 1, N - 1]$ 区间的所有元素指针逐个向左移动一个单元(通过类似 memmove 的操作)。若整个遍历过程中删除了 $M$ 个元素,总操作量大致为 $\sum_{k=1}^{M} (N - i_k)$。在最坏情况下,时间复杂度将直接飙升至 $O(N^2)$。
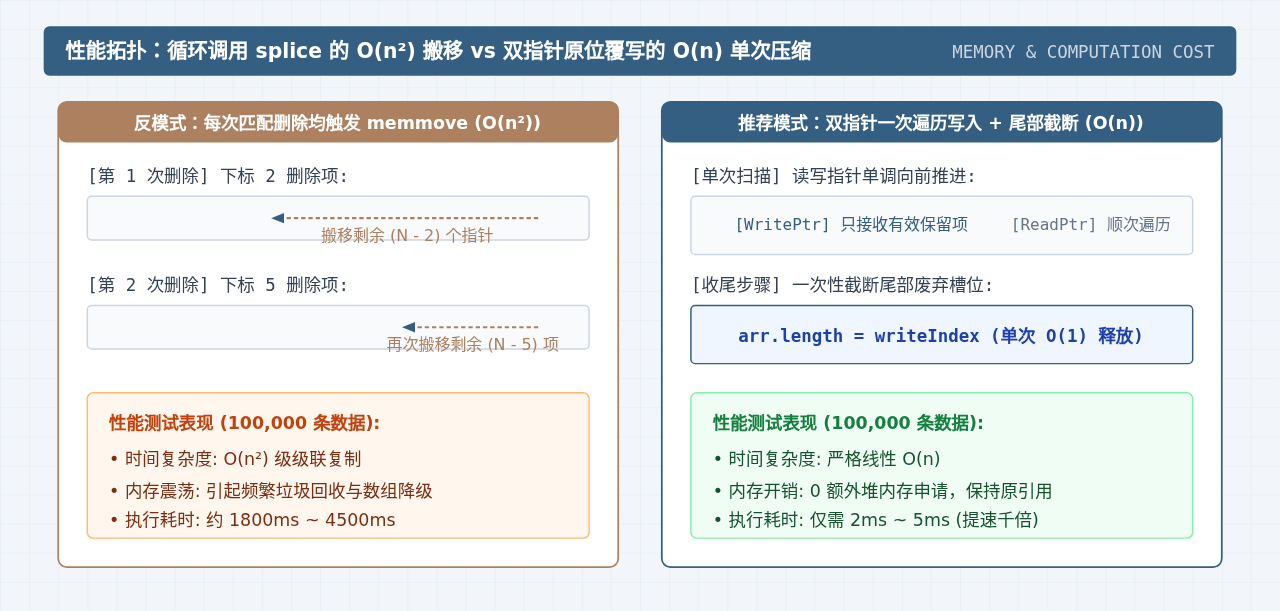
图 3:循环使用 splice 与双指针就地覆写的内存操作开销及耗时对比
四、避坑实践:解决遍历修改需求的安全方案
方案一:倒序遍历(适合小规模数组的简易就地删除)
如果因为业务限制必须在原数组上直接删除元素,且不引入新的数组实例,从后向前逆序遍历是最直接的纠偏手段。
核心机理:从数组末尾(arr.length - 1)向 0 递减。当调用 splice(i, 1) 时,受影响并发生左移的元素全部位于当前游标 i 的右侧,而下一轮迭代要访问的元素在 i - 1(当前游标的左侧)。因此,已被访问过的元素移动不会对未访问的元素索引产生任何干扰。
const list = [10, 12, 14, 15, 18];

// 倒序遍历:i 从最大索引递减到 0
for (let i = list.length - 1; i >= 0; i--) {
  if (list[i] > 10 && list[i] % 2 === 0) {
    list.splice(i, 1); // 改变的只是 i 右侧已处理项的物理下标
  }
}

// 运行结果: [10, 15](完全符合预期)
适用边界:代码量极小,适用于百量级以内的小型数组。但如果数组包含数万个元素且删除频率高,其内部的内存搬移仍然存在性能瓶颈。
方案二:双指针原地写回法(最高性能的原地修改)
当需要保留原数组引用(例如该数组被多个外部模块引用),同时又面临大规模数据的高吞吐量清洗时,双指针算法是工程最优解。
我们使用 writeIndex 标记有效保留项应该存放的位置,使用 readIndex 依次扫描原数组。符合保留条件的元素直接覆写到 writeIndex,最后通过修改 arr.length = writeIndex 斩断多余的尾部空间。
function compactArrayInPlace(arr, predicate) {
  let writeIndex = 0;

  for (let readIndex = 0; readIndex < arr.length; readIndex++) {
    // 满足保留条件(即不是待删除元素)
    if (!predicate(arr[readIndex], readIndex, arr)) {
      if (writeIndex !== readIndex) {
        arr[writeIndex] = arr[readIndex];
      }
      writeIndex++;
    }
  }

  // 一次性物理截断,触发引擎内部 O(1) 缩减
  arr.length = writeIndex;
  return arr;
}

// 使用示例
const data = [10, 12, 14, 15, 18];
compactArrayInPlace(data, item => item > 10 && item % 2 === 0);
console.log(data); // [10, 15] 严格 O(n),零漏项
方案三:纯函数式替换(推荐的业务开发范式)
在日常 Web 业务系统(如 React、Vue 等现代框架)中,强行原地变异数组往往破坏响应式系统的依赖追踪机制,导致视图不刷新或状态难以预测。现代前端推崇不可变数据(Immutable Data)理念:通过返回新数组代替原地修改。
| 目标操作 | 原数组变异方法(容易产生副作用) | 不可变替代方案(纯函数 / 推荐) | 支持规范 |
|---|---|---|---|
| 元素条件剔除 / 过滤 | for + splice(i, 1) |
arr.filter(predicate) |
ES5 |
| 元素形态映射 / 转换 | forEach 原地赋值修改 |
arr.map(transform) |
ES5 |
| 区间替换 / 删除 | arr.splice(start, count, ...items) |
arr.toSpliced(start, count, ...items) |
ES2023 |
| 指定索引单项替换 | arr[index] = newValue |
arr.with(index, newValue) |
ES2023 |
| 数组翻转 / 排序 | arr.reverse() / arr.sort() |
arr.toReversed() / arr.toSorted() |
ES2023 |
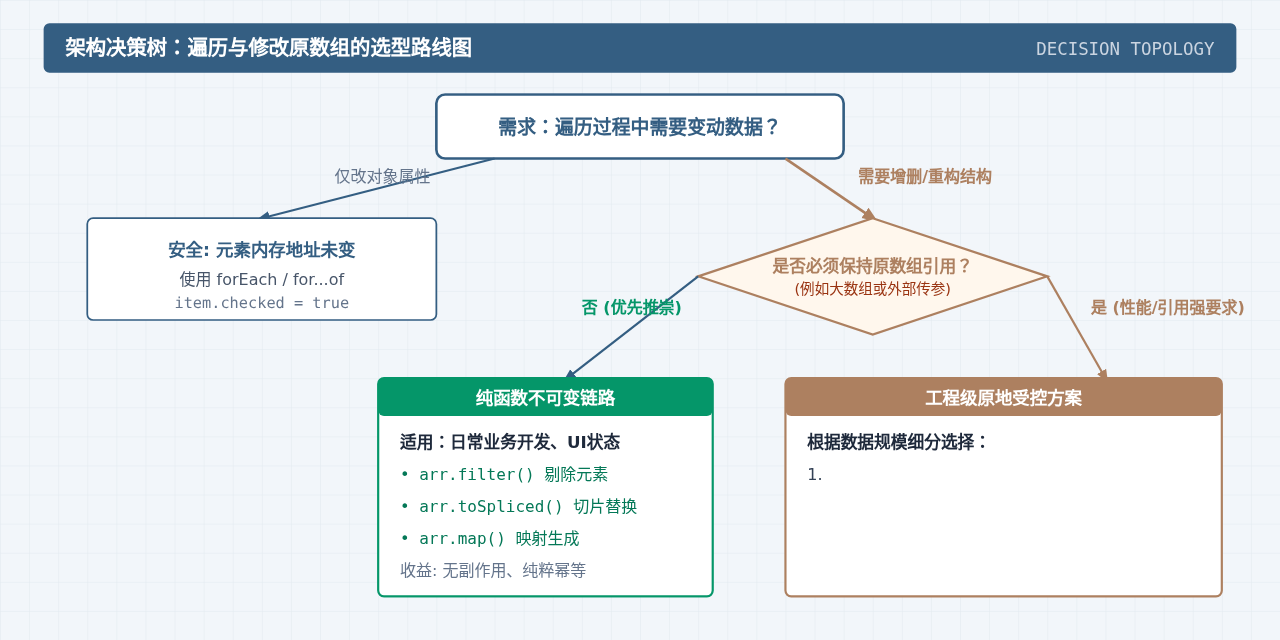
图 4:综合总结与最佳技术选型决策树
五、核心要点总结
在处理 JavaScript 数组循环与变异时,可遵循以下具体核查标准:
- 牢记内部游标的机械性:无论是正向
for还是forEach,遍历游标只会单调向前递增。正向删除元素必然使得后续项前移,从而被递增的游标跨过。 - 高阶方法中绝对禁止变异结构:切勿在
forEach、map或filter回调中使用splice()、shift()或pop(),此类方法内部的索引推进机制不可逆且外部无法干涉。 - 默认优先使用不可变方法:优先选用
filter()或 ES2023 引入的toSpliced()、with(),避免破坏函数的纯度(Purity)与单向数据流。 - 原地高性能清理选用双指针:对于海量数据且必须维系原引用的场景,弃用循环
splice,采用双指针读写覆写并在最后一步使用arr.length = writeIndex进行物理截断,将时间复杂度从 $O(n^2)$ 压降至 $O(n)$。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章