

深入讲解在现代前端开发中如何使用 JavaScript 强制刷新页面并有效绕过浏览器缓存。解析 location.reload(true) 失效的原因,提供动态时间戳、无痕替换以及离线缓存清理的可靠代码方案与工程实践。
JavaScript怎么强制刷新页面绕过浏览器缓存
作者:安全边界
时间:2026-11-06
浏览:640
文章目录
在现代前端开发中,若要通过 JavaScript 真正绕过浏览器缓存并刷新页面,最直接且可靠的客户端方案是通过修改 URL 查询参数(如注入动态时间戳)并调用
window.location.replace()。由于历史上的 location.reload(true) 已被现代浏览器和 W3C/WHATWG 规范彻底废弃,单纯调用重载函数已无法穿透本地强缓存。本文将详细解析失效原因、提供标准实用的重载代码,并说明全栈环境下的根治方案。
一、为什么传统的 location.reload(true) 失效了?
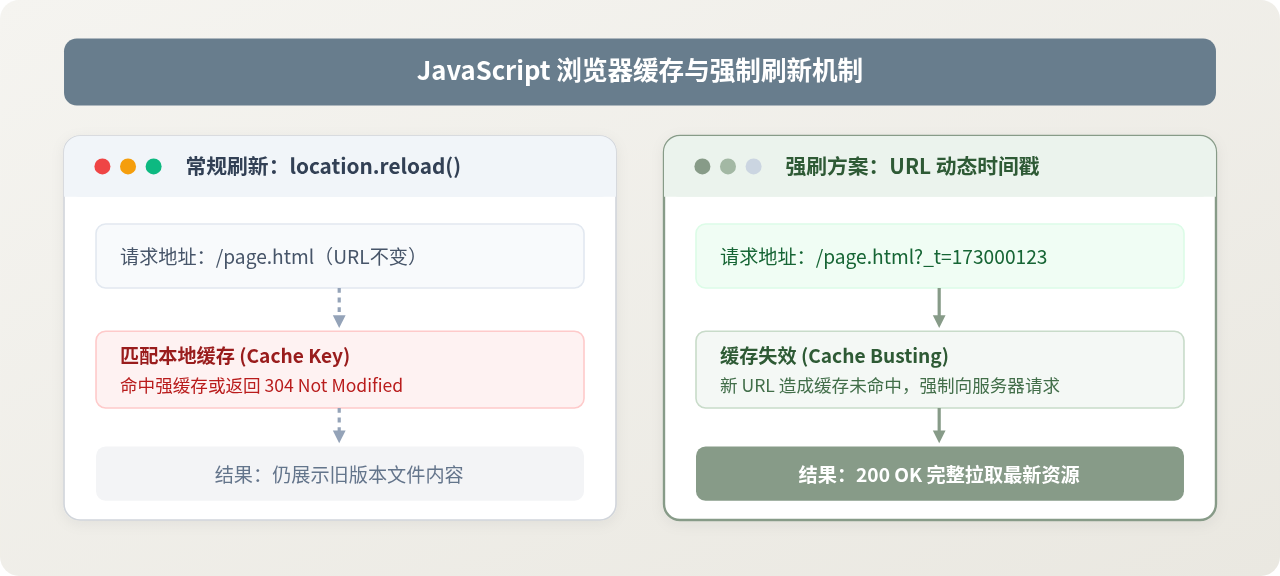
许多早期教程和遗留代码中经常出现 window.location.reload(true),寄希望于通过传入布尔值 true 来实现类似键盘 Ctrl + F5(或 Mac 上的 Cmd + Shift + R)的硬刷新。然而在现代浏览器中,这一调用已经彻底失去了绕过缓存的作用。
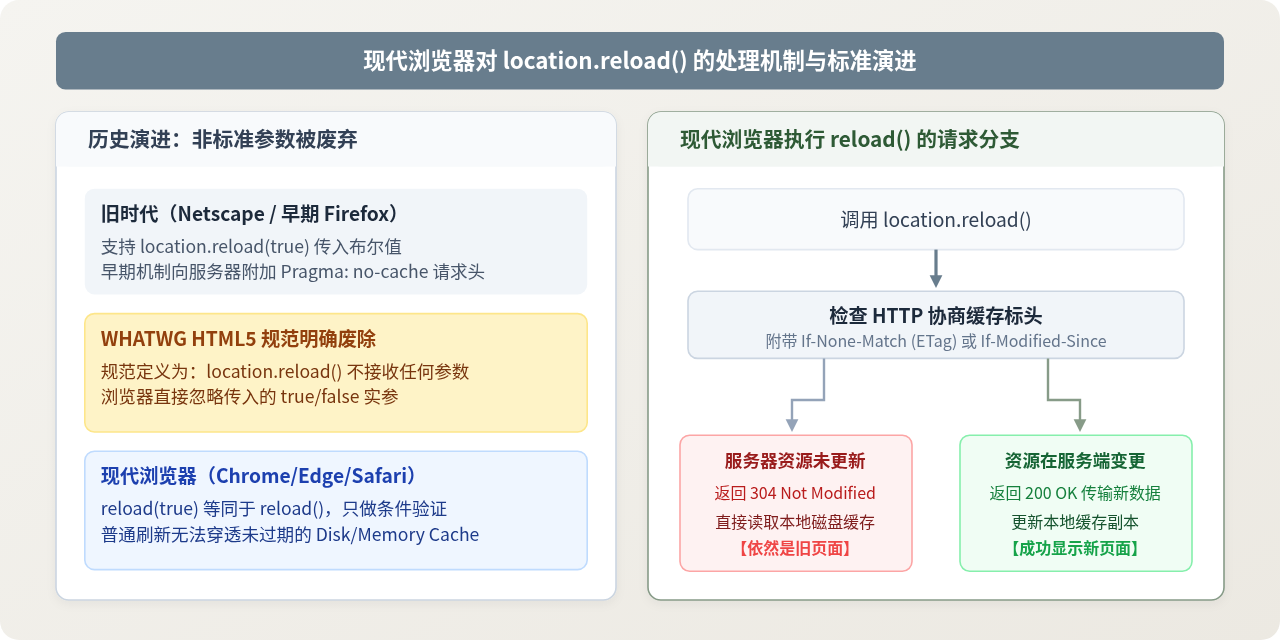
深入查看 WHATWG HTML 规范可以发现,Location.reload() 的方法定义本身并不接收任何参数。过去传入 true 只不过是早期网景(Netscape)和 Firefox 的专有扩展特性。现代浏览器(包括 Google Chrome、Microsoft Edge、Safari 以及新版 Firefox)为了遵循统一标准并优化资源性能,均已忽略该布尔参数。
注意:在现代浏览器中执行
location.reload(true) 与执行 location.reload() 完全等价。浏览器只会向服务器发送包含 If-Modified-Since 或 If-None-Match 的条件请求;如果页面命中了本地强缓存(如 Cache-Control: max-age 尚未到期),或者服务端返回了 304 Not Modified,页面将直接复用旧缓存。
二、可靠的客户端方案:URL 动态时间戳刷新法
浏览器对本地资源进行缓存与索引的核心依据是 Cache Key(通常由请求方法与完整的 URL 组成)。如果 URL 发生变化,浏览器会将其视为访问一个全新的资源,从而完全跳过先前的本地磁盘缓存与内存缓存,向源服务器发送无缓存的新请求。
基于这一原理,最稳健的纯 JavaScript 做法就是在当前页面 URL 上动态追加或更新一个毫秒级时间戳参数。
1. 完整实现代码
/**
 * 强制刷新当前页面并绕过浏览器缓存
 * @param {boolean} useReplace - 是否替换历史记录(默认为 true,推荐避免后退死循环)
 */
function forceReloadWithoutCache(useReplace = true) {
  // 1. 基于当前完整地址实例化 URL 对象
  const currentUrl = new URL(window.location.href);

  // 2. 注入唯一时间戳参数(若已存在 _t 则会自动更新)
  currentUrl.searchParams.set('_t', Date.now().toString());

  // 3. 执行页面重定向
  if (useReplace) {
    // 推荐:替换当前历史记录,用户点击浏览器“后退”不会卡在旧时间戳页面
    window.location.replace(currentUrl.toString());
  } else {
    window.location.href = currentUrl.toString();
  }
}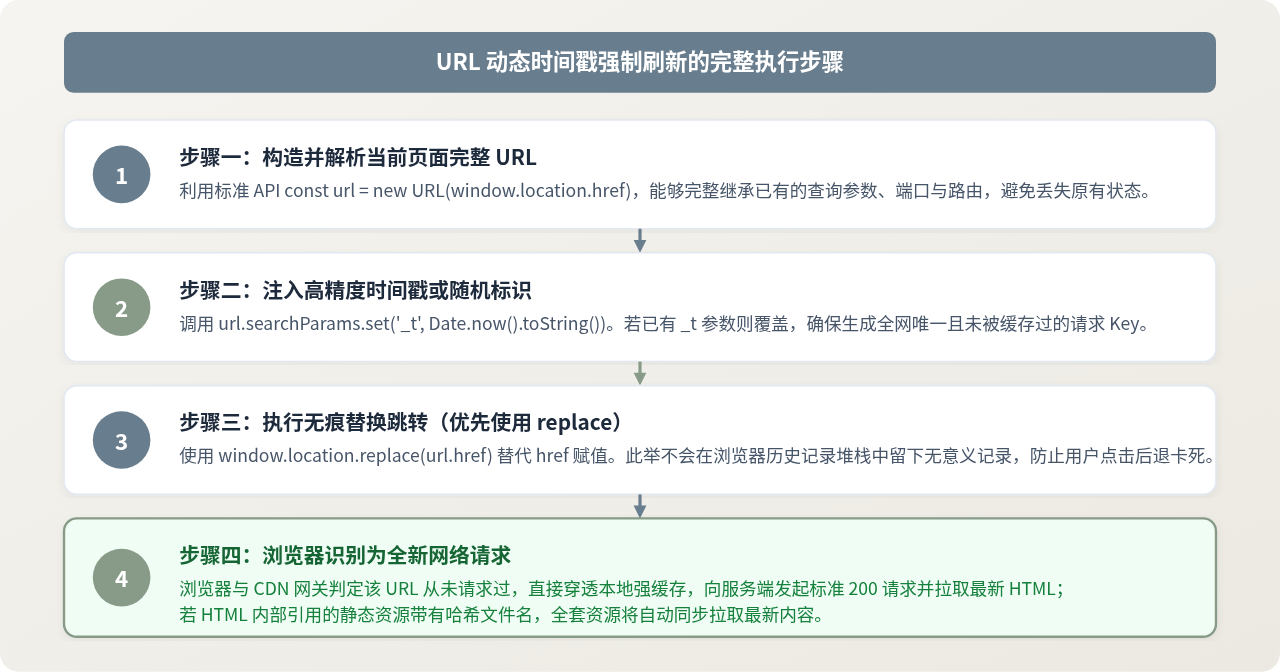
2. 为什么优先使用 location.replace() 而非 location.href?
在进行强制重载时,理解两者的差异至关重要:
-
使用
window.location.href = ...:会将带新时间戳的 URL 作为一条新记录推入浏览器的历史堆栈(History Stack)。如果用户在一个页面内多次触发强制刷新,历史记录中会堆积大量的无意义快照。当用户尝试点击浏览器“后退”按钮时,无法直接回到上一页,反而会在各个时间戳版本之间反复横跳。 -
使用
window.location.replace():直接替换当前活动的历史条目。刷新完成后,地址栏更新且历史堆栈长度不变,彻底避免了后退死循环问题,用户体验平滑自然。
三、单页应用(SPA)与静态资源的缓存陷阱
在以 Vue、React 或 Angular 为代表的单页应用中,强制刷新页面往往是为了解决“前端发版后用户仍停留在旧代码”的问题。此时需要清楚区分 HTML 页面本身的缓存 与 JavaScript / CSS 等打包产物的缓存:
- HTML 文档:是所有资源加载的入口。如果主 HTML 被浏览器强缓存,用户即便多次刷新也可能无法发现新打包的代码入口。使用上述的 URL 时间戳法可以确保拉取到最新的 HTML 文件。
-
静态资源(JS/CSS):现代构建工具(如 Vite、Webpack)在打包时默认会为文件名计算哈希指纹(如
app.4f9a12.js)。只要最新拉取的 HTML 中指向了新的哈希文件名,浏览器就会直接向服务器下载新资源,无需对 JS/CSS 单独追加时间戳。
关键差异分析:URL 时间戳方案 vs 普通条件刷新
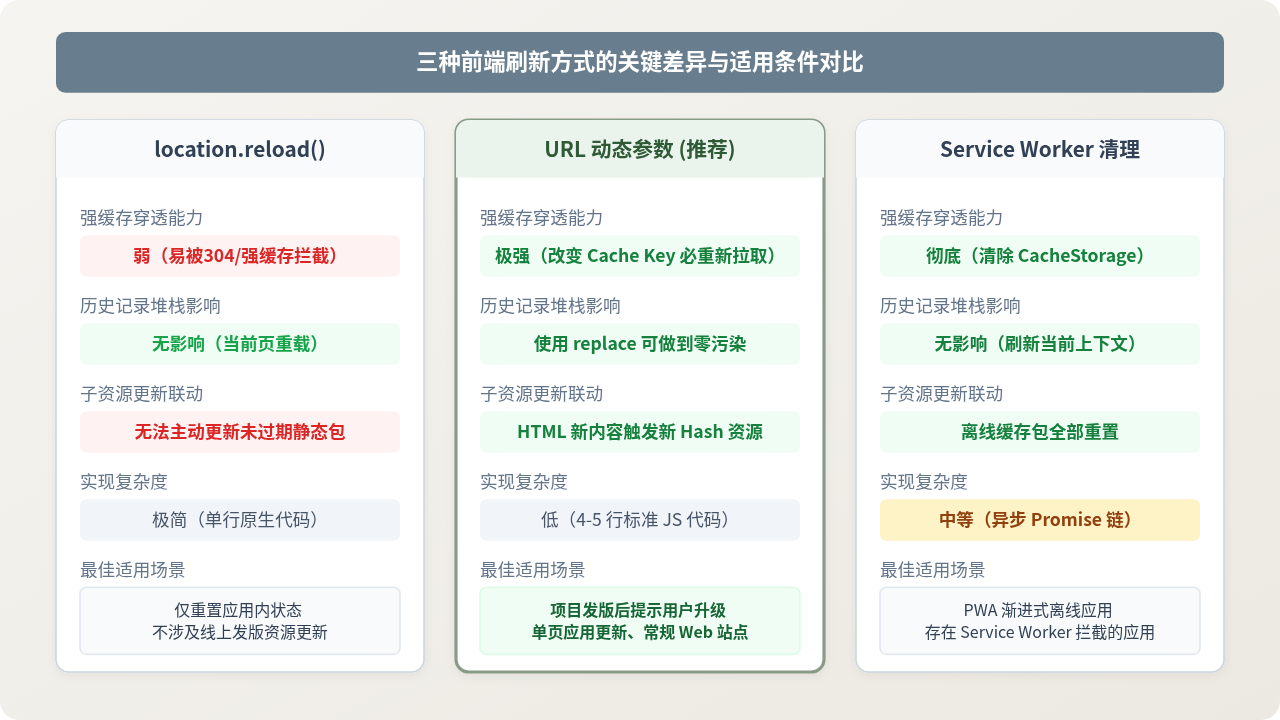
在相同网络环境与服务器配置下,两者的核心差异在于对强缓存边界的干预能力:
| 比较维度 | 普通重载 (location.reload) | URL 动态时间戳重定向 |
|---|---|---|
| Cache Key 判定 | URL 保持一致,命中相同本地缓存条目 | 参数改变产生全新 Cache Key,强制未命中 |
| 强缓存穿透力 | 受 max-age 与本地规则约束,易返回旧缓存 |
100% 触发全新请求,完全穿透强缓存 |
| 网络状态码 | 常返回 304 Not Modified 或 (disk cache) | 必须返回 200 OK 传输完整数据 |
| 实现限制 | 代码极短,但无法保证拿到最新内容 | 需要在 URL 中追加查询字段,极度可靠 |
四、进阶场景:Service Worker 与离线缓存清理
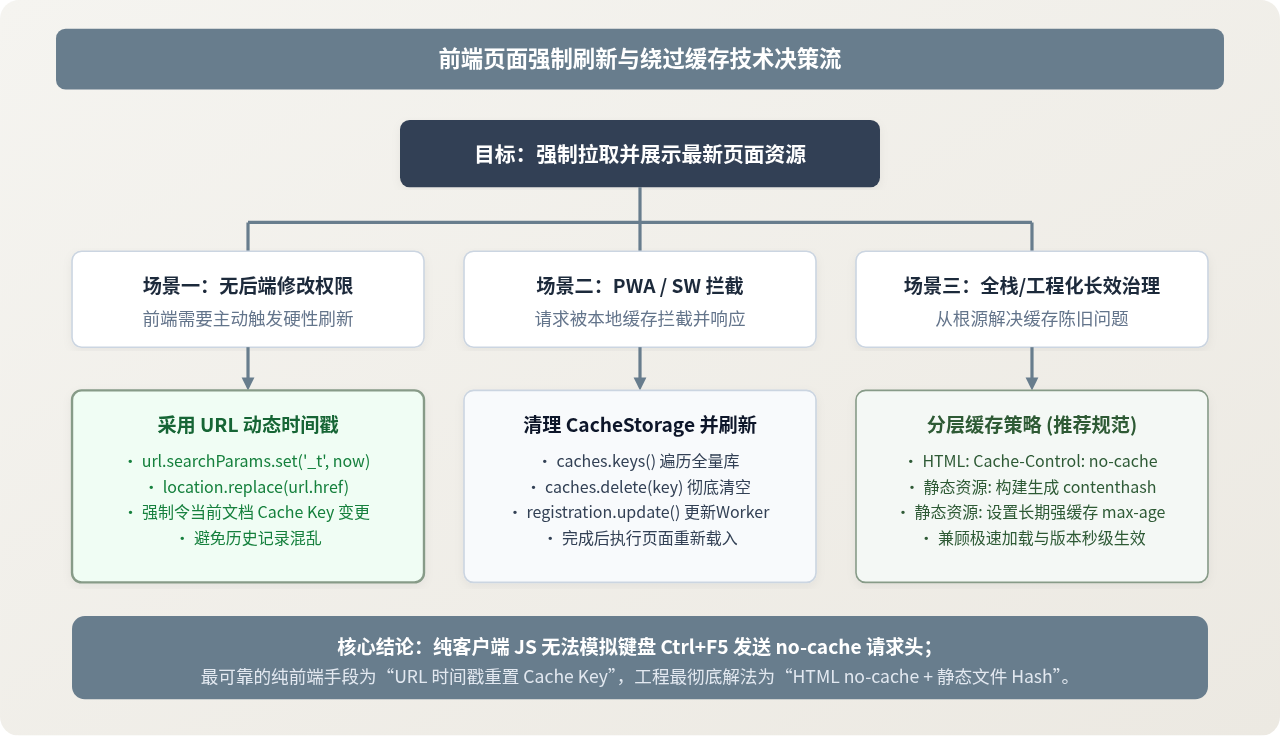
如果你的 Web 项目引入了 PWA(渐进式 Web 应用)或使用了 Service Worker 进行资源预缓存,普通的页面重定向甚至可能失效。因为 Service Worker 的 fetch 事件监听器可能会在请求到达浏览器网络层之前就直接将其拦截,并从 CacheStorage 中返回旧响应。
在此类场景下,强制刷新的 JavaScript 脚本必须先清空 caches 存储并触发 Service Worker 更新:
/**
 * 针对 PWA / Service Worker 应用的彻底强制刷新方案
 */
async function forceReloadPWA() {
  try {
    // 1. 如果存在 CacheStorage API,清理所有已存储的离线缓存
    if ('caches' in window) {
      const cacheNames = await caches.keys();
      await Promise.all(cacheNames.map(name => caches.delete(name)));
    }

    // 2. 检查并强制更新已注册的 Service Worker
    if ('serviceWorker' in navigator) {
      const registrations = await navigator.serviceWorker.getRegistrations();
      for (const registration of registrations) {
        await registration.update();
      }
    }
  } catch (err) {
    console.warn('清理离线缓存时发生异常:', err);
  } finally {
    // 3. 附带时间戳重载,彻底告别旧版本
    const url = new URL(window.location.href);
    url.searchParams.set('_t', Date.now().toString());
    window.location.replace(url.toString());
  }
}
五、长效治理:为什么需要配合 HTTP 标头?
必须认识到:JavaScript 无法在客户端直接向主页面的导航请求中插入自定义 HTTP 请求头(如 Cache-Control: no-cache)。键盘快捷键 Ctrl + F5 是由浏览器宿主直接发起的底层硬重载,而页面脚本运行在浏览器沙箱中,无法模拟这种行为。
因此,虽然 URL 时间戳可以在前端临时救急,但从根本上杜绝缓存问题的现代前端标准策略是服务端分层缓存架构:
-
HTML 入口文件:在 Nginx 或静态托管服务中,明确为 HTML 文件配置
Cache-Control: no-cache。这意味着浏览器每次加载网页时都必须与服务器核对是否有最新版本,避免直接使用过期的本地副本。 -
静态资源文件(JS、CSS、图片):打包时开启文件名 Hash(如
chunk-[hash].js),并在服务器端设置超长缓存时间(如Cache-Control: max-age=31536000, immutable)。不仅加载速度极快,而且每次上线发布只需更新 HTML 中的文件名引用即可实现秒级更新。
六、总结
面对“JavaScript 怎么强制刷新页面绕过浏览器缓存”这一问题,核心要点总结如下:
- 不要继续使用
location.reload(true),该传参已被标准废除且无实际穿透效果。 - 纯前端最有效的强制刷新方法是构造带有高精度时间戳(
Date.now())的全新 URL,并通过location.replace()执行无痕替换。 - 在使用了 PWA / Service Worker 的项目中,刷新前需显式调用
caches.delete()清空离线缓存仓库。 - 生产环境中最彻底的解决方案永远是架构规范:让 HTML 保持协商缓存(
no-cache),静态资源通过文件名哈希(ContentHash)实现长期强缓存。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章