
深入对比JavaScript中获取DOM元素的常用API,系统解析document.getElementById与querySelector在语法规则、调用作用域、执行机制、性能表现以及集合类型上的核心区别与工程选型建议。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS获取DOM元素的常用方法:getElementById与querySelector区别
作者:窗边听雨
时间:2026-11-06
浏览:426
文章目录
JavaScript 核心规范
DOM API 架构解析
执行机制与工程选型
在 JavaScript 中获取 DOM 元素主要依赖两类原生接口:一类是以 document.getElementById 为代表的经典 ID 索引方法,另一类是以 querySelector 和 querySelectorAll 为代表的现代 CSS 选择器引擎接口。它们的核心区别在于:getElementById 仅能通过 document 全局调用且仅接收纯 ID 字符串,底层直接检索哈希映射表(复杂度 \(O(1)\)),性能极高但灵活性单一;而 querySelector 既能在文档全局调用也能在任意 Element 上局部执行,支持复合 CSS 选择器语法,但每次调用需经过词法分析与 DOM 树自右向左匹配。本文将深入拆解这两套方法的语法规范、作用域限制、底层运作流程、集合类型差异及常见避坑实践。
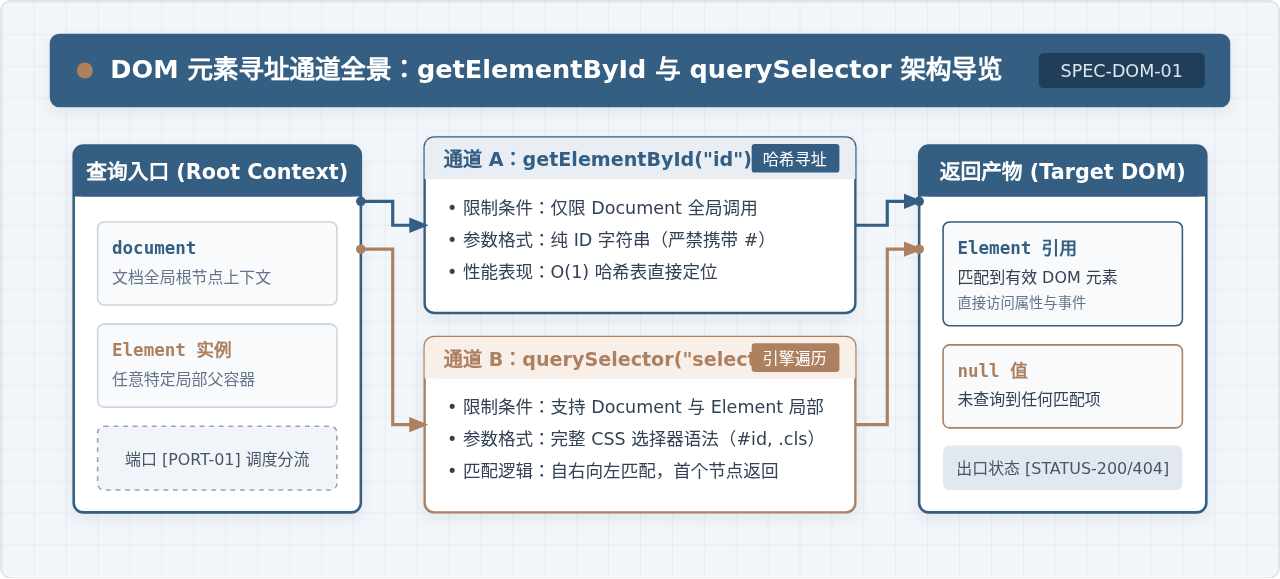
一、JS 获取 DOM 元素的常用方法技术谱系
文档对象模型(DOM)是浏览器将 HTML 结构映射为内存对象的树形接口。在 JavaScript 发展过程中,获取 DOM 节点的 API 经历了从“专用属性方法”到“通用选择器方法”的技术演进。掌握这些方法的分类与原型链挂载位置,是正确理解其行为差异的前提。
1. 常用原生获取方法分类
浏览器提供的 DOM 获取接口根据检索维度与返回数据形态,可以划分为以下两大阵营:
- 经典特定属性查询接口:
document.getElementById(id):依据元素的id属性检索唯一节点,返回单个Element对象或null。getElementsByClassName(names):依据class类名检索,返回动态的HTMLCollection集合。getElementsByTagName(name):依据标签名(如div、p)检索,返回动态的HTMLCollection集合。document.getElementsByName(name):依据表单元素的name属性检索,返回NodeList集合。
- 现代通用 CSS 选择器接口(Selectors API):
querySelector(selectors):接收标准 CSS 选择器字符串,返回匹配到的首个Element对象或null。querySelectorAll(selectors):接收标准 CSS 选择器字符串,返回包含全部匹配项的静态NodeList快照集合。
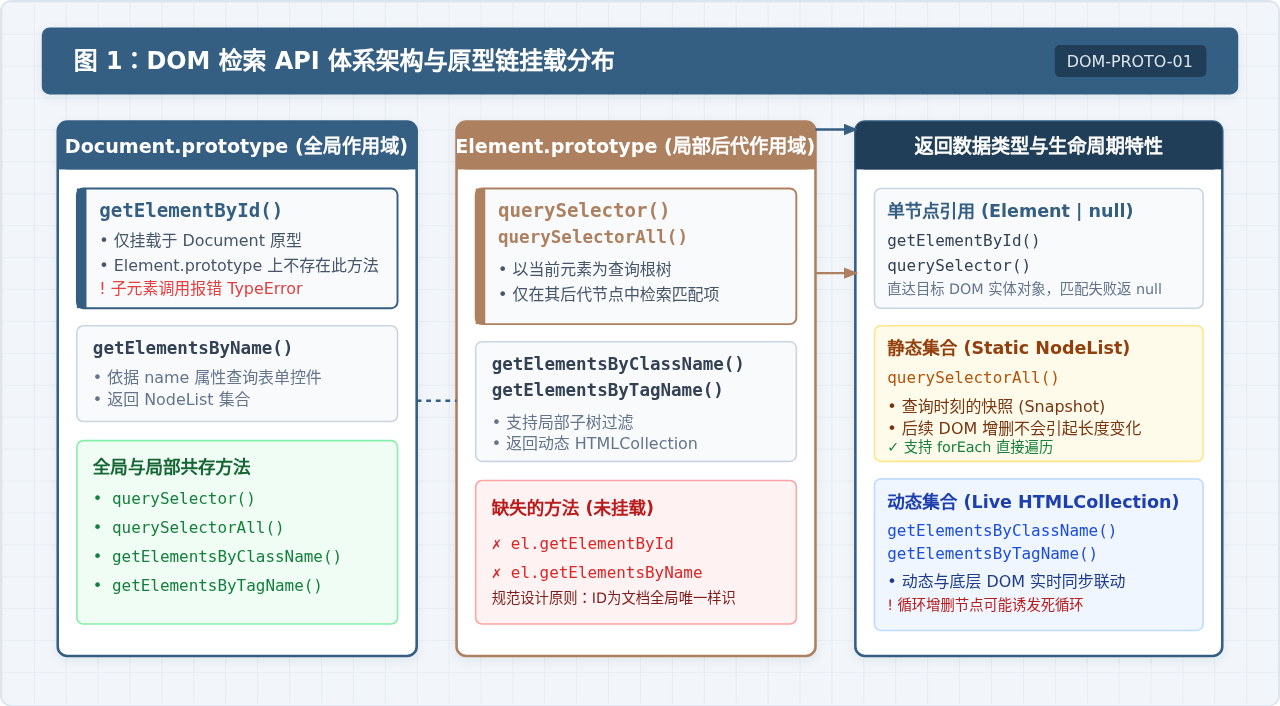
2. 原型链挂载层级带来的作用域差异
在 DOM 规范中,Document 与 Element 位于不同的原型链分支上。如图 1 所示,getElementById 的规范方法签名是 Document.prototype.getElementById,这意味着它是一个专属全局文档对象的方法,普通的 DOM 元素实例上并未挂载此方法。如果在某个特定的子节点(如 divElement.getElementById(...))上调用,JavaScript 引擎会直接抛出 TypeError: el.getElementById is not a function。
相对而言,querySelector 与 querySelectorAll 既被挂载在 Document.prototype 上,也被挂载在 Element.prototype 上。这赋予了选择器 API 强大的“局部上下文查询”能力,使开发者能够在特定容器节点内部进行限定范围的精准检索。
二、getElementById 的使用规范与底层机制
getElementById 是 DOM 规范中历史最悠久、实现最纯粹的查询方法。由于 HTML 规范要求 id 在整个文档中必须保持唯一,浏览器对其进行了极致的底层优化。
1. 语法规范与使用示例
调用 getElementById 时,必须满足以下调用约束:
- 必须且只能在全局
document对象上调用; - 传入参数为纯 ID 字符串,严禁携带 CSS 选择器中的
#前缀; - 若页面中存在多个重复的相同 ID,规范规定返回在文档流中出现的第一个匹配元素;
- 若未匹配到任何元素,返回
null。
// HTML 示例: <button id="submit-btn" class="btn primary">提交数据</button>

// 正确用法:传入纯 ID 字符串
const submitBtn = document.getElementById('submit-btn');

if (submitBtn !== null) {
  submitBtn.addEventListener('click', () => {
    console.log('按钮被点击,ID 节点获取成功');
  });
} else {
  console.warn('未能在文档中检索到目标元素');
}

// 典型错误 1:误加了 CSS 井号前缀(将导致返回 null)
const wrongEl = document.getElementById('#submit-btn');
console.log(wrongEl); // 输出: null

// 典型错误 2:在非 document 对象上调用
const container = document.querySelector('.card');
// container.getElementById('submit-btn'); // 抛出异常: TypeError: container.getElementById is not a function
2. 浏览器内部哈希映射表(Hash Table)机制
在浏览器内核(如 Chromium Blink 或 WebKit)解析 HTML 构建 DOM 树的过程中,除了建立父子兄弟节点的树形结构外,还会同步维护一张全局的 ElementOrderedMap 哈希索引表(ID 映射表)。该表以字符串形式的 id 为键,以对应 DOM 节点的内存 C++ 原生指针为值。
当执行 document.getElementById('submit-btn') 时,引擎直接对传入的字符串计算 Hash 值,并在哈希表中进行 \(O(1)\) 常数复杂度的单次寻址。不需要对 DOM 树进行深度优先或广度优先遍历,因而其执行耗时通常仅在数纳秒级别,是所有 DOM 获取操作中速度最快的路径。
三、querySelector 的使用规范与选择器引擎机制
W3C 引入 Selectors API(即 querySelector 和 querySelectorAll)的初衷,是为了让原生 JavaScript 具备与 CSS 规则乃至类 jQuery 库相同维度的灵活匹配能力。
1. 语法规范与复杂选择器表达
querySelector 接收任何合法的 CSS 选择器字符串。无论是类选择器、属性选择器、层级结构,还是伪类选择器,均可直接识别:
// 1. 类选择器获取
const activeTab = document.querySelector('.nav-item.active');

// 2. 属性选择器与复杂复合条件
const emailInput = document.querySelector('form#login-form input[type="email"][required]');

// 3. 伪类选择器获取(首个匹配项)
const firstRow = document.querySelector('table.data-table tbody tr:first-child');

// 4. 局部子树上下文检索(Element.prototype 调用)
const modal = document.querySelector('#confirm-modal');
if (modal) {
  // 仅在 modal 容器后代节点中检索确认按钮,避免全局冲突
  const confirmBtn = modal.querySelector('button.action-confirm');
  console.log('局部确认按钮:', confirmBtn);
}
2. CSS 选择器引擎匹配流程与 Early Exit 机制
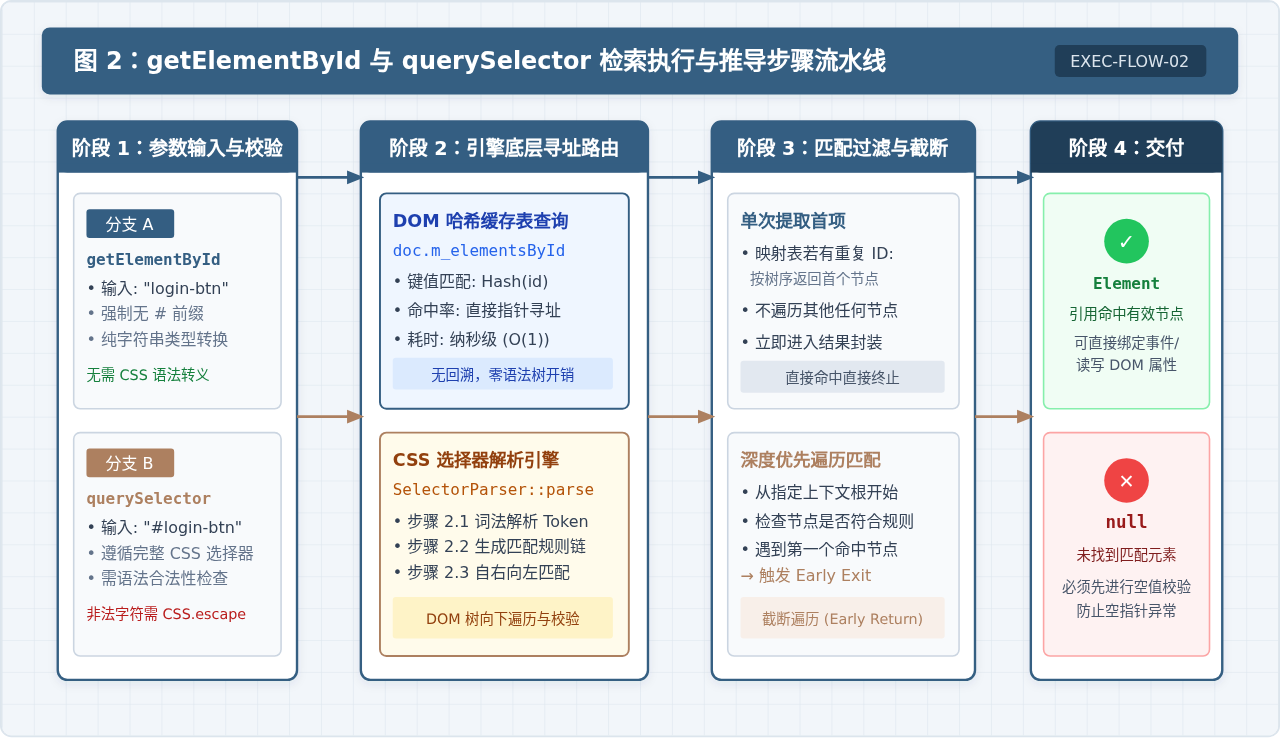
如图 2 所示,当调用 querySelector 时,浏览器必须经历完整的引擎处理流程:
- 词法与语法分析:将传入的选择器字符串拆解为 Token(例如标签名、ID、类名、属性组合),并构建匹配抽象语法树(AST);
- 语法合法性校验:如果选择器语法有误(如包含未转义的特殊字符),直接抛出
DOMException: '...' is not a valid selector错误; - 自右向左(Right-to-Left)遍历匹配:现代浏览器引擎从选择器的最右端(关键选择器 Key Selector)开始筛选候选节点,随后向左沿着 DOM 树父级链回溯验证祖先关系;
- 首项截断(Early Exit):
querySelector专为获取单元素设计,一旦在树序遍历中找到第一个满足全部规则的节点,引擎会立刻截断后续遍历流程,将该节点封装为 JavaScriptElement对象返回。
四、getElementById 与 querySelector 深度对比
为了在工程架构中制定明确的编码规范,我们需要从语法、调用作用域、性能机制、容错机制及集合类型五个维度进行横向对比。
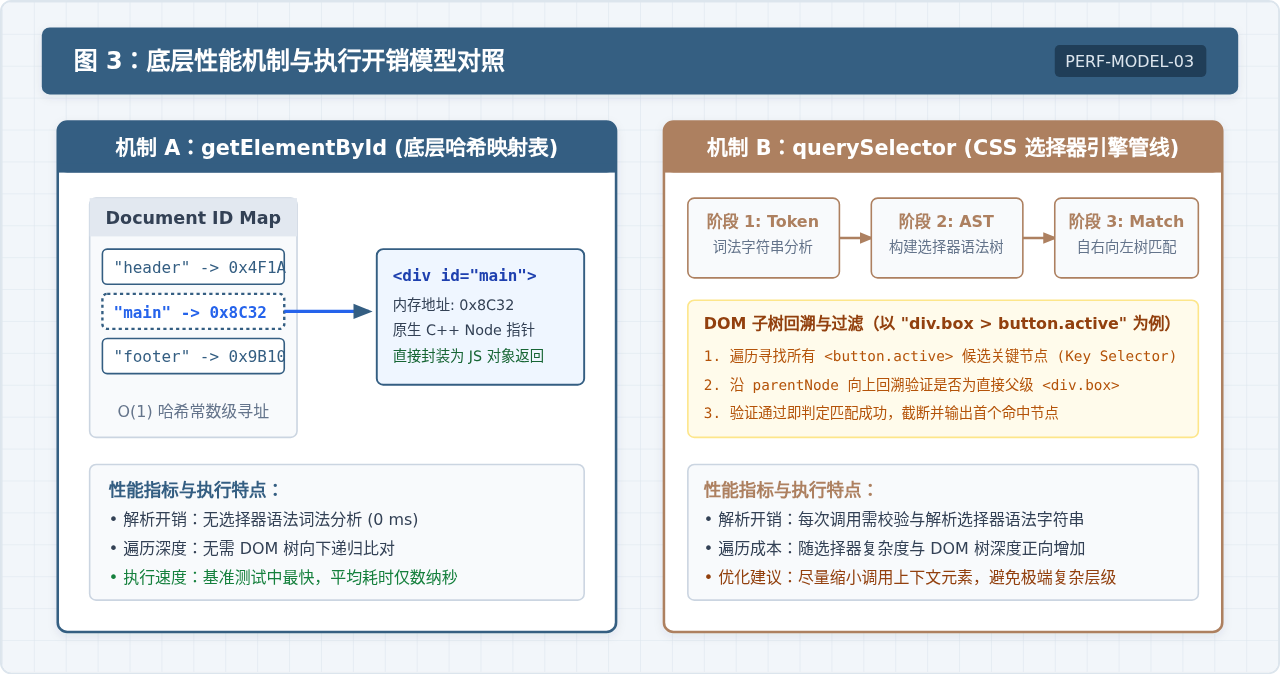
1. 核心维度技术比对
| 对比维度 | getElementById | querySelector |
|---|---|---|
| 调用作用域 | 仅限 Document.prototype(全局文档) |
支持 Document.prototype 与 Element.prototype(支持局部子树查找) |
| 参数规范 | 仅接收 ID 字符串,严禁携带 # 前缀 |
接收标准 CSS 选择器(ID 必须携带 #,支持复合语法) |
| 语法灵活性 | 单一,仅能根据 ID 单一维度检索 | 极高,支持标签、类、属性、伪类、兄弟选择器组合 |
| 底层算法复杂度 | \(O(1)\) 常数级哈希查找(无语法解析) | \(O(N)\) 受选择器复杂度与 DOM 树深度影响(需词法解析与树遍历) |
| 执行速度 | 极快(单次调用平均数纳秒) | 较快(纳秒至微秒级),略低于直接哈希寻址 |
| 特殊字符容错 | 原生支持字符串传参,无需任何转义 | 遇冒号、点号、数字开头等需使用 CSS.escape() 转义 |
| 批量查找对应 API | 无(因 ID 具有全局唯一性) | querySelectorAll(返回静态 NodeList 快照) |
2. 静态 NodeList 与动态 HTMLCollection 的机制差异
在探讨单元素获取时,理解其关联的批量方法同样关键:
querySelectorAll返回的是 静态 NodeList(Static NodeList)。它在执行时刻对匹配结果拍下一张“快照”。在代码后续对 DOM 树执行appendChild或remove操作时,已获取的 NodeList 集合的长度和节点内容不会发生任何改变。- 传统的
getElementsByClassName与getElementsByTagName返回的是 动态集合(Live HTMLCollection)。该集合与底层 DOM 树保持实时响应联动。如果在for循环中边遍历该集合边向 DOM 树插入匹配节点,很容易诱发因length动态递增而导致的死循环崩溃。
五、常见开发误区与避坑指南
在日常业务开发中,由于对两者规范细节理解不全面,极易产生隐蔽的 Bug。以下总结四个最普遍的坑点及防御性修复方案。
1. 误区一:参数前缀混淆导致返回 null
现象:使用
原因:
原则:
document.getElementById('#user-profile') 返回 null,即使页面确实存在该元素。原因:
getElementById 严格以传入的纯文本作为 key 查找,加了 # 会导致引擎寻找 id="#user-profile" 的元素,因而返回 null。原则:
getElementById 不加 #,querySelector 查 ID 必须加 #。
2. 误区二:子元素局部查找时调用不存在的 API
现象:执行
原因:
解决方案:若需在特定父容器内查找子节点,统一使用
cardElement.getElementById('action-btn') 抛出 Uncaught TypeError: cardElement.getElementById is not a function。原因:
getElementById 仅挂载于 Document.prototype,未在 Element.prototype 上定义。解决方案:若需在特定父容器内查找子节点,统一使用
cardElement.querySelector('#action-btn')。
3. 误区三:ID 中包含特殊字符未转义导致选择器语法报错
在某些服务端渲染框架(如 ASP.NET、JSF)或动态生成的节点中,ID 可能包含点号(.)、冒号(:)、斜杠或以纯数字开头(例如 id="user:item.12"):
// HTML 示例: <div id="module:detail.tab">内容模块</div>

// getElementById 原生支持任意有效字符串,直接传入即可正常获取
const el1 = document.getElementById('module:detail.tab'); // 正常获取节点

// querySelector 会将冒号解析为伪类、点号解析为类名,直接执行将抛出异常:
// document.querySelector('#module:detail.tab');
// 报错: Uncaught DOMException: Failed to execute 'querySelector' on 'Document': '#module:detail.tab' is not a valid selector.

// 正确方案:使用 CSS.escape() 进行防御性转义
const rawId = 'module:detail.tab';
const el2 = document.querySelector('#' + CSS.escape(rawId));
console.log('转义后安全获取:', el2);
4. 误区四:未做空值判断直接读取属性引发崩裂
两个方法在未匹配到节点时均返回 null。如果直接链式访问其属性(如 .value、.classList),将引发经典的 Cannot read properties of null 运行时崩溃:
// 危险做法:未校验直接操作
// document.querySelector('.non-existent-btn').addEventListener('click', handler); // 抛出 TypeError

// 现代安全规范 1:可选链式操作符 (Optional Chaining)
document.querySelector('.submit-btn')?.addEventListener('click', () => {
  console.log('安全执行');
});

// 现代安全规范 2:显式守卫分支
const panel = document.getElementById('control-panel');
if (panel) {
  panel.classList.add('visible');
}
六、工程实践选型建议与决策矩阵
在现代前端开发中,虽然单次调用的性能差异在多数普通页面中不足以造成肉眼可见的卡顿,但清晰的代码语义、作用域隔离和稳健性对于大型可维护工程至关重要。
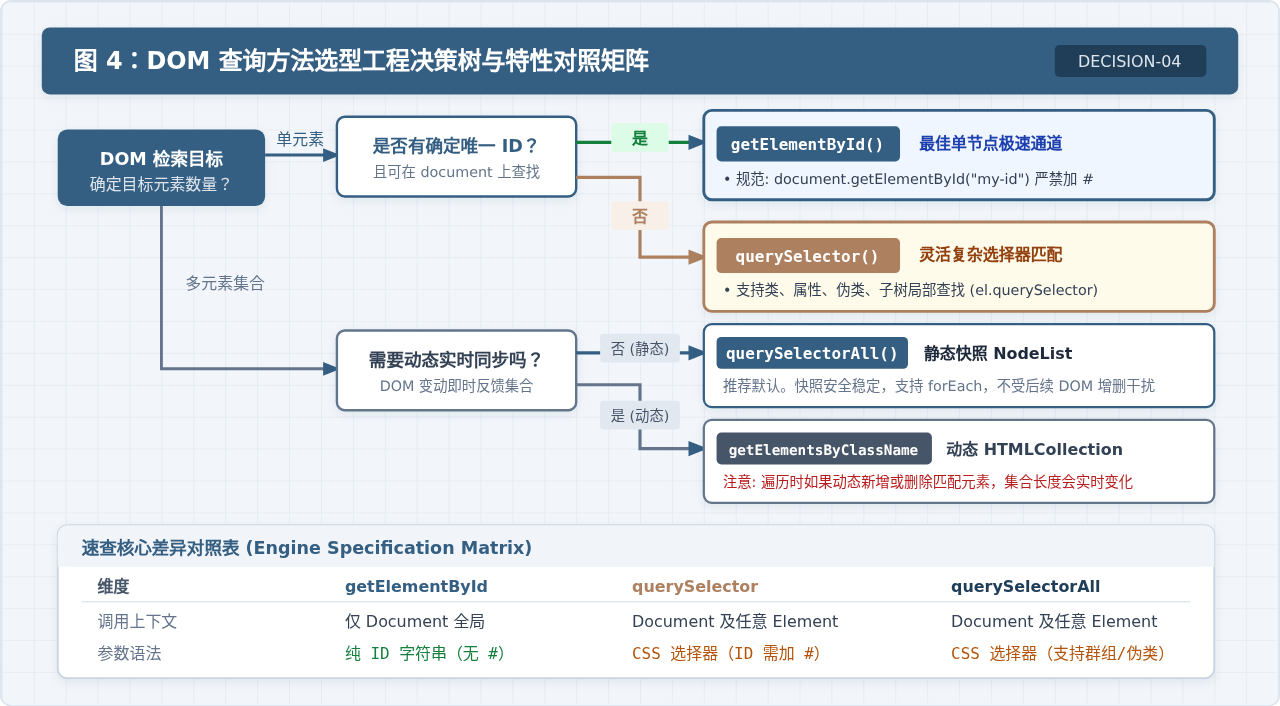
1. 选型决策准则
- 优先使用
getElementById的场景:- 目标节点拥有明确、唯一的语义化 ID(例如单页应用的主挂载点
#app、全局模态框容器#modal-root); - 在执行高频调用的性能关键路径中(如动画每一帧内的查询、海量虚拟列表中的主节点获取);
- 目标明确在
document全局范围,且 ID 包含特殊符号无需额外转义时。
- 目标节点拥有明确、唯一的语义化 ID(例如单页应用的主挂载点
- 优先使用
querySelector的场景:- 需要在局部组件或特定父容器内进行限定范围检索(
containerEl.querySelector(...)); - 查询条件涉及类名(
.class)、属性选择器([data-role="tab"])、复合关系(ul > li.active); - 需要获取非 ID 唯一样识的特定位置子节点(如
table tr:nth-child(2))。
- 需要在局部组件或特定父容器内进行限定范围检索(
- 优先使用
querySelectorAll的场景:- 需要获取多节点列表并直接使用
forEach遍历时; - 需要一个不受后续 DOM 插入/删除变动影响的静态节点快照时。
- 需要获取多节点列表并直接使用
2. 总结
getElementById 与 querySelector 并非互相替代的关系,而是互为补充的底层工具:getElementById 胜在直观、专一与极致的哈希寻址性能;querySelector 胜在通用、强大的 CSS 规则支持与组件化局部后代作用域。根据查询上下文与选择器维度做出恰当的选型,能够让代码在兼顾性能的同时保持极高的可读性与健壮性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章