
深入对比JavaScript中parseInt与Number转整数的底层机制差异、边界行为表现、潜在陷阱及各工程场景下的最佳选型实践。

当前位置:首页 > JavaScript 基础 > 正文
JS中parseInt与Number转整数的核心区别及适用场景
作者:百宝袋
时间:2026-11-05
浏览:154
文章目录
核心结论先行:在 JavaScript 中,
parseInt 与 Number 表面上都能将数据转换为数字,但底层的设计目标与处理机制有着根本差异:parseInt 是“字符流容错解析器(Parser)”,采用前缀扫描策略,遇到首个不属于指定进制的字符便终止扫描并返回已解析出的整数部分;Number 则是“严格类型强制转换器(Type Caster)”,遵循 ECMAScript 规范中的 ToNumber 抽象操作,对字符串进行全量语法校验,只要夹杂任意非法字符即直接返回 NaN,且针对空字符串、布尔值及 null 具备预设的类型映射值。在转整数任务中,提取带有单位或后缀的字符串(如 "16px")应选用 parseInt(str, 10);严格验证用户表单输入的纯数字应使用 Number() 配合整数判定;已有浮点数值截断取整应使用 Math.trunc()。
一、底层机制差异:字符流扫描 vs 严格规范转换
理解两者的本质差异,首先要从 ECMAScript 规范定义的设计定位入手。很多初学者容易将 parseInt 误当成纯粹的“类型转换函数”,而实际上它是一个文本解析工具。
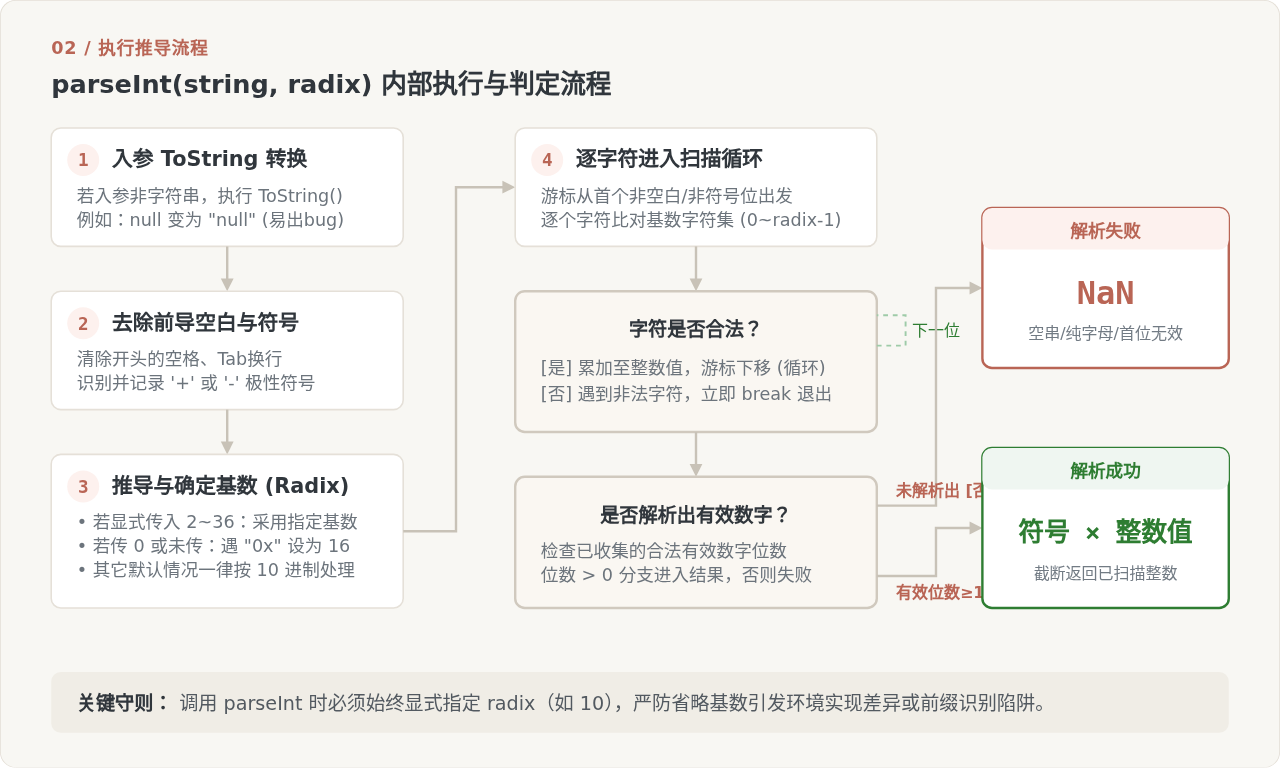
当执行 parseInt(string, radix) 时,引擎首先确保入参被当作字符序列处理。它会先通过内部的 ToString 将参数转换为字符串,剔除前导空白后,从左至右逐个读取字符。如果遇到符合指定基数(默认依据前缀或十进制)的字符就累加数值,一旦遇到第一个不合法的字符(如字母、点号、特殊符号),扫描器便会立即停止,并直接返回之前已经累加完成的有效整数。如果开头的第一个非空白字符就无法解析为有效数字,则返回 NaN。
相对地,Number(value) 是严格按照规范中 ToNumber 规则执行的强制转换。如果是字符串,该字符串必须从头到尾完整匹配数值字面量语法(允许前后空格、科学计数法指数及特定进制前缀如 0x、0b、0o)。只要字符串中间夹杂了任何无法识别的非数值字符,Number() 就视为语法错误,直接给出 NaN。
// 1. 面对末尾带有杂质字符的字符串
const rawSize = "42px";
console.log(parseInt(rawSize, 10)); // 输出: 42 (前缀容错匹配,遇到 'p' 停止)
console.log(Number(rawSize));         // 输出: NaN (无法通过全量数值校验)

// 2. 面对浮点数字符串
const rawFloat = "18.85";
console.log(parseInt(rawFloat, 10)); // 输出: 18 (遇到小数点 '.' 视为非法字符,截断退出)
console.log(Number(rawFloat));        // 输出: 18.85 (合法浮点字面量,保留小数位)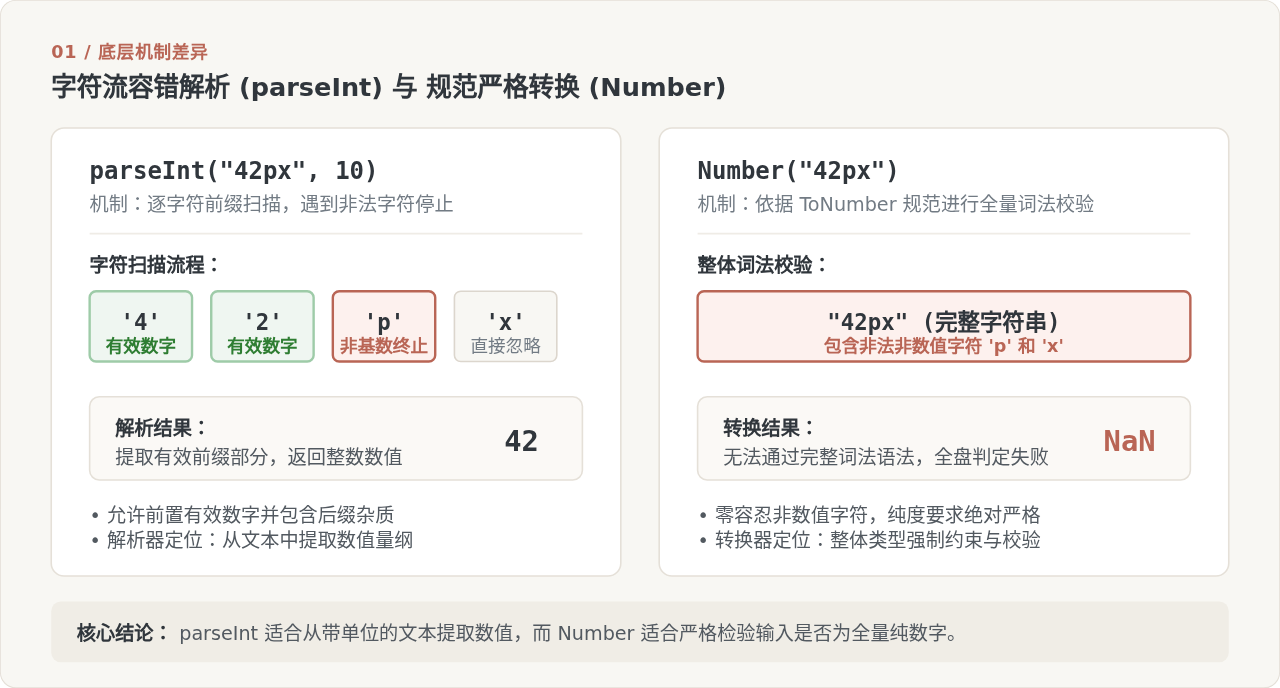
二、深入 parseInt 的执行流程与基数 (Radix) 规则
在使用 parseInt 转整数时,开发者必须面对其第二个参数:基数 radix。基数是 2 到 36 之间的整数,表示解析时所采用的进制体系。
为什么业界开发规范一律强制要求“调用 parseInt 时必须显式传入第二个参数 radix”?原因在于其默认基数推导规则中存在的历史遗留细节:
- 如果省略
radix或传入0,引擎会根据字符串前缀进行猜测: - 以
"0x"或"0X"开头的字符串,自动按 16 进制 解析; - 在 ES3 时代,以
"0"开头的字符串常被推断为 8 进制(例如parseInt("08")在老旧引擎中会因为8不是合法八进制数字而返回0)。虽然现代 ES5+ 规范已经修正并明确规定前导0默认按十进制处理,但为了防御不同运行环境的不一致性,省略radix依然是高危行为。
经典面试题拆解
为什么 ['1', '2', '3'].map(parseInt) 输出 [1, NaN, NaN]?
在 JavaScript 中,Array.prototype.map 在回调时会传入三个参数:(item, index, array)。
当直接传入 parseInt 时,实际执行的是:
// 迭代过程等价于:
parseInt('1', 0); // radix 为 0,依据默认规则按 10 进制处理 -> 返回 1
parseInt('2', 1); // radix 为 1,基数必须在 2~36 范围内,非法基数 -> 返回 NaN
parseInt('3', 2); // radix 为 2(二进制),字符 '3' 在二进制中非法 -> 返回 NaN
正确做法是显式包裹一层单参数函数:list.map(item => parseInt(item, 10)) 或 list.map(Number)。
三、关键边界行为与隐蔽陷阱对照
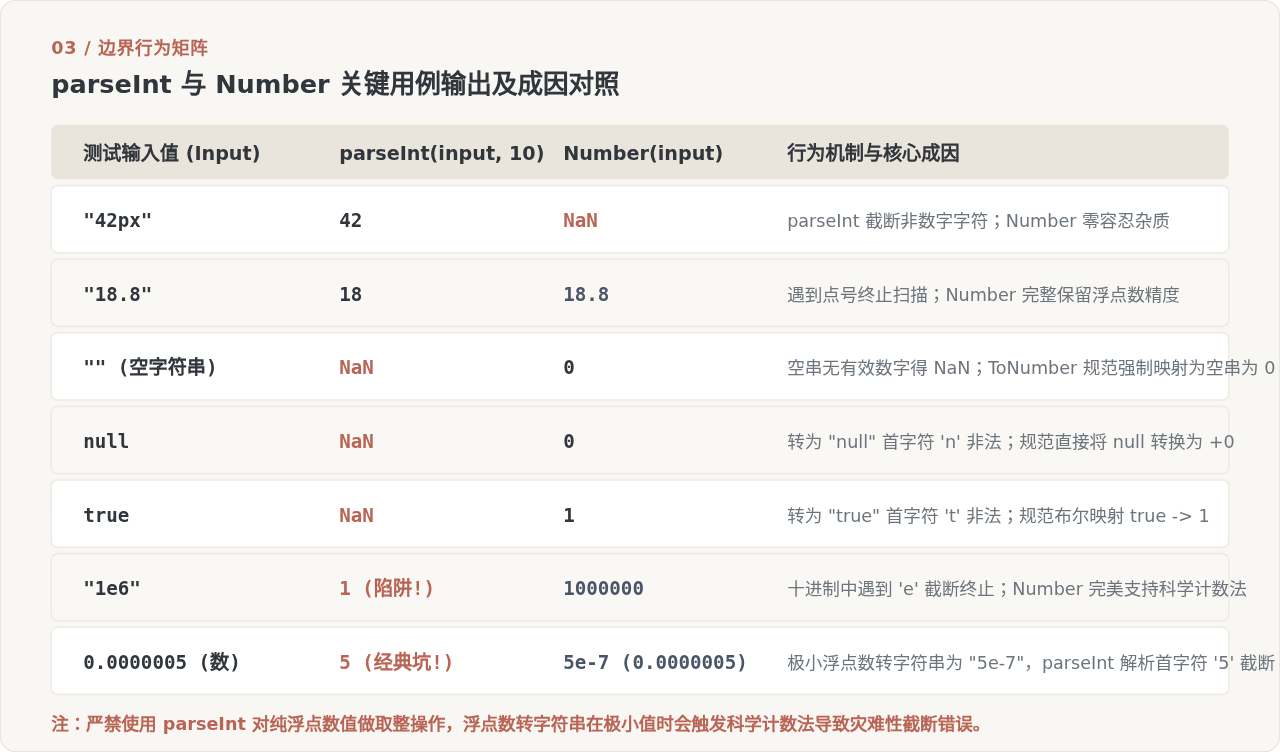
除了常规的字符串转数值,parseInt 与 Number 在面对空值、布尔值、科学计数法以及大/小数时的表现大相径庭。在实际生产排错中,这些边界情况是引发 Bug 的重灾区。
| 输入值 (input) | parseInt(input, 10) | Number(input) | 核心差异机制与注意事项 |
|---|---|---|---|
"" (空字符串) |
NaN |
0 |
parseInt 找不到任何有效数字字符返回 NaN;而 ToNumber("") 规范直接定义映射为 0。 |
null |
NaN |
0 |
parseInt(null) 经历 ToString(null) 变为 "null",首字母 'n' 非数字返回 NaN;Number(null) 规范定义转为 +0。 |
undefined |
NaN |
NaN |
两者皆为 NaN,但路径不同:前者转 "undefined" 遇到 'u' 失败,后者规范定义 ToNumber(undefined) 为 NaN。 |
true / false |
NaN |
1 / 0 |
parseInt 转为字符串 "true"/"false" 导致首字母解析失败;Number 严格执行布尔数值映射。 |
"1e6" (科学计数法) |
1 陷阱 |
1000000 |
parseInt 按十进制扫描,遇到字母 'e' 判定为非法字符提前截断退出,造成严重数值失真!Number 则完全支持科学计数法。 |
0.0000005 (极小数值) |
5 大坑 |
0.0000005 |
JavaScript 引擎对极小数字调用 ToString 会转为 "5e-7",parseInt 截取首位 5 并停在 'e',导致荒谬的输出结果。 |
高危避坑提醒
绝对不要用 parseInt 来做浮点数向零取整!
很多开发者喜欢用 parseInt(floatNumber, 10) 代替取整函数,例如 parseInt(42.3, 10) === 42。然而,当处理极小浮点数时:
const num = 0.0000005;
console.log(String(num));              // "5e-7" (引擎内部自动序列化为科学计数法)
console.log(parseInt(num, 10));       // 5 !!(灾难性逻辑错误)
console.log(Math.trunc(num));           // 0 (符合数学事实的正确取整)
结论:对于本来就是数字类型的浮点数,向零截断取整必须使用 Math.trunc(),向下取整使用 Math.floor(),严禁借道字符串解析器 parseInt。
四、转整数的最佳实践与选型指南
在实际项目架构与业务编码中,针对不同的输入类型与业务期望,应当建立明确的函数选型策略:
1. 场景一:从带有量纲单位的文本提取整数数值
典型案例包括解析 CSS 属性字符串(如 "24px"、"100vh"、"12rem")或带描述的业务文本。由于需要自动忽略末尾非数字字符,必须使用 parseInt,并显式指定十进制基数:
function parsePixelSize(cssValue) {
  if (typeof cssValue !== 'string') return 0;
  const val = parseInt(cssValue, 10);
  return Number.isNaN(val) ? 0 : val;
}

parsePixelSize("24px");  // 24
parsePixelSize("auto");  // 0
2. 场景二:用户表单、URL 查询参数的纯整数严格转换
在处理用户输入或接口参数时,容错截断往往会掩盖前端传参或用户手滑输入的错误(例如用户将数量输入为 "12a",若使用 parseInt 会静默转为 12,导致账单或库存出现非预期业务逻辑)。此时必须用 Number() 配合校验逻辑:
function parseStrictInteger(input) {
  // 过滤空串与前后空白(防止 Number("") 误转为 0)
  if (typeof input === 'string' && input.trim() === "") {
    return null;
  }
  const num = Number(input);
  // 校验:必须是数字、非 NaN、且属于整数
  if (!Number.isFinite(num) || !Number.isInteger(num)) {
    return null; // 判定为非法整数输入
  }
  return num;
}

parseStrictInteger("100");   // 100
parseStrictInteger("100px"); // null (拦截非法脏数据)
parseStrictInteger("100.5"); // null (拦截非整数浮点)
parseStrictInteger("");      // null (避免空串转 0 的隐式陷阱)
3. 场景三:多进制字符串转换
在需要解析二进制(如权限位掩码 "1010")或十六进制(如色彩十六进制 "FFA0")时,使用 parseInt(str, radix):
const binaryPermission = "1011";
const mask = parseInt(binaryPermission, 2); // 11

const hexColorPart = "FF";
const rgbVal = parseInt(hexColorPart, 16);   // 255
4. 场景四:数值型浮点数的取整操作
面对已知为数字类型的浮点数(例如计算布局坐标、动画插值),直接使用 Math.trunc()、Math.floor() 或 Math.round(),绝不可依赖 parseInt:
const position = 154.76;
const truncated = Math.trunc(position); // 154 (高效且无 ToString 风险)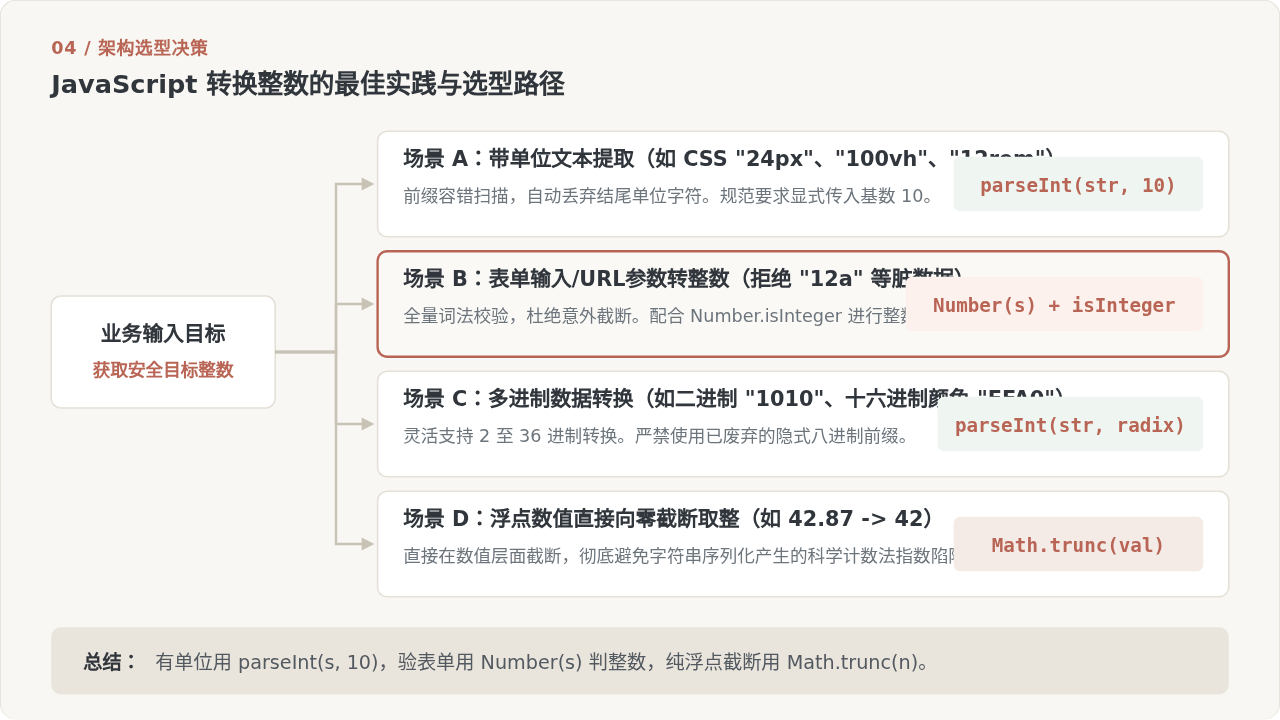
五、总结速查表
为了在日常开发中快速准确地进行选型,可以参考以下核心对照准则:
- 看输入是否有合法后缀:带 CSS 单位(
px、rem)用parseInt(s, 10);纯数值文本用Number(s)。 - 看对脏数据的态度:容错提取用
parseInt;严格校验输入纯度用Number并结合Number.isInteger。 - 看基数是否多变:非十进制解析(2~36 进制)用
parseInt(s, radix)。 - 看初始数据类型:纯数值浮点数截断取整永远优先使用
Math.trunc(),彻底远离parseInt的隐式字符串化风险。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章