
深入解析JavaScript递归函数的执行机制与调用栈模型,详述基准条件与收敛设计技巧,对比普通递归与尾递归的累加器转换,剖析ES6尾调用优化原理与现代引擎支持现状,并提供蹦床函数及显式堆栈等生产级防爆栈解决方案。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JavaScript递归函数编写技巧与尾调用优化
作者:异步漫步
时间:2026-11-04
浏览:604
文章目录
标签:JavaScript / 运行时原理 / 算法优化
阅读时长:约 10 分钟
代码规范:ES2015+ / 严格模式
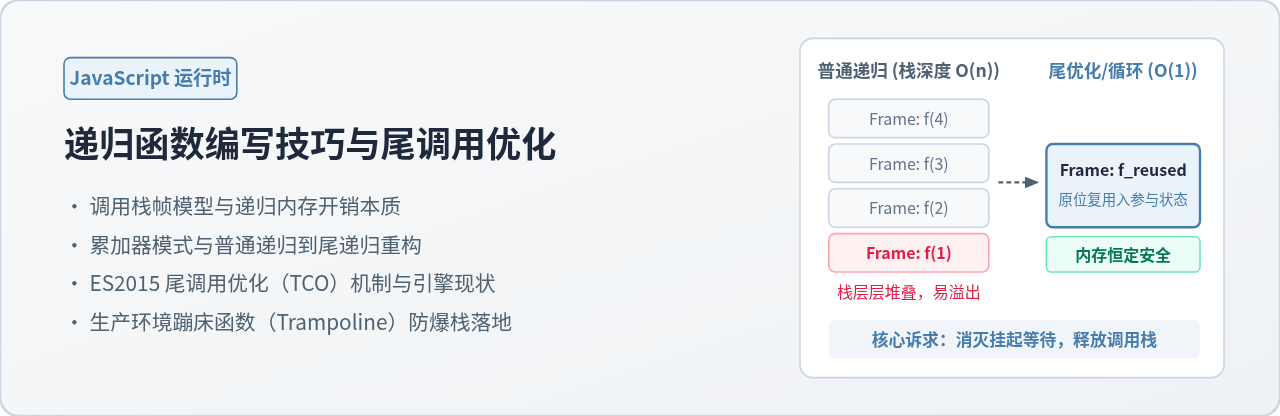
在 JavaScript 开发中,递归是解决树形遍历、嵌套数据扁平化以及分治算法最直接的表达方式。然而,因为 JavaScript 引擎分配给调用栈(Call Stack)的深度有限(通常在 10,000 层左右),递归深度过大极易触发
RangeError: Maximum call stack size exceeded 异常。要编写高健壮性的递归程序,核心在于两点:一是设计严密收敛的基准条件与状态传递机制,二是理解尾调用优化(TCO)的运行原理及其在现代各浏览器与 Node.js 运行环境中的真实表现,并掌握在缺少原生支持时采用“蹦床函数”或“显式堆栈模拟”进行防爆栈落地的实用技巧。
一、递归的核心运作模型与调用栈内存开销
递归的本质是“自己调用自己”。在底层执行层面,每一次 JavaScript 函数调用都会在调用栈中分配一块被称为“执行栈帧”(Execution Stack Frame)的内存区域。栈帧中存储着当前调用的函数入参、局部变量、当前执行指令的位置指针以及该层执行结束后的返回地址。
一个合法的递归函数由两部分构成:
- 基准条件(Base Case):决定递归何时终止并开始返回,防止无休止地继续下潜。
- 递归步进(Recursive Step):缩小问题规模,逐步向基准条件靠拢。
以经典阶乘计算为例,当执行 factorial(4) 时,其代码通常编写为:
function factorial(n) {
  if (n <= 1) return 1; // 基准条件
  return n * factorial(n - 1); // 递归步进:挂起了乘法运算
}
请注意关键细节:表达式 return n * factorial(n - 1) 并不是直接返回子函数的结果,而是必须先等待 factorial(n - 1) 返回具体数字后,再将其与外层的 n 执行相乘操作。这种被称为未决计算(Deferred Operation)的挂起机制,导致外层的每一个栈帧都必须完整驻留在内存中无法销毁。
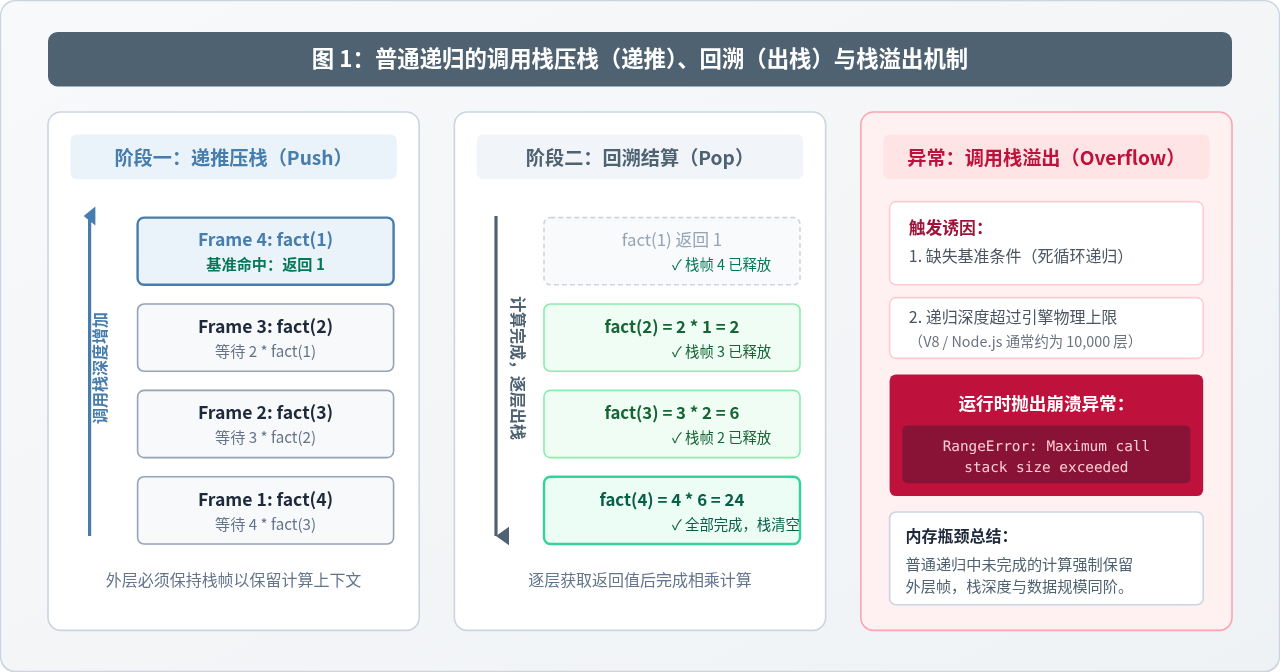
如图 1 所示,递归的执行可以严格划分为两个阶段:
- 递推压栈阶段:从
fact(4)逐级调用至fact(1),栈帧逐层叠加,内存开销达到峰值 O(n); - 回溯出栈阶段:
fact(1)返回1后,各层恢复执行挂起的乘法运算,并依次释放栈帧,最终返回24。
调用栈溢出排查注意:如果业务数据深度不可控(例如无限嵌套的深层评论树),或者递归的收敛步长出现死循环(例如浮点数递减无法精确等于整数基准),调用栈将迅速被塞满,V8 引擎会直接抛出不可捕获式的致命异常
RangeError: Maximum call stack size exceeded。
二、高质量递归函数的四大编写技巧
在实际项目中编写递归时,遵守防御性设计准则能避免绝大多数由于逻辑疏漏引发的线上故障。以下是经过实战验证的编写技巧:
1. 基准条件置顶且执行强类型/边界校验(Base Case First)
永远将基准条件的判断放在函数体的最开头(前 1~3 行),且不仅要判断理想终止值,还必须覆盖所有非法越界值。例如处理数值递减时,使用 if (n <= 1) 而非脆弱的 if (n === 1),避免因传入 0、负数或非法输入导致跳过终止判断。
2. 防范对象环状引用与无限嵌套
处理复杂深拷贝或树形节点扫描时,对象之间可能存在循环引用(例如 node.parent.children)。如果不加处理,递归将陷入无限环路。此时应当借助 WeakSet 记录已经访问过的对象引用:
function traverseTreeSafely(node, visited = new WeakSet()) {
  if (!node || visited.has(node)) return;
  visited.add(node);

  // 访问当前节点
  console.log(node.id);

  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      traverseTreeSafely(child, visited);
    }
  }
}
3. 避免单次调用中的额外闭包与大对象分配
在每一层递归函数内部创建临时闭包、复杂正则表达式实例或大体积对象,会成倍放大堆内存占用,并在短时间内制造大量短期对象,触发 V8 频繁进行新生代垃圾回收(GC),造成界面掉帧。优先将工具函数或常量对象提取至外层作用域复用。
4. 状态下传与纯函数设计
尽量避免在递归过程中依赖或修改外部模块的作用域全局变量。将变化中的状态全部通过参数自上而下传递,确保递归调用具备幂等性与良好的可测试性。
三、从普通递归到尾递归:累加器模式(Accumulator)
要解决普通递归中调用栈层层挂起未决计算的问题,核心手段是将其重构为尾递归(Tail Recursion)。
所谓尾调用,是指某个函数的最后一步动作是直接调用另一个函数并将其结果直接返回。当最后一步调用的正是当前函数自身时,即为尾递归。重构的关键在于“累加器模式”:将原本在回溯阶段才执行的运算,提前到当前步执行,并将结算结果作为参数传递给下一层。
// 重构为尾递归形式的阶乘计算
function factorialTail(n, acc = 1) {
  if (n <= 1) return acc;
  // 关键区别:return 的是一个纯粹的函数调用,外层没有任何运算挂起
  return factorialTail(n - 1, n * acc);
}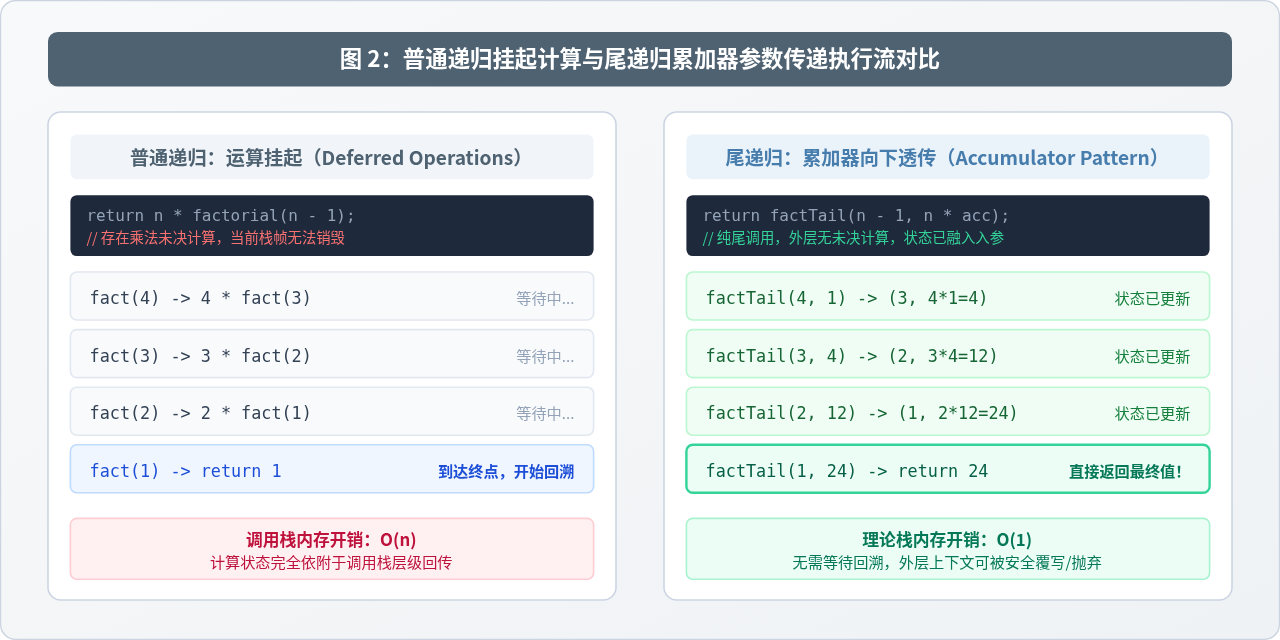
对比图 2 中两种模式的演进差异:
- 普通递归:
fact(4)必须等待fact(3)的返回值才能与 4 相乘;每一层的上下文信息都不可丢弃。 - 尾递归:每一层进入下一层时,累计的运算结果(
n * acc)已经实时算出并写入参数。当到达n === 1时,累加器acc已经就是最终答案24,不需要任何回溯乘法!因此,外层调用栈帧所保存的局部变量理论上已经失去了任何利用价值。
四、ES2015 尾调用优化(TCO)的规范原理与现代引擎现状
ECMAScript 2015 (ES6) 规范中正式引入了尾调用优化(Tail Call Optimization, TCO)。规范明确指出:如果一个函数调用处于尾位置,并且满足特定约束,引擎应当在调用发生时复用当前的执行栈帧(Frame Reuse),而不是在调用栈顶推入新的栈帧。
1. ES6 规范中触发 TCO 的三个硬性条件
- 必须运行在严格模式下(
"use strict"):在非严格模式下,函数实例拥有func.arguments和func.caller属性,引擎必须保留完整的历史调用栈才能提供这两个属性,因而无法复用栈帧。 - 必须位于真正的尾位置(Tail Position):递归调用必须是整个函数返回前执行的最后一条指令。
非尾调用反面典型:
•return fn() + 1;(调用后还需执行加法)
•const res = fn(); return res;(虽然语义类似,但需编译器精确识别)
•fn(); return;(未返回子函数的执行结果)
• 处于try...catch或try...finally块中的调用(必须等待异常处理上下文,不能销毁当前栈) - 尾调用的返回值必须被直接返回:三元运算符中合法的尾调用形式为:
return condition ? fnA() : fnB();。
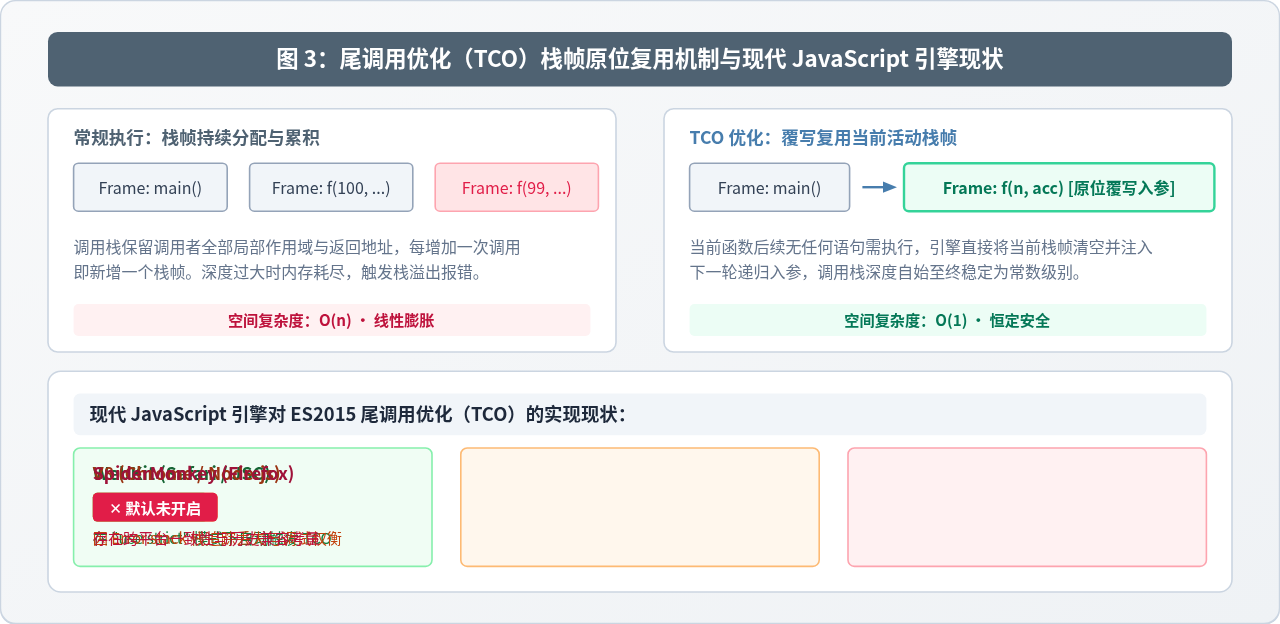
2. 现代 JavaScript 引擎的真实考量与现状
尽管 ES6 规范颁布多年,但现代浏览器和 Node.js 对 TCO 的支持情况并不一致:
| JavaScript 引擎 | 主要载体环境 | TCO 原生支持情况 | 未默认开启的核心技术原因 |
|---|---|---|---|
| WebKit (JSC) | Safari 浏览器、iOS 各类 App 内置 WebKit | ✓ 完整支持 (需严格模式) | 严格按照 ECMAScript 规范实现了栈帧覆写与尾调用调度。 |
| V8 | Google Chrome、Edge、Node.js、Electron | ✕ 默认未开启 |
1. 开发调试体验:栈帧原位复用会导致 error.stack 丢失中间调用链路,难以排查线上 Bug。2. 性能与收益争议:尾调用覆写的开销与 JIT 内联编译优化存在权衡。 |
| SpiderMonkey | Mozilla Firefox | ✕ 默认未开启 | 与 V8 类似,团队出于跨平台错误栈追踪一致性与代码兼容性的考量,未激进铺开。 |
工程实践红线:切勿假设生产环境能自动享受 TCO 带来的 O(1) 栈空间红利!如果代码运行在 Chrome 或 Node.js 后端,单纯写成尾递归依然会在深度过大时抛出
RangeError。面对深度不确定的场景,必须采用应用层的防御式重构。
五、生产环境应对栈溢出的两大跨平台方案
既然不能单靠引擎的隐式优化,我们就需要在应用层将递归的调用深度与底层的调用栈深度解耦。业内成熟的工程方案主要有两种:蹦床函数(Trampoline Pattern)与显式堆栈迭代(Explicit Stack Simulation)。
方案一:蹦床函数(Trampoline Pattern)
蹦床函数的精髓在于“延迟调用”:让递归函数不直接发起下一轮调用,而是返回一个包裹了下轮调用的微型无参函数(Thunk)。外部循环控制器负责依次解包执行,每一步执行完后当前栈帧立即弹出,调用栈的深度永远不会超过 1 层。
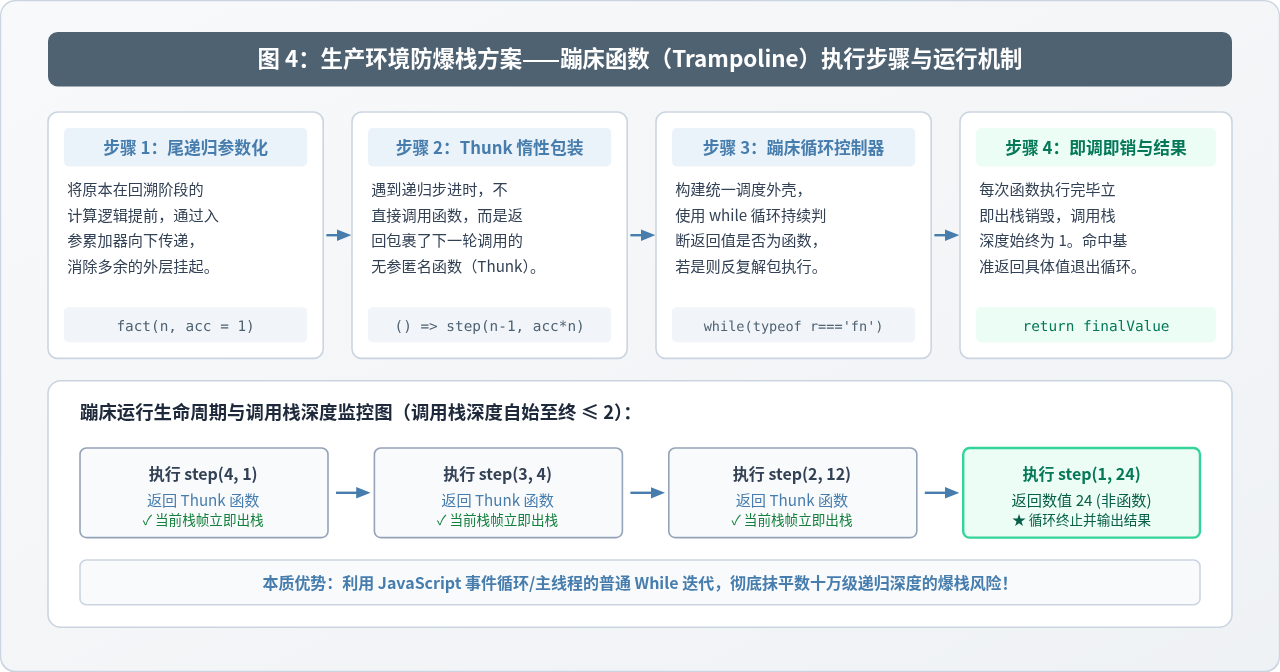
以下是通用的蹦床函数实现与使用示例:
// 1. 通用蹦床调度器
function trampoline(fn) {
  return function (...args) {
    let result = fn(...args);
    // 只要返回的是函数(Thunk),就继续在当前事件循环帧内反复调用
    while (typeof result === 'function') {
      result = result();
    }
    return result;
  };
}

// 2. 改写为 Thunk 返回形态的递归逻辑
function sumBelow(n, acc = 0) {
  if (n <= 0) return acc;
  // 关键:不直接调用自身,而是返回一个延迟执行的闭包
  return () => sumBelow(n - 1, acc + n);
}

// 3. 包装执行
const safeSum = trampoline(sumBelow);

// 测试深度达到 1,000,000 层,普通递归早已崩溃,蹦床函数轻松计算且内存平稳
console.log(safeSum(1000000)); // 500000500000
方案二:显式堆栈模拟(While + Array Stack)
如果对执行性能和垃圾回收(GC)开销有极致要求,蹦床函数每次创建临时闭包仍会有微小的内存分配。此时最优解是将系统调用栈迁移至 JavaScript 堆内存中的普通数组(Array),用纯循环代替函数调用:
// 处理深度多叉树遍历的显式堆栈方案
function deepSearchIterative(rootNode, targetId) {
  if (!rootNode) return null;

  // 用堆内存数组充当调用栈,容量受限于可用内存,而非引擎调用栈限制
  const stack = [rootNode];

  while (stack.length > 0) {
    const current = stack.pop();

    if (current.id === targetId) {
      return current;
    }

    // 将子节点反向推入栈中,保持先序遍历顺序
    if (Array.isArray(current.children)) {
      for (let i = current.children.length - 1; i >= 0; i--) {
        stack.push(current.children[i]);
      }
    }
  }

  return null;
}
六、方案选型矩阵与最佳实践决策流
在真实业务工程中,盲目将所有递归都改写成循环或蹦床函数既没有必要,也会损害代码的可读性。选择合适方案应遵循客观的决策路径:
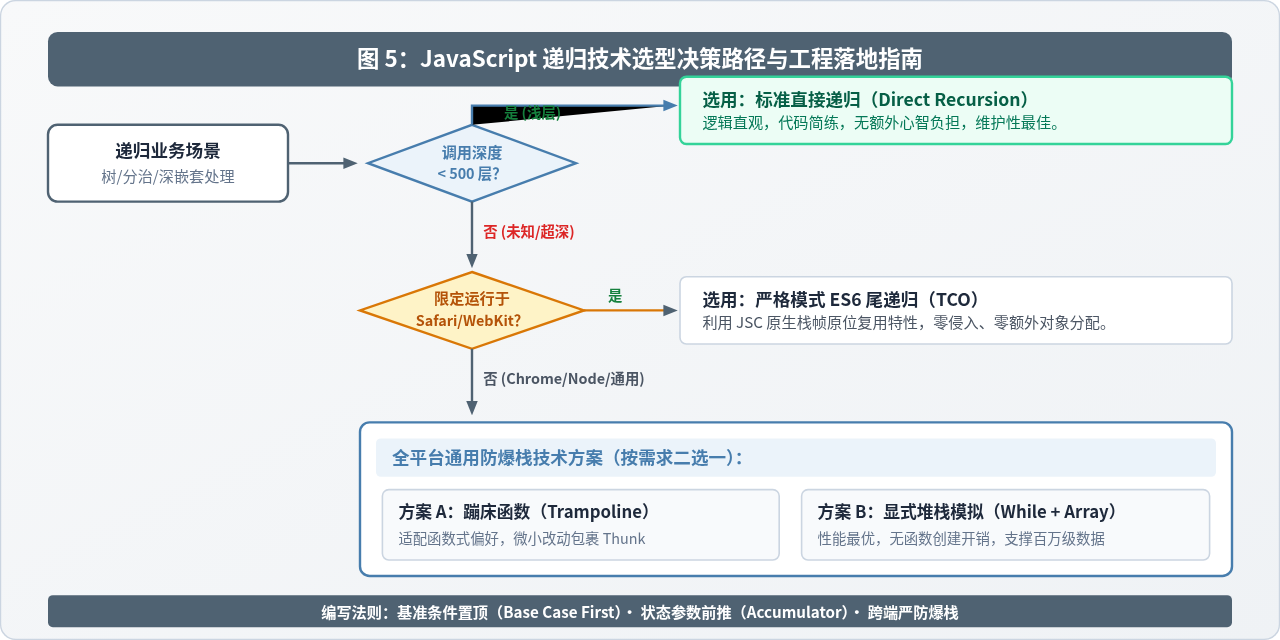
| 技术方案 | 代码可读性 | 堆栈安全性 | 执行性能 | 推荐适用场景 |
|---|---|---|---|---|
| 标准直接递归 | 极佳 (代码最简) | 深度超 10,000 时崩溃 | 快 (V8 JIT 内联优化良好) | DOM 树遍历、小规模树形菜单、常规 JSON 转换等浅层场景。 |
| 原生 ES6 尾递归 (TCO) | 良好 (保持声明式) | JSC 下恒定安全,V8 下仍会爆栈 | 极高 (栈帧原位复用) | 专门面向 Safari / JSC 运行环境的特定业务或移动端插件。 |
| 蹦床函数 (Trampoline) | 良好 (仅需封装 Thunk) | 绝对安全 (调用栈恒为 1) | 中等 (每步存在微小闭包创建) | 偏好函数式编程风格、改动代价要求极小的通用业务模块。 |
| 显式堆栈模拟 (While+Array) | 一般 (需手动管理状态) | 绝对安全 (受限于系统堆内存) | 最高 (无函数调用开销) | 大规模图结构分析、深度计算密集型算法、数据处理流水线。 |
总结准则:
1. 浅层用直觉:已知递归层数不会超过几百层时,放心使用标准递归,保证团队代码的清晰与易维护。
2. 编写守边界:所有递归必须将基准条件置顶,严格使用范围比较(如
3. 深层有预案:深度不可控或用户自由输入的大数据结构,果断重构为累加器形态并搭配蹦床函数或显式循环迭代,彻底消除线上爆栈隐患。
1. 浅层用直觉:已知递归层数不会超过几百层时,放心使用标准递归,保证团队代码的清晰与易维护。
2. 编写守边界:所有递归必须将基准条件置顶,严格使用范围比较(如
<=)并做好循环引用防护。3. 深层有预案:深度不可控或用户自由输入的大数据结构,果断重构为累加器形态并搭配蹦床函数或显式循环迭代,彻底消除线上爆栈隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章