
深入解析JavaScript处理JSON中文字符的底层机制、Unicode转义规则、序列化与反序列化实战技巧,并提供生僻字代理对与网络传输乱码的避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript怎么处理JSON中的中文字符?转义规则与解析实战
作者:纸飞机
时间:2026-10-30
浏览:186
文章目录
在JavaScript开发中处理中文数据时,许多初学者常常会对JSON字符串中出现的原生中文字符与类似\u4e2d\u6587的Unicode转义字符产生困惑。事实上,现代ECMAScript规范与JSON官方标准(RFC 8259)均已将UTF-8作为默认编码,JSON.stringify()在默认情况下会直接保留可读的原生中文,而JSON.parse()则能天然解析原生中文与Unicode转义序列。本文将详细拆解JavaScript处理JSON中文的底层转义规则、两者的相互转换实战,以及生僻字和双重转义等高频故障的排查方案。
一、核心原理:JavaScript 与 JSON 的字符规范
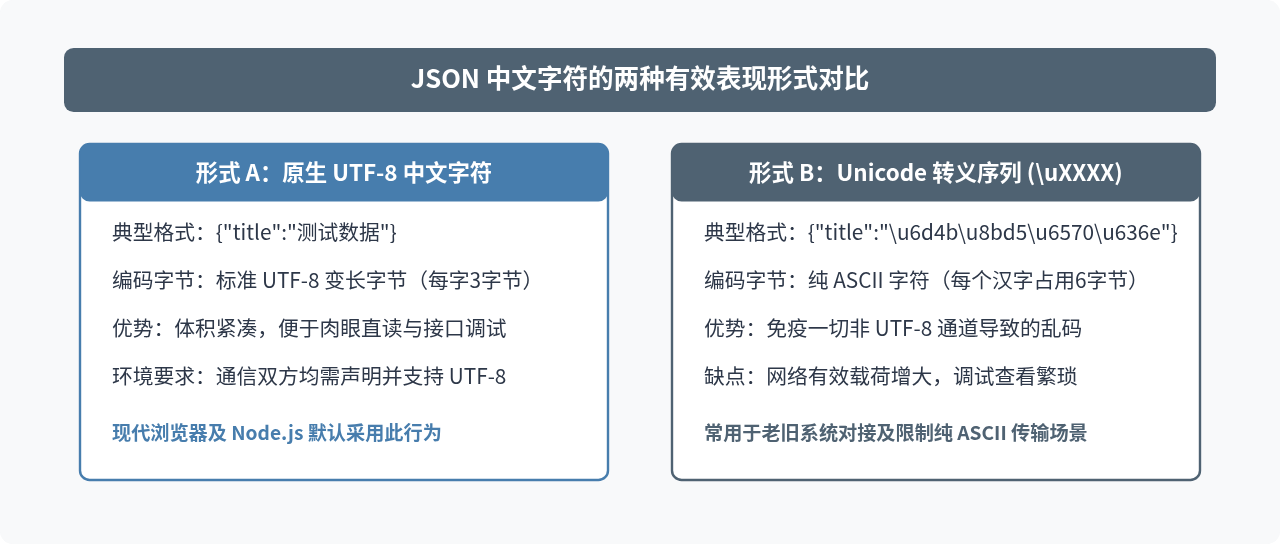
在深入代码之前,需要明确 JSON 规范中对字符的明确定义。JSON(JavaScript Object Notation)文本基于 Unicode 字符集编写。根据现行的 RFC 8259 规范:
- 网络传输中的 JSON 文本应当强制采用 UTF-8 编码。
- JSON 字符串内除了双引号(
")、反斜杠(\)以及控制字符(U+0000 到 U+001F)必须进行转义之外,包括汉字在内的所有合法 Unicode 字符均允许直接以明文呈现。 - JSON 同时允许使用
\uXXXX形式的六字符序列来转义表示任意属于基本多语言平面(BMP)内的 Unicode 字符。
很多开发者误以为“标准 JSON 里的中文必须转成 \uXXXX”,这实际上是一种过时的误解。在早期网络环境中,由于部分邮件协议或老旧 HTTP 网关只支持 7 位 ASCII 字符,将中文转为 ASCII 范围内的 \uXXXX 序列能够有效防止乱码。但在当今现代前后端环境中,直接传输 UTF-8 原生中文不仅符合标准,还能减少大约 50% 的中文字符串载荷。
二、实战:编码、转义与解析的完整处理流程
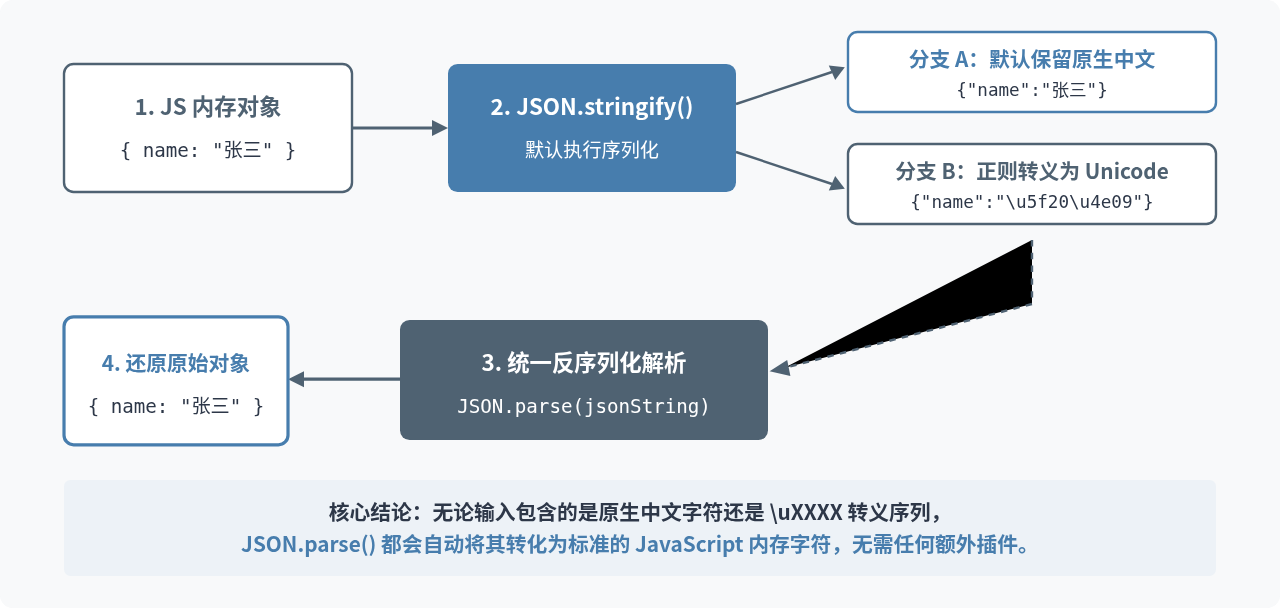
在实际业务中,我们主要面临三种处理诉求:默认直接转换、将中文强制转义为 \uXXXX,以及将包含转义序列的 JSON 还原。
1. 默认序列化与反序列化
在大多数现代业务场景中,直接使用内置方法即可满足要求:
// 1. 包含中文的对象
const user = { id: 101, name: "张三", role: "管理员" };

// 2. 序列化为 JSON 字符串
const jsonStr = JSON.stringify(user);
console.log(jsonStr);
// 浏览器与 Node.js 输出:'{"id":101,"name":"张三","role":"管理员"}'

// 3. 反序列化
const parsedUser = JSON.parse(jsonStr);
console.log(parsedUser.name); // 输出:张三
2. 将中文字符强制转义为 \uXXXX
当对接只接受 ASCII 编码的外部设备、老旧邮件网关或特定第三方接口时,我们需要将中文字符转为转义格式。JSON.stringify 本身没有提供参数控制是否开启 Unicode 转义,但我们可以通过后置正则替换或自定义逻辑优雅实现:
/**
 * 将普通 JSON 字符串中的中文字符转换为 \uXXXX 格式
 * @param {object} obj - 需要转换的对象
 * @returns {string} 包含 Unicode 转义序列的 JSON 字符串
 */
function stringifyWithUnicodeEscape(obj) {
  const json = JSON.stringify(obj);
  // 匹配非 ASCII 字符并转换为 4 位 16 进制 Unicode 转义码
  return json.replace(/[\u007f-\uffff]/g, (char) => {
    return "\\u" + ("0000" + char.charCodeAt(0).toString(16)).slice(-4);
  });
}

// 示例验证
const data = { message: "你好,世界" };
const escapedJson = stringifyWithUnicodeEscape(data);
console.log(escapedJson);
// 输出:{"message":"\u4f60\u597d\uff0c\u4e16\u754c"}
3. 解析带有 \uXXXX 转义的 JSON 字符串
初学者容易踩的一个误区是:在拿到形如 {"name":"\u5f20\u4e09"} 的字符串时,试图手动写正则表达式去将 \uXXXX 转换回中文。其实完全没有必要,直接调用 JSON.parse(),引擎内部会自动完成转义符的映射还原:
const remoteJson = '{"city":"\\u5317\\u4eac","status":"\\u6b63\\u5e38"}';
const result = JSON.parse(remoteJson);

console.log(result.city);   // 自动输出:"北京"
console.log(result.status); // 自动输出:"正常"
三、核心陷阱与深度排查:生僻字与双重转义
在实际工程中,关于 JSON 中文字符的故障往往集中在两处:一是超出 BMP 平面的生僻字;二是后端错误拼装导致的“双重转义”。
1. 生僻字处理与代理对(Surrogate Pairs)
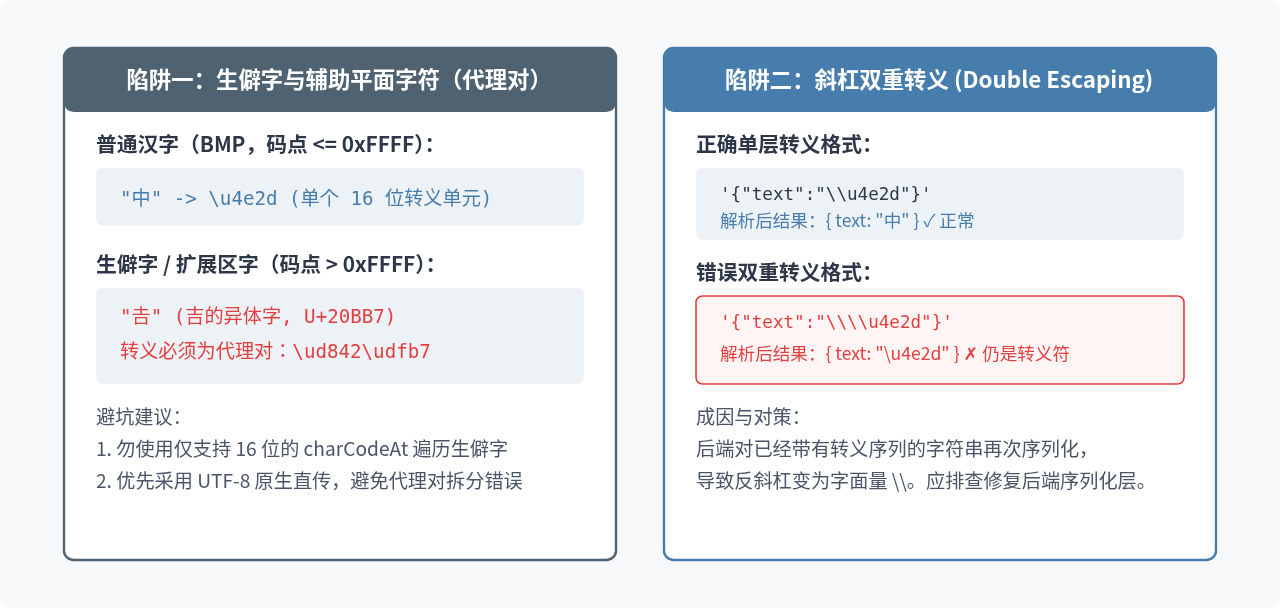
人名或历史古籍中常出现的扩展汉字(例如“𠮷”、“𬌗”等),其 Unicode 码点大于 0xFFFF。在 JavaScript(采用 UTF-16 编码)中,这类字符无法用单个 \uXXXX 表示,而是会被拆分为两个 16 位的“高位代理”和“低位代理”。
const rareChar = "𠮷";
console.log(rareChar.length); // 输出:2(占用两个代码单元)

// 默认直接序列化,保留原始字符(推荐)
console.log(JSON.stringify({ char: rareChar }));
// 输出:{"char":"𠮷"}

// 若强制进行 Unicode 转义,需支持代理对
function toUnicodeSurrogate(str) {
  return str.replace(/[^\x00-\x7F]/g, (c) => {
    return "\\u" + c.charCodeAt(0).toString(16).padStart(4, "0");
  });
}
console.log(toUnicodeSurrogate(rareChar));
// 输出:\ud842\udfb7(由高代理与低代理共同构成)
注意事项:直接使用原生 UTF-8 传递 JSON 是避免生僻字转义截断的最佳方案。若必须转义,请确保反向解析端支持 UTF-16 代理对合并。
2. 双重转义导致页面显示形如“\u4e2d\u6587”字样
很多开发者反映:“为什么我调用了 JSON.parse(),前端页面渲染出来的依然是 \u5317\u4eac 这样的代码,而不是北京两个字?”
根本原因在于后端进行了二次序列化。例如服务端原本生成了 {"city":"\u5317\u4eac"},在返回前又调用了一次序列化工具,导致原本的反斜杠被当做普通字符再次转义为 \\,实际到达浏览器的内容变成了:
'{"city":"\\\\u5317\\u4eac"}'此时前端执行一次 JSON.parse(),得到的值实际上是包含了反斜杠、u及字母的字面量普通文本 "\u5317\u4eac"。若遇到不可控的后端历史包袱,前端可通过针对性解码函数进行补救:
function fixDoubleEscapedUnicode(str) {
  return str.replace(/\\u([0-9a-fA-F]{4})/g, (_, hex) => {
    return String.fromCharCode(parseInt(hex, 16));
  });
}

// 示例
const bugValue = "\\u5317\\u4eac"; // 解析后得到的假转义字面量
console.log(fixDoubleEscapedUnicode(bugValue)); // 还原输出:"北京"
四、实战避坑与场景决策指南
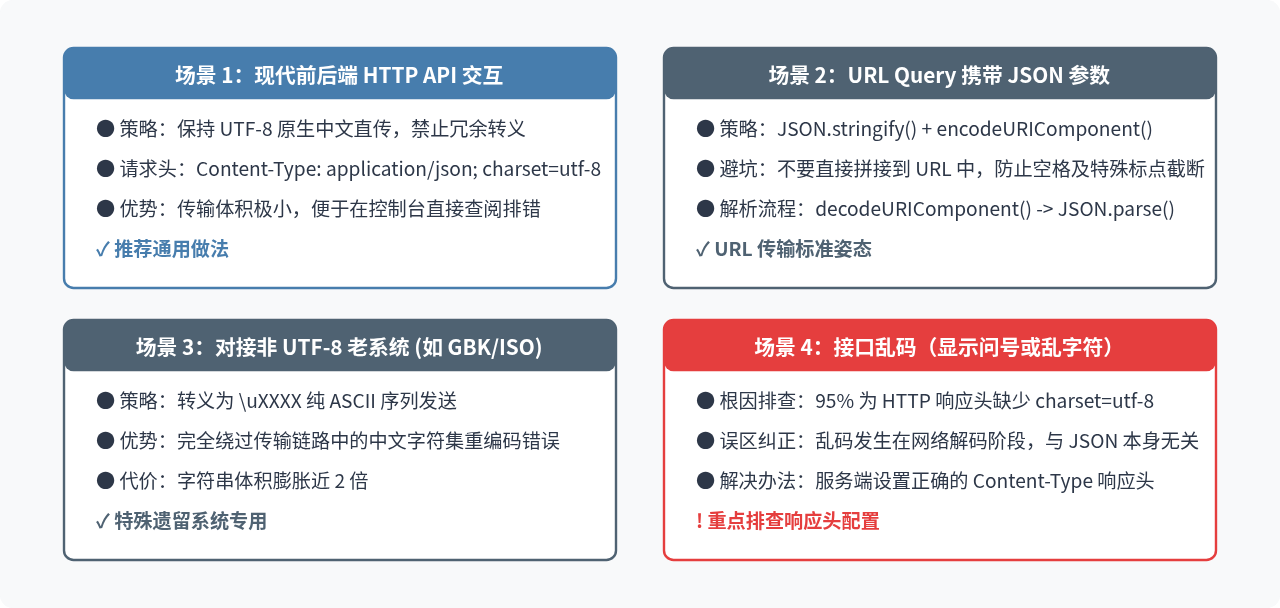
为了在实际工程中保持高效与规范,面对不同的数据交互场景,建议遵循以下决策规范:
核心注意事项小结:
- 避免无意义的手动反转义:遇到服务端返回的
\uXXXX字符,直接调用JSON.parse()即可,不要引入复杂的自定义解密函数。 - URL 传输务必配合 URL 编码:如果需要将 JSON 放入 URL query 参数(例如 GET 请求传参或页面跳转传递 state),在序列化后必须调用
encodeURIComponent(jsonString),避免特殊符号被浏览器自动截断。 - 区分乱码的层级:当页面出现
???或é等乱码时,这是网络层编码(HTTP Header)不匹配导致的,在 JSON 解析前字节流就已经损坏,尝试在 JavaScript 内部做字符串替换无法解决问题,必须从接口的Content-Type和后端文件读取编码入手。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章