

Understand-Anything通过静态分析与多智能体协作,将项目代码扫描为可视化知识图谱,支持搜索、追问及改动影响分析,帮助开发者快速理解系统架构和业务逻辑,降低陌生代码库的认知成本。
Understand-Anything:不用硬啃源码,项目变成可追问知识图谱
作者:技术拾光
时间:2026-06-09
浏览:146
文章目录
近期在 AI 编程领域,Understand-Anything 的关注度持续攀升。
从数据表现来看,该项目本周新增约 7.5k Star,总星数已达 15k。不过根据 GitHub 页面显示,目前实际星数已接近 36k Star。这一增长趋势表明,它并非昙花一现的刷屏项目,而是精准回应了一个真实痛点——随着项目规模不断膨胀、工具链日益繁杂,理解一个陌生代码库所需的时间成本始终居高不下。
它解决的不是“读代码”,而是“先知道从哪读”
接手一个老项目时,最令人困扰的往往不是某段函数的逻辑,而是对系统全局的模糊感。开发者真正想了解的问题通常是这样:
用户下单从哪里进来?支付失败会影响哪些模块?这个接口被哪些地方调用?我改这个文件,测试、前端、任务队列会不会受影响?
传统做法无非是全局搜索、IDE 跳转引用、翻阅 README,再向老同事请教。但这些方式获取的信息过于零散:搜索能找到关键词,却说不清业务含义;IDE 能跳转到引用,但很难拼出系统全貌;而 README 往往早已落后于代码。
Understand-Anything 的思路相当直接:先对整个项目进行一次完整扫描,将文件、函数、类、依赖关系、调用链、业务域和架构层全部抽离出来,生成一张可视化的知识图谱。在这张图上,开发者可以搜索、点击、追问,还能查看改动的潜在影响范围。
它并非替代工程师阅读源码,而是让工程师在读源码之前先拿到一张系统地图。
代码理解工具的工作原理
Understand-Anything 采用“静态分析 + 多智能体理解”的技术路线。
静态分析负责处理确定性信息,例如文件、函数、类、import 和调用关系。LLM 则负责补充语义信息——比如“这个模块负责用户认证”“这个文件属于数据访问层”“这条路径是支付回调流程”。
整体流程可以这样理解: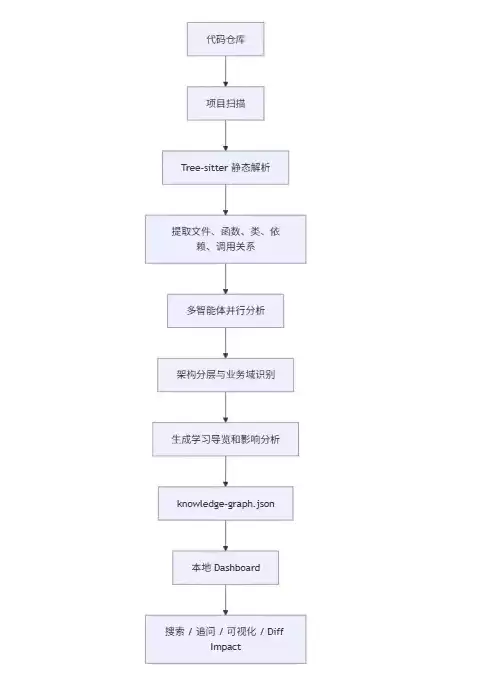
官方 README 中提到,核心命令 /understand 会编排多个 Agent,各司其职:
| Agent | 作用 |
|---|---|
project-scanner | 扫描项目结构,识别语言和框架 |
file-analyzer | 分析文件、函数、类和依赖 |
architecture-analyzer | 识别 API、Service、UI、Data 等架构层 |
tour-builder | 生成新人学习路线 |
graph-reviewer | 检查图谱完整性 |
domain-analyzer | 提取业务域和流程 |
这也是它和普通代码搜索工具的最大区别——代码搜索只回答“词在哪里”,而 Understand-Anything 更倾向于回答“它在系统里扮演什么角色”。
AI 编程工具的上手流程
以下是官方推荐的路径,此处仅作说明,不需要在本机真实启动。
1. 安装 Claude Code 插件
/plugin marketplace add Lum1104/Understand-Anything/plugin install understand-anything
2. 分析项目
/understand
执行后会生成:
.understand-anything/knowledge-graph.json
如果想生成中文说明,可以使用:
/understand --language zh
3. 打开 Dashboard
/understand-dashboard
Dashboard 中可以查看项目图谱、架构分层、节点说明、依赖路径,也可以搜索函数、文件或业务概念。
常用命令还包括:
# 问代码库问题
/understand-chat How does the payment flow work
# 分析当前改动影响面
/understand-diff
# 解释某个文件或函数
/understand-explain src/auth/login.ts
# 生成新人入门指南
/understand-onboard
# 抽取业务域和流程
/understand-domain
代码库分析图谱的查看方法
图谱工具最怕变成“看起来很复杂,但不知道怎么用”。建议按照以下顺序查看:

优先关注三类节点。
第一类是入口节点,例如 API route、controller、页面入口、CLI command、定时任务入口。
第二类是核心业务节点,例如订单、支付、用户、权限、库存、消息通知。
第三类是边界节点,例如数据库访问、缓存、队列、第三方 SDK、外部 API。
这三类节点梳理清楚后,系统骨架基本就浮现出来了。
典型场景:接手支付流程
假设你刚接手一个电商项目,需要理解支付链路。
过去的做法可能是这样:
grep payment
看 controller
看 service
看 repository
看回调接口
看队列消费者
看测试
再问老同事
使用 Understand-Anything 后,可以先运行:
/understand --language zh
/understand-dashboard
然后在 Dashboard 中搜索:
payment
checkout
order
refund
callback
它会将相关文件、函数、依赖路径和业务节点集中展示出来。你可以先查看支付入口,再查看订单服务、支付回调、库存扣减、消息通知和测试文件。
如果已经改了代码,还可以使用:
/understand-diff
查看本次改动可能影响哪些模块。这样再让 Claude Code 或 Codex 动手改代码时,上下文信息会更加准确。
团队协作中的使用方法
Understand-Anything 会生成 .understand-anything/knowledge-graph.json。该文件本质上是项目图谱,可以考虑提交到仓库,供团队成员共享。
建议提交:
.understand-anything/knowledge-graph.json
不建议提交:
.understand-anything/intermediate/
.understand-anything/diff-overlay.json
如果图谱文件较大,可以使用 Git LFS 管理:
git lfs install
git lfs track ".understand-anything/*.json"
更稳健的团队流程如下:
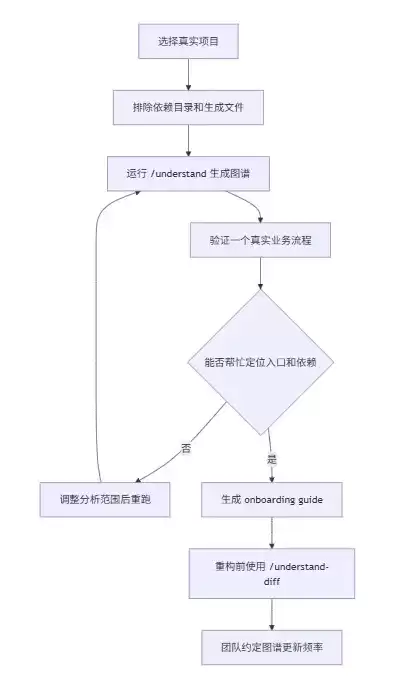
实践中的注意事项
第一,先排除噪声文件。大型项目中务必排除以下目录:
node_modules
dist
build
coverage
target
.next
.turbo
generated
vendor
否则图谱会变得臃肿、分析速度变慢,结果也会被无意义文件污染。
第二,不要将 LLM 摘要当作绝对事实。Tree-sitter 抽取的结构关系比较可靠,但 LLM 生成的业务摘要、标签和解释仍可能存在偏差。它适合作为导航工具,不适合作为最终判断依据。真正改代码之前,关键文件还是需要点进去确认。
第三,图谱需要与代码版本绑定。knowledge-graph.json 是某个 commit 下的快照。代码一旦变化,图谱就会过期。团队最好约定:主分支大改后重新生成,重要重构前重新生成,发布前重新生成。
第四,影响分析不能替代测试。/understand-diff 能帮助缩小检查范围,但不能证明行为正确。正确的流程应该是:
图谱看影响面 → 测试验证行为 → Review 判断设计
第五,注意敏感信息。图谱中可能包含文件路径、函数名、业务摘要、接口说明和依赖关系。对企业项目而言,这些信息本身可能就具有敏感性。提交 .understand-anything/ 之前,需要确认其中没有密钥、客户名、内网地址或未公开的业务流程。
适用场景分析
适合的场景包括:新人入职,需要快速理解项目;老项目缺乏文档,结构又复杂;多语言项目依赖关系混乱;重构前需要评估影响范围;AI Agent 改代码前需要更充分的上下文;技术负责人希望梳理系统架构和业务域。
不太适合的场景包括:项目很小,十几个文件直接查看更快;对 token 成本极度敏感;项目中生成文件太多但未做排除;代码运行时关系高度动态,静态分析难以捕捉;团队不愿意维护图谱更新。
总结
Understand-Anything 这波热度,不是因为它能取代工程师,也不是因为它能让人彻底不看源码——它的真正价值在于:读源码之前,先把系统的地图画出来。
过去理解项目,全靠 README、全文搜索、IDE 跳转,再加上老同事的脑内经验。现在多了一个选项:让工具先扫描一遍代码,生成一张可视化、可搜索、可追问的知识图谱,然后开发者再沿着图谱去查看关键路径。
一句话总结:如果你经常接手陌生项目、维护遗留系统,或者让 Claude Code、Codex 这类 Agent 参与真实开发,不妨尝试一次。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章