

YOLOv1将输入图片划分为7×7网格,每个网格预测两个边界框,共98个框。损失函数通过交并比(IoU)匹配预测框与真实框,包含位置、置信度和类别损失,并设置权重放大坐标损失。非极大值抑制按类别筛选置信度大于0.2的预测框,排序后取最高分框绘制。
YOLOv1损失函数与非极大值抑制
作者:技术拾光
时间:2026-05-31
浏览:96
文章目录
损失函数
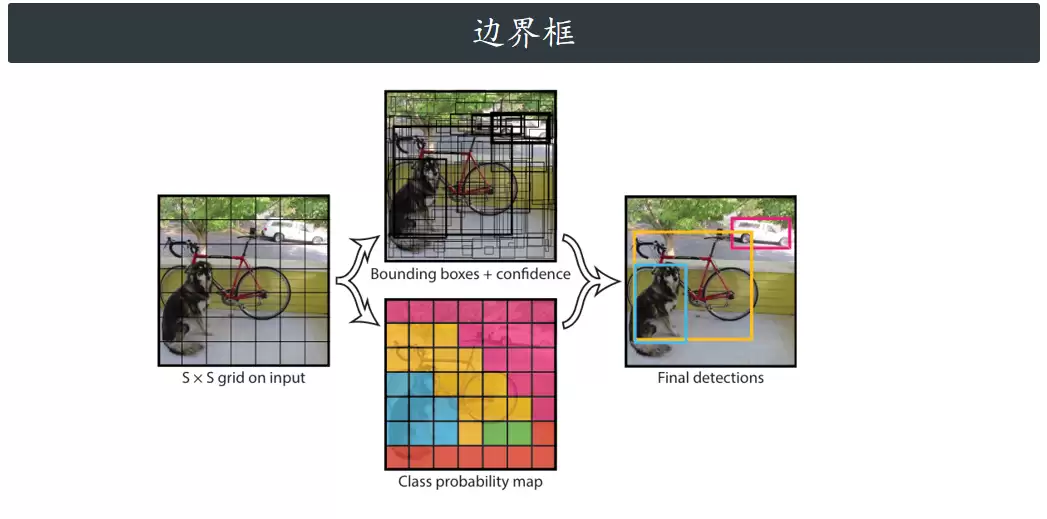
首先介绍基本事实:YOLOv1将输入图片划分为7×7的网格,共49个格子。每个网格会预测两组中心点和边界框的信息,即49乘以2,共98个中心点和边界框。那么,这98个框中,哪一个才是真正可靠的?哪一个最准确?
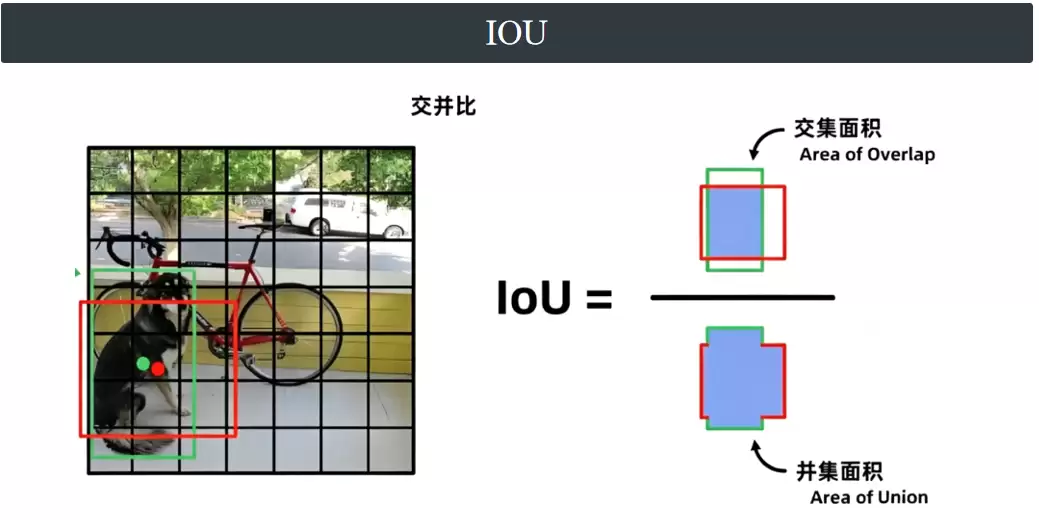
衡量模型检测效果的核心指标是交并比(IoU)。在数据预处理阶段,人工标注出目标物体准确的位置和尺寸,这个标准框称为真实框(Ground Truth),即模型训练的“标准答案”。模型推理时输出的框称为预测框。将预测框与真实框进行比较:计算它们的交集面积除以并集面积,得到的结果即为IoU。该值越高,说明预测框越准确。
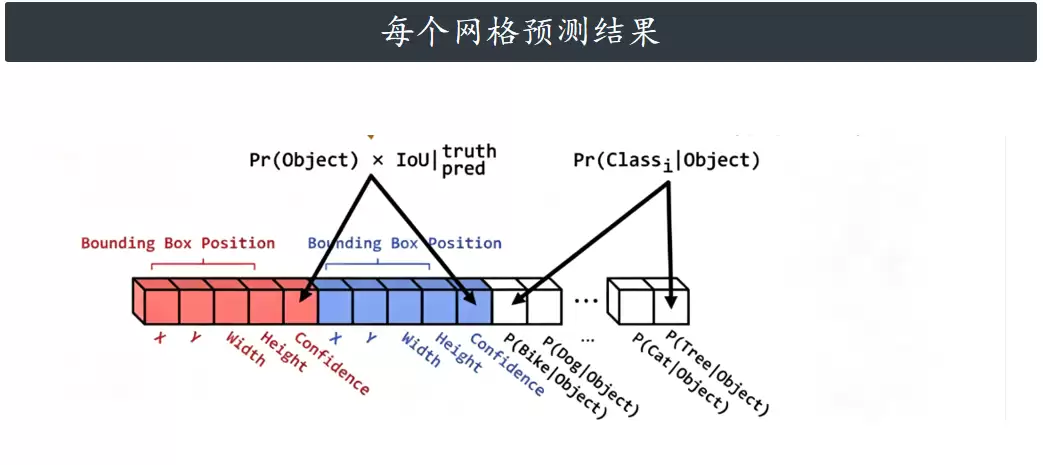
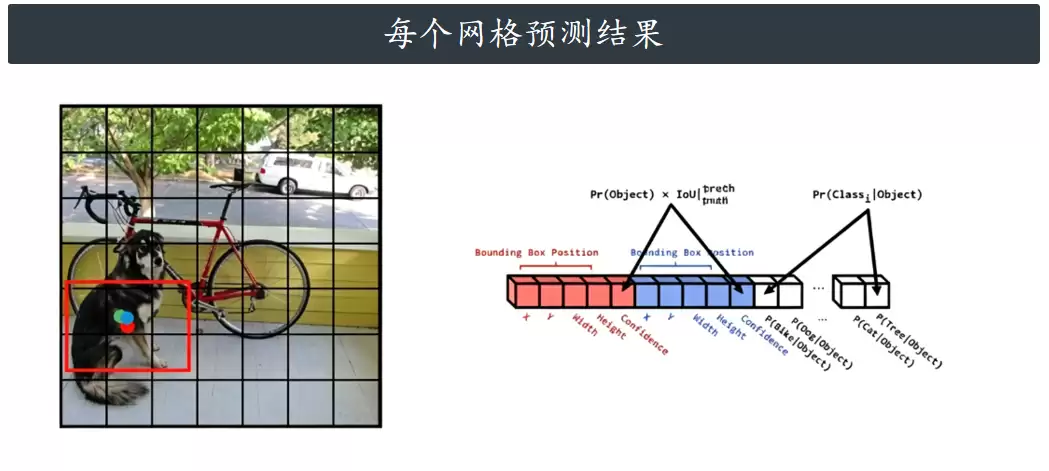
在预测阶段,网络在每个网格输出的信息包括:两组边界框的中心点偏移、宽高偏移量,以及对应这两个框的置信度。YOLOv1对置信度的定义是:网格包含目标物体的概率乘以预测框与真实框的IoU。若网格中确实存在物体,该概率为1;无物体则为0。此外,每个网格还会输出20个类别的预测概率值。
训练过程中,网络将自己预测出的两个边界框与标注好的绿色真实框(GT)进行匹配对比。IoU过小、明显不匹配的预测框会被自动舍弃,仅保留匹配度更高的那个框,用于计算后续的损失函数。
损失函数设计
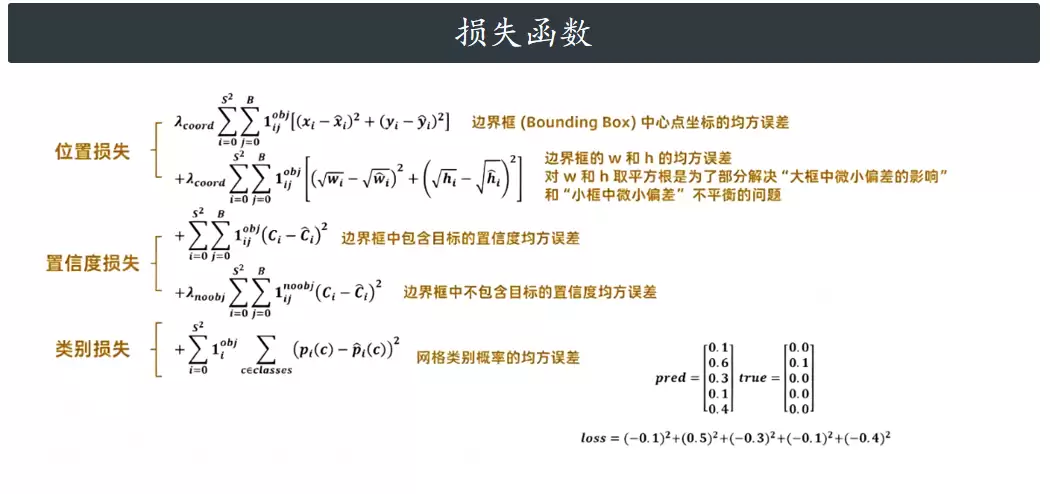
YOLOv1的损失函数设计如下:
公式中的S代表划分的7×7共49个网格,参数B=2表示每个网格预测2个边界框。obj表示网格包含目标物体时取1,不包含时取0;noobj则相反——网格有物体时取0,无物体时取1。损失函数计算时同时兼顾包含物体的网格和不包含物体的网格,两者都不遗漏。
这里有一个巧妙的设计:权重系数设置为5,专门用于放大中心点与边界框坐标的损失权重。原因在于49个网格中,真正包含物体的网格数量极少。若不加大权重,那些不含物体的网格产生的损失会稀释目标位置的重要性。设置该权重是为了让模型将注意力集中在真正有目标的位置上。
损失函数的前两项为位置损失,使用均方误差计算预测框中心点、宽高与真实框的偏差。即真实值减去预测值后平方。后续项依次为置信度损失和类别分类损失。
非极大值抑制
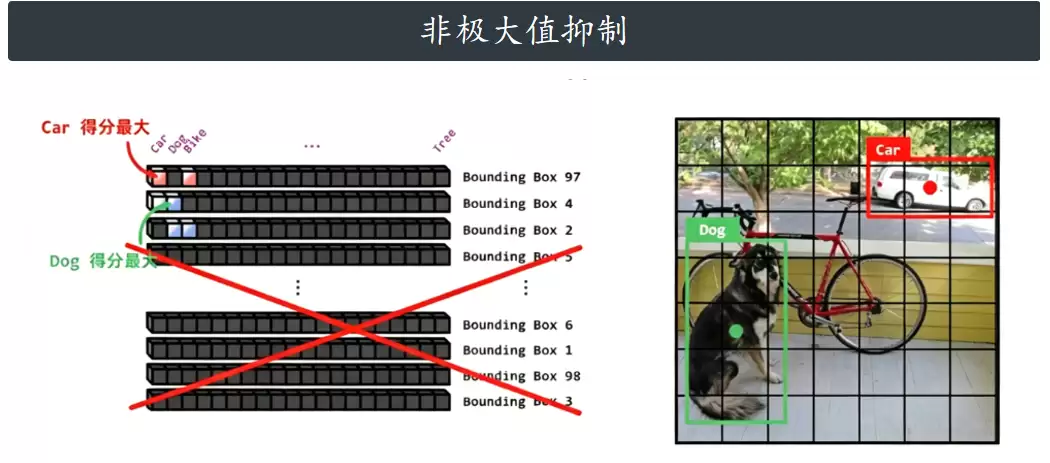
YOLOv1共输出98个预测框,模型如何从众多框中挑选出最优的那些?
每个网格输出的预测向量中,后20个数值对应20个类别的预测概率;前10个参数包含两组边界框的信息,其中包括两个边界框的置信度得分。该置信度得分由公式计算得出,具体定义如下:
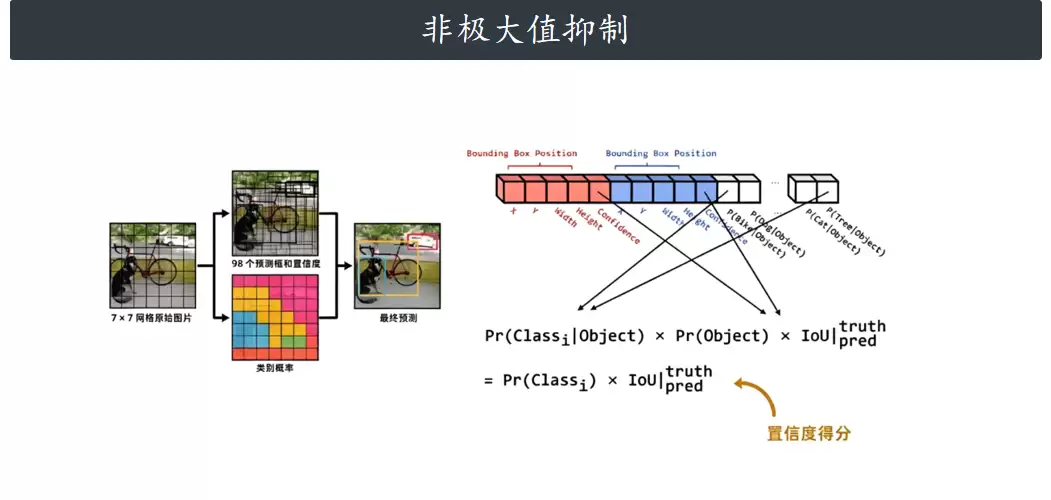
随后得到两个长度为20维的新向量。向量中的每个数值分别代表该预测框对应各个类别目标的置信可靠程度。
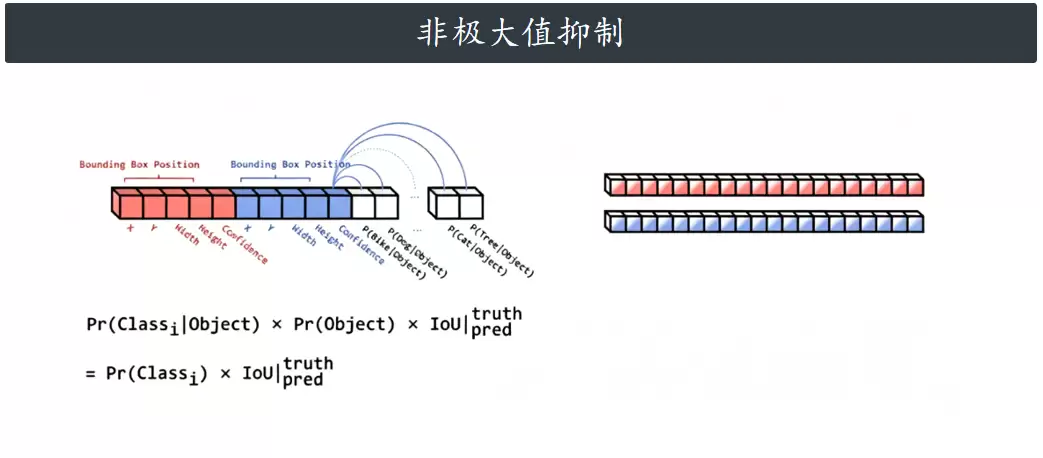
最终得到98个20维的向量,分别对应模型预测的98个边界框。向量中每一列的数值代表对应类别的置信度得分。例如第一列为目标属于汽车类别的置信度。
处理时按类别逐一进行:以汽车类别为例,先筛选出置信度大于0.2的预测框,其余全部舍弃(代码实现时直接将置信度置0)。然后将保留的预测框按置信度从高到低排序,为后续的非极大值抑制(NMS)做准备。
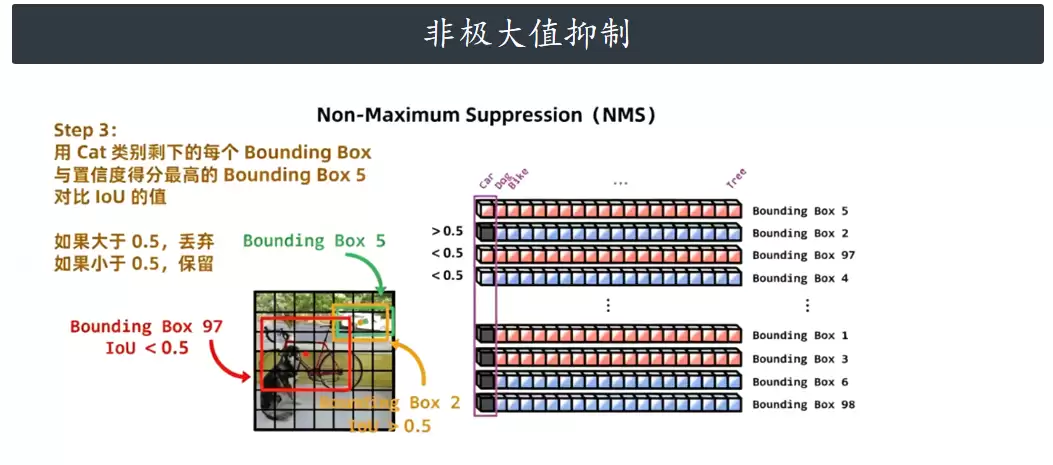
最后整理成一个98×20的矩阵,将矩阵中所有置信度为0的无效数据剔除,即可进行预测框的绘制。仍以汽车类别为例:仅在汽车类别中,挑选出置信度得分最高的预测框,提取其对应的中心点和边界框坐标,直接绘制到原始图片上,并标注相应的类别标签。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。