

BERT采用Transformer编码器架构,通过掩码语言模型和下一句预测进行双向预训练,擅长语义理解与分类任务。官方发布Base和Large两个版本,分别拥有110M和340M参数,后者语义理解更强但算力要求更高。
人工智能BERT简单介绍
作者:技术拾光
时间:2026-05-31
浏览:469
文章目录
2017年发布的Transformer模型,在自然语言处理领域引发了一场重大变革。此后,BERT和GPT作为代表性模型相继问世,分别由谷歌和OpenAI推出,代表了当时两条完全不同的技术路线。本文重点介绍其中的BERT模型。
模型概述
从任务方向来看,预训练语言模型大致可分为两类:一类以语义理解、识别、分类为核心目标的理解型模型;另一类以文本自动生成为核心目标的生成型模型。
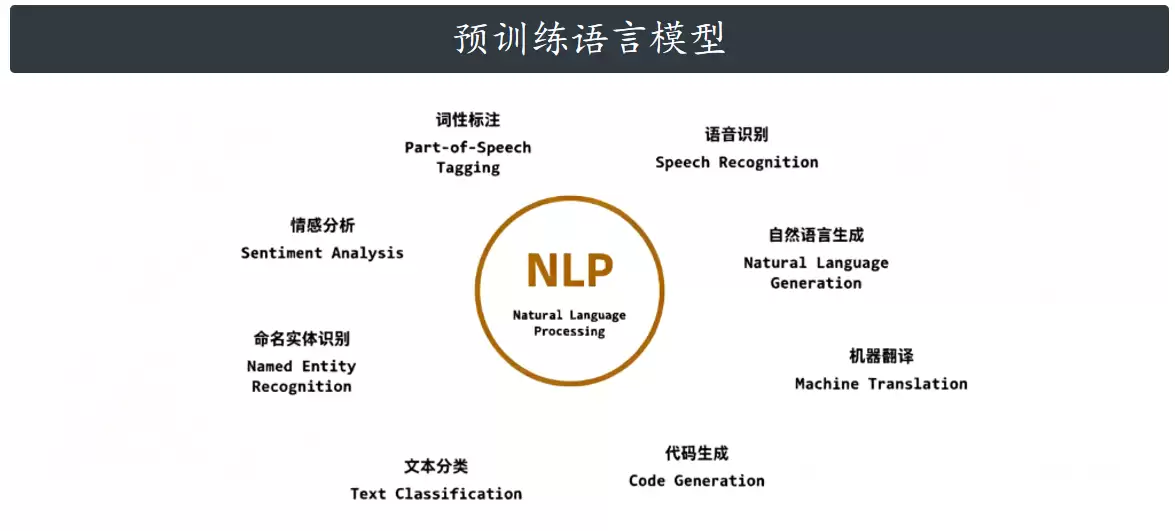
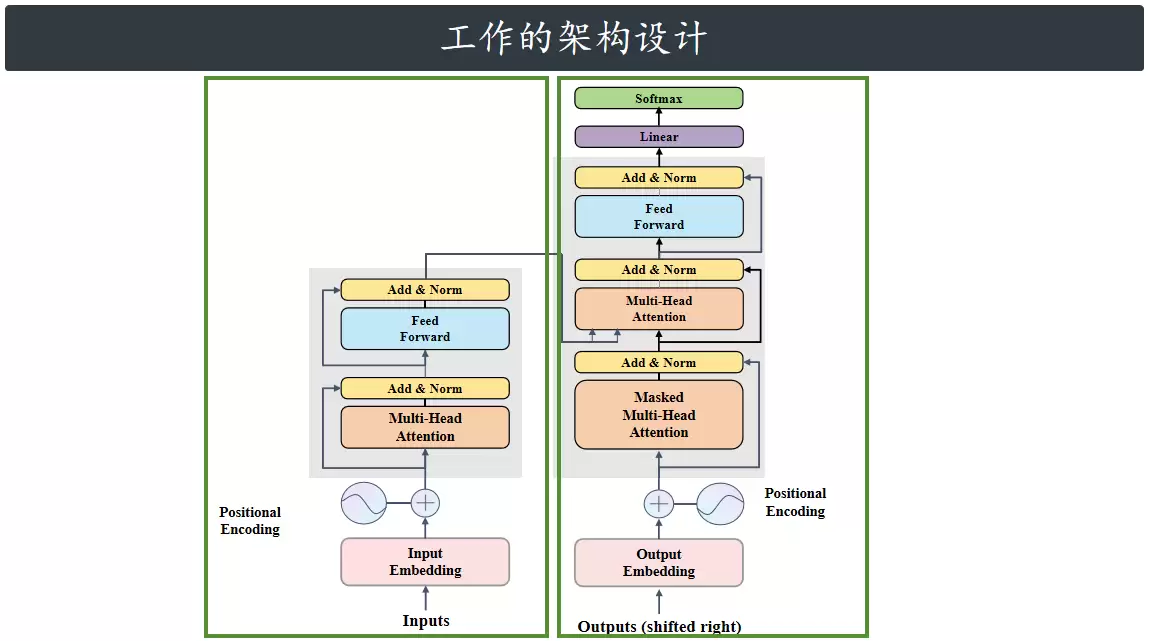
两者在模型结构上存在本质区别:BERT采用Transformer编码器架构,擅长双向上下文理解;GPT则使用Transformer解码器架构,擅长自回归文本生成。这决定了两者分别走向语言理解与语言生成两条不同的发展道路。
- BERT系(编码器) → 专注语言理解,代表模型包括RoBERTa、中文MacBERT;
- GPT系(解码器) → 专注语言生成,当前主力为GPT-5.4,最新旗舰为GPT-6。
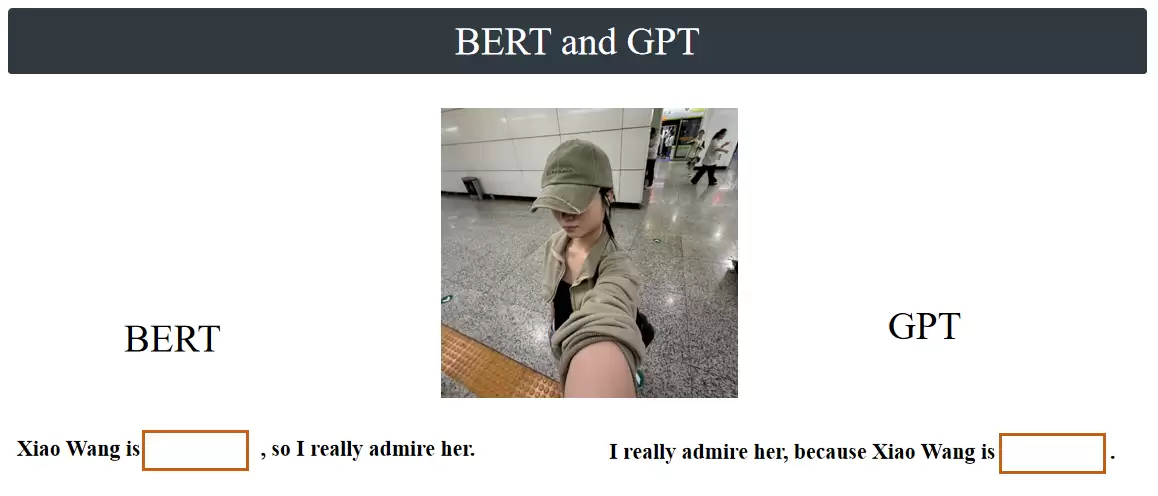
可以用一个比喻来理解:BERT相当于做完型填空,训练时会随机遮挡句子中的部分词语,模型可以同时看到被遮挡位置之前和之后的所有上下文,根据双向信息预测被遮住的词。GPT则相当于续写句子,模型只能看到前面已经出现的文字,单向预测下一个词,无法看到未来内容。正是这种训练方式的差异,造就了两者不同的能力:BERT擅长双向深度理解语义,GPT擅长单向连贯文本生成。
训练流程
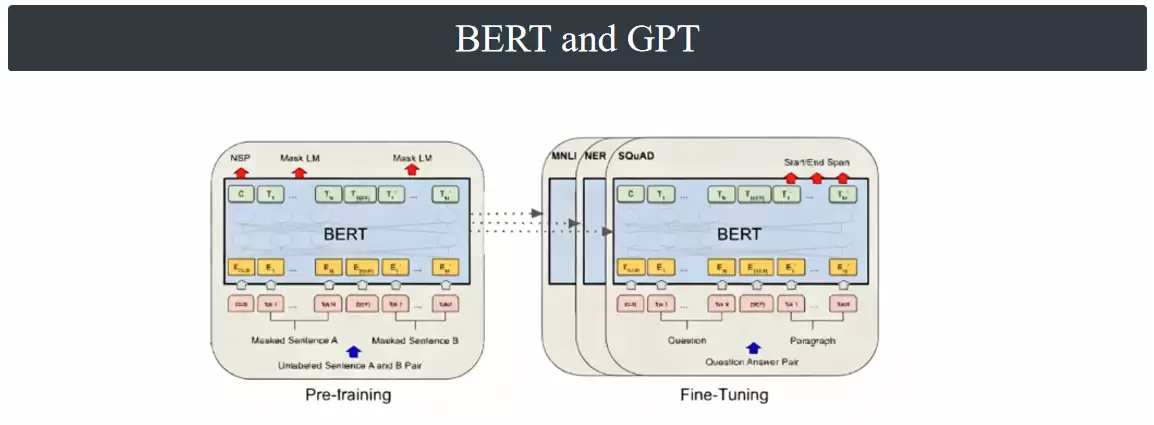
BERT的完整训练流程包含两个核心步骤:首先进行无监督预训练,在海量无标注文本上通过完型填空任务学习通用语言知识;随后进行有监督微调,在特定任务的标注数据上进一步优化,完成文本分类、语义理解等下游任务。微调完成后,模型即可投入实际应用。
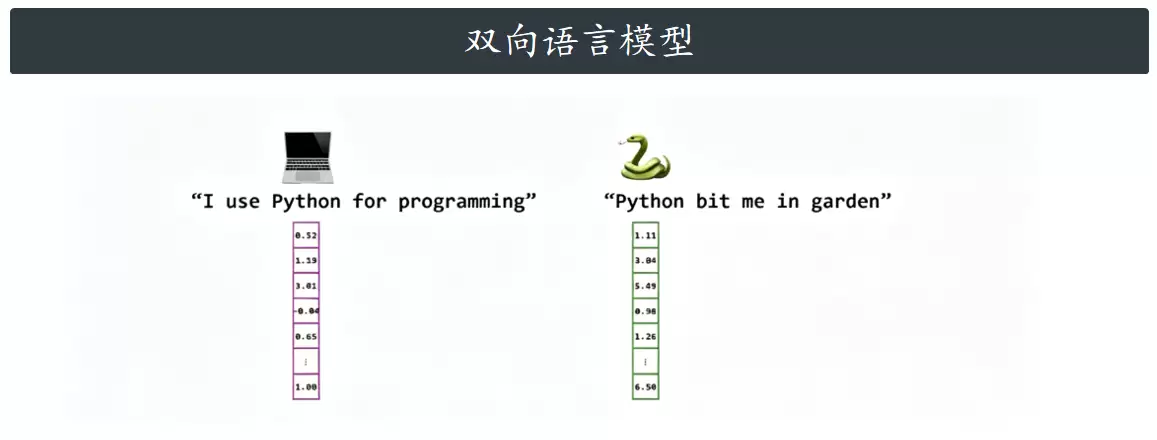
需要强调的是:BERT是一个双向语言模型,类似于做完型填空。模型只有同时正确理解词语的前文与后文,才能为单词“Python”在不同语境下生成精准对应的语义嵌入向量。
两种版本
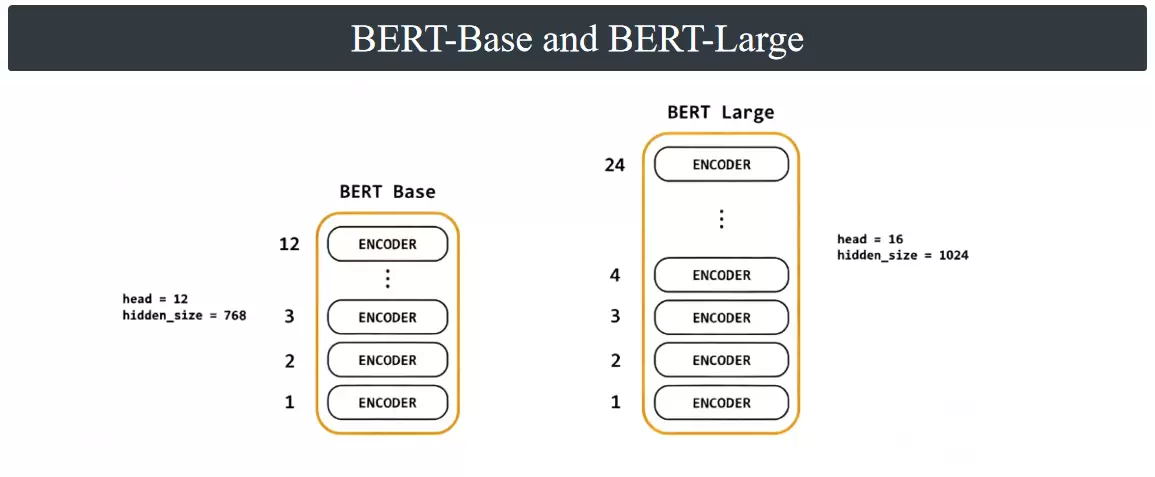
BERT于2018年正式发布,官方同期推出了两个版本:基础版(BERT-Base)和大模型版(BERT-Large)。
两者的主要区别在于网络层数、注意力头数和参数量:
- BERT-Base(基础版):12层Transformer编码器,12个注意力头,总参数约110M。速度快、资源占用低,适合日常开发、实验和普通下游任务。
- BERT-Large(大版本):24层Transformer编码器,16个注意力头,总参数约340M。模型更深更大,语义理解能力更强,但训练和推理速度更慢,算力要求也更高。
输入表示
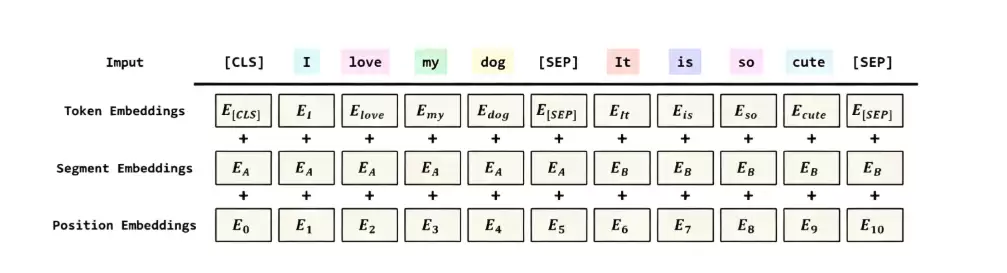
在词嵌入与位置嵌入的基础上,BERT额外引入了片段嵌入(Segment Embedding)。BERT通常以两个句子组成的句对作为输入,片段嵌入的作用是区分词语属于第一句还是第二句。
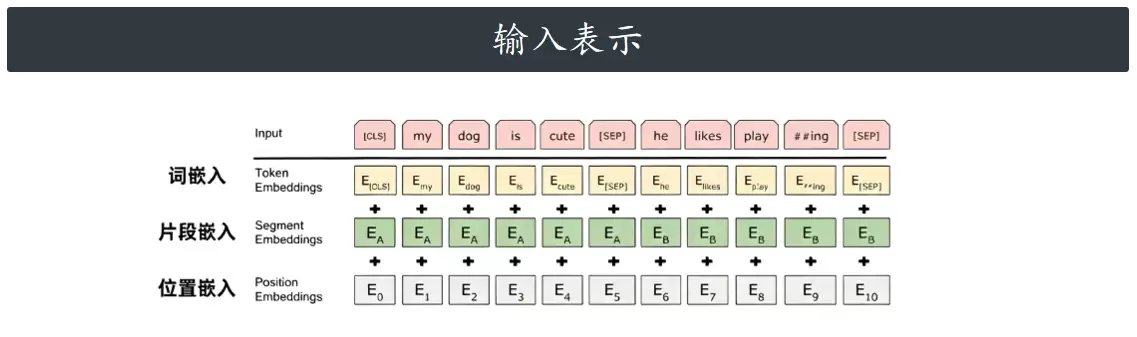
举例来说,假如有一段包含两句话的文本,BERT会先对其进行分词处理(通常采用WordPiece分词器,将单词拆解为更小的子词单元)。随后,在第一句话的开头插入一个特殊的[CLS]标记,其作用是表示这个位置是整个句对的聚合表示,常用于分类任务。在第一句话和第二句话的结尾,分别加上一个[SEP]标记,用于分隔两个句子,同时让模型理解每个句子的边界。经过标记插入后,整个序列进入嵌入层。在BERT中,每个token最终获得的输入向量由三部分嵌入向量逐元素相加而成。
预训练任务
BERT在预训练阶段采用两个核心自监督任务:掩码语言模型(MLM,Masked Language Model)与下一句预测(NSP,Next Sentence Prediction),两者联合训练模型。
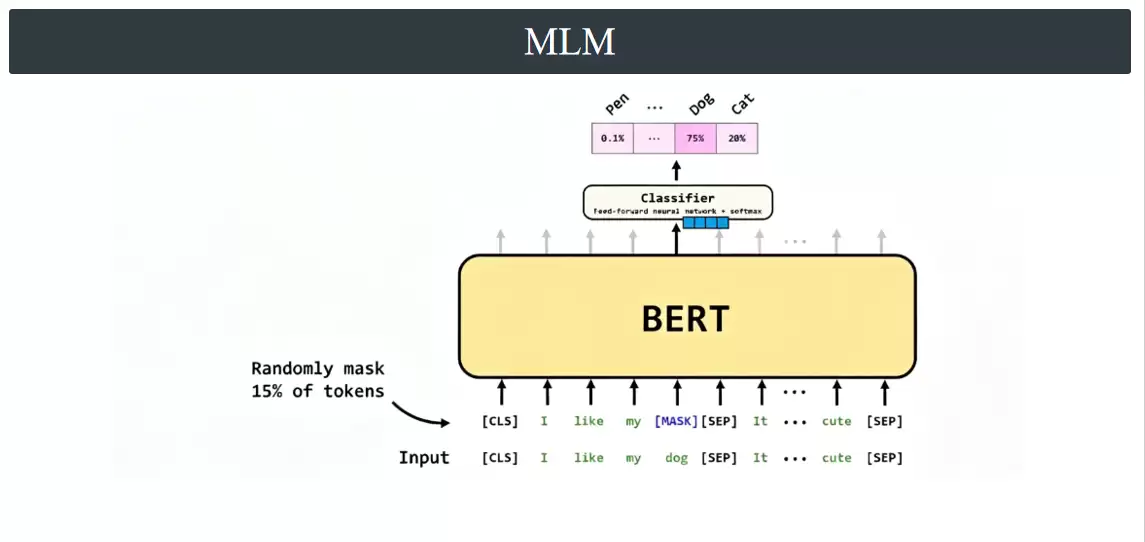
其中,MLM是双向语言建模任务:模型在输入文本中随机对部分Token进行掩码替换,让BERT根据上下文左右双向信息预测被掩码的原始词汇。这个任务让模型学习词语之间的语义关联、语法逻辑和上下文语义理解能力,是BERT实现双向深度语义建模的核心。
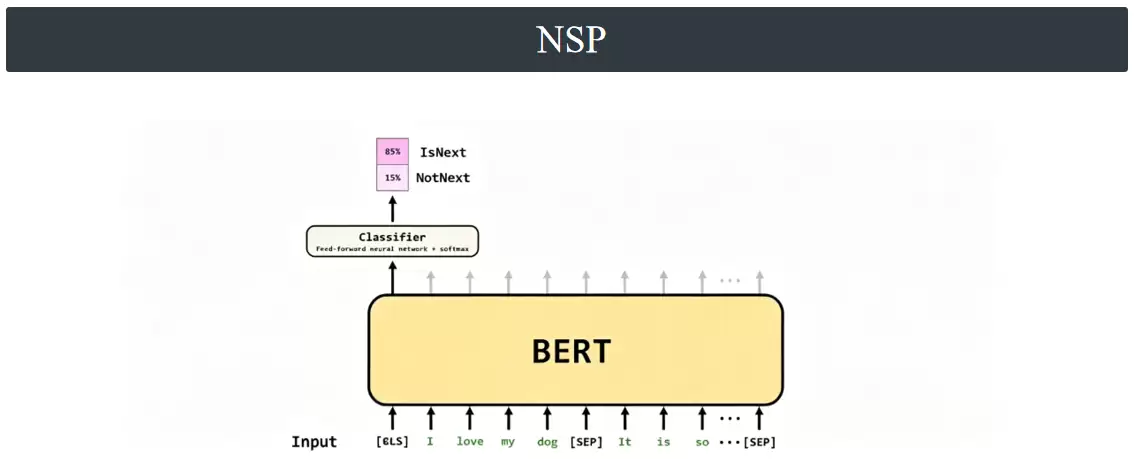
NSP任务则专门用于学习句子之间的关系与句间语义逻辑。模型输入成对句子,判断第二句是否为第一句在原文中连续的下一句,从而使模型具备句子级推理、句间连贯性理解能力,完美适配后续的问答、分类、句子匹配等下游任务。
先来深入理解MLM。在BERT预训练过程中,模型对输入的原始句子进行处理:随机挑选句子中15%的Token单词,用特殊标记[MASK]进行遮挡,隐藏原本的词汇。处理后的掩码句子序列输入BERT的多层Transformer编码器,经过多层编码器的特征计算与语义交互后,模型输出序列中每个单词的新的语义向量表示。这些输出向量融合了单词自身语义、上下文双向语义依赖、以及该单词与句子中其他所有单词之间的关联关系。之后模型基于这个深度向量,预测被[MASK]遮挡的原始单词。通过不断最小化预测损失,BERT学会利用上下文双向信息理解词义、语法和语义逻辑——这是BERT区别于单向语言模型的核心优势。
接着看NSP任务。假设构造一个训练样本:第一段话包含两个连续的句子,其中第二句在逻辑和语义上紧承第一句,构成正样本;第二段话也包含两个句子,但这两句之间没有连贯关系(例如从不同文档中随机抽取),构成负样本。在预训练阶段,BERT每次接收一个由两个句子组成的输入对(记为Sentence A和Sentence B),需要判断B是否为A的真实后续句子。
具体处理时,将这对句子按之前的方式拼接,在开头加入[CLS],句尾和句间加入[SEP]。整个序列送入BERT模型。经过多层Transformer编码后,仅取[CLS]位置对应的输出向量——因为BERT的设计让[CLS]的最终隐状态聚合了整个句对的全局信息。这个向量随后被送入一个全连接层,再经过Softmax函数,输出一个二分类概率:表示“是下一句”(IsNext)和“不是下一句”(NotNext)的可能性。通过最小化预测结果与真实标签之间的交叉熵损失,BERT学习句子间的连贯性关系,从而增强对篇章级别语义的理解能力。
微调任务
BERT在微调阶段可以适配多种不同类型的下游任务。以下是几个典型例子:
- 句子对分类(如NSP):判断两句话是否连贯。例如:“今天天气不错” + “我们去散步吧” → 是下一句。
- 单句分类(如情感分析):输入一条评论,输出情感极性。例如:“这家餐厅太难吃了” → 负向。
- 问答任务:给一个问题和一个包含答案的上下文,让BERT用两个指针标出答案的起始和结束位置。例如:问题“姚明在哪里出生?”、上下文“姚明出生于上海” → 答案起止为“上海”。
- 单句标注(序列标注):为每个单词打标签,如命名实体识别(NER)。例如:“马云在杭州创办了阿里巴巴” → 马云(人名)、杭州(地名)、阿里巴巴(机构名)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。