

百度千帆发布端到端文档智能模型Qianfan-OCR:4B参数,登顶OmniDocBench 3月19日,百度千帆正式推出了全新的端到端文档智能模型——Qianfan-OCR。这个模型有意思的地方在于,它基于统一的视觉语言架构,用4B的参数量就干了一整套活儿:从文档解析、版面分析,到文字识别和语义理
百度千帆发布Qianfan-OCR大模型:4B参数问鼎OmniDocBench评测
作者:技术拾光
时间:2026-05-09
浏览:337
文章目录
百度千帆发布端到端文档智能模型Qianfan-OCR:4B参数,登顶OmniDocBench
3月19日,百度千帆正式推出了全新的端到端文档智能模型——Qianfan-OCR。这个模型有意思的地方在于,它基于统一的视觉语言架构,用4B的参数量就干了一整套活儿:从文档解析、版面分析,到文字识别和语义理解,全部融合在了一个模型里。效果如何呢?多项权威测评的数据已经给出了答案,表现相当抢眼。
目前,开发者与企业用户已经可以在千帆平台上直接使用Qianfan-OCR。更开放的是,其模型权重也同步在HuggingFace上开源了,这为社区研究和应用落地提供了不小的便利。
那么,它的实际能力到底有多强?看看核心评测数据就清楚了。在综合文档理解评测OmniDocBench v1.5上,Qianfan-OCR拿下了93.12的高分,在端到端模型中稳稳排在第一位。在OCRBench的测试中,它的成绩更是大幅领先于同尺寸的通用视觉语言模型以及那些专门的OCR模型。即便是关键信息提取这类高难度任务,它在多个公开榜单的总分上也实现了超越,甚至压过了Google Gemini 3-Pro这样的顶尖商用模型。
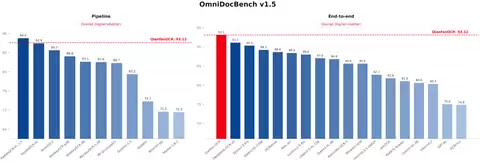
到了图表理解这类复杂场景,端到端架构的优势就被无限放大了。Qianfan-OCR在ChartQA、ChartBench等六项图表理解任务中,一举拿下了五项最佳成绩。这充分说明了它在结构理解和多模态推理方面,的确有独到之处。
说到这里,就不得不提传统的OCR技术路线。行业里普遍采用的还是“检测、识别、大语言模型理解”这种三段式的流水线架构。虽然这套流程已经很成熟,但问题也显而易见:多阶段串联就像一场接力赛,任何一棒的微小误差都会被不断放大。更重要的是,在把文本一块块提取出来的过程中,文档原本的空间布局、视觉上下文这些关键信息很容易丢失。结果就是,一旦碰到复杂的图表或者表格,传统方法的理解能力就有点捉襟见肘了。
Qianfan-OCR的突破,正是从底层架构上彻底重构了这个问题。它通过一个统一的端到端视觉语言模型,能够直接从文档图片生成结构化的理解结果。这意味着,从视觉信息输入到结构化信息输出,整个过程一气呵成,文档的原始视觉信息得到了完整保留。本质上,它实现了从“看见文档”到“理解文档”的一步跨越,这让它在处理需要高度一致性和准确性的结构理解任务时,显得更加游刃有余。
Qianfan-OCR在文档一体化理解上展现出的领先性,不仅是一个模型的成功,更清晰地验证了端到端技术路线的可行性与前瞻性。这或许标志着一个新的阶段正在开启:文档智能的核心能力,正在从过去的“多个流程拼接”,大步迈向“单一模型统一”的新纪元。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章