

本文详解如何使用原生JavaScript模拟浏览器innerHTML功能。通过将HTML字符串解析为DOM树,文章分三步实现:利用状态机进行词法分析生成Token流,通过栈结构进行语法分析建立父子关系,最后递归执行生成真实DOM节点。
引言与函数原型
浏览器与服务端通过纯文本的 HTTP 协议传输数据。当浏览器接收到 HTML 字符串后,需将其解析为真实的 DOM 元素,即生成 DOM Tree。基于对状态机概念的理解,本文旨在通过实践编写一个具备 innerHTML 功能的函数,以深入理解这一过程。
函数原型
我们将实现一个函数,接收 DOM 元素和 HTML 字符串作为参数。该函数的核心任务是将传入的 HTML 字符串转换为真实的 DOM 元素,并将其追加到指定的 DOM 元素中。
function html(element, htmlString) {
  // 1. 词法分析

  // 2. 语法分析

  // 3. 解释执行
}
如前文注释所述,该实现过程分为三个主要阶段:词法分析、语法分析和解释执行。
词法分析:状态机实现
词法分析
词法分析是核心且关键的一步,其具体任务是将字符流转换为 Token 流。
词法分析通常有两种实现方案:状态机或正则表达式,两者等效,可根据个人偏好选择。本文采用状态机方案。
首先需确定 Token 的种类。鉴于本文仅关注原理学习,无需具备浏览器那样强大的容错能力,因此暂不考虑容错处理,也不涉及自闭合节点、注释及 CDATA 节点等复杂情况。
接下来分析具体节点信息,确定需要拆分出的 Token 类型。
<p class="a" data="js">测试元素</p>基于上述节点信息,可拆分为以下 Token:
- 开始标签:<p
- 属性标签:class="a"
- 文本节点:测试元素
- 结束标签:</p>
状态机原理涉及遍历整个 HTML 字符串,每次读取一个字符并依据当前状态做出决策(确定下一个字符所属状态)。通过这一过程,可逐步生成完整的 Token 并记录到最终的 Tokens 集合中。
万事开头难,首先需确定初始状态,即定义 start 函数。在此之前,对词法分析类进行简单封装,具体实现如下:
function HTMLLexicalParser(htmlString, tokenHandler) {
  this.token = [];
  this.tokens = [];
  this.htmlString = htmlString
  this.tokenHandler = tokenHandler
}
对上述各属性进行简要解释:
- token:当前正在构建的 Token 字符序列
- tokens:存储已生成的完整 Token 集合
- htmlString:待处理的 HTML 字符串
- tokenHandler:Token 处理函数,每生成一个 Token 即可进行流式解析
显然,字符串要么以普通文本开头,要么以 < 字符开头。因此 start 函数的代码如下:
HTMLLexicalParser.prototype.start = function(c) {
  if(c === '<') {
    this.token.push(c)
    return this.tagState
  } else {
    return this.textState(c)
  }
}
start 函数处理逻辑较为简单:若遇到 < 字符,表示可能开始标签或结束标签,需读取下一个字符以确定具体 Token 类型,故返回 tagState 函数进行判断;否则视为文本节点,返回文本状态函数。
随后分别展开 tagState 和 textState 函数。tagState 根据下一个字符判断进入开始标签状态还是结束标签状态:若为 / 则表示结束标签,否则为开始标签。textState 用于处理文本节点字符,遇到 < 表示得到一个完整的文本节点 Token。代码如下:
HTMLLexicalParser.prototype.tagState = function(c) {
  this.token.push(c)
  if(c === '/') {
    return this.endTagState
  } else {
    return this.startTagState
  }
}
HTMLLexicalParser.prototype.textState = function(c) {
  if(c === '<') {
    this.emitToken('text', this.token.join(''))
    this.token = []
    return this.start(c)
  } else {
    this.token.push(c)
    return this.textState
  }
}
此处初次引入 emitToken、startTagState 和 endTagState 函数。
emitToken 用于将生成的完整 Token 存储到 tokens 中,参数包括 Token 类型和值。
startTagState 用于处理开始标签,包含三种情形:
- 若后续字符为字母,则认定仍处于开始标签状态
- 若遇到空格,则认定开始标签状态结束,接下来处理属性
- 若遇到 >,同样认定开始标签状态结束,接下来处理新的节点信息
- endTagState 用于处理结束标签,由于结束标签不包含属性,故仅包含两种情形:
- 若后续字符为字母,则认定仍处于结束标签状态
- 若遇到 >,同样认定结束标签状态结束,接下来处理新的节点信息
逻辑描述已较为清晰,代码实现也相对简单,此处略过详细代码展示。
HTMLLexicalParser.prototype.emitToken = function(type, value) {
  var res = {
    type,
    value
  }
  this.tokens.push(res)
  // 流式处理
  this.tokenHandler && this.tokenHandler(res)
}
HTMLLexicalParser.prototype.startTagState = function(c) {
  if(c.match(/[a-zA-Z]/)) {
    this.token.push(c.toLowerCase())
    return this.startTagState
  }
  if(c === ' ') {
    this.emitToken('startTag', this.token.join(''))
    this.token = []
    return this.attrState
  }
  if(c === '>') {
    this.emitToken('startTag', this.token.join(''))
    this.token = []
    return this.start
  }
}
HTMLLexicalParser.prototype.endTagState = function(c) {
  if(c.match(/[a-zA-Z]/)) {
    this.token.push(c.toLowerCase())
    return this.endTagState
  }
  if(c === '>') {
    this.token.push(c)
    this.emitToken('endTag', this.token.join(''))
    this.token = []
    return this.start
  }
}
最后需处理属性标签,即前述 attrState 函数,同样处理三种情形:
- 若遇到字母、单引号、双引号或等号,则认定仍处于属性标签状态
- 若遇到空格,则表示属性标签状态结束,接下来进入新的属性标签状态
- 若遇到 >,则认定属性标签状态结束,接下来开始处理新的节点信息
代码如下:
HTMLLexicalParser.prototype.attrState = function(c) {
  if(c.match(/[a-zA-Z'"=]/)) {
    this.token.push(c)
    return this.attrState
  }
  if(c === ' ') {
    this.emitToken('attr', this.token.join(''))
    this.token = []
    return this.attrState
  }
  if(c === '>') {
    this.emitToken('attr', this.token.join(''))
    this.token = []
    return this.start
  }
}
最后提供 parse 解析函数及 getOutPut 函数以获取结果,此处不再赘述,直接展示代码:
HTMLLexicalParser.prototype.parse = function() {
  var state = this.start;
  for(var c of this.htmlString.split('')) {
    state = state.bind(this)(c)
  }
}

HTMLLexicalParser.prototype.getOutPut = function() {
  return this.tokens
}
接下来进行简单测试,对于 <p class="a" data="js">测试并列元素的</p><p class="a" data="js">测试并列元素的</p> HTML 字符串,输出结果为:
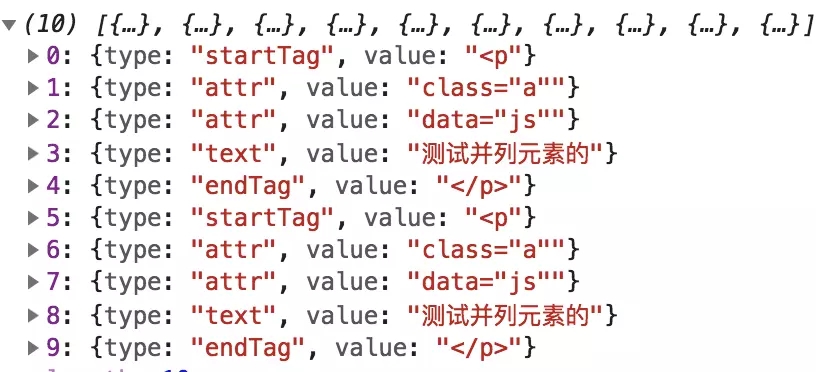
结果看起来不错,接下来进入语法分析步骤。
语法分析:栈结构构建DOM树
语法分析
首先需考虑两种情况:存在多个根元素或仅有一个根元素。
节点分为两种类型:文本节点和正常节点,因此需声明两个数据结构。
function Element(tagName) {
  this.tagName = tagName
  this.attr = {}
  this.childNodes = []
}

function Text(value) {
  this.value = value || ''
}
目标:建立元素间的父子关系,因为真实 DOM 结构即为父子关系。在初期实践中,我曾尝试将 childNodes 属性的处理放在 startTag Token 中,并为 Element 增加 isEnd 属性,这种做法不仅复杂化且难以实现。
仔细思考 DOM 结构,Token 具有顺序性,合理利用栈数据结构可使问题简化。将 childNodes 处理移至 endTag 中处理。具体逻辑如下:
- 若为 startTag Token,直接 push 一个新 element
- 若为 endTag Token,表示当前节点处理完成,此时出栈一个节点,同时将该节点归入栈顶元素节点的 childNodes 属性。此处需进行判断:若出栈后栈为空,表示整个节点处理完成,考虑到可能存在平行元素,将元素 push 到 stacks。
- 若为 attr Token,直接写入栈顶元素的 attr 属性
- 若为 text Token,由于文本节点的特殊性,不存在子节点或属性,故认定其处理完成。此处需进行判断:因为文本节点可能是根级别的,需判断是否存在栈顶元素,若存在则直接压入栈顶元素的 childNodes 属性,若不存在则 push 到 stacks。
代码如下:
function HTMLSyntacticalParser() {
  this.stack = []
  this.stacks = []
}
HTMLSyntacticalParser.prototype.getOutPut = function() {
  return this.stacks
}
// 一开始搞复杂了,合理利用基本数据结构真是一件很酷炫的事
HTMLSyntacticalParser.prototype.receiveInput = function(token) {
  var stack = this.stack
  if(token.type === 'startTag') {
    stack.push(new Element(token.value.substring(1)))
  } else if(token.type === 'attr') {
    var t = token.value.split('='), key = t[0], value = t[1].replace(/'|"/g, '')
    stack[stack.length - 1].attr[key] = value
  } else if(token.type === 'text') {
    if(stack.length) {
      stack[stack.length - 1].childNodes.push(new Text(token.value))
    } else {
      this.stacks.push(new Text(token.value))
    }
  } else if(token.type === 'endTag') {
    var parsedTag = stack.pop()
    if(stack.length) {
      stack[stack.length - 1].childNodes.push(parsedTag)
    } else {
      this.stacks.push(parsedTag)
    }
  }
}
简单测试如下:
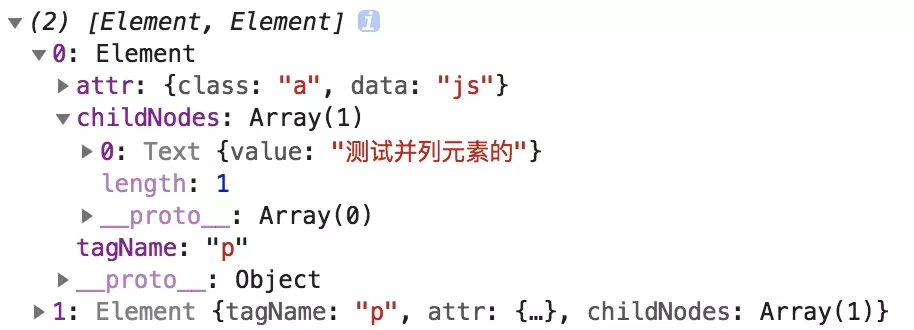
目前看来没有大问题。
解释执行:生成真实DOM
解释执行
上述语法分析的结果可理解为 vdom 结构,接下来需将其映射为真实 DOM。这一步相对简单,使用递归即可,直接展示代码:
function vdomToDom(array) {
  var res = []
  for(let item of array) {
    res.push(handleDom(item))
  }
  return res
}
function handleDom(item) {
  if(item instanceof Element) {
    var element = document.createElement(item.tagName)
    for(let key in item.attr) {
      element.setAttribute(key, item.attr[key])
    }
    if(item.childNodes.length) {
      for(let i = 0; i < item.childNodes.length; i++) {
        element.appendChild(handleDom(item.childNodes[i]))
      }
    }
    return element
  } else if(item instanceof Text) {
    return document.createTextNode(item.value)
  }
}
实现函数
完成上述三个步骤后,进入最后一步,即实现最初提出的函数。
function html(element, htmlString) {
  // parseHTML
  var syntacticalParser = new HTMLSyntacticalParser()
  var lexicalParser = new HTMLLexicalParser(htmlString, syntacticalParser.receiveInput.bind(syntacticalParser))
  lexicalParser.parse()
  var dom = vdomToDom(syntacticalParser.getOutPut())
  var fragment = document.createDocumentFragment()
  dom.forEach(item => {
    fragment.appendChild(item)
  })
  element.appendChild(fragment)
}
对三种不同情况的测试用例进行简单测试:
html(document.getElementById('app'), '<p class="a" data="js">测试并列元素的</p><p class="a" data="js">测试并列元素的</p>')
html(document.getElementById('app'), '测试<div>你好呀,我测试一下没有深层元素的</div>')
html(document.getElementById('app'), '<div class="div"><p class="p">测试一下嵌套很深的<span class="span">p的子元素</span></p><span>p同级别</span></div>')
声明:简单测试均无问题。本次实践旨在通过词法分析和语法分析生成 DOM Tree,从而对 DOM 相关原理有基本认识,因此细节问题仍可能存在。
总结与展望
总结
在了解原理后,编写此类代码并无太大难度,但令人兴奋的是有两个成果:
- 了解并初步实践了状态机
- 体会了数据结构的魅力
代码已基本列出,有兴趣运行的童鞋可 clone 此 repo:domtree
总结
以上所述是小编给大家介绍的用原生 JS 实现 innerHTML 功能实例详解,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!