

本文深入解析JavaScript的执行上下文(Execution Context)及其堆栈机制。详细阐述了全局代码、函数代码和Eval代码三种环境,解释了单线程同步执行模型下的堆栈操作。重点剖析了执行上下文创建的“创建阶段”与“激活/代码执行阶段”,包括变量对象(VO/AO)的构建过程、作用域链的形成以及this值的确定。通过实例解析了变量提升(Hoisting)的本质原因,澄清了函数声明与变量声明在预处理阶段的优先级差异,帮助开发者理解代码预处理的底层逻辑。
执行上下文概述
本文将深入剖析JavaScript的核心机制之一:执行上下文(Execution Context)。阅读完毕后,你将更清晰地理解解释器的工作方式,包括为何能在声明前调用某些函数或变量,以及这些值的确定过程。
什么是执行上下文?
JavaScript的执行环境至关重要。当代码执行时,会被预处理为以下三种类型之一:
- 全局代码(Global code):这是代码首次执行时的默认环境。
- 函数代码(Function code):每当执行流程进入函数体时触发。
- Eval代码(Eval code):用于在eval函数内执行的文本。
尽管网上有大量关于作用域的讨论,但为了便于理解,我们可以将“执行上下文”视为当前代码的运行环境或作用域。接下来,我们将通过一个包含全局和函数(局部)上下文的代码示例来具体说明。
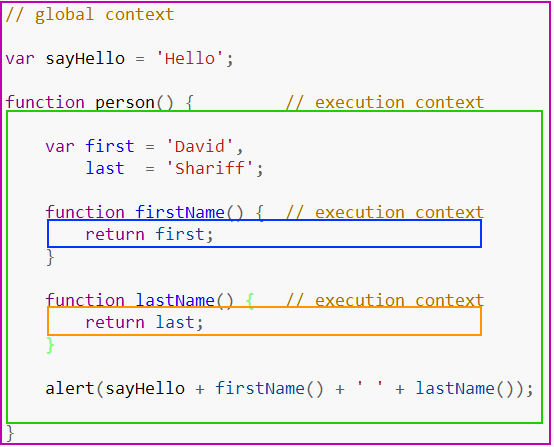
这里没有特殊之处,紫色边框代表全局上下文,而绿色、蓝色和橙色边框分别代表三个不同的函数上下文。整个程序中只能存在一个全局上下文,但可以从程序中的任何其他上下文访问它。
你可以拥有任意数量的函数上下文,每次函数调用都会创建一个新的上下文,从而形成一个私有作用域。这意味着当前函数作用域外无法直接访问函数内部声明的内容。在上面的示例中,函数可以访问其当前上下文之外声明的变量,但外部上下文无法访问在其中声明的变量或函数。为什么会这样?这段代码究竟是如何处理的?
执行上下文堆栈机制
执行上下文堆栈(Execution Context Stack)
浏览器中的JavaScript解释器被实现为单线程。这意味着在浏览器中一次只能执行一个任务,其他动作或事件会在所谓的执行堆栈中排队。下图展示了单线程堆栈的抽象视图:
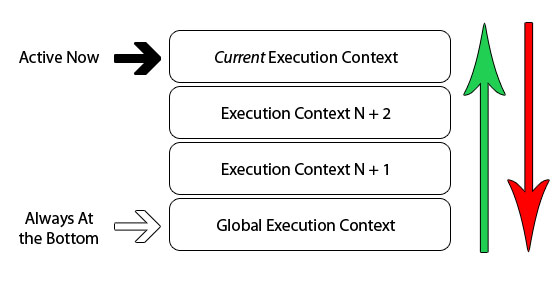
我们知道,当浏览器首次加载脚本时,默认进入全局上下文执行。如果在全局代码中调用函数,程序的顺序流会进入被调用的函数,创建新的执行上下文并将其推送到执行堆栈的顶部。
如果在当前函数中调用另一个函数,会发生同样的情况。代码的执行流程进入内部函数,该函数创建一个新的执行上下文,并将其推送到现有堆栈的顶部。浏览器始终执行位于堆栈顶部的当前执行上下文。一旦函数执行完当前上下文,它将从栈顶弹出,并将控制权返回到栈中的下一个上下文。下面的示例展示了递归函数和程序的执行堆栈:
(function foo(i) {
  if (i === 3) {
    return;
  }
  else {
    foo(++i);
  }
}(0));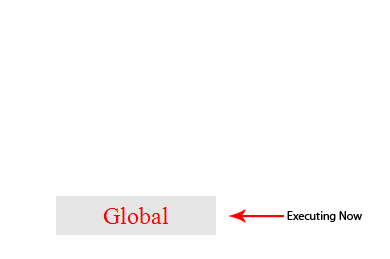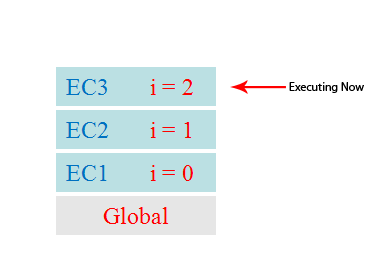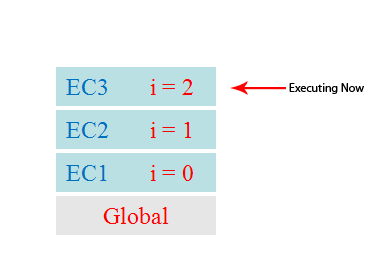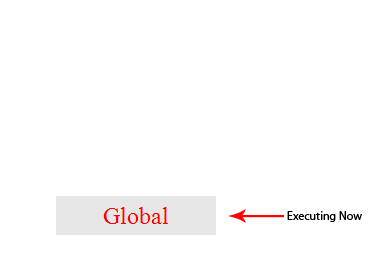
代码简单地调用自身3次,并将i的值递增1。每次调用函数foo时,都会创建一个新的执行上下文。一旦上下文完成执行,它就会弹出堆栈,并将控制权返回到它下面的上下文,直到再次达到全局上下文。
关于执行堆栈(execution stack)有5个关键要点:
- 单线程。
- 同步执行。
- 一个全局上下文。
- 任意多个函数上下文。
- 每个函数调用都会创建一个新的执行上下文(execution context),即使是对自身的调用。
执行上下文的创建与执行阶段
执行上下文的细节
现在我们知道每次调用一个函数时,都会创建一个新的执行上下文。但是,在JavaScript解释器中,对执行上下文的每次调用包含两个阶段:
创建阶段 [调用函数时,但在执行任何代码之前]:
- 创建作用域链。
- 创建变量、函数和参数。
- 确定“this”的值。
激活/代码执行阶段:
- 分配值、引用函数并解释/执行代码。
我们可以将每个执行上下文在概念上表示为具有3个属性的对象:
executionContextObj = {
  'scopeChain': { /* variableObject + 所有父执行上下文的variableObject */ },
  'variableObject': { /* 函数实参/形参,内部变量和函数声明 */ },
  'this': {}
}
激活对象/变量对象 [AO/VO]。
在调用该函数且实际执行函数之前,会创建这个executionContextObj。这被称为第1阶段,即创造阶段。此时解释器通过扫描函数传递的实参或形参、本地函数声明和局部变量声明来创建executionContextObj。此扫描的结果将成为executionContextObj中的variableObject。
以下是解释器如何预处理代码的伪代码概述:
1. 找到要调用的函数代码。
2. 在执行功能代码之前,创建执行上下文。
3. 进入创建阶段:
① 初始化作用域链。
② 创建variable object:
- 创建arguments object,检查参数的上下文,初始化名称和值并创建引用副本。
- 扫描上下文以获取函数声明:
- 对于找到的每个函数,在variable object中创建一个属性,该属性是函数的确切名称,该属性存在指向内存中函数的引用指针。
- 如果函数名已存在,则将覆盖引用指针值。
- 扫描上下文以获取变量声明:
- 对于找到的每个变量声明,在variable object中创建一个属性作为变量名称,并将该值初始化为undefined。
- 如果变量名称已存在于variable object中,则不执行任何操作并继续扫描。
③ 确定上下文中“this”的值。
4. 激活/执行阶段:
- 在上下文中运行/解释函数代码,并在代码逐行执行时分配变量值。
我们来看一个例子:
function foo(i) {
  var a = 'hello';
  var b = function privateB() {
  };
  function c() {
  }
}
foo(22);
在调用foo(22)时,创建阶段如下所示:
fooExecutionContext = {
  scopeChain: { ... },
  variableObject: {
    arguments: {
      0: 22,
      length: 1
    },
    i: 22,
    c: pointer to function c()
    a: undefined,
    b: undefined
  },
  this: { ... }
}
如你所见,创建阶段处理定义属性的名称,而不是为它们赋值,但正式的形参/实参除外。创建阶段完成后,执行流程进入函数,激活/代码执行阶段在函数执行完毕后如下所示:
fooExecutionContext = {
  scopeChain: { ... },
  variableObject: {
    arguments: {
      0: 22,
      length: 1
    },
    i: 22,
    c: pointer to function c()
    a: 'hello',
    b: pointer to function privateB()
  },
  this: { ... }
}
变量提升(Hoisting)原理解析
关于hoisting(变量提升)
你可以找到许多使用JavaScript定义术语hoisting的在线资源,解释变量和函数声明被hoisting到其函数范围的顶部。但是没有人能够详细解释为什么会发生这种情况,掌握了关于解释器如何创建激活对象的新知识,很容易理解为什么。请看下面的代码示例:
(function() {
  console.log(typeof foo); // function pointer
  console.log(typeof bar); // undefined
  var foo = 'hello',
    bar = function() {
      return 'world';
    };
  function foo() {
    return 'hello';
  }
}());
我们现在可以回答的问题是:
为什么我们可以在声明foo之前就能访问?
- 如果我们理解了创建阶段,就知道在激活/代码执行阶段之前已经创建了变量。因此,当函数流开始执行时,已经在激活对象中定义了foo。
Foo被声明两次,为什么foo显示为function而不是undefined或string?
- 即使foo被声明两次,我们通过创建阶段知道函数在变量之前就被创建在激活对象上了,而且如果激活对象上已经存在了属性名称,我们只是绕过了声明这一步骤。
- 因此,首先在激活对象上创建对函数foo()的引用,并且当解释器到达var foo时,我们已经看到属性名称foo存在,因此代码不执行任何操作并继续处理。
为什么bar未定义?
- bar实际上是一个具有函数赋值的变量,我们知道变量是在创建阶段被创建的,但它们是使用undefined值初始化的。
希望到这里你已经能够很好地掌握了JavaScript解释器如何预处理你的代码。理解执行上下文和堆栈可以让你了解背后的原因:为什么代码预处理后的值和你预期的不一样。
你认为学习解释器的内部工作原理是多此一举还是非常必要的呢?了解执行上下文阶段是否能够帮你写出更好的JavaScript呢?
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。如果你想了解更多相关内容请查看下面相关链接