
深入讲解如何在JavaScript中准确将CSV字符串解析为二维数组与对象数组。通过辨析朴素切分的边界缺陷,实现零依赖、高吞吐的RFC 4180规范微型状态机,并攻克BOM头、转义引号和跨行字段等边缘陷阱。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS解析CSV字符串为数组的实战技巧
作者:纸飞机
时间:2026-11-03
浏览:638
文章目录
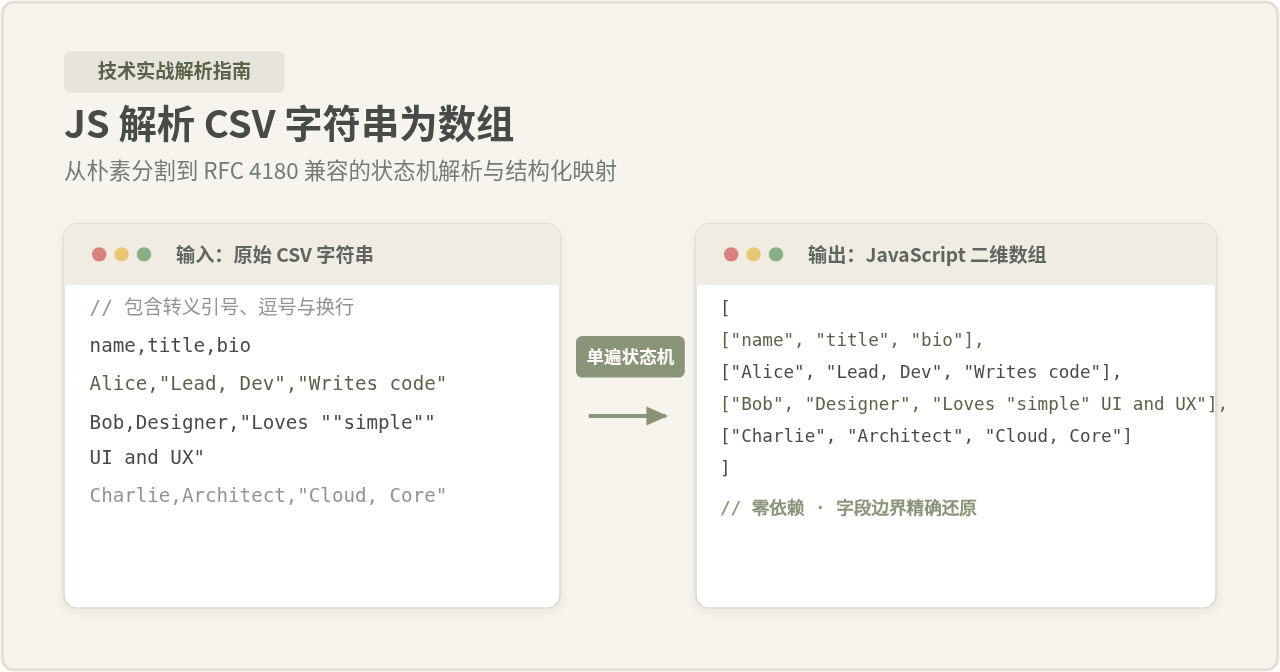
在 JavaScript 前端或 Node.js 环境中解析 CSV 字符串,最直接的目标是将其转换成结构统一的二维数组
string[][] 或以表头为键的对象数组 Record<string, string>[]。很多开发者习惯调用 str.split('
') 与 row.split(','),但在遇到包含逗号的单元格、连续转义双引号以及跨行文本时,朴素分割会导致列错位和行断裂。本文将从边界场景的实质破绽讲起,实现一套零外部依赖、兼容 RFC 4180 规范的字符流状态机解析器,并系统解决 BOM 字符、混合换行及类型转换等关键工程问题。
一、朴素 split 方案的有效边界与常见破绽
在很多入门示例中,解析 CSV 往往被写成一行链式调用:text.trim().split('
').map(r => r.split(','))。这种写法非常轻巧,在特定场景下确实能够工作。了解它的成立条件是写出健壮代码的第一步。
1. 朴素方案何时成立?
如果数据的生成端完全受你的代码控制,且满足以下三个严格前提,使用 split 是没有问题的:
- 无复合内容:所有字段仅包含单纯的数字、字母、布尔值或普通文本,绝无逗号(如千分位
"1,000"或地点"Beijing, China")。 - 无多行换行:单元格内容不允许换行,换行符严格代表新行记录的开始。
- 无双引号包裹与转义:数据源没有遵循标准用成对双引号包裹字段,也不存在
""转义引号。
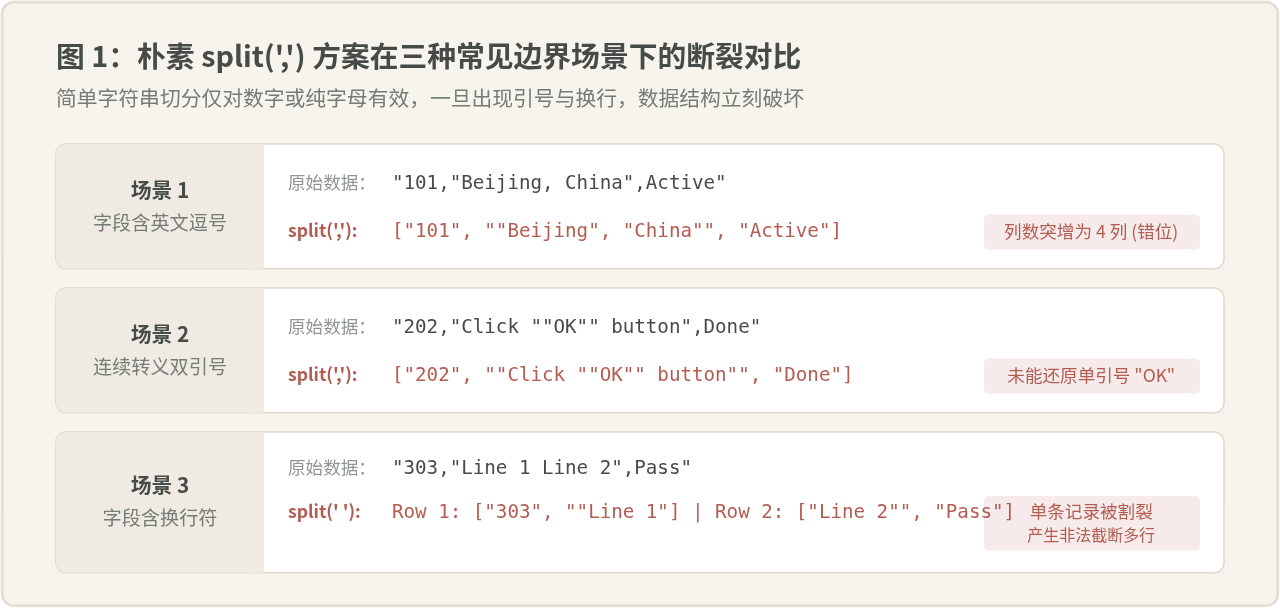
2. 真实场景下的三个致命断裂点
一旦 CSV 来自用户的 Excel 导出、外部系统接口或含有自由文本(备注、地址、长标题),split 机制就会立刻产生静默损坏(Silent Corruption):
- 字段内逗号导致列错位:当字段形如
"Shenzhen, Guangdong"时,split(',')会直接将其割裂为两个字段,导致后续列全部右移,破坏整行的对齐逻辑。 - 转义双引号未还原:RFC 4180 规定,若字段本身含有双引号,需使用两个连续双引号表示(例如
"""OK""")。split无法识别这种语法,字符串中会残留多余的外层引号与转义符。 - 字段内跨行导致整条记录被切断:用户在输入框内输入的带有
split('
')
会机械地将这一行记录强行切成两条完全残缺的非法行。
二、核心实现:基于单遍扫描的状态机解析器
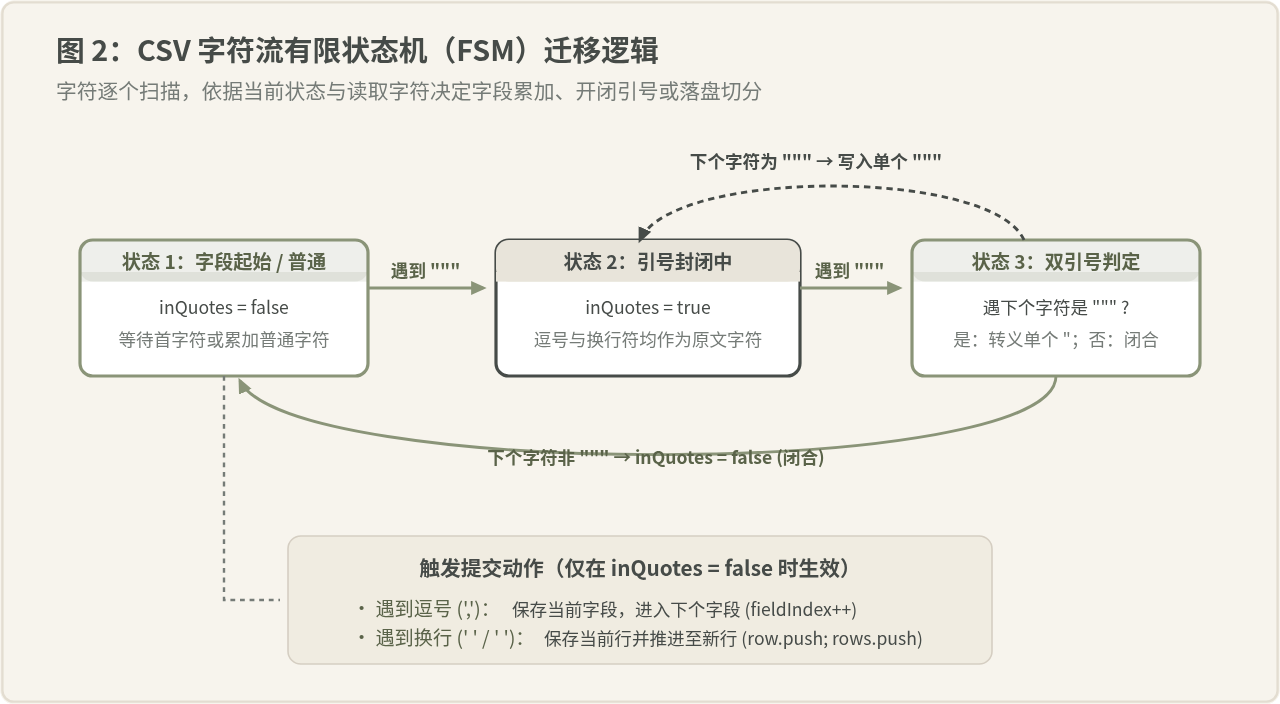
解决上述问题的核心思路并非堆砌更复杂的正则表达式,而是采用有限状态机(Finite State Machine, FSM)。因为 CSV 格式的语法具有典型的上下文依赖:字符是否应该被当成分隔符,完全取决于当前是否处在双引号的包裹范围内。
1. 状态转移原理
在单遍遍历字符串时,解析器只需维护几个基础游标和布尔标记:
inQuotes:当前是否处于成对双引号所界定的字段内部。若为true,所有的逗号和换行符都仅作为当前字段的普通字符被累加,绝不触发分列或换行。- 双引号探测:在
inQuotes为true时遇到双引号字符",我们预读下一个字符。如果是另一个",说明这是转义的单引号,将单个"写入当前字段并跳过下一字符;如果下一个字符不是",说明引号已经闭合,将inQuotes置为false。 - 分隔符与换行:仅当
inQuotes === false时,遇到逗号触发字段提交,遇到
2. 生产级零依赖 parseCSV 函数
以下是完整的 JavaScript 原生函数实现。时间复杂度为精确的 $O(N)$,且无需任何外部 npm 依赖,在现代浏览器及 Node.js 均可直接执行:
/**
 * 严格按照 RFC 4180 规范解析 CSV 字符串为二维数组
 * @param {string} text 原始 CSV 文本
 * @param {string} delimiter 分隔符,默认为英文逗号 ','
 * @returns {string[][]} 二维字符串数组
 */
function parseCSV(text, delimiter = ',') {
  if (!text || typeof text !== 'string') {
    return [];
  }

  // 1. 过滤开头的 UTF-8 BOM 字符
  if (text.charCodeAt(0) === 0xFEFF) {
    text = text.slice(1);
  }

  const rows = [];
  let currentRow = [];
  let currentField = '';
  let inQuotes = false;
  const len = text.length;

  for (let i = 0; i < len; i++) {
    const char = text[i];

    if (inQuotes) {
      if (char === '"') {
        // 遇到连续双引号转义:"" -> "
        if (i + 1 < len && text[i + 1] === '"') {
          currentField += '"';
          i++; // 跳过转义的第二个引号
        } else {
          // 引号闭合
          inQuotes = false;
        }
      } else {
        // 引号内的所有字符(包括换行、逗号)均作为字段原生文本累加
        currentField += char;
      }
    } else {
      if (char === '"') {
        // 字段内开启引号包裹
        inQuotes = true;
      } else if (char === delimiter) {
        // 遇到分隔符,提交当前字段
        currentRow.push(currentField);
        currentField = '';
      } else if (char === '\r') {
        // 处理 CRLF 换行
        if (i + 1 < len && text[i + 1] === '\n') {
          i++;
        }
        currentRow.push(currentField);
        rows.push(currentRow);
        currentRow = [];
        currentField = '';
      } else if (char === '\n') {
        // 处理单个 LF 换行
        currentRow.push(currentField);
        rows.push(currentRow);
        currentRow = [];
        currentField = '';
      } else {
        // 普通字符
        currentField += char;
      }
    }
  }

  // 收尾:将最后一个字段及行压入结果
  if (currentField !== '' || currentRow.length > 0) {
    currentRow.push(currentField);
    rows.push(currentRow);
  }

  // 过滤尾部可能存在的全空行(例如以回车结尾的文件)
  if (rows.length > 0) {
    const lastRow = rows[rows.length - 1];
    if (lastRow.length === 1 && lastRow[0].trim() === '') {
      rows.pop();
    }
  }

  return rows;
}
代码解析提示:注意
i++ 的用法。当在引号内部连续检测到两个 "" 时,我们手动将循环计数器递增一位,从而保证在常数时间内吃掉转义字符,不产生多余的条件嵌套。
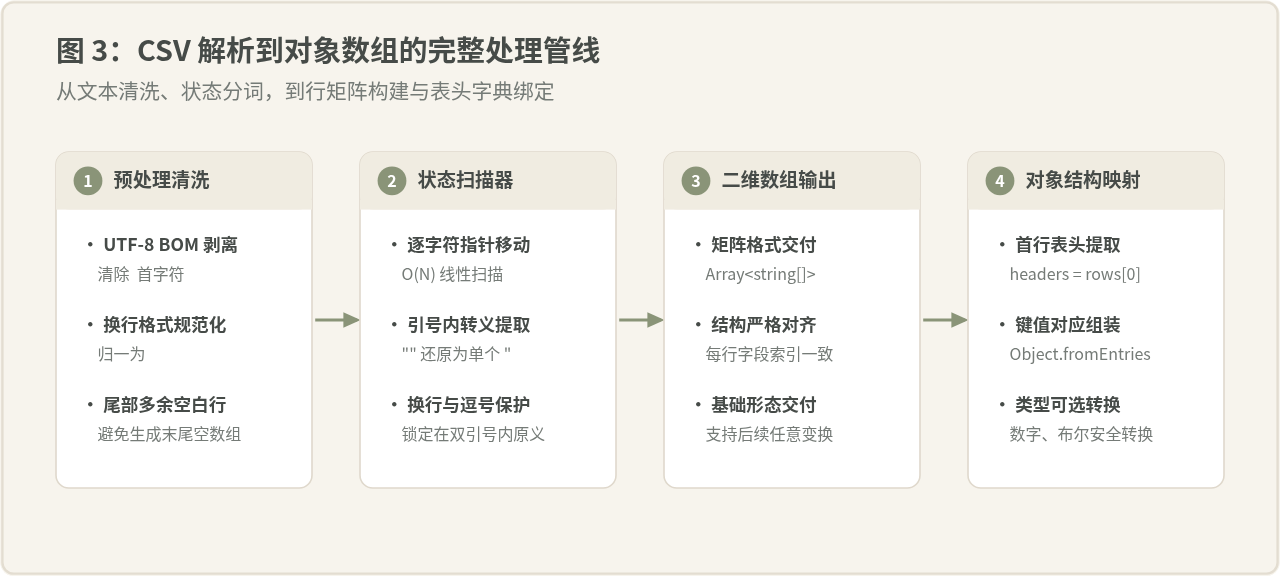
三、进阶:将二维数组转换为强结构的对象数组
在前端业务组件(如表格组件 el-table、Ant Design Table)中,通常需要对象数组 Array<Record<string, any>> 才能更直观地按照键名渲染。
1. 映射函数实现
基于前面写好的 parseCSV,我们可以快速封装一个将第一行作为 Key 的转换工具:
/**
 * 将 CSV 字符串解析为以首行为字段名的对象数组
 * @param {string} text 原始 CSV 文本
 * @param {object} options 配置参数
 * @param {string} [options.delimiter=','] 分隔符
 * @param {boolean} [options.trimHeaders=true] 是否自动修剪表头两端空格
 * @param {boolean} [options.autoType=false] 是否尝试自动将数字和布尔值转换类型
 * @returns {Record<string, any>[]} 对象数组
 */
function csvToObjects(text, options = {}) {
  const {
    delimiter = ',',
    trimHeaders = true,
    autoType = false
  } = options;

  const matrix = parseCSV(text, delimiter);
  if (matrix.length < 2) {
    return []; // 无数据或仅有表头行
  }

  // 提取并清洗首行表头
  const rawHeaders = matrix[0];
  const headers = rawHeaders.map((h, idx) => {
    let name = trimHeaders ? h.trim() : h;
    // 容错:处理空表头列
    return name || `__column_${idx + 1}`;
  });

  const result = [];

  for (let r = 1; r < matrix.length; r++) {
    const row = matrix[r];
    // 忽略与表头长度不符的完全空行
    if (row.length === 1 && !row[0].trim()) continue;

    const rowObj = {};
    for (let c = 0; c < headers.length; c++) {
      const key = headers[c];
      let val = row[c] !== undefined ? row[c] : '';

      if (autoType && val !== '') {
        val = coerceType(val);
      }
      rowObj[key] = val;
    }
    result.push(rowObj);
  }

  return result;
}

// 类型安全转换辅助函数
function coerceType(val) {
  if (val === 'true') return true;
  if (val === 'false') return false;
  if (val === 'null') return null;
  // 仅在完全由合法数字组成时才转换(排除含前导0的纯数字编码,如邮编、手机号)
  if (!isNaN(Number(val)) && !/^\s*0\d+/.test(val)) {
    return Number(val);
  }
  return val;
}
四、生产环境必须解决的五个边缘陷阱
在实际项目中,解析器崩溃或数据污染往往不是因为算法复杂度,而是由文件编码和各操作系统差异引发的“暗坑”。以下列出最容易出现的五个边缘细节:
1. UTF-8 BOM 导致首个表头字段匹配失败
Windows 记事本或早期 Excel 保存的 UTF-8 CSV 文件常会在文件头部附加 3 字节的字节顺序标记(BOM,0xEF, 0xBB, 0xBF,在 JS 字符串中对应 )。如果不做剔除,首个表头名称就会变成 id,导致代码读取 item.id 时始终得到 undefined。
做法:在函数入口先判断 if (text.charCodeAt(0) === 0xFEFF) text = text.slice(1);。
2. 混合换行符(CRLF 与 LF)
Windows 系统导出使用
,Unix/Linux/macOS 使用
,旧版 Mac 使用 。代码不能只依赖单个
判断换行,否则字段末尾会残留不可见的 字符,导致控制台打印混乱或比较相等时失败。
3. 空行与文件末尾的回车符
大多数合规的 CSV 导出工具会在最后一行数据写完后追加一个换行符。如果不做边界保护,单遍解析器会在最后额外压入一个 [""]。解析器必须在输出前剔除这个空行。
4. 连续逗号代表空字段
当出现 Alice,,28 时,中间的字段代表空字符串 ""。状态机在遇到连续逗号时会正确向数组压入空字符串,而某些不严谨的正则分割可能会意外跳过它。
5. 长数字与文本保护(例如身份证、订单编号)
自动类型推断(Auto-typing)是一把双刃剑。如果遇到形如 "012345"(邮政编码)或 "123456789012345678"(18位身份证号)时,若直接使用 Number() 转换,不仅会丢失前导 0,还会因为超出 JavaScript 的 Number.MAX_SAFE_INTEGER($2^{53} - 1$)而发生精度丢失。在业务中,应默认将字段保留为字符串,仅对明确需要计算的数值列进行转换。
五、自研轻量实现 vs 成熟开源库选型决策
在实际技术选型中,很多开发者会纠结:到底该直接使用上面的轻量状态机函数,还是引入体积较大的成熟开源库?
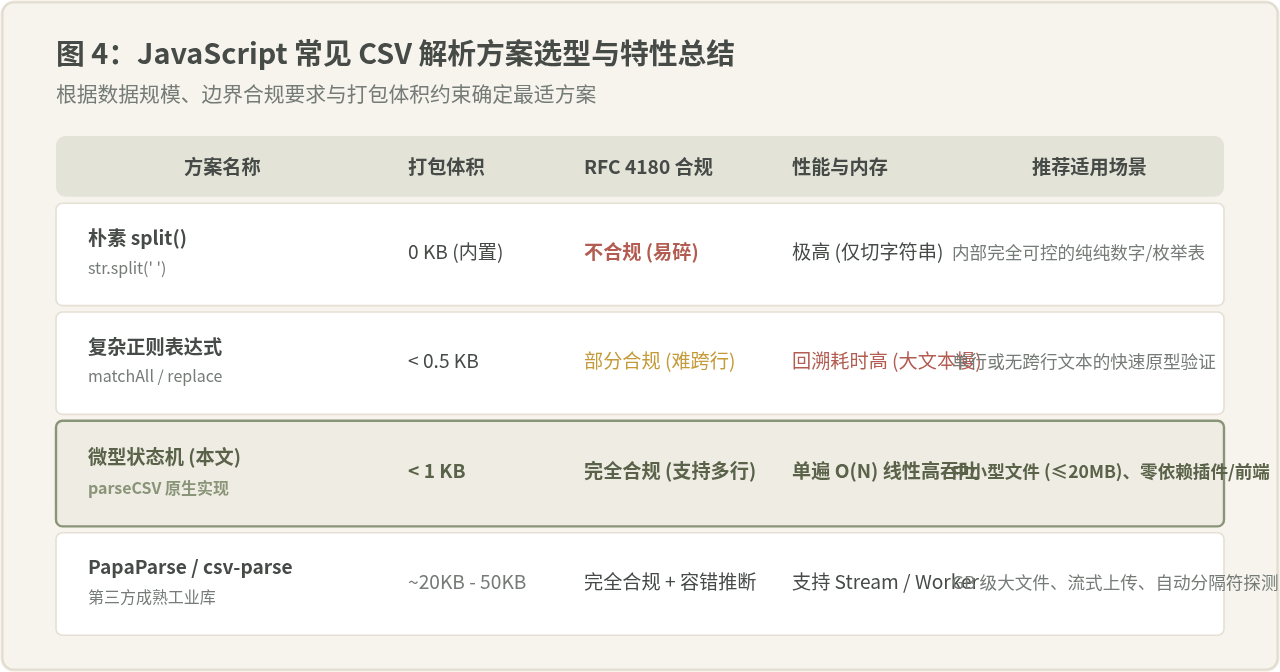
1. 选用自研轻量状态机(本文方案)的场景
- 体积极其敏感的场景:前端 SDK、浏览器扩展插件、移动端 H5 或轻量 Serverless 函数中,对打包体积有严格限制,几百字节的纯函数毫无额外包袱。
- 中小型常规数据文件:文件体积通常在几十 KB 到 20MB 以内,内存单次解析耗时均在毫秒级,直接在主线程同步解析完全足够。
- 完全可控的内聚模块:不希望为了一个简单的导入功能在
package.json中引入庞大的第三方依赖树。
2. 必须选用工业级第三方库(如 PapaParse、csv-parse)的场景
- 超大文件流式读取:文件大小达到数百兆甚至数吉字节(GB),此时无法将整个文件一次性读入为单个字符串,必须结合
ReadableStream或 Web Worker 进行分块解析。 - 不规则或损坏格式的容错探测:例如未知分隔符(分号
;、制表符
六、总结
在 JavaScript 中解析 CSV 并不需要动辄引入庞大的第三方库,但也绝不能依赖脆弱的 split。通过理解 RFC 4180 的状态转移本质,采用单遍扫描的有限状态机模型,仅用几十行代码就能实现完整还原引号转义、跨行文本以及容错清洗的健壮解析器。在实际开发中,再针对 BOM 字符、换行符差异以及长数字精度进行针对性处理,即可轻松应对绝大多数生产级别的数据解析需求。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章