
深入解析 JavaScript 中二维及多维数组的正确生成方法,剖析 new Array().fill([]) 共享引用的底层陷阱,提供 Array.from、双层 for 循环、递归通用函数及 TypedArray 扁平化映射等实战解决方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript 中怎么正确生成二维或多维数组
作者:纸飞机
时间:2026-11-03
浏览:399
文章目录
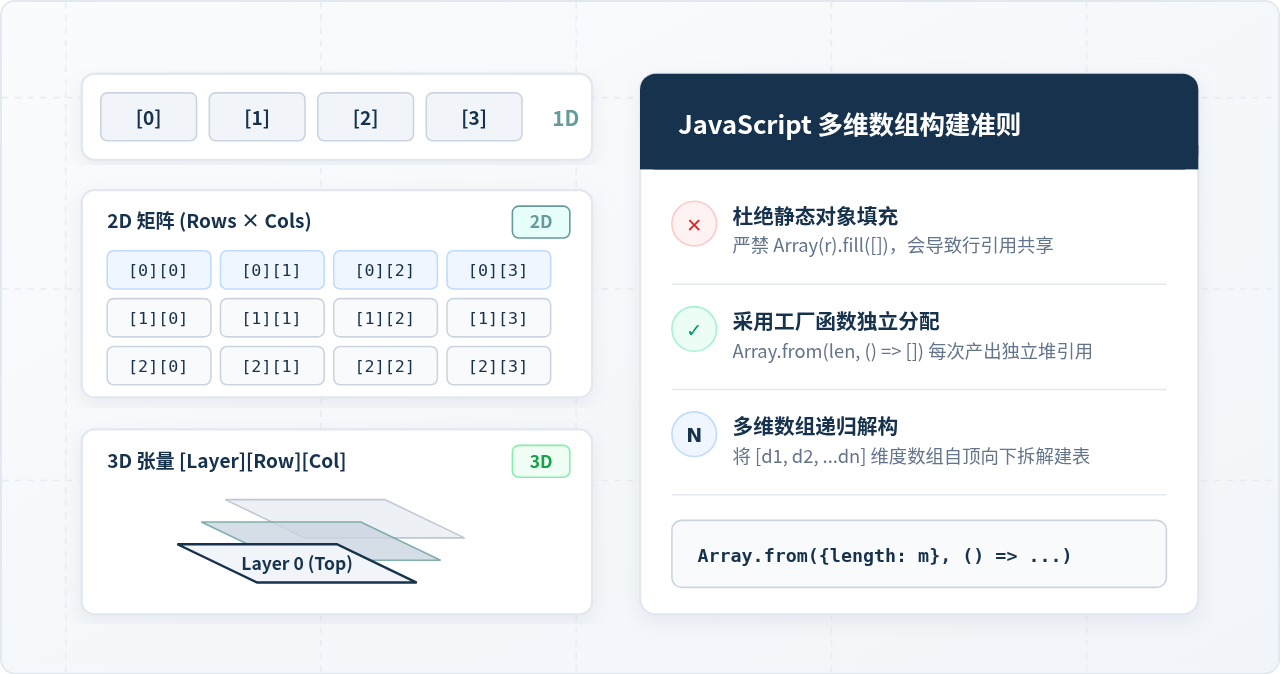
在 JavaScript 中生成二维或多维数组的核心答案是:必须保证内层的每一个子数组都由独立的工厂函数单独实例化,绝不能使用静态引用的方式直接填充。最推荐的现代标准做法是使用 Array.from({ length: rows }, () => new Array(cols).fill(initialValue));对于高性能密集计算,采用显式预分配的双层 for 循环;对于三维及更高维度的复杂矩阵,则通过递归函数逐层展开降维构建。本文将直奔核心问题,首先剖析最容易导致线上事故的引用共享陷阱,继而提供完整可靠的标准方案与工程实践指南。
一、致命陷阱:为什么 fill([]) 会让整张二维表“牵一发而动全身”
很多开发者在初次尝试生成一个 3 × 3 的二维数组时,往往会凭直觉写出如下代码:
// ⚠️ 极其隐蔽的经典错误写法
const rows = 3;
const cols = 3;
const matrix = new Array(rows).fill(new Array(cols).fill(0));

// 尝试修改第 0 行第 0 列的值
matrix[0][0] = 99;

console.log(matrix);
// 输出结果并不是仅修改了 [0][0],而是所有行的第 0 列全变成了 99!
// [
//   [99, 0, 0],
//   [99, 0, 0],
//   [99, 0, 0]
// ]
这种现象在业务中往往导致难以排查的状态联动 Bug。产生这一问题的底层原因在于 JavaScript 引擎对引用类型(Reference Types)的处理机制:
当执行 new Array(cols).fill(0) 时,JavaScript 引擎在堆内存(Heap)中分配了一个数组实例,并返回了该实例的内存地址指针(例如 0x1A01)。接着,外层的 .fill(...) 方法被执行,该方法的作用是将传入的实参值浅拷贝并填入外层数组的每一个槽位。因此,外层数组的 matrix[0]、matrix[1] 和 matrix[2] 存储的全部是同一个内存地址指针 0x1A01。
陷阱本质:
Array.prototype.fill(value) 是以传值(Pass-by-value)方式接收参数的。在 JavaScript 中,对象的“值”就是其内存引用地址。fill 只会在调用前对参数求值一次,而不会在每次填充每个槽位时重复执行创建逻辑。
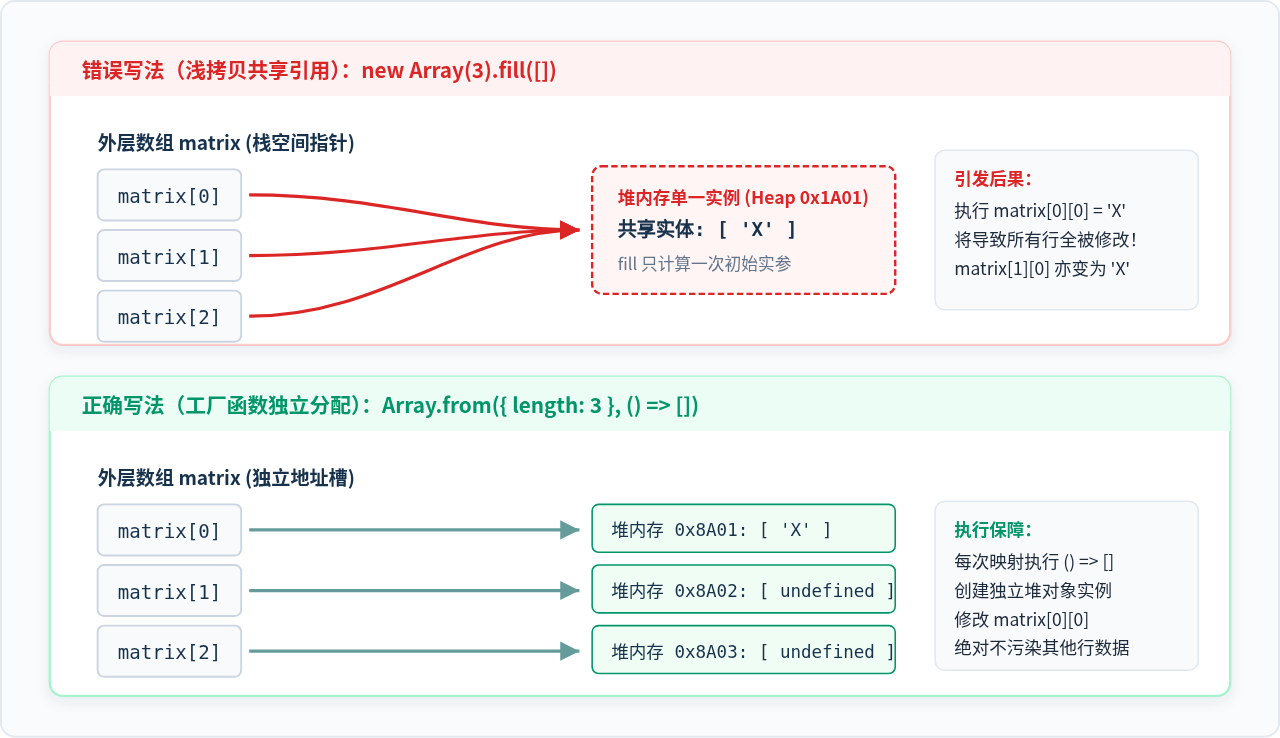
要打破这种共享引用,核心原则是:每一次为行分配子数组时,都必须调用一次独立的构造逻辑,确保每一个槽位获取到的都是通过 new 或数组字面量新创建的堆对象。
二、二维数组的标准生成姿势与现代写法
在日常业务开发中,生成二维数组需要兼顾代码可读性、执行效率以及内存安全性。根据具体业务场景,推荐以下两种标准实现姿势:
1. 首选方案:Array.from 配合工厂映射(现代标准)
ES6 引入的 Array.from() 接收第二个参数作为映射回调函数(Mapping Function)。该回调函数会在初始化外层数组的每个槽位时被依次调用,从而天然具备了“工厂函数”的特性:
/**
 * 生成独立的 M × N 二维数组(填充基础类型初值)
 * @param {number} rows 行数
 * @param {number} cols 列数
 * @param {any} initialValue 初始值(基础类型:数字、布尔、字符串等)
 */
function createMatrix(rows, cols, initialValue = 0) {
  return Array.from({ length: rows }, () => new Array(cols).fill(initialValue));
}

// 测试验证
const grid = createMatrix(3, 4, 0);
grid[0][0] = 7;

console.log(grid[0]); // [7, 0, 0, 0]
console.log(grid[1]); // [0, 0, 0, 0] —— 完全独立,未受污染!
为什么内层的
因为对于
.fill(initialValue) 在这里是安全的?因为对于
number、string、boolean、null、undefined 等基础数据类型(Primitive Types),它们在内存中按值传递,并不存在堆对象引用的问题。只要外层的每一行是独立的,内层填充基础类型值就是绝对安全的。但如果 initialValue 是一个对象(如 {}),内层同样必须使用 () => ({}) 工厂函数进行隔离。
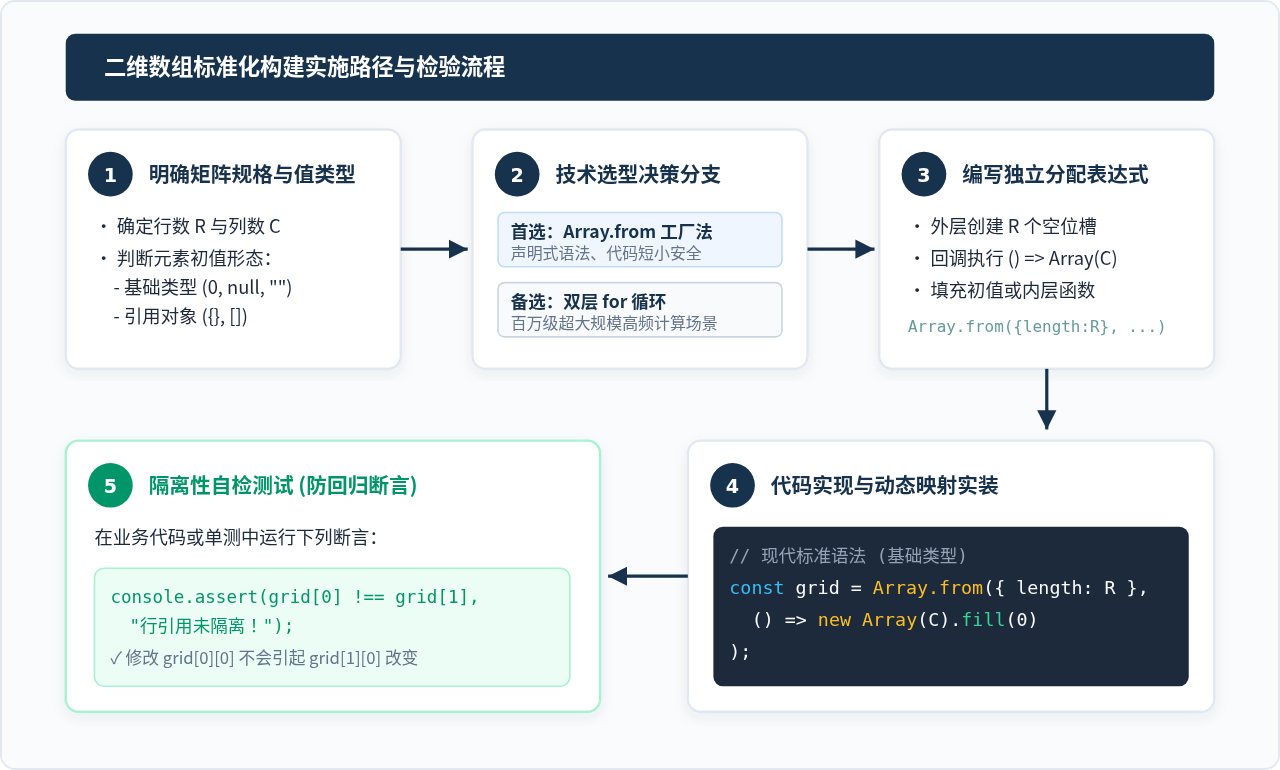
2. 备选方案:经典的预分配双层 for 循环(极致性能场景)
在算法刷题(如 LeetCode 动态规划、图论搜索)或高频实时渲染场景下,函数调用的开销(Function Call Overhead)会成倍放大。此时,显式使用双层 for 循环不仅逻辑直观,而且在现代 V8 引擎中能够获得极佳的 JIT 优化与向量化执行速度:
function createMatrixFast(rows, cols, initialValue = 0) {
  // 显式声明外层定长数组
  const matrix = new Array(rows);
  for (let i = 0; i < rows; i++) {
    const row = new Array(cols);
    for (let j = 0; j < cols; j++) {
      row[j] = initialValue;
    }
    matrix[i] = row;
  }
  return matrix;
}
在涉及十万乃至百万级元素的大矩阵初始化测试中,双层 for 循环由于避免了多次闭包分配与迭代器协议调用,其吞吐效率通常比 Array.from 高出 2 到 4 倍。因此,面对计算密集型任务时,双层 for 循环依然是最佳选择。
三、从二维迈向任意 N 维:通用的递归生成函数
在游戏开发(如 3D 体素地图)、多维动态规划或科学计算中,经常需要动态生成三维乃至任意多维的张量结构(例如 [depth][row][col])。手动编写三重或四重循环不仅繁杂易错,且无法适应运行时动态传入的维度参数。
处理多维结构的最优思维模型是递归降维(Recursive Dimensionality Reduction):将维度数组 [d1, d2, ...dn] 视为由“长度为 d1 的外层数组”包含“[d2, ...dn] 的子维度数组”构成。当维度列表仅剩下最后一个维度时,触发基底条件(Base Case),直接产出包含最终初值的一维数组并逐层回溯装配。
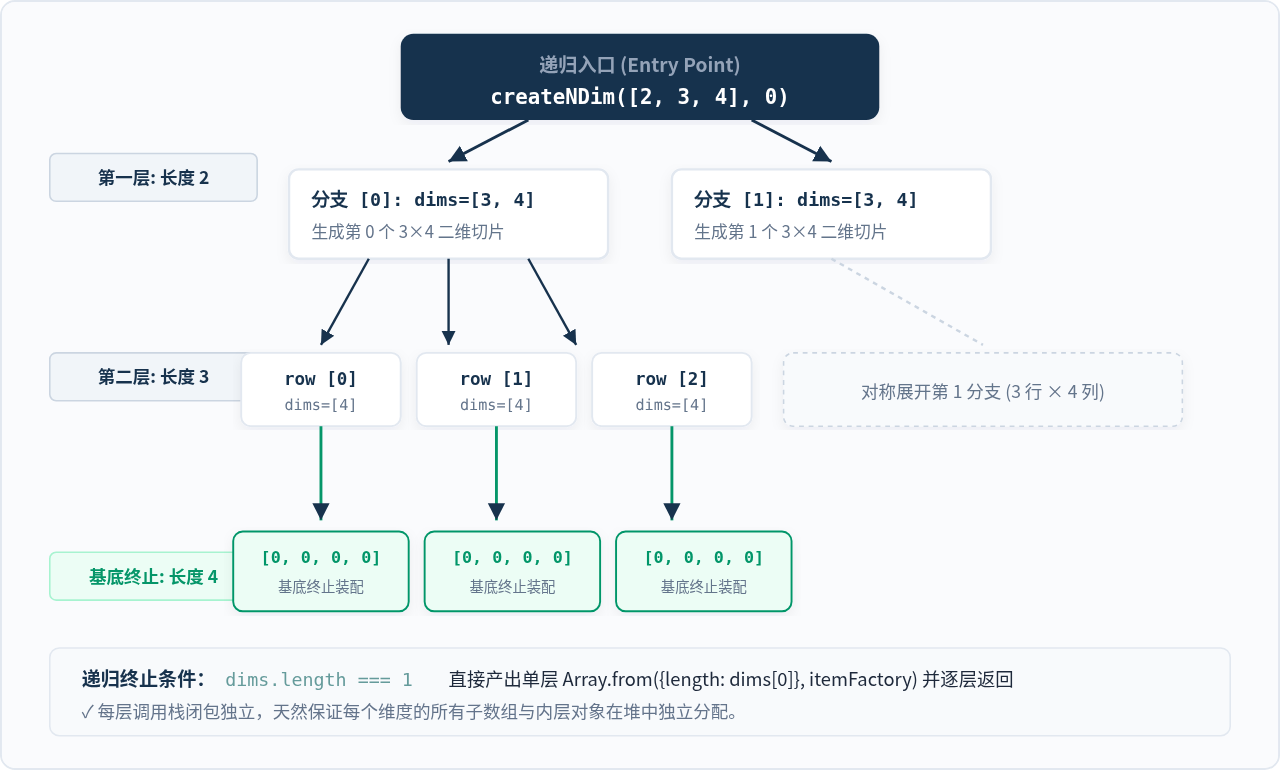
下面给出工程级的通用多维数组生成函数。该函数支持直接传入初值,或传入动态工厂函数(避免如果初值为引用对象再次踩坑):
/**
 * 通用多维数组生成器(支持任意维度与动态初值工厂)
 * @param {number[]} dimensions 维度尺寸数组,例如 [2, 3, 4] 表示 2×3×4 的三维数组
 * @param {any | Function} initValOrFactory 默认填充值或生成值的回调函数
 * @returns {Array} 构造完成的多维数组
 */
function createNDimArray(dimensions, initValOrFactory = 0) {
  if (!Array.isArray(dimensions) || dimensions.length === 0) {
    throw new TypeError("dimensions 必须是非空的数字数组");
  }

  // 内部递归求解器
  function buildLayer(dimIndex) {
    const currentDim = dimensions[dimIndex];

    // 基底条件:到达最底层叶子维度
    if (dimIndex === dimensions.length - 1) {
      return Array.from({ length: currentDim }, (_, i) => {
        // 如果提供了工厂函数,则将各维度坐标透传,便于动态生成位置标识
        return typeof initValOrFactory === "function"
          ? initValOrFactory()
          : initValOrFactory;
      });
    }

    // 递推步骤:递归构建下一层子数组
    return Array.from({ length: currentDim }, () => buildLayer(dimIndex + 1));
  }

  return buildLayer(0);
}

// 实战应用:创建一个 2 × 3 × 4 的三维空间张量
const tensor = createNDimArray([2, 3, 4], 0);

// 单点修改验证
tensor[0][1][2] = 888;

console.log(tensor[0][1][2]); // 888
console.log(tensor[1][1][2]); // 0 —— 兄弟维度完全隔离,验证成功!
四、工程实践中的进阶场景与性能权衡
1. 警惕“空洞数组”(Sparse Arrays)导致的 map() 失效
在构建数组时,另一个容易让初学者困惑的现象是 new Array(n).map(...) 无法正常工作:
// ❌ 错误做法:map 回调完全不会被执行!
const wrongGrid = new Array(3).map(() => new Array(3).fill(0));
console.log(wrongGrid); // [ <3 empty items> ],并未生成内层数组!
这是因为 new Array(n) 创建的是稀疏数组(Sparse Array),其内部只有 length 属性,槽位本身并不存在真实键值(即存在“空洞” Holes)。根据 ECMAScript 规范,Array.prototype.map、forEach、filter 会主动跳过不存在的空洞。而 Array.from({ length: n }) 会将类数组对象的索引转换为实际的 undefined 密集数组,确保映射回调正常触发。
2. 超大规模数值计算:一维 TypedArray 扁平化映射方案
如果需要在前端进行大规模数值矩阵运算(如 Canvas 像素处理、音频信号处理、机器学习权重矩阵),使用原生“数组的数组”(即交错数组)会带来显著的内存与性能开销:
- 内存碎片化:每个子数组都是独立的堆对象指针,无法在物理内存中形成连续区间;
- CPU 缓存缺失:由于内存地址不连续,CPU L1/L2 Cache 命中率低;
- GC 垃圾回收压力:成千上万个子数组对象会大幅增加垃圾回收标记时间。
此时行业内的标准工业解法是:使用一维类型化数组(TypedArray)在物理连续内存中模拟多维矩阵,通过行列索引换算定位元素:
class FlatMatrix2D {
  constructor(rows, cols) {
    this.rows = rows;
    this.cols = cols;
    // 物理分配一段连续的高速双精度浮点数缓冲内存
    this.data = new Float64Array(rows * cols);
  }

  // 坐标映射公式:index = r * cols + c
  get(r, c) {
    return this.data[r * this.cols + c];
  }

  set(r, c, value) {
    this.data[r * this.cols + c] = value;
  }
}

const flatMatrix = new FlatMatrix2D(1000, 1000); // 百万级浮点数矩阵
flatMatrix.set(450, 620, 3.14159);
console.log(flatMatrix.get(450, 620)); // 3.14159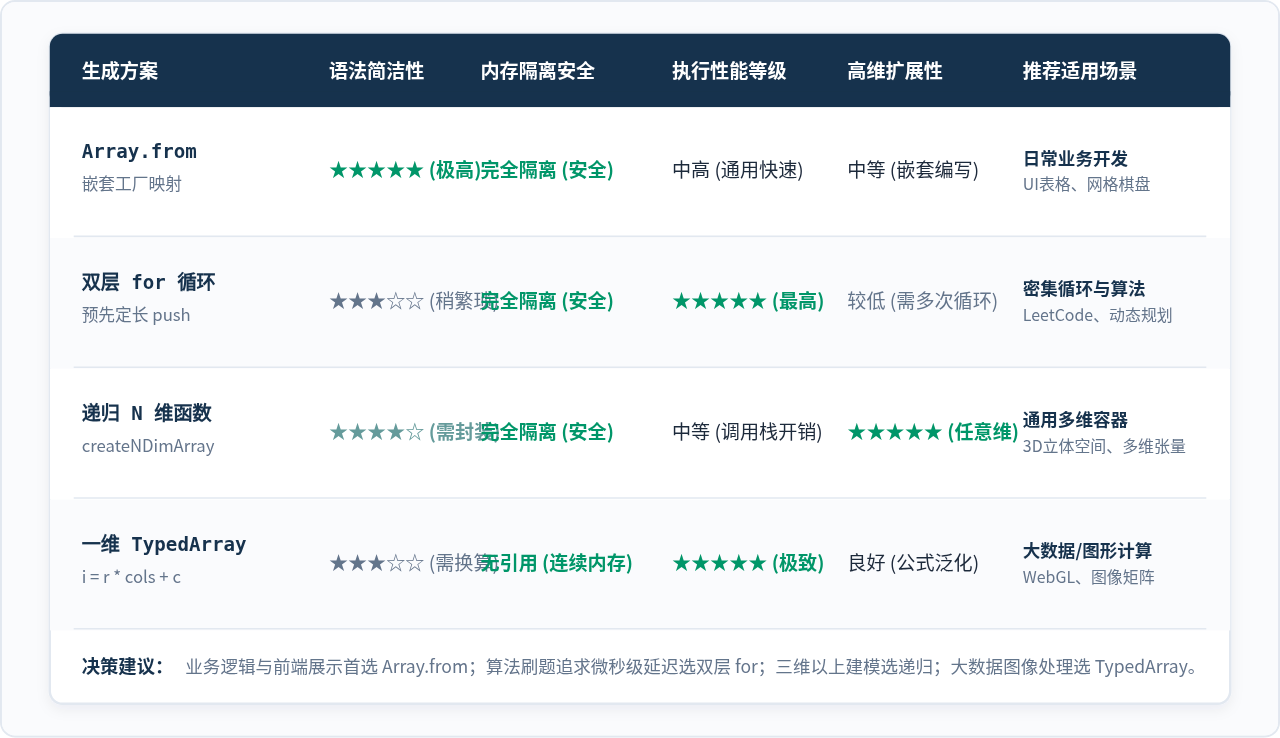
五、方案选型指南与决策速查
为了帮助读者在不同业务场景中做出最精准的技术决策,可参考下述选型依据:
| 场景需求 | 推荐方案 | 核心语法范式 | 选型理由 |
|---|---|---|---|
| 常规业务、表格组件、轻量网格 | Array.from 映射法 | Array.from({length: R}, () => Array(C).fill(0)) |
声明式语法,语义清晰,规避引用共享,综合维护成本最低。 |
| LeetCode 算法题、高频递归 DP | 双层 for 循环 | const m = new Array(R); for... |
无多余闭包分配开销,V8 引擎编译优化好,运行速度最快。 |
| 3D体素、多维张量、动态配置维数 | 通用递归函数 | createNDimArray([d1, d2, d3], factory) |
高度抽象,维度扩展灵活,支持复杂对象独立克隆。 |
| 图像像素分析、WebGL、大数据矩阵 | TypedArray 扁平映射 | new Float32Array(R * C) |
物理连续内存,极低内存占用,无 GC 压力,运算吞吐极致。 |
交付自检清单(Checklist):
- 是否检查过代码中是否存在
new Array(n).fill([])? - 外层数组的槽位填充是否由独立的函数或循环语句显式执行?
- 如果初始值是引用对象(如
{ checked: false }),内层是否同样使用了工厂函数? - 是否在测试用例中加入
arr[0] !== arr[1]与单点修改断言以保证内存隔离?
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章