
深入解析 JavaScript 中的可迭代协议与迭代器协议,系统厘清 Iterable 与 Iterator 的本质区别、底层运行机制、单次消费陷阱以及规范化迭代器的实现。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript迭代器协议详解:Iterable与Iterator的区别
作者:函数茶馆
时间:2026-11-03
浏览:120
文章目录
在 JavaScript 的迭代体系中,Iterable(可迭代对象)与 Iterator(迭代器对象)常被混为一谈,但它们实际上是职责分明且相互配合的两个协议:Iterable 是声明了“可被遍历”能力的数据源工厂,要求提供
[Symbol.iterator]() 方法;Iterator 则是记录遍历进度并输出数据的单向游标,要求实现 next() 方法。搞清两者的接口契约与生命周期,是写好自定义数据流、排查单次消费陷阱以及掌握 for...of 底层运作的关键。
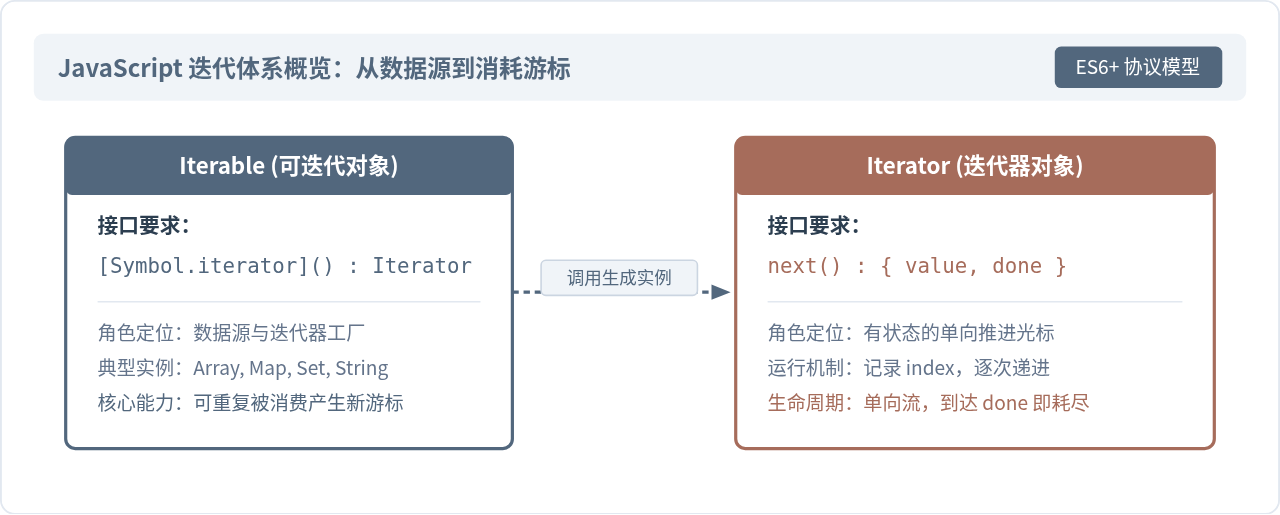
图 0:Iterable 与 Iterator 的核心契约与职能分工
一、现象切入:for...of 背后到底发生了什么?
在日常 JavaScript 开发中,我们随处可见遍历操作:可以用 for...of 遍历数组、字符串和集合,甚至使用 [...spread] 解构或 Array.from() 转换数据。然而,当你试图对一个普通字面量对象 const obj = { a: 1, b: 2 } 执行 for (const val of obj) 时,控制台却会抛出熟悉的报错:
// 运行时抛出 TypeError
const obj = { a: 1, b: 2 };
for (const val of obj) {
  console.log(val);
}
// Uncaught TypeError: obj is not iterable
这个报错点明了一个核心机制:JavaScript 引擎在运行 for...of 时,并不会直接检查目标是否有 length 或按属性读取,而是严格寻找目标上的 可迭代协议标识([Symbol.iterator])。如果存在,引擎就会调用该方法拿回一个真正的 迭代器(Iterator),并反复调用其 next() 方法推进流程。
我们可以用一段原生代码来手动模拟 for...of 的执行全过程:
// 手动模拟 for...of 执行逻辑
function simulateForOf(iterable, callback) {
  // 1. 检验目标是否具备可迭代能力
  if (iterable == null || typeof iterable[Symbol.iterator] !== 'function') {
    throw new TypeError(`${iterable} is not iterable`);
  }

  // 2. 调用工厂方法,获取独立的迭代器实例
  const iterator = iterable[Symbol.iterator]();

  // 3. 循环推进迭代器状态
  while (true) {
    const result = iterator.next(); // 得到 { value, done }
    if (result.done) {
      break; // 迭代完成,退出
    }
    callback(result.value);
  }
}

// 测试数组
simulateForOf(['Alpha', 'Beta', 'Gamma'], item => {
  console.log('消费到:', item);
});
通过这段代码,我们清晰地看到了分水岭:传入的数组是 Iterable,它只负责提供一个可以生产 Iterator 的通道;而后续推进循环、承载 next() 与返回 { value, done } 的对象才是 Iterator。
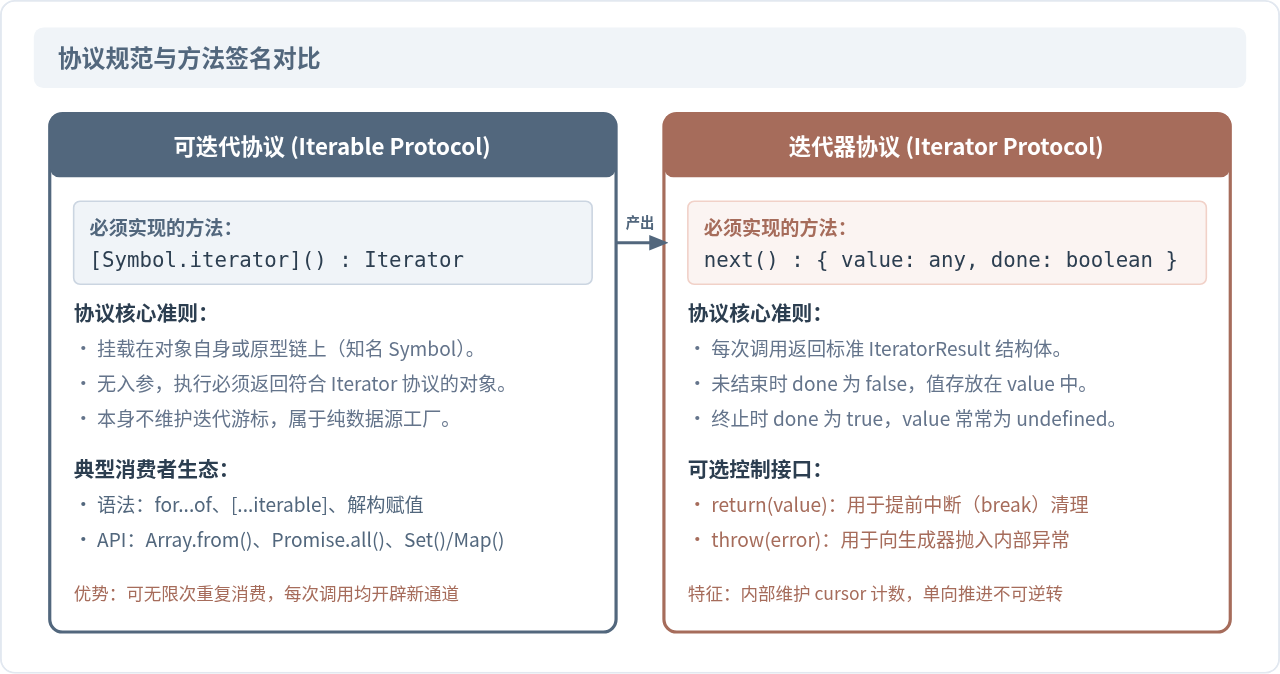
图 1:可迭代协议(Iterable)与迭代器协议(Iterator)的接口契约对比
二、Iterable 协议详解:让数据结构支持遍历
一个对象只要在其自身或原型链上挂载了键名为 [Symbol.iterator] 的方法,并且该方法返回一个合法的迭代器,这个对象就是 Iterable(可迭代对象)。
1. 内置可迭代对象
JavaScript 已经为大多数常见的数据集合内置了该协议,包括:
Array与各类TypedArrayString(按 Unicode 码点安全拆解字符)Map与Set- 函数内部伪数组
arguments - DOM 节点的
NodeList与HTMLCollection
2. 手动实现一个自定义 Iterable
假设我们需要一个表示数值范围的对象 Range,希望能够像数组一样直接使用 for...of 循环,而不需要在内存中一次性开辟庞大的真实数组。我们可以直接实现它的 [Symbol.iterator]:
// 实现自定义的可迭代对象
class NumberRange {
  constructor(from, to) {
    this.from = from;
    this.to = to;
  }

  // 实现可迭代协议
  [Symbol.iterator]() {
    let current = this.from;
    const end = this.to;

    // 返回一个符合 Iterator 协议的对象
    return {
      next() {
        if (current <= end) {
          return { value: current++, done: false };
        } else {
          return { value: undefined, done: true };
        }
      }
    };
  }
}

// 实际使用
const range = new NumberRange(1, 3);

// 第一次遍历
for (const num of range) {
  console.log('Round 1:', num); // 输出 1, 2, 3
}

// 第二次遍历:完全不受第一次影响,正常从头输出!
console.log([...range]); // 输出 [1, 2, 3]注意这段代码的关键特征:NumberRange 自身并没有维持 current 变量。current 是在每次执行 [Symbol.iterator]() 时在闭包内创建的新变量。这意味着 每一次遍历都拿到了独立的迭代器实例,因此 Iterable 是支持重复、并发遍历的。
三、Iterator 协议详解:单步推进与状态清理
与负责“声明能力”的 Iterable 不同,Iterator(迭代器)是一个有状态的指针对象。它的核心在于每次调用 next() 都会返回包含两个属性的对象:
value:当前步骤产出的数据。当done为true时,通常为undefined,也可以作为迭代的最终返回值。done:布尔值。如果仍有后续项,为false;如果序列已耗尽,为true。
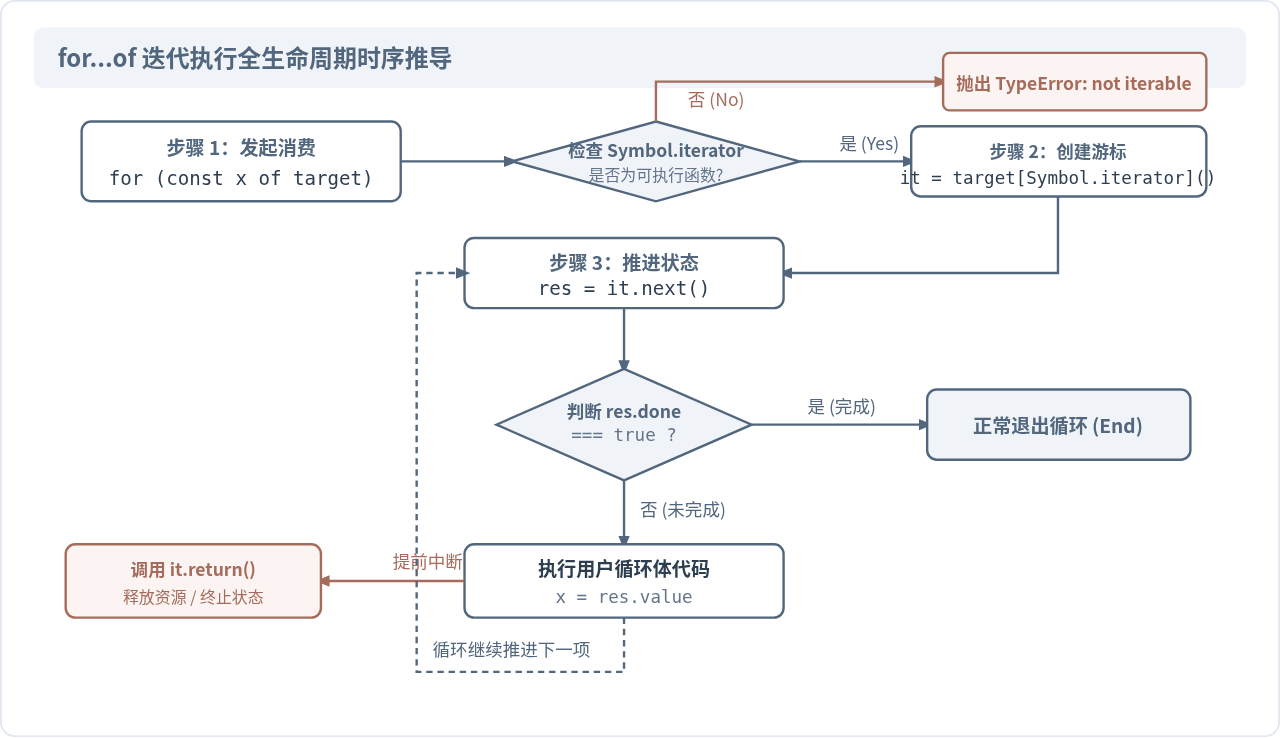
图 2:for...of 内部执行时序图(含提前退出与 return 钩子)
进阶接口:迭代器的提前终止与资源清理(return 方法)
在遍历过程中,若遇到 break、return 或者在循环内部抛出了未捕获异常,迭代过程会被强行打断。如果迭代器在初始化时申请了外部资源(例如打开的文件描述符、数据库连接、或网络长连接),该如何保证资源被妥善释放?
迭代器协议提供了一个可选方法:return(value)。当循环非正常耗尽而退出时,JavaScript 引擎会自动检测并执行该方法:
// 带有资源释放能力的自定义迭代器
function createResourceIterator() {
  let step = 0;
  console.log('[系统] 建立数据连接资源...');

  return {
    next() {
      step++;
      if (step <= 5) {
        return { value: `数据项-${step}`, done: false };
      }
      return { value: undefined, done: true };
    },

    // 当遍历因 break、return 或异常中断时,引擎自动调用
    return(val) {
      console.log('[系统] 检测到循环提前终止,正在清理并释放连接...');
      return { value: val, done: true };
    }
  };
}

// 包装成 Iterable
const resource = {
  [Symbol.iterator]: createResourceIterator
};

// 触发 break
for (const item of resource) {
  console.log('读取:', item);
  if (item === '数据项-2') {
    console.log('满足条件,执行 break 中断');
    break;
  }
}
// 输出顺序:
// [系统] 建立数据连接资源...
// 读取: 数据项-1
// 读取: 数据项-2
// 满足条件,执行 break 中断
// [系统] 检测到循环提前终止,正在清理并释放连接...
四、关键差异剖析:为什么 Iterator 不能直接代替 Iterable?
理解两者差异的最关键视角是:可重用性(Reusability)与状态所有权。
高频踩坑点:很多开发者误以为拿到一个
iterator 就可以把它当作普通数组随时随地 for...of,结果在第二次读取时发现拿到了空数据。
来看一个典型的错误写法:
const list = ['A', 'B', 'C'];
// 获取数组的迭代器实例
const it = list.values();

// 第一次读取
for (const item of it) {
  console.log('Loop 1:', item); // 打印 A, B, C
}

// 第二次读取(试图重复使用)
for (const item of it) {
  console.log('Loop 2:', item); // 什么都不会输出!
}
为什么 Loop 2 一无所获?因为 it 是一个 Iterator。它的指针在 Loop 1 结束时已经移到了末尾(done: true)。对于这个对象而言,状态已经固化,它无法重置自己的游标,因此后续所有的 next() 调用均直接返回 { done: true }。
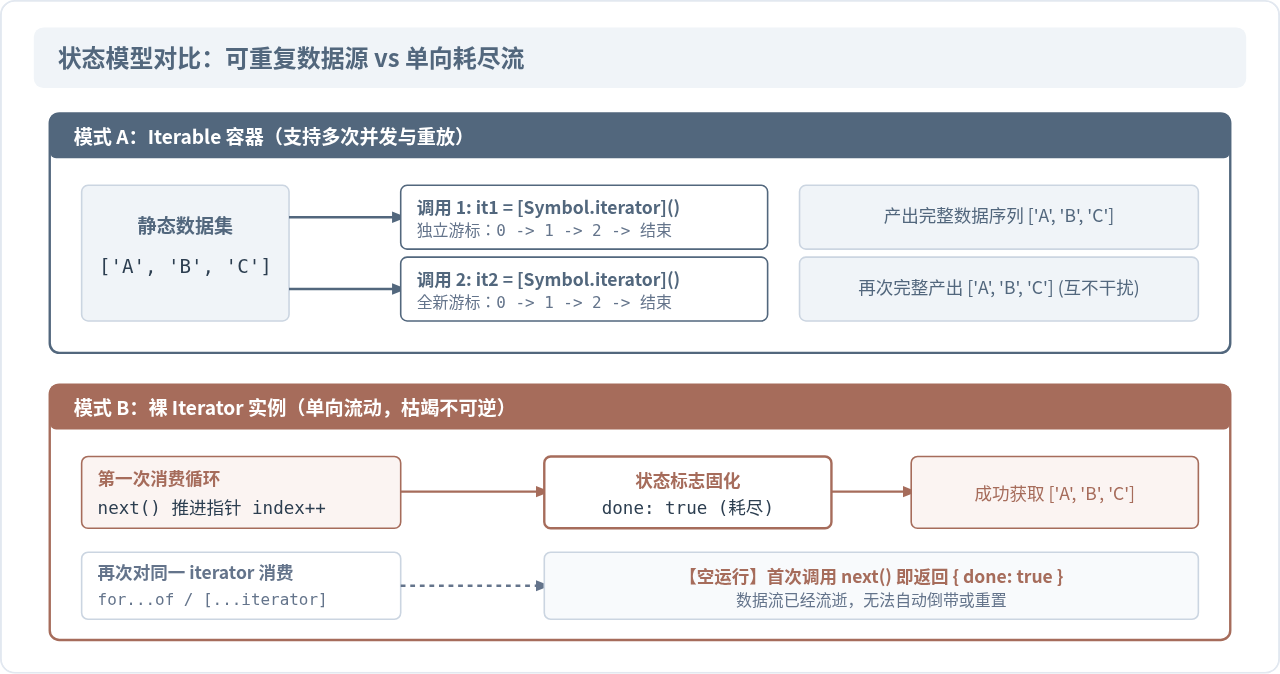
图 3:Iterable(多实例重放)与 Iterator(单向耗尽)的状态行为对比
五、最佳实践:规范化迭代器(Iterable Iterator)
细心的读者可能会发现一个矛盾:在上一节中,我们看到 list.values() 返回的是 Iterator,但我们依然能把它传入 for...of 循环!既然 for...of 要求传入必须是 Iterable,那为什么迭代器本身也能被 for...of 接受?
这是因为 ECMAScript 规范推行了一种优雅的设计模式——规范化迭代器(Well-formed Iterable Iterator)。它让 Iterator 对象本身也实现 [Symbol.iterator](),并且该方法直接返回自身:
// 检查内置迭代器的行为
const arr = [10, 20];
const iterator = arr.values();

// 迭代器自身居然也具备 [Symbol.iterator] 方法!
console.log(typeof iterator[Symbol.iterator] === 'function'); // true

// 而且返回的就是它自己
console.log(iterator[Symbol.iterator]() === iterator); // true
如何自己编写一个标准的 Iterable Iterator?
当你需要实现一个支持细粒度控制的迭代工具库时,最推荐的写法就是同时满足这两个协议:
// 同时实现两个协议的生成函数
function makeCountdown(from) {
  let count = from;

  return {
    // 1. 实现 Iterator 协议
    next() {
      if (count > 0) {
        return { value: count--, done: false };
      }
      return { value: undefined, done: true };
    },

    // 2. 实现 Iterable 协议:直接返回自身
    [Symbol.iterator]() {
      return this;
    }
  };
}

// 场景 A:可以像普通迭代器一样手动控制单步执行
const cd = makeCountdown(3);
console.log(cd.next()); // { value: 3, done: false }

// 场景 B:也可以直接把没消耗完的迭代器扔进 for...of 消费
for (const val of cd) {
  console.log('Rest val:', val); // 输出 2, 1
}
值得一提的是,ES6 的生成器函数(function*)执行后返回的 Generator 对象,正是标准的 Iterable Iterator。它不仅拥有 next()、return()、throw(),同时也原生实现了 [Symbol.iterator]() { return this; }。
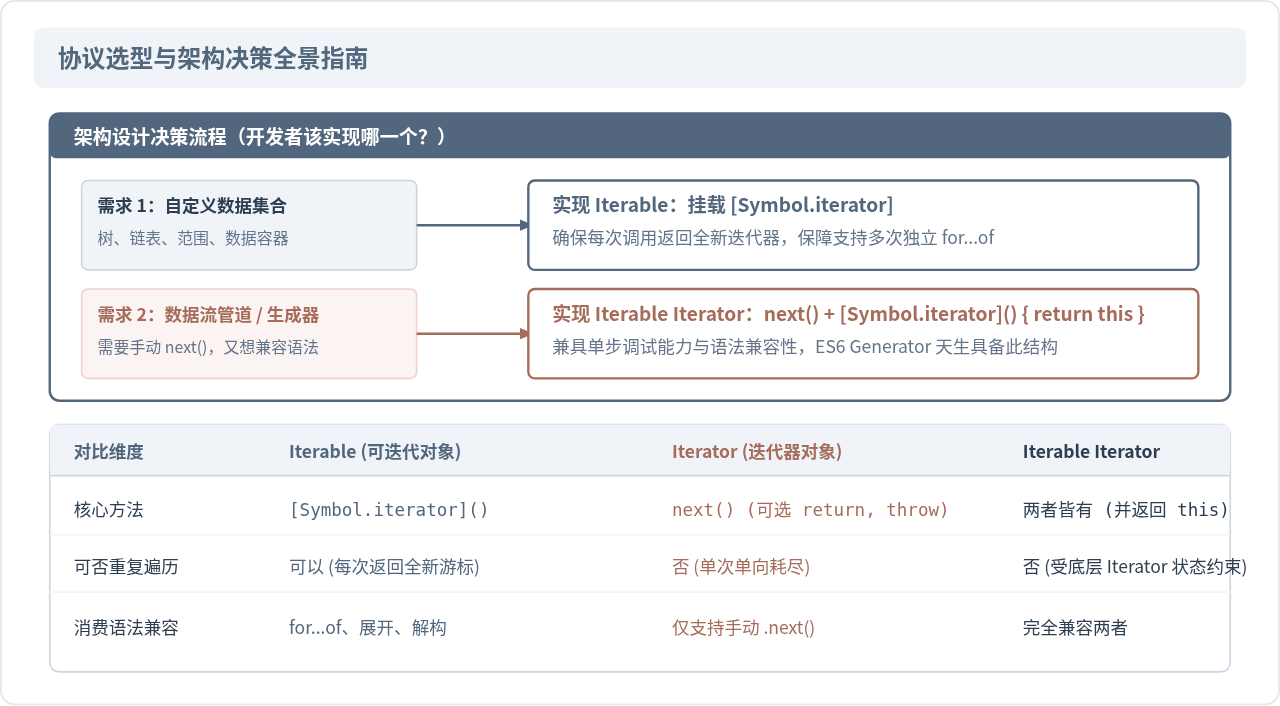
图 4:Iterable、Iterator 与 Iterable Iterator 的架构决策与属性对照
六、总结与关键结论
要彻底区分并掌握 JavaScript 的迭代器协议,只需记住以下三点核心结论:
- Iterable 是工厂,Iterator 是游标: Iterable 拥有
[Symbol.iterator]()方法,它不负责记录进度,只负责在被调用时生产一个全新的游标;Iterator 拥有next()方法,它维护着内部状态与索引,负责逐项产出{ value, done }。 - 别把裸 Iterator 当可重复数据源传递: 裸 Iterator 是一次性消费品。一旦它的
done变为true,就无法重新回到开头。如果你需要多次遍历同一个数据结构,必须对原始的 Iterable 进行操作。 - 善用规范化迭代器(Iterable Iterator): 在编写自定义流式工具时,让迭代器实现
[Symbol.iterator]() { return this; },可以同时赋予对象手动单步执行(.next())与被高层语法(for...of、展开运算符)直接消费的灵活性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章