
深入解析 JavaScript 快速排序在面对大量重复数据时的时间复杂度退化与 V8 引擎调用栈溢出问题,详解 Dijkstra 三向切分(荷兰国旗算法)的核心原理、状态转移机制与工业级落地实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript 快速排序在大量重复数据下的退化与解决方案
作者:小括号
时间:2026-11-03
浏览:186
文章目录
一、问题溯源:传统二路划分在重复数据下的退化机制
快速排序的核心思想是“分治”(Divide and Conquer):选定一个基准元素(Pivot),通过一次切分(Partition)过程将数组重新排列,使得基准左侧的元素均不大于基准,右侧的元素均不小于基准,随后对左右两个子区间递归执行排序。
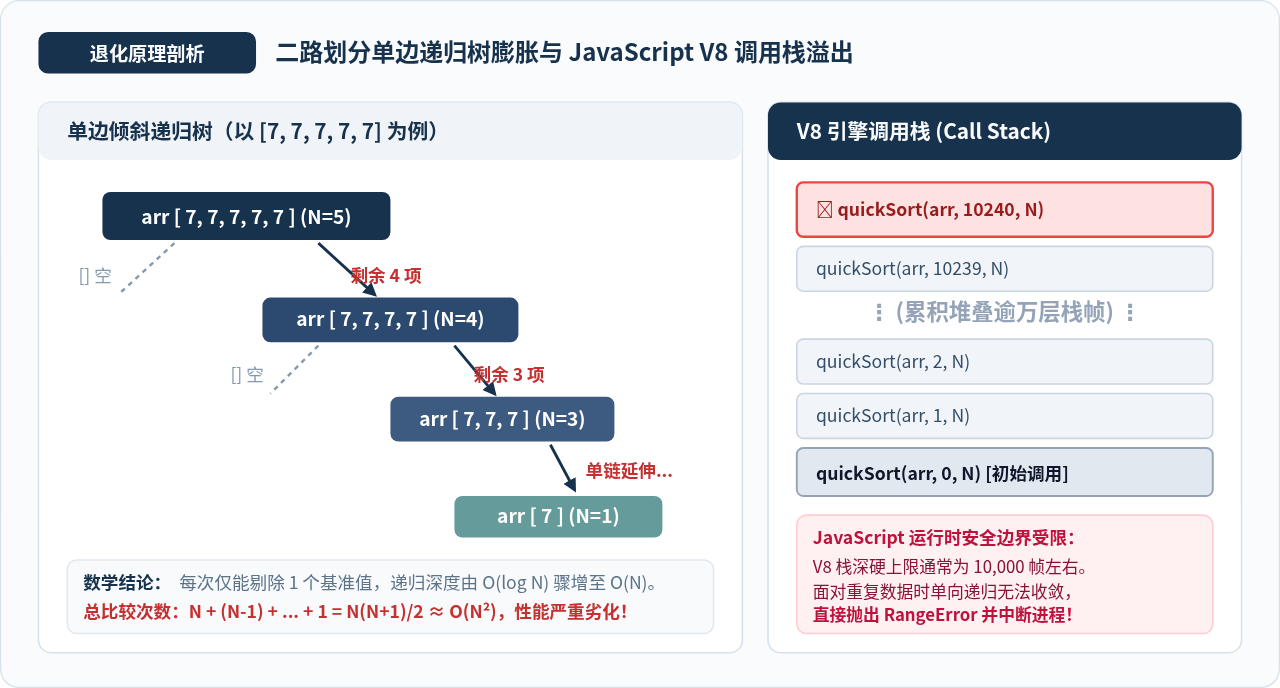
在教科书和大量初级教程中,最常见的实现是 Lomuto 划分方案。Lomuto 划分使用单向指针维护小于等于基准的边界。当面对全量相同元素(例如包含 10,000 个数值 5 的数组)时,若判断条件为 arr[i] <= pivot,所有的元素都会被无一例外地判定为满足条件并划分到同一侧;若判定条件为 arr[i] < pivot,所有的元素又会被划分到另一侧。
致命表现:
在 Lomuto 切分下,长度为 N 的重复数组切分后,左侧区间长度为 0,基准占 1 个位置,右侧区间长度仍高达 N - 1。原本期望中“对半拆分”的平衡二叉树退化成了一条深度为 N 的单向链表。
这种单边极度倾斜带来了两个维度的灾难性后果:
-
比较次数二次方膨胀:每一层递归仅仅排除了一个基准元素,总比较次数为
(N-1) + (N-2) + ... + 1 = N(N-1)/2,时间复杂度从理想的 O(N log N) 骤降至 O(N²)。对于十万级别的数据,计算步数直接从数百万次暴增至百亿次。 -
JavaScript 引擎调用栈溢出:与 C++ 等语言不同,JavaScript 是基于单线程事件循环运行的宿主语言,V8、SpiderMonkey 等引擎为避免内存耗尽,对递归函数的调用栈深度施加了严格的上限安全阈值(在 Chrome / Node.js 环境下通常在 10,000 帧左右)。单侧递归链瞬间打满调用栈,直接抛出未捕获的
RangeError: Maximum call stack size exceeded,导致脚本完全中断。
即使采用双向对向扫描的 Hoare 划分方案,若处理等于基准的逻辑不够周密,相等的元素也会在左右两侧频繁发生毫无意义的原地交换。虽然 Hoare 划分能够在全重复数据下将数组粗略对半拆开避免树高退化,但所有相等的元素依然会在后续的每一层子递归中反复参与比对和拆分,无法及时退出,额外增加了大量的冗余比较与交换操作。
二、核心破局:Dijkstra 三向切分(荷兰国旗算法)深度解析
既然二路划分在处理“相等”这一关系时顾此失彼,最根本的解法就是将“相等”单独提炼为一个一等公民区间。这一思想正是计算机先驱 Edsger W. Dijkstra 提出的荷兰国旗问题(Dutch National Flag Problem)在快速排序中的直接应用——被称为三向切分快速排序(3-Way QuickSort)。
1. 核心不变式与指针定义
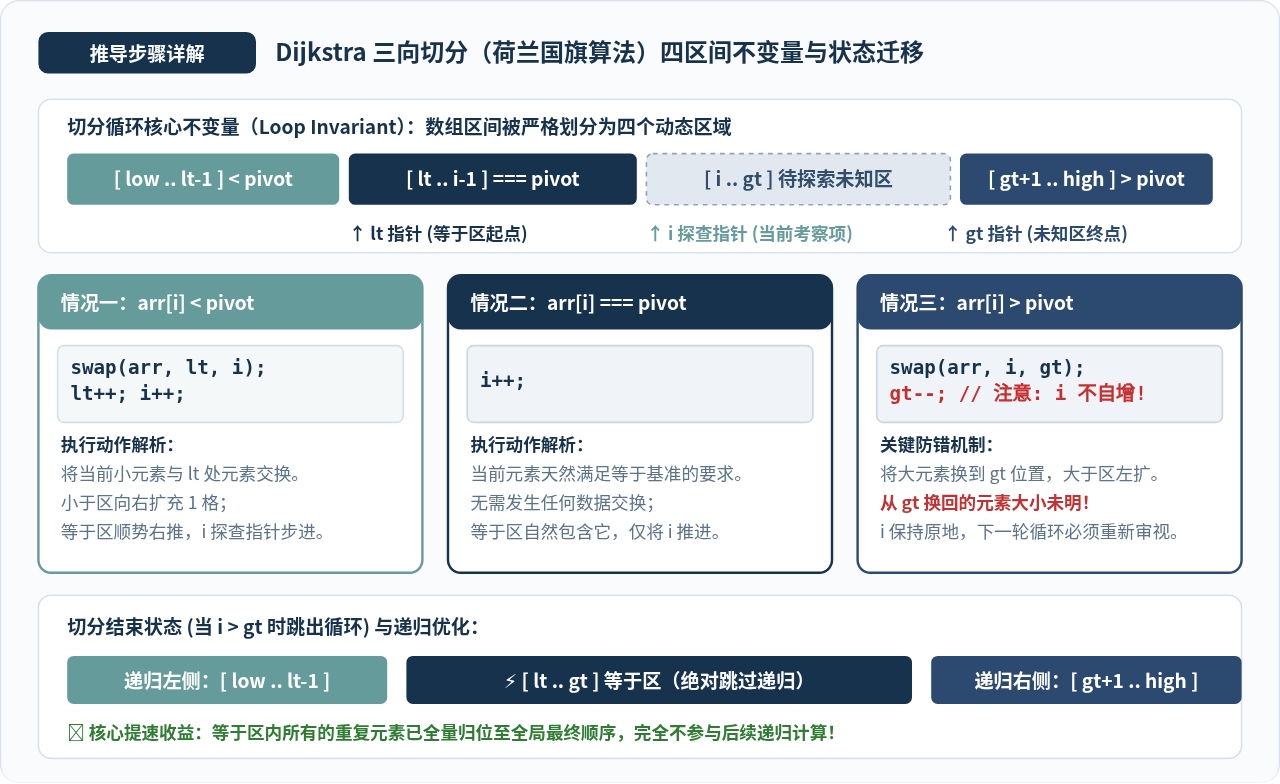
在待切分子区间 arr[low .. high] 中,我们选择一个基准值 pivot = arr[low],并通过维护三个游标指针将当前数组划分为四个严格的逻辑区域:
- 严格小于区:
arr[low .. lt-1],区间内所有元素严格小于pivot; - 严格等于区:
arr[lt .. i-1],区间内所有元素严格等于pivot; - 待探索未知区:
arr[i .. gt],尚未扫描处理的未知元素; - 严格大于区:
arr[gt+1 .. high],区间内所有元素严格大于pivot。
2. 状态转移法则(三向分支驱动)
探查指针 i 从 low + 1 开始向右推进,考察当前元素 arr[i] 与 pivot 的大小关系,分别执行以下三类原子操作:
-
若
arr[i] < pivot: 将arr[i]与arr[lt]互换位置,随后执行lt++与i++。因为换到lt处的必定是小于基准的元素,而换到i处的原本是等于基准的元素,因此两个指针均可安全右移一位。 -
若
arr[i] === pivot: 无需进行任何数据交换,直接执行i++。等于区区间自然扩大,探查指针继续向后扫描。 -
若
arr[i] > pivot: 将arr[i]与arr[gt]互换位置,随后执行gt--。
特别注意:此时i绝对不能自增!因为从gt位置换过来的元素此前属于未知区,其大小尚未经过比对,必须在下一次循环中重新对当前的arr[i]进行校验。
当 i > gt 时,待探索未知区长度缩减为 0,切分过程宣告完成。此时,整个数组被完美归类为三个部分:
[low .. lt-1] 为小于区,[lt .. gt] 为等于区,[gt+1 .. high] 为大于区。
为什么三向切分在重复数据下拥有降维打击般的优势?
在切分结束的瞬间,位于
[lt .. gt] 区间的所有重复元素已经处于其在全局数组中的最终绝对有序位置。因此,后续递归只需对 [low .. lt-1] 和 [gt+1 .. high] 进行分治求解,中间长达 (gt - lt + 1) 的全重复区间被完全跳过!如果输入数据全是重复项,单次切分后左右子数组均为空,算法直接退出,耗时严格为 O(N) 线性时间。
三、工业级 JavaScript 完整实现与关键工程优化
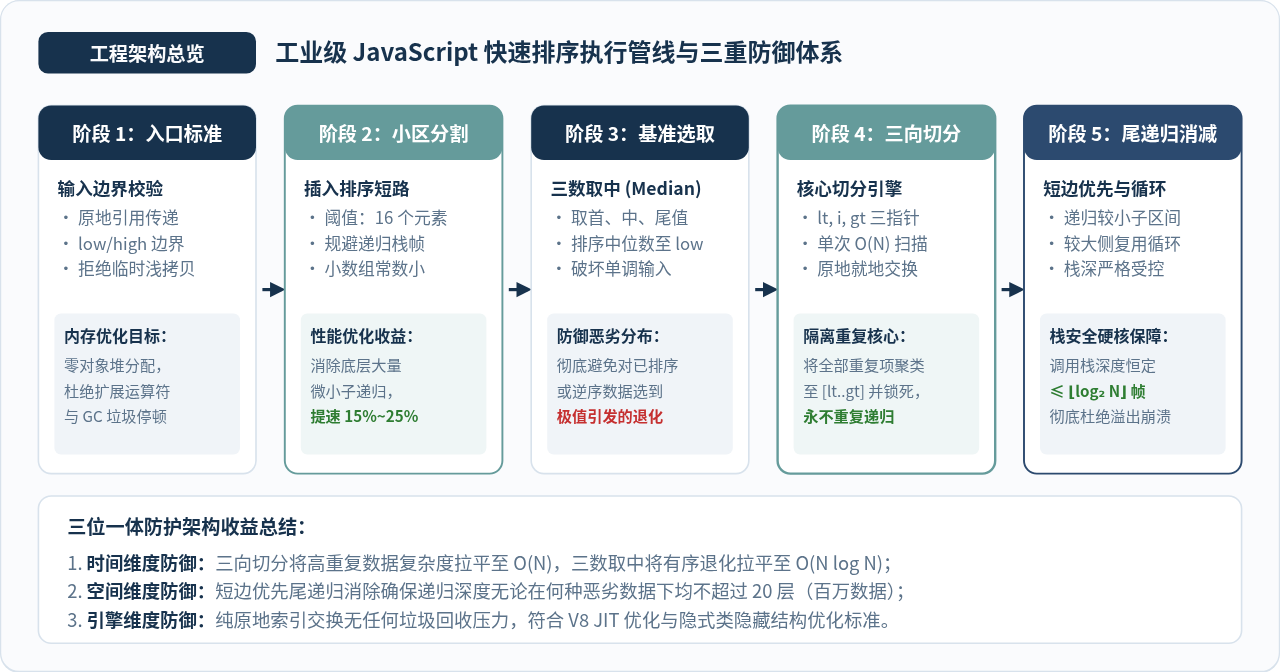
在实际的前端工程或 Node.js 服务端场景中,仅仅实现基础的三向切分仍然可能在特定极端输入下出现轻微性能抖动。为了打造一个鲁棒、高性能的工业级排序模块,我们需要构建包含三重防御机制的完整执行架构:
1. 三重工程防御机制
-
防御一:三数取中选择基准(Median-of-Three):
不直接盲目取
arr[low]作为基准,而是对比首部low、中部mid、尾部high三个位置的值,取中位数换至low位置。这能彻底瓦解由于输入数据单调递增或递减导致的极值基准陷阱。 - 防御二:小区间插入排序短路(Small-Array Cutoff): 当子数组规模较小(通常阈值取 16)时,快速排序频繁建立 JavaScript 执行函数栈帧的开销远大于简单的就地遍历。切换为无递归开销的直接插入排序,通常能使整体排序吞吐率提升 15% 以上。
-
防御三:尾递归消除与短边优先(Tail-Recursion Elimination):
传统的双递归形式难以控制最坏情况下的栈深度。我们将其改写为外层
while循环,永远优先递归元素较少的一侧子数组,而将元素较多的一侧留给循环变量在当前函数帧中继续处理。这从数学上严格保证了调用栈深度绝对不会超过⌊log₂ N⌋,彻底杜绝栈溢出。
2. 生产级完整代码实现
以下为遵循上述规范的完整 JavaScript 原生代码,采用严格的原地交换机制,绝不分配临时数组切片,保证极低的内存占用与零额外 GC 压力:
quickSort3Way.js (ES6+ / 完整工业实现)
Zero-GC / In-Place
/**
 * 原地交换数组两个索引的元素
 * @param {Array<number>} arr
 * @param {number} i
 * @param {number} j
 */
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

/**
 * 三数取中(Median-of-Three)
 * 比较 low、mid、high 三个位置的元素,将中位数交换至 low 作为基准
 */
function medianOfThree(arr, low, high) {
  const mid = low + ((high - low) >> 1);
  if (arr[low] > arr[mid]) swap(arr, low, mid);
  if (arr[low] > arr[high]) swap(arr, low, high);
  if (arr[mid] > arr[high]) swap(arr, mid, high);
  // 将选中的中位数换到 low 位置作为基准值
  swap(arr, low, mid);
  return arr[low];
}

/**
 * 小数组插入排序优化
 * 在区间长度 <= 16 时就地排序,消除深层递归函数栈帧开销
 */
function insertionSort(arr, low, high) {
  for (let i = low + 1; i <= high; i++) {
    const key = arr[i];
    let j = i - 1;
    while (j >= low && arr[j] > key) {
      arr[j + 1] = arr[j];
      j--;
    }
    arr[j + 1] = key;
  }
}

/**
 * 工业级三向切分快速排序主入口
 * 包含:Dijkstra 三向切分 + 三数取中 + 插入排序短路 + 短边优先尾递归消除
 * @param {Array<number>} arr 待排序数组(原地修改)
 * @param {number} [low=0] 起始索引
 * @param {number} [high=arr.length - 1] 结束索引
 * @returns {Array<number>} 排序后的原数组引用
 */
function quickSort3Way(arr, low = 0, high = arr.length - 1) {
  const INSERTION_SORT_THRESHOLD = 16;

  while (low < high) {
    // 1. 小区间短路优化
    if (high - low <= INSERTION_SORT_THRESHOLD) {
      insertionSort(arr, low, high);
      break;
    }

    // 2. 三数取中基准选定
    const pivot = medianOfThree(arr, low, high);

    // 3. 初始化三向切分指针
    let lt = low;       // arr[low .. lt-1] < pivot
    let gt = high;      // arr[gt+1 .. high] > pivot
    let i = low + 1;    // arr[lt .. i-1] === pivot

    // 4. 原地三向切分核心状态循环
    while (i <= gt) {
      if (arr[i] < pivot) {
        swap(arr, lt, i);
        lt++;
        i++;
      } else if (arr[i] > pivot) {
        swap(arr, i, gt);
        gt--; // 注意:此处 i 不推进,从 gt 换回的未知元素需继续校验
      } else {
        i++;  // 相等元素自然纳进等于区
      }
    }

    // 5. 尾递归优化与短边优先:严格限制调用栈深度 <= log2(N)
    if (lt - low < high - gt) {
      // 左侧区间较小,递归左侧;右侧区间较大,由当前 while 循环迭代处理
      quickSort3Way(arr, low, lt - 1);
      low = gt + 1;
    } else {
      // 右侧区间较小,递归右侧;左侧区间较大,由当前 while 循环迭代处理
      quickSort3Way(arr, gt + 1, high);
      high = lt - 1;
    }
  }

  return arr;
}

// 示例:验证大量重复数据下的排序表现
const sampleData = [6, 2, 6, 8, 6, 1, 6, 6, 9, 6, 3];
quickSort3Way(sampleData);
console.log("排序结果:", sampleData);
// 期望输出: [1, 2, 3, 6, 6, 6, 6, 6, 6, 8, 9]
四、对比与选型:为什么现代 V8 选用 TimSort 与自定义快排的取舍
探讨 JavaScript 快速排序时,很多开发者会产生一个疑问:现代 JavaScript 原生的 Array.prototype.sort() 是否也会在大量重复数据下崩溃?
1. V8 原生排序算法的演进历史
在 2018 年(Chrome 70 / Node.js 11 / V8 v7.0)之前,V8 内部对小数组采用插入排序,对大数组(长度大于 10)确实采用了基于快速排序的变种。当时由于切分策略与非稳定排序的特性,也曾出现过特定恶劣分布下的性能退化。
而在 ECMAScript 2019(ES10)规范中,TC39 明确规定:Array.prototype.sort 必须保证算法的稳定性(Stable Sort)。由于快速排序本质上是非稳定排序(相同元素在跨区交换时无法保证原有的相对顺序),现代 V8 全面弃用了快排,转而采用了源自 Python 的混合自适应排序算法——TimSort。TimSort 天生擅长识别连续升序与降序分块(Run),并在处理大量重复元素时利用二分插入归并保持 O(N) 的线性复杂度与稳定性。
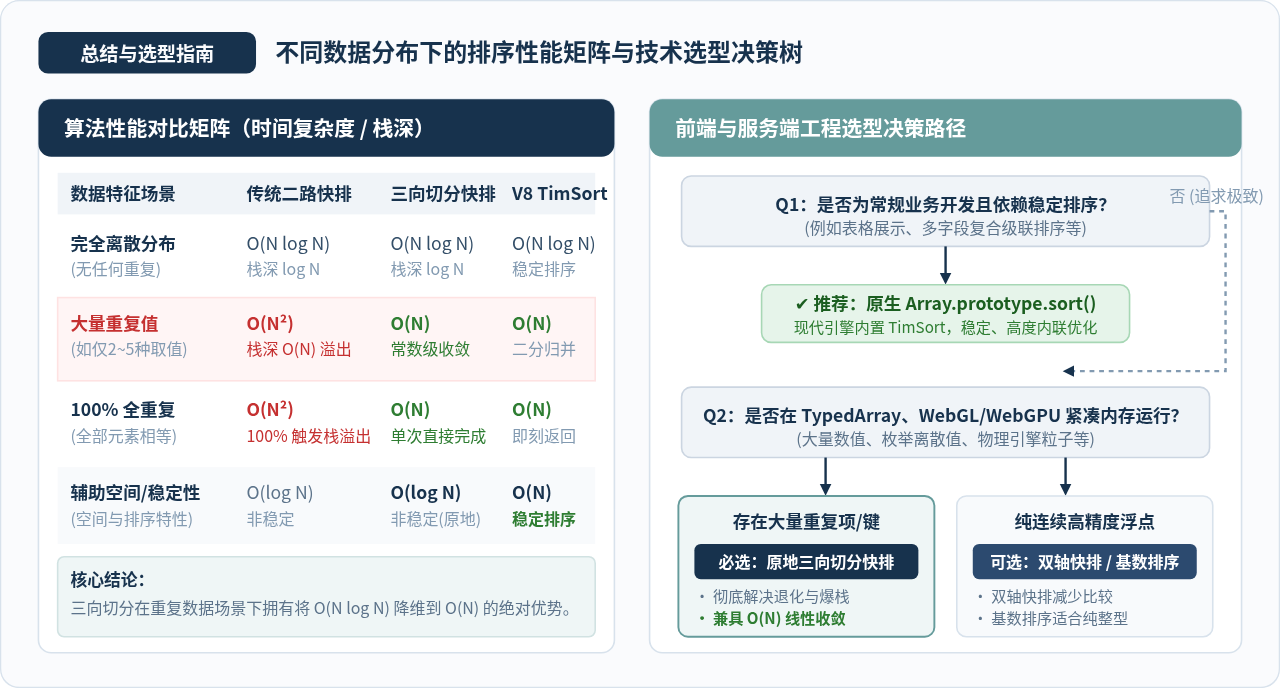
2. 不同数据分布下的性能对比矩阵
| 测试场景分布 | 经典二路快速排序 | Dijkstra 三向切分快排 | 原生 TimSort (Array.sort) |
|---|---|---|---|
| 完全无重复随机分布 | O(N log N) 平稳 | O(N log N) 常数略微增加 | O(N log N) C++ 内核高效 |
| 大量重复值 (如仅 3~5 种枚举) | O(N²) 退化 / 栈溢出 | O(N) 极速跳跃收敛 | O(N) 线性归并合并 |
| 100% 相同数据 (全重复) | O(N²) 100% 触发 RangeError | O(N) 仅单次切分即刻返回 | O(N) 线性遍历即刻返回 |
| 算法稳定性 (Stability) | 非稳定 | 非稳定 | 绝对稳定 |
| 辅助内存空间复杂度 | O(log N) 栈 | O(log N) 原地栈 | O(N) 需要辅助归并数组 |
3. 实际工程中的技术选型法则
-
常规 Web / Node.js 业务开发:
直接使用原生的
Array.prototype.sort()。现代引擎的 C++ 实现经过了激进的 JIT 内联与内建优化,且提供了不可替代的排序稳定性,无需重复造轮子。 -
高性能数值计算与紧凑内存场景:
在处理
Float64Array、Int32Array等 TypedArray 时,或在开发 WebGL 顶点渲染管线、物理引擎碰撞体粗筛、游戏状态压缩等场景下,TimSort 所需的 O(N) 额外归并辅助内存可能导致高频 GC 抖动。此时,原地(In-Place)三向切分快速排序由于兼备零临时对象分配、高缓存局部性与免疫重复项退化的特性,是定制化算法库的绝佳选择。
五、常见陷阱与避坑清单
在自行编写快速排序时,开发者常因细节疏漏掉入以下陷阱,需特别引起重视:
-
大于分支中误写
i++: 在三向切分中,当arr[i] > pivot时执行swap(arr, i, gt); gt--;之后,绝对不能自增i!因为从gt换过来的元素从未被比较过,一旦跳过该位置,未排序的元素就会被永久遗留在等于区,导致最终排序错乱。 -
扩展运算符糖衣陷阱:
在部分面试题或代码片段中,常有人写出类似
return [...qs(left), ...equal, ...qs(right)]的函数式代码。这种写法虽然形式精简,但在处理 100,000 个元素时会瞬时创建数十万个数组切片对象,瞬间引爆内存占用并触发长达数百毫秒的 V8 GC 停顿,彻底失去了快速排序就地排序的优势。 -
未进行递归栈深约束:
如果仅写基础的递归调用而不做“短边优先 + 尾递归循环化”,遇到极端分布时调用栈深度仍可达 O(N)。务必像前文代码所示,优先递归较小的一侧,将较大侧留在外层
while中处理。
六、总结
快速排序在大量重复数据下的性能退化并非算法本身的不可逆缺陷,而是传统二路划分在处理“相等”状态时语义缺失的必然结果。通过引入 Dijkstra 三向切分,我们将基准相等的元素直接隔离为一个独立的静态区间,不仅彻底排除了不平衡分区与调用栈溢出风险,更在海量重复数据的极端场景下将整体复杂度奇迹般地改善至 O(N) 线性时间。
结合三数取中、小数组插入排序与短边优先尾递归消除,我们可以构建出一个兼具极高运行速度与工业级稳定性的 JavaScript 排序引擎,在高性能计算与紧凑内存处理中发挥出快速排序应有的极限威力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章