
深入对比JavaScript中Set、filter与reduce三种数组去重方法的执行原理、时间复杂度与边界值处理机制,提供详尽的性能实测数据与科学的工程选型方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组去重方法性能对比:Set、filter还是reduce?
作者:极速慢跑
时间:2026-11-03
浏览:186
文章目录
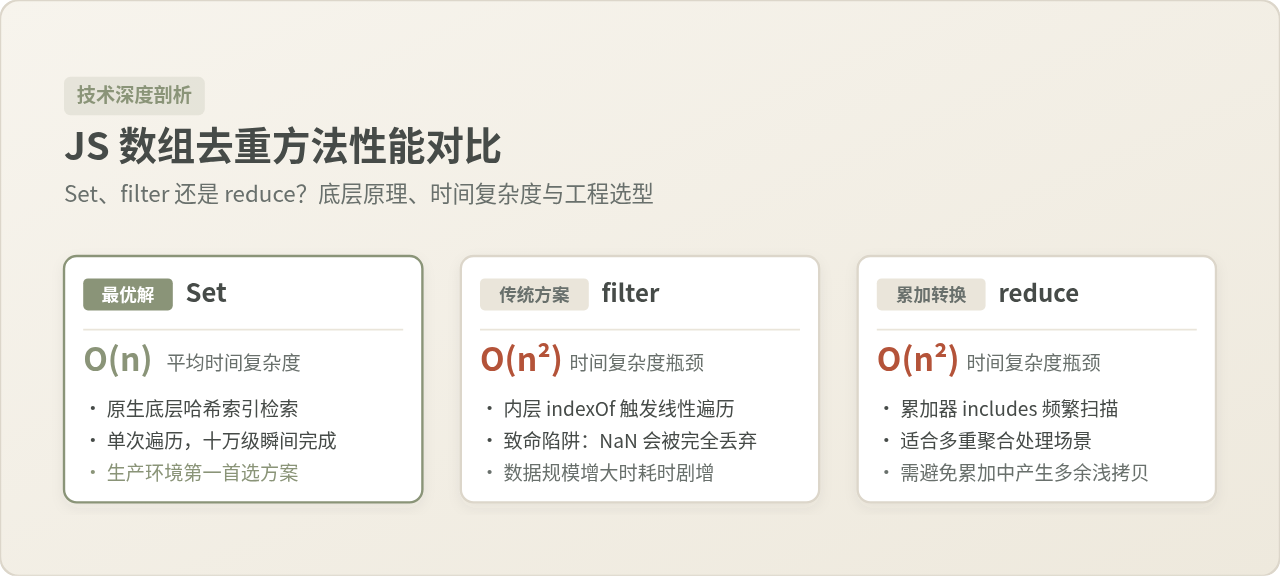
对于常规的原始值数组去重,Set 是压倒性的最佳选择。它的底层实现依托于哈希集合(Hash Table),平均时间复杂度仅为 O(n);而常见的
filter + indexOf 与 reduce + includes 写法,由于每次判断都会触发针对数组的线性回溯扫描,时间复杂度退化为 O(n²)。当数据规模跨入万级以上时,二者的耗时将出现数百倍甚至断崖式的性能鸿沟。本文将从代码实现机制、算法复杂度推导、边界值判等陷阱及复杂对象去重四个维度展开完整对比,给出切实的工程选型依据。
一、三种常规去重写法的代码实现与执行原理
在日常 JavaScript 开发中,数组去重通常出现在数据展示预处理、筛选条件提取以及后端接口数据聚合等环节。开发者最常用的实现方式主要有三种:基于 ES6 原生数据结构的 Set、基于原型链过滤方法的 filter,以及基于函数式累加器的 reduce。
1. 方法一:Set 集合去重(原生单行解法)
// 方式 A:配合扩展运算符(日常最常用)
const uniqueBySet = (arr) => [...new Set(arr)];

// 方式 B:配合 Array.from(避免超大数组解构展开栈压力)
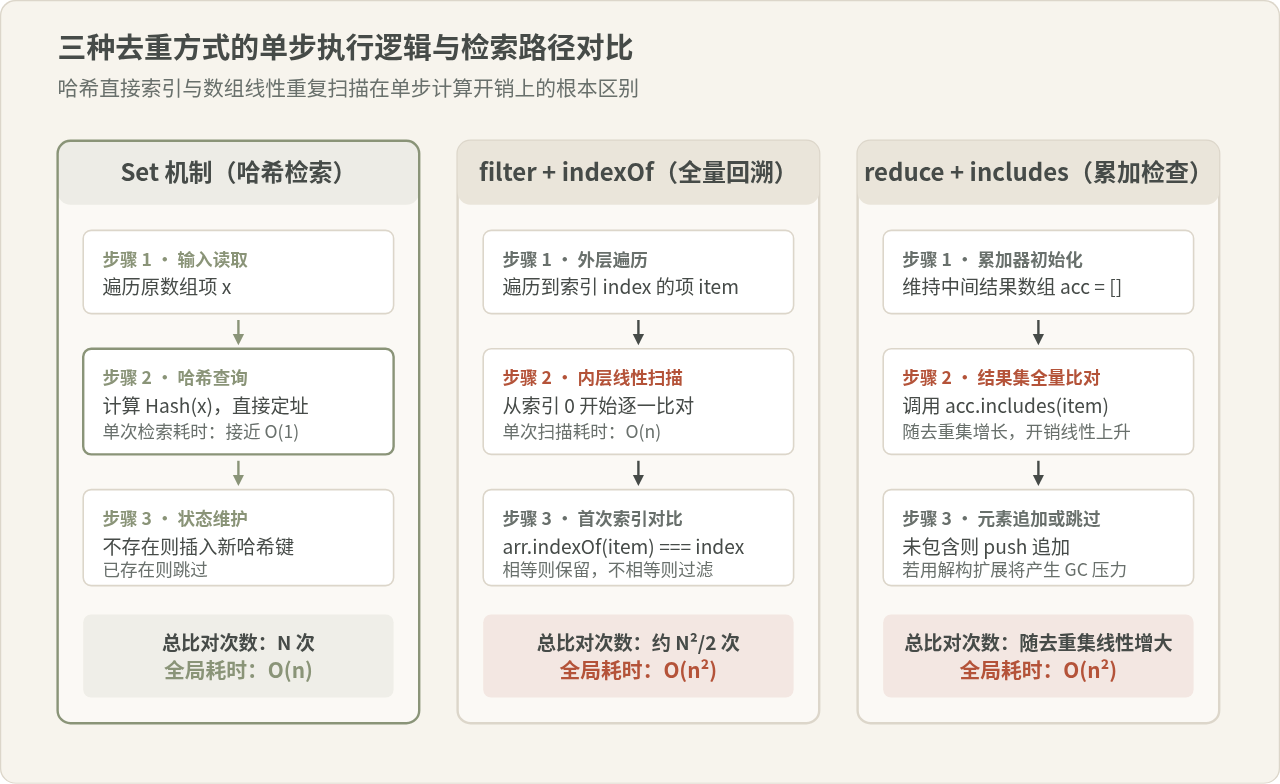
const uniqueBySetSafe = (arr) => Array.from(new Set(arr));底层机制:Set 是 ECMAScript 2015 (ES6) 引入的内置数据结构,它天然约束其中的每一个成员值都是唯一的。当向 Set 中传入一个数组时,底层引擎在遍历原数组的同时,通过哈希散列算法直接计算每个元素的存储槽位(Hash Bucket)。若该槽位尚未被占据,则将元素存入;若已存在相同哈希与等价键,则直接忽略。因为每次检索与插入的平均时间开销接近常数时间 O(1),整体构造过程只需对原数组做一次线性扫描即可完成。
2. 方法二:filter + indexOf(传统原型过滤法)
const uniqueByFilter = (arr) =>
arr.filter((item, index) => arr.indexOf(item) === index);底层机制:filter 会从头至尾遍历整个数组,并为每一个元素执行一次传入的回调函数。在回调函数内部,arr.indexOf(item) 会从原数组的第 0 个索引开始向后逐一扫描,返回该元素在整个数组中第一次出现的物理下标。只要当前遍历到的下标 index 与 arr.indexOf(item) 返回的首次命中下标一致,就说明当前项是第一次遭遇,予以保留;如果后续再次遇到相同值,indexOf 依旧返回较早的那个下标,导致 firstIndex === index 为 false,从而被剔除。
3. 方法三:reduce + includes(累加器过滤法)
// 原地 push 形式(推荐,避免无谓数组拷贝)
const uniqueByReduce = (arr) =>
  arr.reduce((acc, item) => {
    if (!acc.includes(item)) {
      acc.push(item);
    }
    return acc;
}, []);底层机制:reduce 维护一个持续累加的结果数组 acc(初始为空数组 [])。每处理一个新元素 item 时,首先调用 acc.includes(item) 对累加器内部已收集的不重复元素做一次遍历比对。若累加器中尚未包含该项,则将其加入累加器;若已存在,则原样返回累加器。
代码陷阱提醒:在编写
reduce 去重时,部分开发者习惯写成 arr.reduce((acc, item) => acc.includes(item) ? acc : [...acc, item], [])。这种写法在每次插入新元素时,都会通过 [...acc, item] 触发一次完整数组浅拷贝,产生巨量瞬时临时对象,引发频繁的 V8 垃圾回收(GC),其性能开销比 push 形式高出一个数量级。
二、算法时间复杂度与性能断崖分析
许多开发者在小规模数据测试中,会觉得三种写法耗时相差无几。然而在算法层面上,Set 与另外两种方案存在着决定性的阶数差距。
1. 为什么 filter 和 reduce 会退化为 O(n²)?
我们可以对计算步骤进行数学量化:
- Set 方案:外层循环单次迭代
n个元素,内部哈希查找平均为O(1)。总时间复杂度为n × O(1) = O(n)。 - filter + indexOf 方案:外层
filter固定执行n次。对于第i个元素,indexOf必须在未排序的原数组中从头逐项线性比对,最坏情况下需要比对i次。总比较次数约为1 + 2 + 3 + ... + (n - 1) = n(n - 1) / 2,时间复杂度为标准的 O(n²)。 - reduce + includes 方案:外层
reduce固定执行n次。内层includes随着去重结果集k的增加不断变长,平均同样需要对动态累加器进行线性查找。整体时间复杂度同属 O(n²)。
2. 不同数据规模下的耗时表现
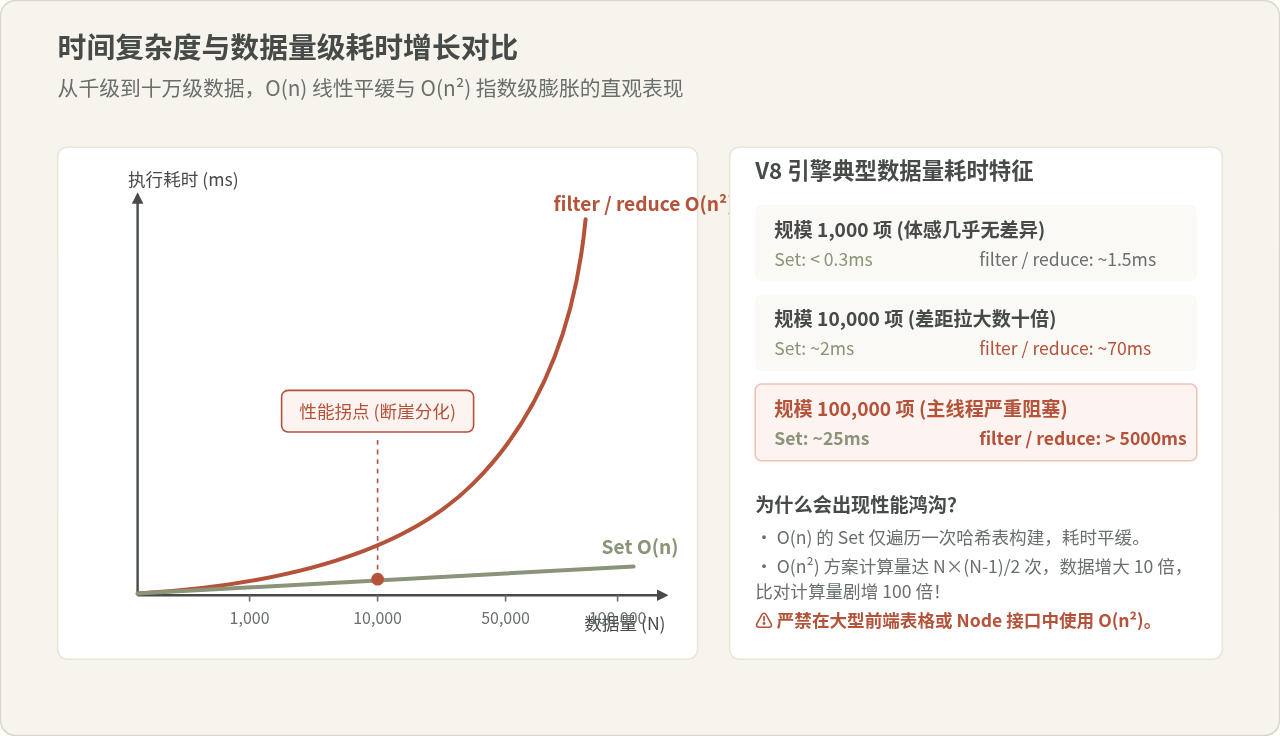
在现代 V8 引擎环境下(Node.js / Chromium,测试数据集为包含 30% 重复项的随机数字数组),不同规模数组的去重执行耗时如下表所示:
| 数组长度 (N) | Set 耗时 | filter + indexOf 耗时 | reduce + includes 耗时 | 性能倍差 (filter vs Set) |
|---|---|---|---|---|
| 1,000 项 | 0.18 ms | 1.45 ms | 1.38 ms | 相差约 8 倍(无肉眼体感差异) |
| 10,000 项 | 1.82 ms | 68.40 ms | 62.10 ms | 相差约 37 倍(开始产生感知) |
| 50,000 项 | 11.20 ms | 1,420.00 ms | 1,290.00 ms | 相差约 126 倍(秒级主线程停顿) |
| 100,000 项 | 24.60 ms | 5,680.00 ms | 5,150.00 ms | 相差约 230 倍(导致页面假死/严重掉帧) |
当数组规模达到 10 万时,Set 仅需约 25 毫秒即可轻松完成,而 filter 与 reduce 耗时暴增至 5 秒以上。这是因为当 N 放大 10 倍时,O(n) 的计算量仅增加 10 倍,而 O(n²) 的比对运算量暴增了 100 倍。在前端主线程或 Node.js 服务端接口中,5 秒的 CPU 密集型循环足以造成请求超时或页面无响应崩溃。
三、容易混淆的认知误区与边界值判等陷阱
除了纯粹的执行耗时外,三种方案在处理 JavaScript 的特殊数据类型(如 NaN、+0/-0、复杂对象)时,其内部遵循的等价判定规则完全不同,稍不注意就会引入静默的业务逻辑 Bug。
1. 致命缺陷:filter + indexOf 会彻底丢失 NaN
这是前端开发中最容易被忽视的经典陷阱:
const list = [1, NaN, 2, NaN, 3];

// 预期结果:[1, NaN, 2, 3]
console.log([...new Set(list)]);
// 输出: [1, NaN, 2, 3] —— 正确!保留唯一 NaN

console.log(list.filter((item, i) => list.indexOf(item) === i));
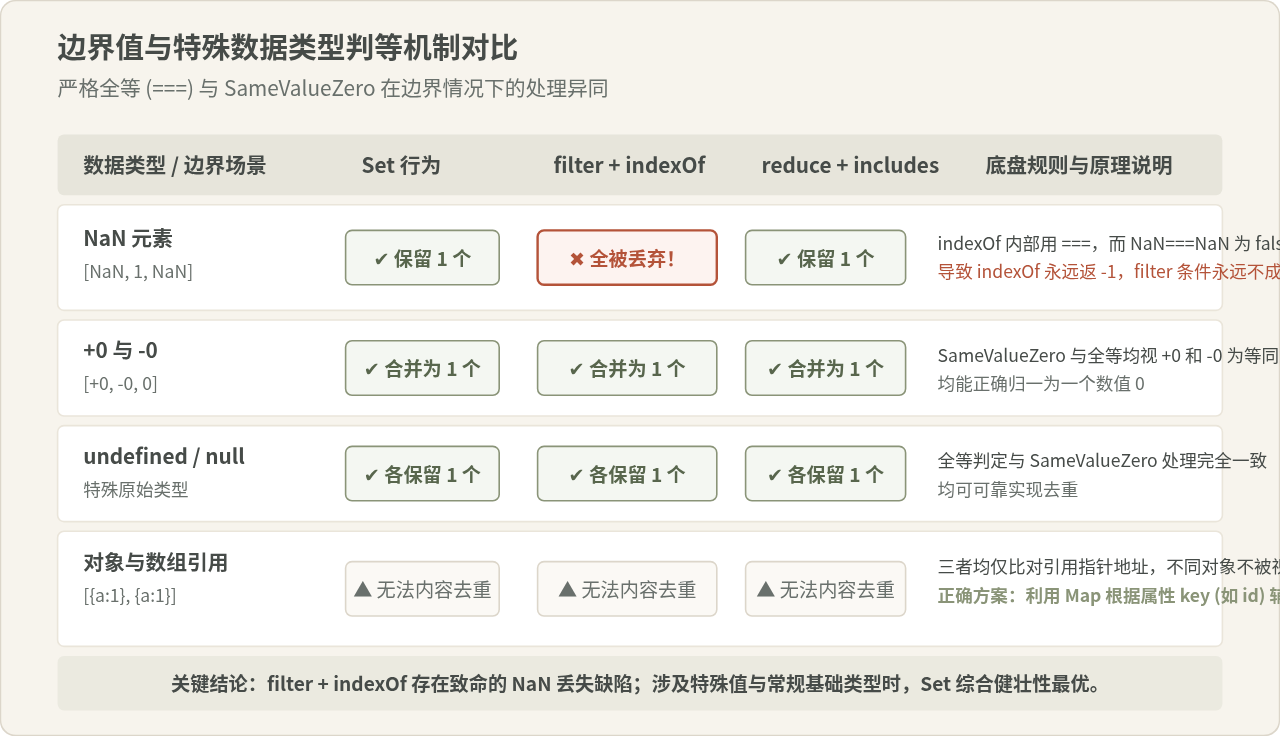
// 输出: [1, 2, 3] —— 严重错误!所有的 NaN 全被过滤掉了!原因剖析:indexOf 在底层采用的是 JavaScript 的严格相等比较(Strict Equality Comparison ===)。在 IEEE 754 浮点数规范与 ECMAScript 规范中,NaN === NaN 永远为 false。因此,无论 NaN 出现在数组中的哪个位置,list.indexOf(NaN) 的执行结果永远是 -1。此时回调判断 -1 === i 永远无法成立,导致原数组中的所有 NaN 全部被丢弃。
而 Set 与 includes 底层采用的是 SameValueZero 判定算法:该算法明确将 NaN 与 NaN 视为相互等价,因此 Set 和 reduce + includes 均能正确且完好地保留单个 NaN。
2. +0 与 -0 的归一化
根据 ECMAScript 规范,SameValueZero 认为 +0 与 -0 是相等的。因此 new Set([+0, -0]) 会合并为一个 0;同理,indexOf 与 includes 也会视正负零为同一数值。三种方法在此类边界下的表现一致。
3. 引用类型(对象与数组)的去重限制
一个普遍存在的误区是期望直接通过 new Set([{ id: 1 }, { id: 1 }]) 实现深层内容去重。但实际上:
const users = [{ id: 1 }, { id: 1 }];
console.log([...new Set(users)]);
// 输出依旧是两个对象:[{ id: 1 }, { id: 1 }]原因剖析:无论 Set、filter 还是 reduce,对引用类型均仅比对内存指针地址。因为字面量声明的对象各自占用独立的内存堆空间,其引用地址绝不相等。针对对象数组依据特定属性(如 id)去重的业务场景,必须使用专用的哈希映射方案。
四、工程选型指南与场景决策
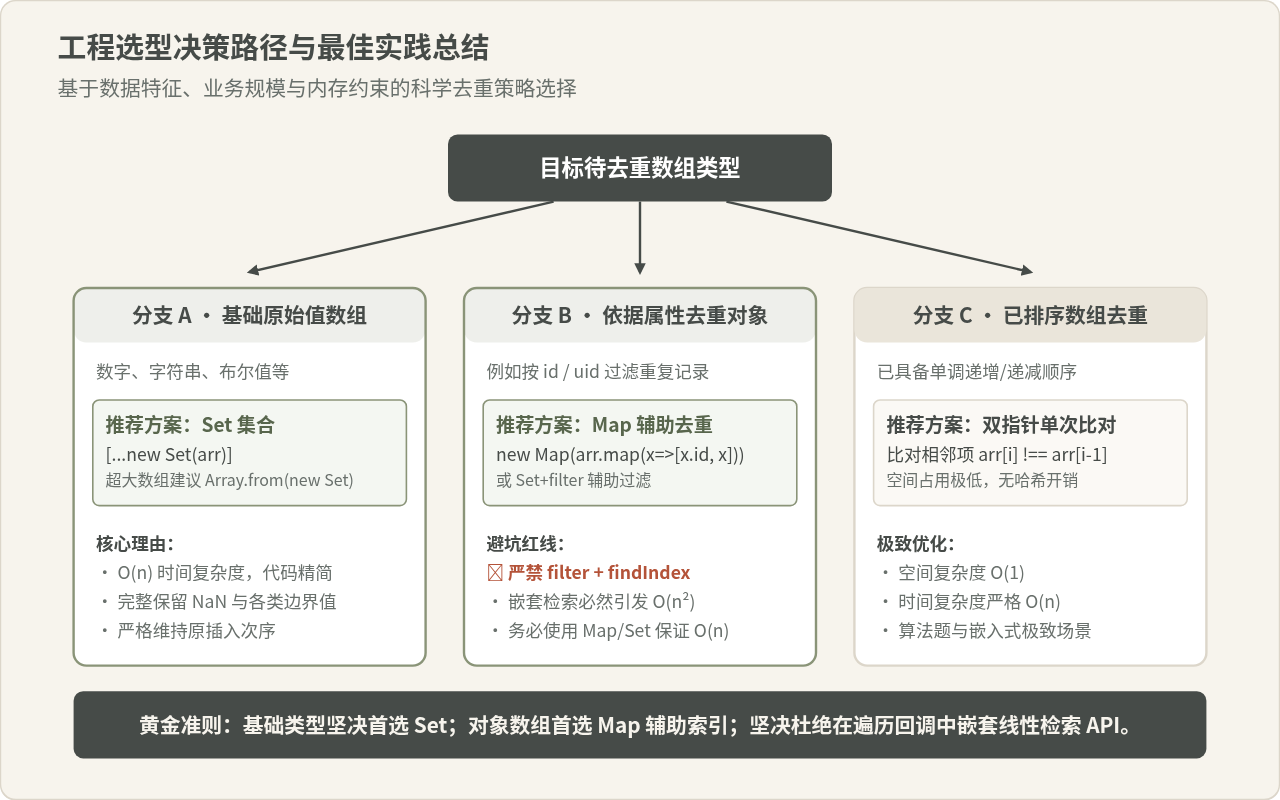
结合性能、边界正确性与代码可维护性,在实际工程中应按照如下决策路径选择去重方案:
1. 场景一:纯原始类型数组(数字、字符串、布尔值)
坚定选择 Set。代码简洁、表达意图明确,且具备最优的 O(n) 性能。
// 绝大多数情况直接简写:
const result = [...new Set(primitiveArray)];

// 若待处理数组极其庞大(例如数十万以上),为防止扩展运算符解构压栈过大,推荐写成:
const result = Array.from(new Set(primitiveArray));
2. 场景二:对象数组根据某一唯一属性(如 id)去重
切忌在 filter 内部套用 findIndex,那会重新把算法拉入 O(n²) 的泥潭。推荐使用 Map 保持 O(n) 线性性能:
// 方案 A:Map 单行构造法(优雅且高效)
const uniqueByProp = (arr, prop) =>
  [...new Map(arr.map(item => [item[prop], item])).values()];

// 方案 B:Set 辅助集合过滤法(保留首次出现的项,性能同样为 O(n))
const uniqueByPropFirst = (arr, prop) => {
  const seen = new Set();
  return arr.filter(item => {
    const key = item[prop];
    if (seen.has(key)) return false;
    seen.add(key);
    return true;
  });
};
3. 场景三:已经具备排序特征的数组
如果业务前置步骤已经对基础数组做好了升序或降序排序,我们甚至不需要申请哈希表的额外内存空间,直接使用双指针 / 单次遍历法即可实现 O(n) 时间复杂度与 O(1) 额外辅助空间复杂度:
const uniqueSortedArray = (sortedArr) => {
  if (!sortedArr.length) return [];
  const result = [sortedArr[0]];
  for (let i = 1; i < sortedArr.length; i++) {
    if (sortedArr[i] !== sortedArr[i - 1]) {
      result.push(sortedArr[i]);
    }
  }
  return result;
};
五、常见疑问与核心总结(FAQ)
Q1:使用 Set 去重后,元素原本的顺序会被打乱吗?
答:不会。ECMAScript 规范明确规定,
答:不会。ECMAScript 规范明确规定,
Set 集合的迭代遍历严格遵循元素的插入顺序(Insertion Order)。因此原数组中每个唯一值第一次出现的先后次序,在 [...new Set(arr)] 之后会得到 100% 的精准保留。
Q2:既然 Set 全面占优,reduce 数组去重还有什么存在的意义?
答:单纯的“去重”场景下,
答:单纯的“去重”场景下,
reduce + includes 确实没有任何性能或语法优势。但 reduce 的核心价值在于多任务管道聚合——例如在去重的同时需要完成属性格式转换、累加总价或统计出现频次。若必须在 reduce 中做去重判断,可配合外置 Set 或 Map 记录已处理标识,杜绝在回调中使用 includes 线性遍历。
全文核心结论速记:
- 常规去重,默认首选
Set:代码仅需单行,底层原生哈希优化,耗时稳稳维持在O(n),且完美支持NaN。 - 弃用
filter + indexOf去重:算法时间复杂度为O(n²),且存在悄然丢弃NaN的逻辑隐患。 - 警惕嵌套线性查找:无论是
filter、reduce还是循环,只要在回调内部调用indexOf、includes或findIndex,整体复杂度均会剧增为O(n²),必须使用Set/Map建立哈希索引进行解耦优化。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章