
详细讲解在JavaScript中截取包含中文、生僻字及特殊符号的字符串时,如何准确计算长度并彻底解决UTF-16码元撕裂与UTF-8字节截断造成的中文乱码问题,提供生产可用的完整方案。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串截取时怎么处理中文乱码或长度计算错误
作者:代码拾荒
时间:2026-11-03
浏览:177
文章目录
在 JavaScript 中截取字符串遇到中文乱码或长度计算失准,核心解决路径在于明确“截取度量维度”并避开原生 UTF-16 码元陷阱:若需要按纯字符个数截取,应使用支持 Unicode 码点的
[...str]、Array.from(str) 或 Intl.Segmenter,防止冷僻字与 Emoji 的代理对被撕裂;若属于后端存储或网络协议的字节限制(如 UTF-8 字节上限),应使用 TextEncoder 转为字节数组后实施尾部字节前缀回溯校验,剔除未闭合的多字节首部,从而彻底杜绝 \uFFFD 乱码。
一、为什么原生字符串截取会出现乱码与长度失真
很多开发者在处理用户输入或排版截断时,习惯直接调用 str.length 获取长度,并用 str.slice(0, n) 或 str.substring(0, n) 进行截取。这种做法在纯英文 ASCII 字符甚至大部分常用汉字下看似正常,但在遇到生僻字、部分符号或严格字节限制时,便会暴露出两类截然不同的缺陷。
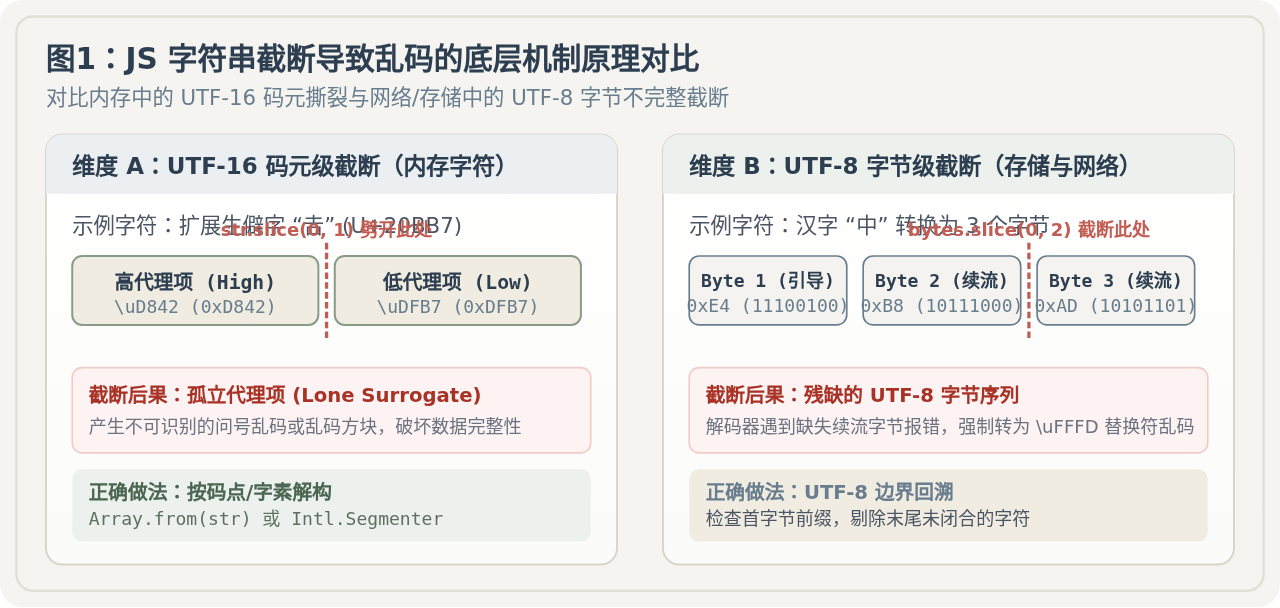
第一类是 UTF-16 码元拆分导致的乱码。JavaScript 的字符串在底层是以 UTF-16 编码单元(Code Units,每单元 16 位/2 字节)存储的。常用的中文字符(位于 Unicode 基本多语言平面 BMP,码点范围 U+0000 到 U+FFFF)刚好占用 1 个码元,因此 "中".length === 1。然而,扩展汉字(如生僻字“𠮷”、“𪚥”)以及大部分 Emoji 表情位于辅助平面(码点大于 U+FFFF),在 UTF-16 中必须使用一对 16 位码元表示,即“代理对”(Surrogate Pair)。
以“𠮷”字为例,其 Unicode 码点为 U+20BB7,在 UTF-16 中由高位代理 \uD842 与低位代理 \uDFB7 两个码元拼接而成。如果对包含该字的字符串执行 str.slice(0, 1),刚好切在两个代理项中间,截取结果将只保留前半个孤立代理项 \uD842。孤立代理项不是合法的 Unicode 字符,浏览器和操作系统在渲染时无法识别,便会将其展示为乱码符号(如问号或黑色菱形块)。
第二类是 字节阶段性截断导致的乱码。当业务系统要求“最多输入 20 个字节”或“后端字段为 VARCHAR(20) 字节限制”时,前端若先将字符串转为 UTF-8 字节流(或在 Node.js 中转为 Buffer)再直接按索引裁剪字节,由于常用汉字在 UTF-8 中编码为 3 个字节(生僻字与 Emoji 占 4 个字节),截断点一旦落在汉字内部的第 1 或第 2 个字节处,该汉字就会被破坏。随后调用 TextDecoder 或在网络传输到后端反序列化时,残缺的字节流无法组成合法字元,从而造成大面积乱码。
二、场景一:按字符维度截取——防止生僻字与复合字符分裂
当业务需求是“限制展示前 N 个文字”,且不管汉字、字母还是 Emoji 每一个均算作 1 个字符时,不能直接基于 str.slice() 截取。针对此场景,现代 JavaScript 提供了基于 Unicode 码点与字素簇的安全截取方式。
1. 基础解法:利用迭代器与解构语法(按码点截取)
ES6 的数组解构语法 [...str] 与 Array.from(str) 内部使用了字符串的默认迭代器,该迭代器基于完整的 Unicode 码点(Code Point)遍历,能够将高低代理对识别为一个整体。
// 安全字符截取:基于 Unicode 码点
function truncateByCodePoints(str, maxChars) {
  if (!str) return "";
  const chars = Array.from(str);
  if (chars.length <= maxChars) {
    return str;
  }
  return chars.slice(0, maxChars).join("");
}

// 验证测试
const text = "张𠮷祥"; // 中间为扩展汉字,长 2 码元
console.log(text.slice(0, 2));            // 输出: 带有孤立代理项的损坏字符
console.log(truncateByCodePoints(text, 2)); // 输出: "张𠮷" (完整保留汉字,无乱码)
2. 进阶解法:使用 Intl.Segmenter 处理复杂复合字符
部分特殊的文字组合(如带注音符号的汉字字符、带有肤色修饰符的 Emoji 或由零宽连接符 ZWJ 拼接的复合符号)由多个 Unicode 码点组成。如果仅使用 Array.from(),仍可能将修饰符与基础字符拆散。对于高保真场景,可以使用现代浏览器和 Node.js 原生支持的 Intl.Segmenter。
// 基于国际化标准字素簇(Grapheme Cluster)的安全截取
function truncateByGrapheme(str, maxCount) {
  if (!str) return "";
  if (typeof Intl !== "undefined" && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" });
    const segments = Array.from(segmenter.segment(str));
    if (segments.length <= maxCount) return str;
    return segments.slice(0, maxCount).map(s => s.segment).join("");
  }
  // 降级方案
  return truncateByCodePoints(str, maxCount);
}
三、场景二:按字节维度截取——满足后端限制且杜绝乱码
在很多数据库设计与报文交互中,限制是以字节为单位的。例如,数据库中某一列定义为 UTF-8 编码的 VARCHAR(60),意味着最多容纳 60 个字节。如果前端直接按字符截取 20 个汉字,一旦用户混入了 4 字节的 Emoji 或生僻字,总字节数便会突破 60 字节,导致后端存储失败;而若前端将字符串转为字节数组后盲目切片,又极易在字符中间切开。
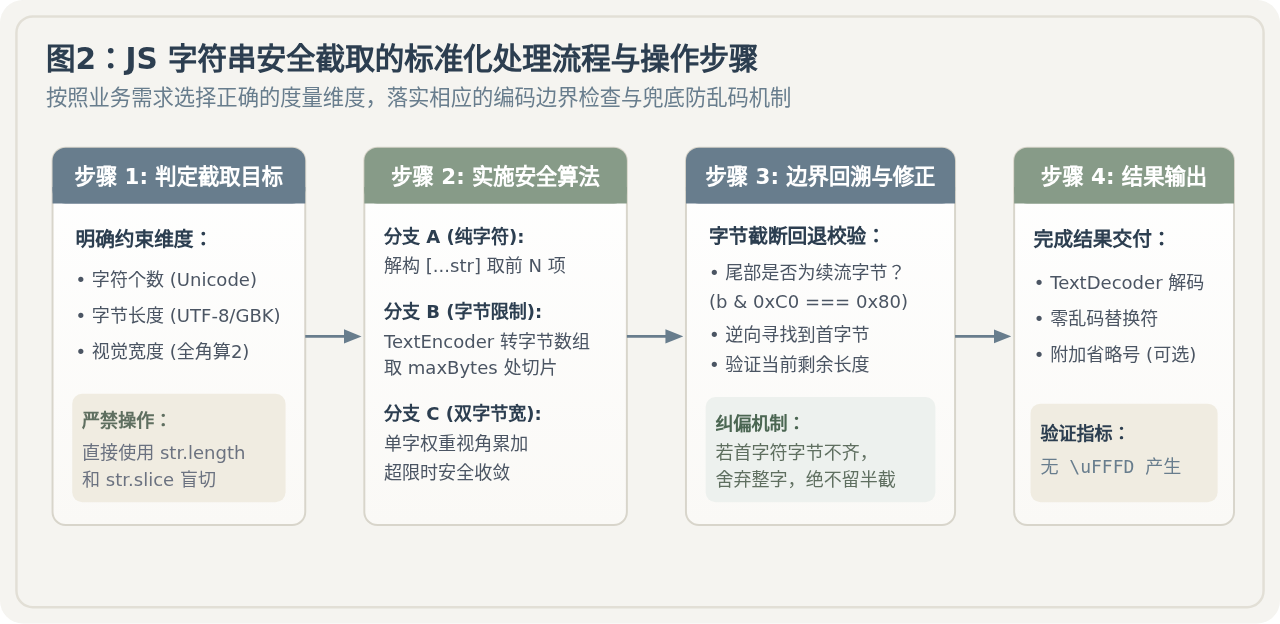
为了在严格满足最大字节数的前提下绝不产生乱码,必须遵循 UTF-8 编码的首字节与续流字节规则:
- 单字节 ASCII 字符:最高位为
0(形如0xxxxxxx,0x00 ~ 0x7F)。 - 多字节字符的后续字节(续流字节):最高两位为
10(形如10xxxxxx,即byte & 0xC0 === 0x80)。 - 双字节字符首字节:最高三位为
110(形如110xxxxx,即byte & 0xE0 === 0xC0)。 - 三字节字符首字节(绝大多数汉字):最高四位为
1110(形如1110xxxx,即byte & 0xF0 === 0xE0)。 - 四字节字符首字节(生僻字与 Emoji):最高五位为
11110(形如11110xxx,即byte & 0xF8 === 0xF0)。
处理步骤与算法逻辑:当截断索引恰好落在一个多字节字符的中间时,我们只需从截断点向前回溯,找到该多字节字符的首字节,并检查该字符的完整字节数是否已被全部包含。若未完整包含,则将这个未能闭合的字符完全剔除,只保留其前面已经完整的字元。
/**
 * UTF-8 字节长度安全截取函数
 * @param {string} str - 待截取的原始字符串
 * @param {number} maxBytes - 允许的最大 UTF-8 字节数
 * @returns {string} 截取后安全无乱码的字符串
 */
function truncateByUtf8Bytes(str, maxBytes) {
  if (!str || maxBytes <= 0) return "";

  const encoder = new TextEncoder();
  const bytes = encoder.encode(str);

  // 如果总字节数小于等于限制,直接返回原字符串
  if (bytes.length <= maxBytes) {
    return str;
  }

  let validIndex = maxBytes;

  // 检查截断位置是否为 UTF-8 续流字节 (10xxxxxx)
  // 0xC0 = 11000000, 0x80 = 10000000
  while (validIndex > 0 && (bytes[validIndex] & 0xC0) === 0x80) {
    validIndex--;
  }

  // 此时 validIndex 指向截断边界处字符的第一个字节(引导字节或ASCII)
  if (validIndex > 0) {
    const leadByte = bytes[validIndex];
    let expectedLength = 1;

    if ((leadByte & 0xE0) === 0xC0) {
      expectedLength = 2; // 双字节字符
    } else if ((leadByte & 0xF0) === 0xE0) {
      expectedLength = 3; // 三字节字符(常规中文)
    } else if ((leadByte & 0xF8) === 0xF0) {
      expectedLength = 4; // 四字节字符(生僻字/Emoji)
    }

    // 若该字符在 maxBytes 范围内无法完整闭合,则舍弃该字符的首字节
    if (validIndex + expectedLength > maxBytes) {
      // 保持 validIndex 之前的内容
    } else {
      validIndex += expectedLength;
    }
  }

  const decoder = new TextDecoder("utf-8");
  return decoder.decode(bytes.subarray(0, validIndex));
}

// 验证测试
const original = "编程技术"; // 每个汉字 3 字节,共 12 字节
// 假设限制为 5 个字节:
// "编"占 3 字节,"程"占 3 字节。5 字节无法容纳两个字。
const result = truncateByUtf8Bytes(original, 5);
console.log(result); // 输出: "编"(3字节),绝不截出半个"程"导致乱码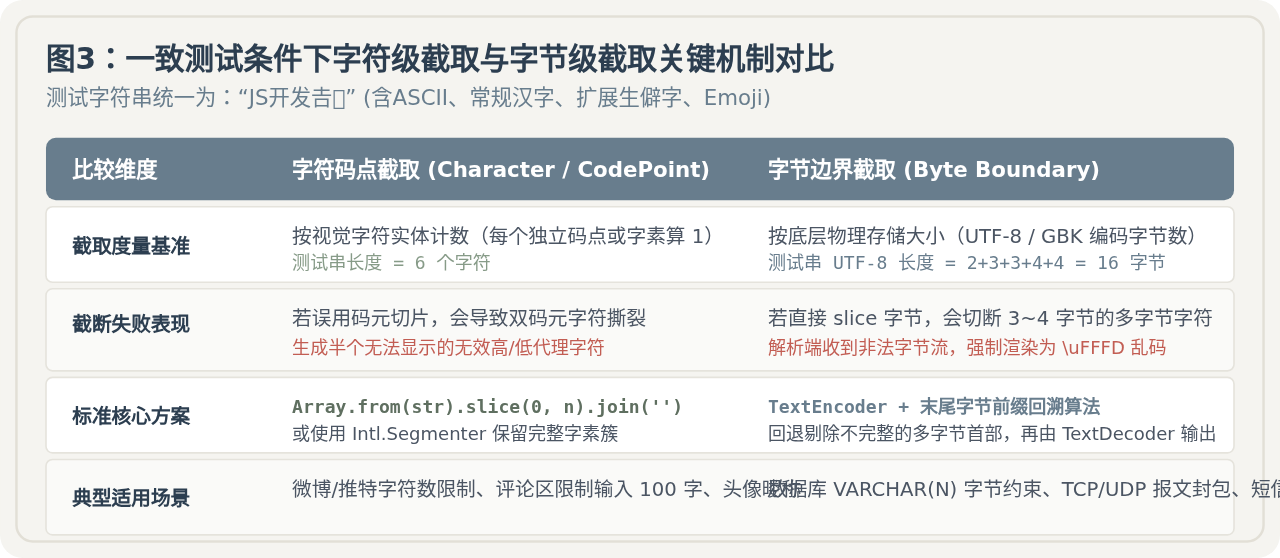
四、关键差异对比:字符截取 vs 字节截取
在实际开发中,将“字符截取”与“字节截取”混淆是引发线上乱码和数据截断缺陷的最常见原因。为了让读者在设计业务逻辑时能够明确选型,我们在一致的测试样本条件下对两种方案的关键差异进行对比:
| 对比维度 | 字符截取 (Character / CodePoint) | 字节截取 (Byte Boundary) |
|---|---|---|
| 度量基准 | 以人类视觉可见的独立字符为基准,1 个字素或码点计数为 1。 | 以计算机存储及网络传输的二进制字节数为基准(如 UTF-8 字节)。 |
| 长度与内容关系 | 长度只与字符数量相关,不受字符类型影响(ASCII、生僻字均占 1 字符)。 | 长度强烈依赖编码:英文 1 字节,常规汉字 3 字节,生僻字与 Emoji 4 字节。 |
| 原生切片缺陷 | 原生 str.slice 容易切散 UTF-16 代理对,破坏字符完整性。 |
原生切片若截断在汉字多字节内部,解码端必定产生 \uFFFD 乱码。 |
| 性能损耗 | 极低。仅需在内存中遍历字符串迭代器,无编解码转换开销。 | 较低至中等。涉及 TextEncoder 与 TextDecoder 的内存转换。 |
| 典型应用场景 | 前端 UI 界面标签省略、文章标题预览、输入框限制字数。 | 数据库表字段长度校验、二进制网络协议封包、GBK 打印机报文。 |
核心差异的影响原因:字符截取的本质是维持“语意完整”,确保用户看到的文字不出现断裂;而字节截取的本质是维持“容量合规”,确保底层系统不会因为内存溢出或字段溢出发生奔溃。当需要满足后端字节限制时,必须先满足字节上限,再在此上限内退回到字符边界,这也是字节截断算法必须向前回退的原因。
五、场景三:UI 排版中的“双字节”(全角算2)计算与截取
在国内的前端排版与表格展示中,经常存在一种折中规则:中文字符宽度约为英文字符的 2 倍。为了让不同语言组成的列表具有视觉对齐效果,产品规范通常会要求“中文字符记为 2,英文字符记为 1,最多展示 10 个单位长度,多余内容加省略号”。
如果直接按字节计算,UTF-8 下汉字算 3,会导致中文提前被过度截断;如果直接按 str.length 计算,又无法体现全角与半角的视觉宽度差异。正确的做法是逐字符判断其 Unicode 范围或视觉宽度,并动态累计长度。
/**
 * 获取单个字符的视觉宽度(中文与全角字符计为 2,半角字符计为 1)
 */
function getCharVisualWidth(char) {
  const code = char.codePointAt(0);
  // ASCII 范围
  if (code <= 0x007f) return 1;
  // 半角片假名及常用半角标点符号
  if (code >= 0xff61 && code <= 0xff9f) return 1;
  // 其余大部分 Unicode 区域(含汉字、全角标点、Emoji)计为 2
  return 2;
}

/**
 * 按双字节视觉宽度截取字符串,并安全补充省略号
 * @param {string} str - 原始字符串
 * @param {number} maxWidth - 最大宽度(每个汉字占 2,字母占 1)
 * @param {string} ellipsis - 超长时补充的后缀(如 '...')
 */
function truncateByVisualWidth(str, maxWidth, ellipsis = "...") {
  if (!str) return "";

  // 使用 Array.from 保证生僻字与 Emoji 不被撕裂
  const chars = Array.from(str);
  let totalWidth = 0;

  for (const char of chars) {
    totalWidth += getCharVisualWidth(char);
  }

  // 未超过限制直接返回
  if (totalWidth <= maxWidth) {
    return str;
  }

  // 计算省略号本身的宽度
  let ellipsisWidth = 0;
  for (const c of Array.from(ellipsis)) {
    ellipsisWidth += getCharVisualWidth(c);
  }

  const targetLimit = maxWidth - ellipsisWidth;
  let currentWidth = 0;
  const resultChars = [];

  for (const char of chars) {
    const w = getCharVisualWidth(char);
    if (currentWidth + w > targetLimit) {
      break;
    }
    currentWidth += w;
    resultChars.push(char);
  }

  return resultChars.join("") + ellipsis;
}

// 验证测试
const title = "JS深入浅出教程发布"; // 2(J)+1(S)+8*2(汉字) = 18 宽
console.log(truncateByVisualWidth(title, 10)); // 预留3个点,截断后输出: "JS深入..."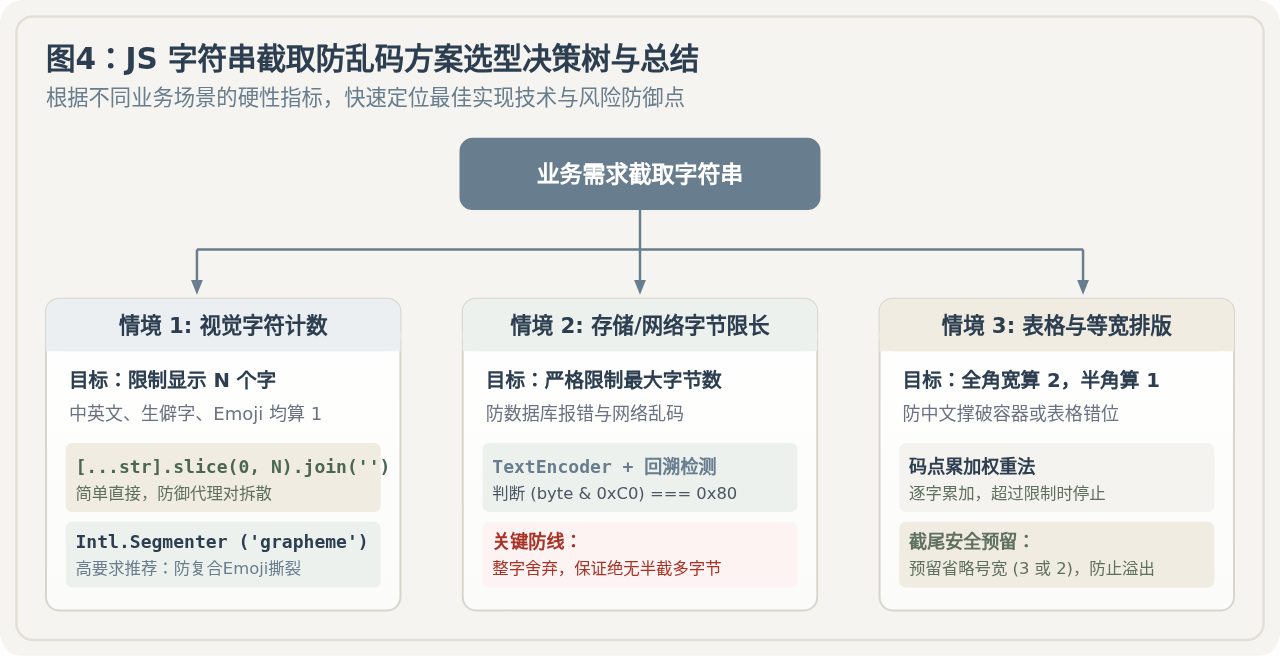
六、避坑提醒与常见问题
提醒 1:不要使用过时的正则表达式 /[\u4e00-\u9fa5]/ 判定中文
许多旧教程推荐使用 /[\u4e00-\u9fa5]/ 正则来匹配中文字符。该范围仅覆盖了 Unicode 4.0 之前的 CJK 统一表意文字基本区。大量现代人名、地名中常见的生僻字位于“CJK 扩展 A 到 G 区”(如“𠮷”在扩展 B 区 U+20BB7)。在 ES2018+ 环境下,应优先使用 Unicode 属性转义 /\p{Script=Han}/u,它能精准覆盖包括扩展生僻字在内的全部汉字,且不会造成代理对判断错漏。
提醒 2:避免使用已废弃的 String.prototype.substr()
substr(start, length) 方法在 ECMAScript 标准中已被列为废弃特性(Annex B Legacy Features),且它同样基于 UTF-16 码元操作,在不同运行时中可能存在细微行为差异。在需要基于索引截取时,请始终明确使用数组转换配合解构,或使用符合语义的标准 API。
提醒 3:服务端双重校验必不可少
前端的字符串截断主要服务于 UI 渲染质量与友好的用户体验,绝不能作为系统安全与数据合规的唯一关卡。恶意请求可能绕过前端脚本直接提交超长或非法代理项数据。后端在接收请求时,仍需基于自身的编码格式(如 Java 的 String.codePointCount 或 Go 的 utf8.RuneCountInString / 字节上限)做二次防御。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章