
全面解析在 JavaScript 中判断字符串是否以数组中任意元素开头的方法。从 some 与 startsWith 的基础组合,到短路执行机制、获取命中项、边界空串防坑以及大规模数据下的正则与前缀树选型。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS 判断字符串是否以数组中任意元素开头
作者:半夏
时间:2026-11-03
浏览:496
文章目录
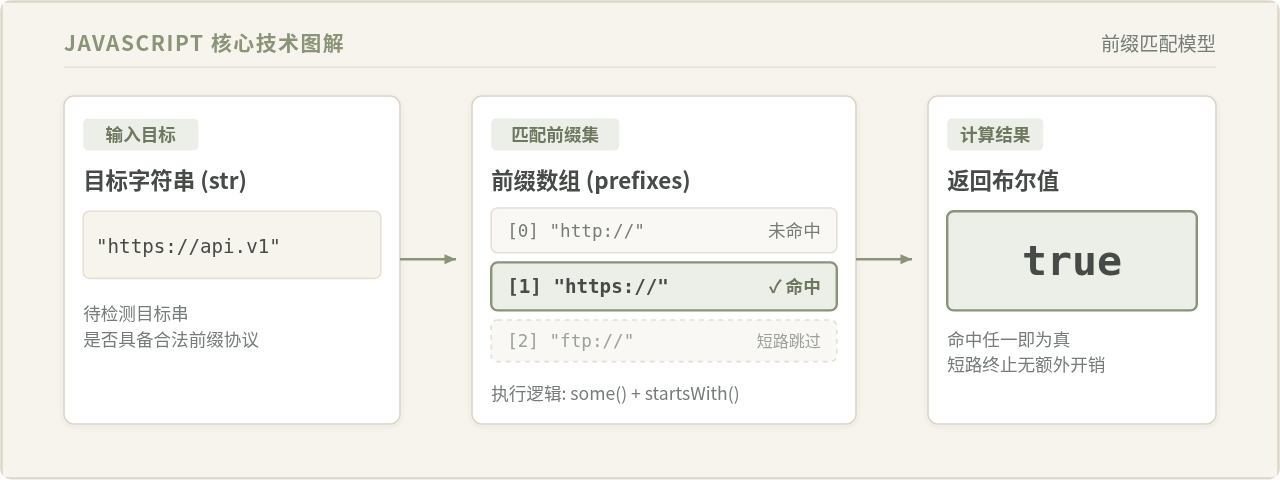
在 JavaScript 中,判断一个目标字符串是否以数组中的任意元素开头,最直接、规范且高效的方案是将数组的高阶方法 Array.prototype.some() 与字符串原生方法 String.prototype.startsWith() 组合使用:prefixes.some(prefix => str.startsWith(prefix))。该写法语义清晰,并且具备短路求值(Short-Circuiting)特性,一旦遇到第一个匹配成功的前缀就会立刻终止循环返回 true,若全部遍历完毕仍无匹配则返回 false。本文将围绕这一核心问题,详细剖析其运行机制、获取具体命中项的变体、容易被忽略的边界陷阱,以及在处理海量前缀时的性能选型。
一、基础方案:some() 与 startsWith() 组合
日常业务开发中最常见的场景之一就是路径或协议的白名单校验。例如,在处理前端路由或文件上传请求时,我们需要验证当前地址是否以某些特定的协议头开头。利用现代 JavaScript 的原生方法,只需一行代码即可完成:
// 1. 定义合法协议前缀数组
const allowedProtocols = ['https://', 'http://', 'ftp://'];

// 2. 待检测的目标字符串
const targetUrl = 'https://api.example.com/v1/users';

// 3. 执行判断
const isValid = allowedProtocols.some(protocol => targetUrl.startsWith(protocol));

console.log(isValid); // 输出: true
这套组合之所以成为推荐标准,主要归功于两者的职责明确与配合紧密:
String.prototype.startsWith(searchString):ECMAScript 2015 (ES6) 引入的原生方法,专门用于判断字符串是否以指定的子串开头,返回精确的布尔值。相较于旧代码中使用的indexOf(prefix) === 0,它的语义更具表现力。Array.prototype.some(callback):用于测试数组中是否至少有一个元素通过了提供的函数测试。其核心优势在于“短路执行”——从数组的第 0 个元素向后逐一判断,只要回调函数返回true,some()便会立即终止后续遍历,不再执行未检查的项。
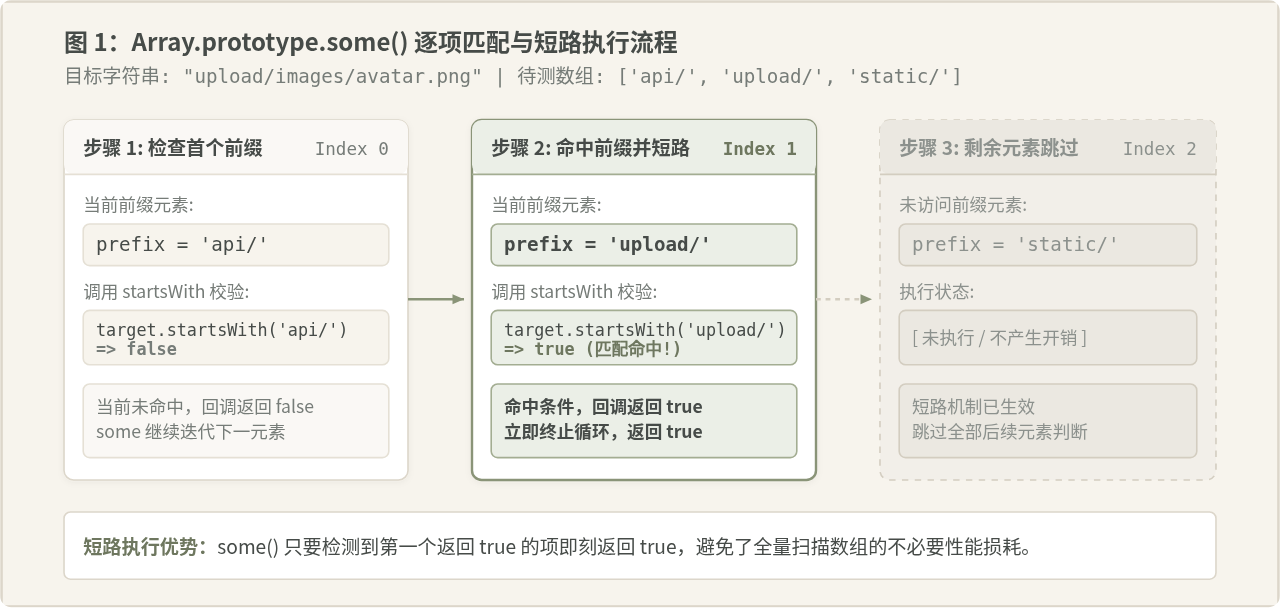
如图 1 所示,当目标字符串为 "upload/images/avatar.png",前缀数组为 ['api/', 'upload/', 'static/'] 时:
- 首先取出下标为 0 的元素
'api/',调用target.startsWith('api/')得到false,循环继续; - 接着取出下标为 1 的元素
'upload/',调用target.startsWith('upload/')得到true; - 此时
some()判定条件达成,不再访问下标 2 的'static/',直接向外层返回true。如果前缀数组规模较大且命中项位于靠前位置,这种短路特性可以节省不必要的比对开销。
二、进阶场景:获取具体命中的前缀
some() 解决的是“是否存在”的布尔判断问题。但在许多实际需求中,我们不仅要确认匹配成功,还需要拿到具体是“哪一个前缀”命中了目标,以便执行后续的数据清洗或分流。例如在重写路由或剥离 URL 协议时,必须精确知道前缀的长度。
此时,只需将 some() 替换为 Array.prototype.find() 即可:
const routePrefixes = ['/api/v1', '/api', '/auth'];
const requestPath = '/api/v1/user/profile';

// 使用 find 提取命中的具体前缀
const matchedPrefix = routePrefixes.find(prefix => requestPath.startsWith(prefix));

if (matchedPrefix) {
  // 剥离前缀,获取真实内部路径
  const realPath = requestPath.slice(matchedPrefix.length);
  console.log('命中前缀:', matchedPrefix); // "/api/v1"
  console.log('剥离后路径:', realPath);      // "/user/profile"
} else {
  console.log('未匹配到任何受支持的前缀');
}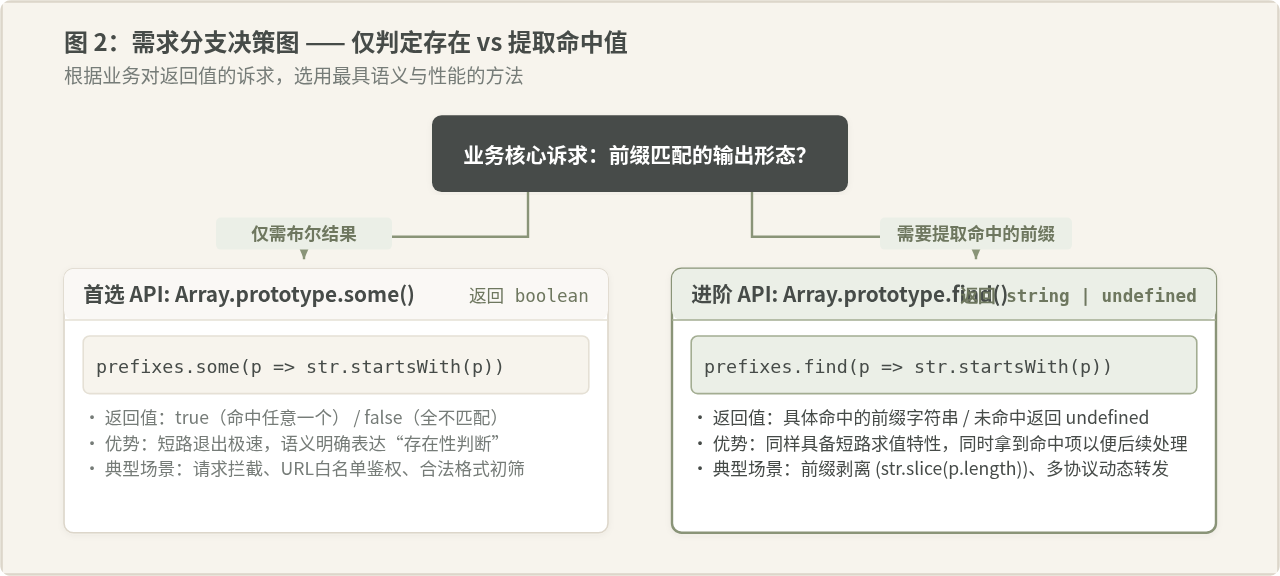
find() 与 some() 具有相同的短路求值特性。不同之处在于,find() 在遇到第一个满足回调函数的元素时,会直接返回该元素本身;若全部元素遍历完成仍无匹配,则返回 undefined。在 JavaScript 中,可以通过判断返回值是否为 undefined,同时兼顾存在性检查与值提取。
注意前缀重叠顺序:当数组中存在包含关系的前缀(例如
['/api', '/api/v1'])时,由于find()和some()是按数组索引顺序正向匹配的,若'/api'处于前面,目标'/api/v1/user'将率先命中短前缀。如果有“最长前缀优先匹配”的业务需求,应在匹配前先将前缀数组按长度降序排列:prefixes.sort((a, b) => b.length - a.length)。
三、容易混淆的边界条件与避坑指南
在简单的测试用例中,直接调用 prefixes.some(p => str.startsWith(p)) 往往表现正常,但在面对复杂用户输入或动态配置时,存在几个容易引发严重逻辑缺陷的隐蔽陷阱。
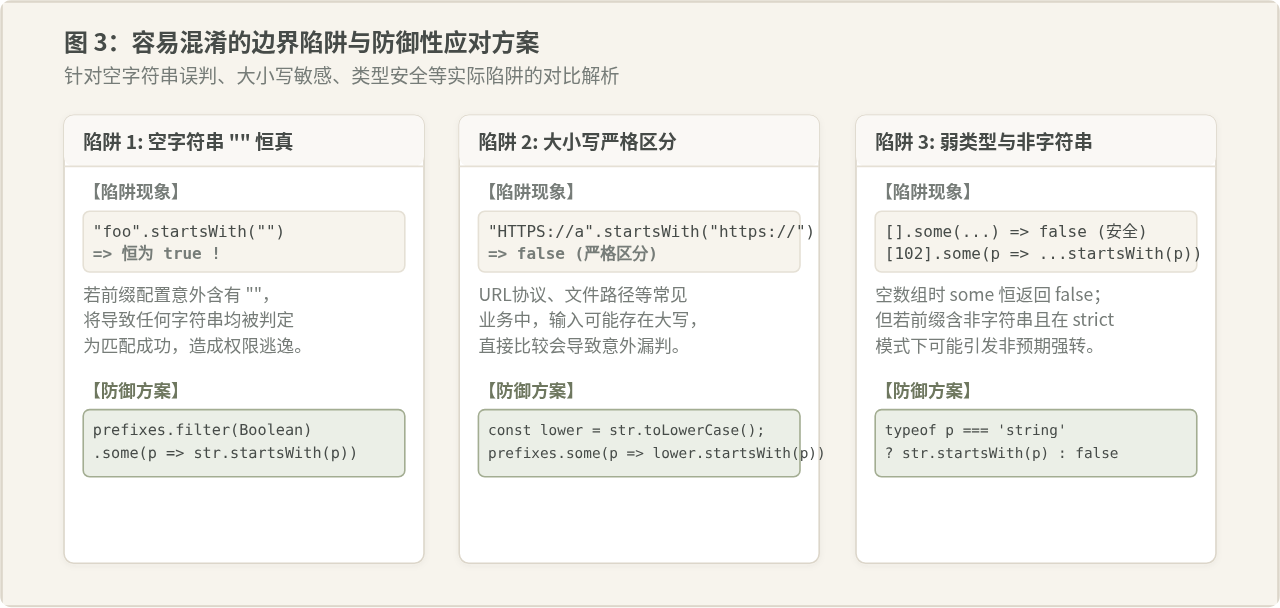
1. 空字符串 "" 导致无条件判定为真
在 JavaScript 标准规范中,任何字符串调用 startsWith("") 的结果恒为 true:
'https://example.com'.startsWith(''); // true
''.startsWith('');                    // true
如果前缀数组来自后台数据库、配置文件或者用户逗号分隔的输入框,一旦在解析时产生了空字符串元素(例如配置了 ['https://', '']),整个 some() 表达式对任意输入都将恒为 true,这在安全校验中可能导致拦截器形同虚设。防御做法:在执行匹配前先过滤掉假值或空字符串,即 prefixes.filter(Boolean)。
2. 忽略大小写引发的漏判
startsWith() 是严格区分大小写的。诸如网络协议头或操作系统路径可能包含大写输入(如 HTTPS://SITE.COM 或 C:\Users)。如果前缀数组统一为小写 ['https://'],直接检测就会判定为 false。为提高代码鲁棒性,可在比对时统一转为小写:
const lowerStr = str.toLowerCase();
const hasPrefix = prefixes.some(p => lowerStr.startsWith(p.toLowerCase()));
3. 空数组与类型安全
当传入的前缀数组为空数组 [] 时,根据规范,空数组调用 some() 永远返回 false,这完全符合“没有任何元素匹配”的语义,无需在外部额外包裹 prefixes.length > 0 的判断。但如果数组元素中混入了 null 或 undefined,直接传入 startsWith() 会被自动强制类型转换为 "null" 或 "undefined" 进行前缀匹配,引发难以排查的非预期结果,建议显式过滤非字符串元素。
四、大规模前缀场景下的技术方案选型
在日常开发中,前缀数组通常只有几个到数十个元素,some() + startsWith() 的耗时通常在微秒级别,属于最优选择。但在高频网关、防火墙规则比对或大规模敏感词过滤等场景中,前缀数量可能达到上千甚至数万个,此时需根据规模切换更适合的数据结构。
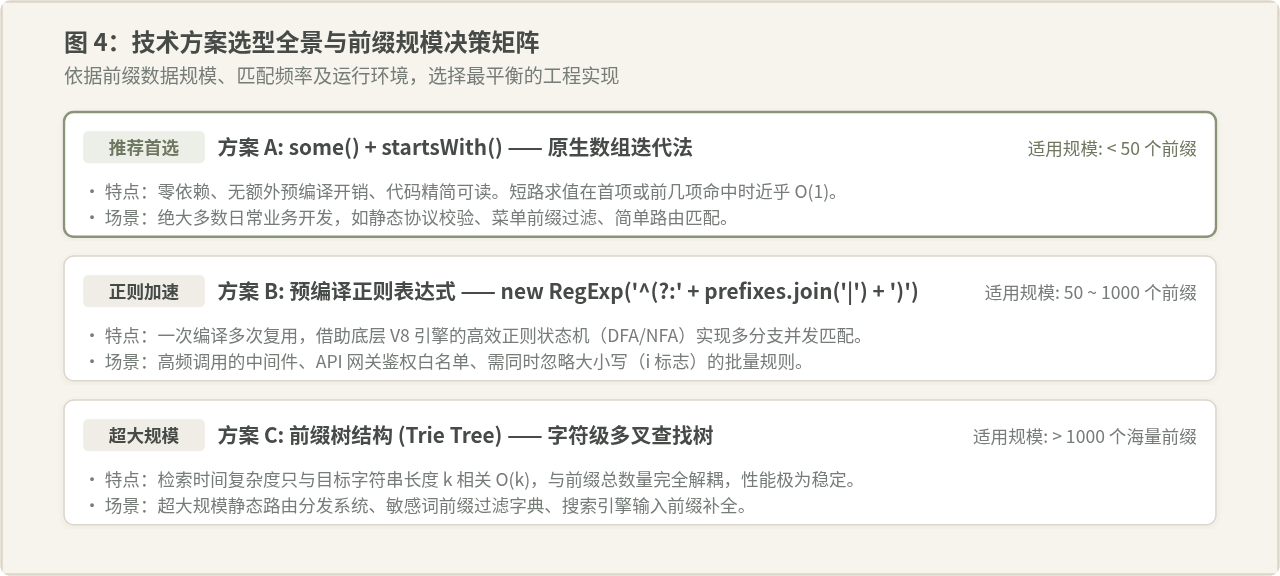
| 技术方案 | 适用规模 | 时间复杂度 | 核心优势与局限 |
|---|---|---|---|
| some() + startsWith() | < 50 个元素 | O(n × m) | 标准原生语法,0 内存预编译开销,短路迅速,代码极其简洁。但在数千条前缀且全部未命中时会全量扫描。 |
| 预编译正则表达式 | 50 ~ 1000 个元素 | 接近 O(m) | 利用 V8 引擎底层 NFA/DFA 状态机并发比对,支持 i 忽略大小写;需要预先对特殊字符进行转义。 |
| 前缀树 (Trie 树) | > 1000 个海量元素 | O(k) | 检索时间只与目标字符串长度相关,与前缀数量彻底解耦;需要构建树形结构的内存开销。 |
针对中等规模(如 100 ~ 500 个静态前缀)的性能敏感场景,借助正则表达式的构建示例如下:
// 正则转义辅助函数,避免前缀中含问号、点、星号等符号破坏正则语法
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 预先编译正则(适合作为全局单例常量复用)
const prefixRegex = new RegExp(
  '^(?:' + prefixes.filter(Boolean).map(escapeRegExp).join('|') + ')',
  'i' // 可选:忽略大小写
);

// 匹配判断
const isMatch = prefixRegex.test(targetString);
五、生产环境推荐封装
结合上述分析的所有边界安全与大小写兼容考量,我们可以在项目中沉淀一个具备健壮容错能力的工具函数:
/**
 * 判断字符串是否以数组中任意有效元素开头
 * @param {string} str - 目标待检测字符串
 * @param {string[]} prefixes - 前缀候选数组
 * @param {object} [options] - 可选配置项
 * @param {boolean} [options.ignoreCase=false] - 是否忽略大小写
 * @returns {boolean} 是否匹配成功
 */
function startsWithAny(str, prefixes, options = {}) {
  if (typeof str !== 'string' || !Array.isArray(prefixes)) {
    return false;
  }

  const { ignoreCase = false } = options;
  const target = ignoreCase ? str.toLowerCase() : str;

  return prefixes.some(prefix => {
    // 剔除非字符串及空字符串,防止误判
    if (typeof prefix !== 'string' || prefix.length === 0) {
      return false;
    }
    const p = ignoreCase ? prefix.toLowerCase() : prefix;
    return target.startsWith(p);
  });
}

// 示例验证
console.log(startsWithAny('HTTPS://example.com', ['https://', 'http://'], { ignoreCase: true })); // true
console.log(startsWithAny('app/main.js', ['', 'dist/'])); // false (安全排除空字符串)
console.log(startsWithAny('app/main.js', ['app/', 'src/']));   // true
总结而言,在 JavaScript 中解决“判断字符串是否以数组中任意元素开头”的问题,核心在于理解并运用 Array.prototype.some() 与 String.prototype.startsWith() 的组合。在需要提取匹配值时切换为 find(),同时在实际工程落地时注意过滤空字符串配置并统一大小写,便能保证代码兼具简洁性、执行效率与生产健壮性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章