
深入对比JavaScript函数内循环中直接使用return与break的本质差异,涵盖控制流终点、返回值传递、多层嵌套穿透、高阶函数陷阱及工程实践选型。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JS函数内循环直接用return退出与break的区别
作者:函数茶馆
时间:2026-11-03
浏览:619
文章目录
JavaScript 实战
控制流与作用域
难度:中级
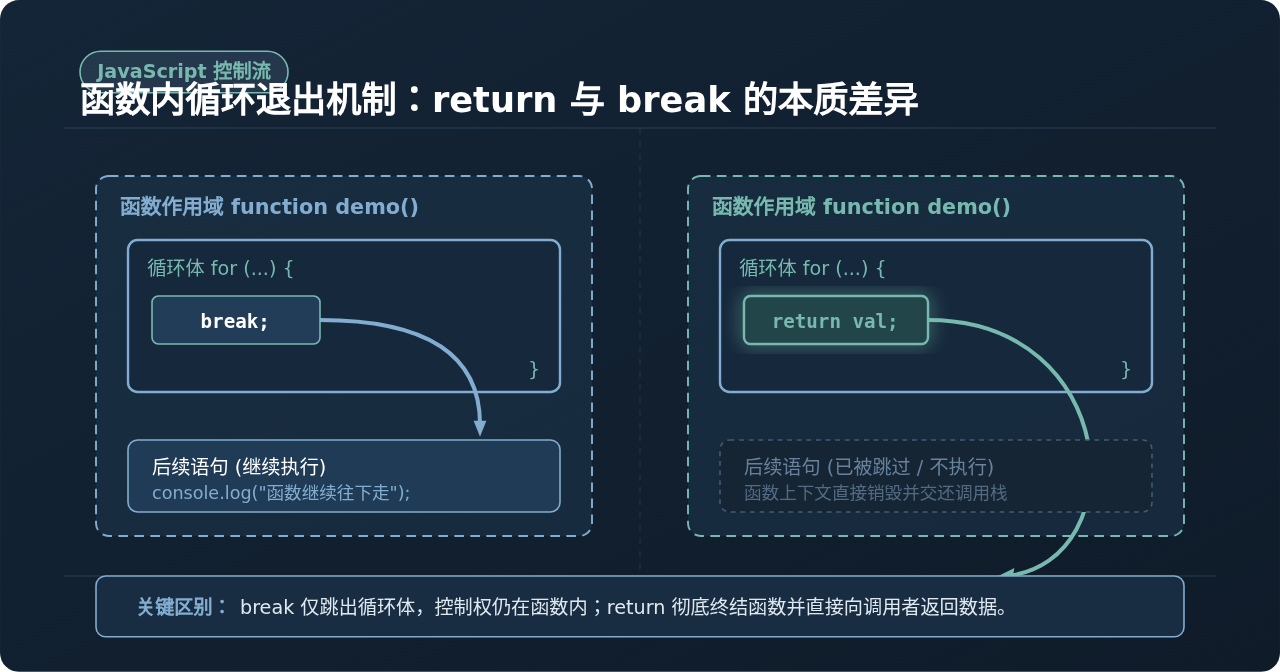
假设你正在编写一个根据用户 ID 检索并组装用户信息的函数。在遍历数组的过程中,一旦匹配到目标对象,你就面临两个选择:是写下 break 还是直接写下 return?表面上看,这两种写法都能立即阻断循环体继续处理后续剩余的数据,但它们向 JavaScript 运行时发出的控制流指令有着本质区别:break 的作用边界被严格限制在当前循环体内,循环结束后函数后续的逻辑仍会继续执行;而 return 则是整个函数作用域的终点,它会立即截断函数内部尚未执行的所有代码,将结果直接交还给外部调用方。
一、核心结论先行:作用域边界与控制流终点
在 JavaScript 中,语句的执行受制于其生效的上下文边界。要理清二者的差别,首先要明确它们分别服务于哪一层执行环境:
- break 语句:属于循环控制语句。它的控制范围仅限于当前所在的那一层循环结构(例如
for、while或switch)。当代码执行到break时,解释器立即终止循环的迭代,并将程序执行指针跳转到紧跟在循环闭合花括号之后的第一行语句。函数本身的执行上下文完好无损,函数后续的代码依旧按序执行。 - return 语句:属于函数控制语句。它的控制范围是整个宿主函数(Host Function)。不论
return潜藏在第几层嵌套循环或条件块中,一旦被触发,它会瞬间穿透所有循环边界,彻底终结函数的执行,并把指定的值作为返回值递交给调用栈。循环体之后的任何函数级代码都将直接被短路跳过。
二、通过具体检索任务对比执行步骤
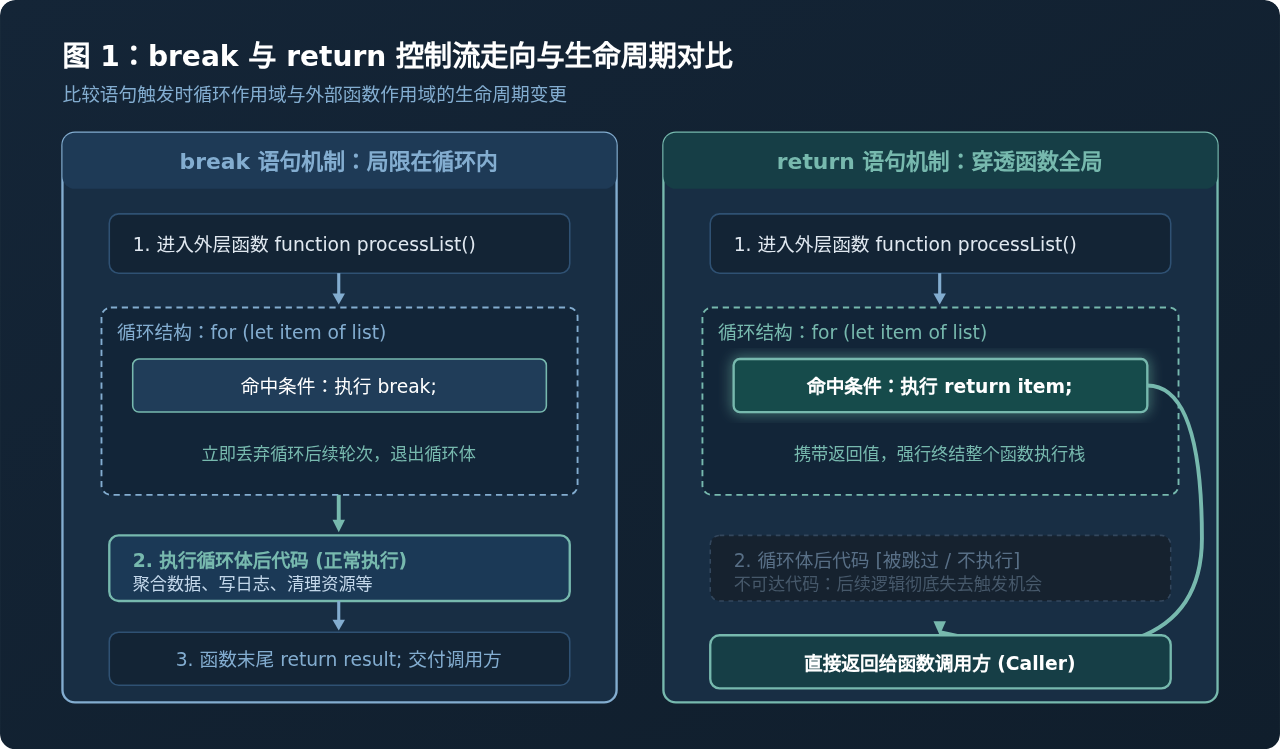
为了直观展现两者在运行轨迹上的差异,我们来看一个包含数据提取与格式化流程的典型业务函数。代码需要在用户列表中找到符合条件的用户,并调用辅助方法加工后返回。
1. 使用 break 的实现方式与执行轨迹
// 方式 A:使用 break 控制循环
function findAndFormatUserWithBreak(users, targetId) {
  let matchedUser = null;

  for (let i = 0; i < users.length; i++) {
    if (users[i].id === targetId) {
      matchedUser = users[i];
      break; // 仅跳出 for 循环
    }
  }

  // 循环结束后的逻辑仍会正常执行
  if (!matchedUser) {
    return "用户不存在";
  }

  const formattedInfo = `[ID: ${matchedUser.id}] 姓名: ${matchedUser.name}`;
  return formattedInfo;
}在该流程中,break 充当的是“阶段性收工”的标记:遍历任务已经找出目标,无需继续比对剩余数组项,因此提前结束迭代。但此时函数并未执行完,控制权顺利交到循环下方的判断与格式化代码,最后由函数底部的 return formattedInfo 返回最终数据。
2. 使用 return 的实现方式与执行轨迹
// 方式 B:使用 return 提前返回
function findUserDirectlyWithReturn(users, targetId) {
  for (let i = 0; i < users.length; i++) {
    if (users[i].id === targetId) {
      // 找到即返回,不仅跳出循环,而且直接终结函数
      return users[i];
    }
  }

  // 只有当整个循环完全走完且没有命中时,才会执行到这里
  return null;
}
如果在上一个例子的循环体内误写成了 return matchedUser;,那么循环下方的 formatUserData() 以及字符串拼接代码将永远失去执行的机会。这就是两者在业务链条中最大的行为鸿沟。
三、多层嵌套循环中的穿透能力与边界
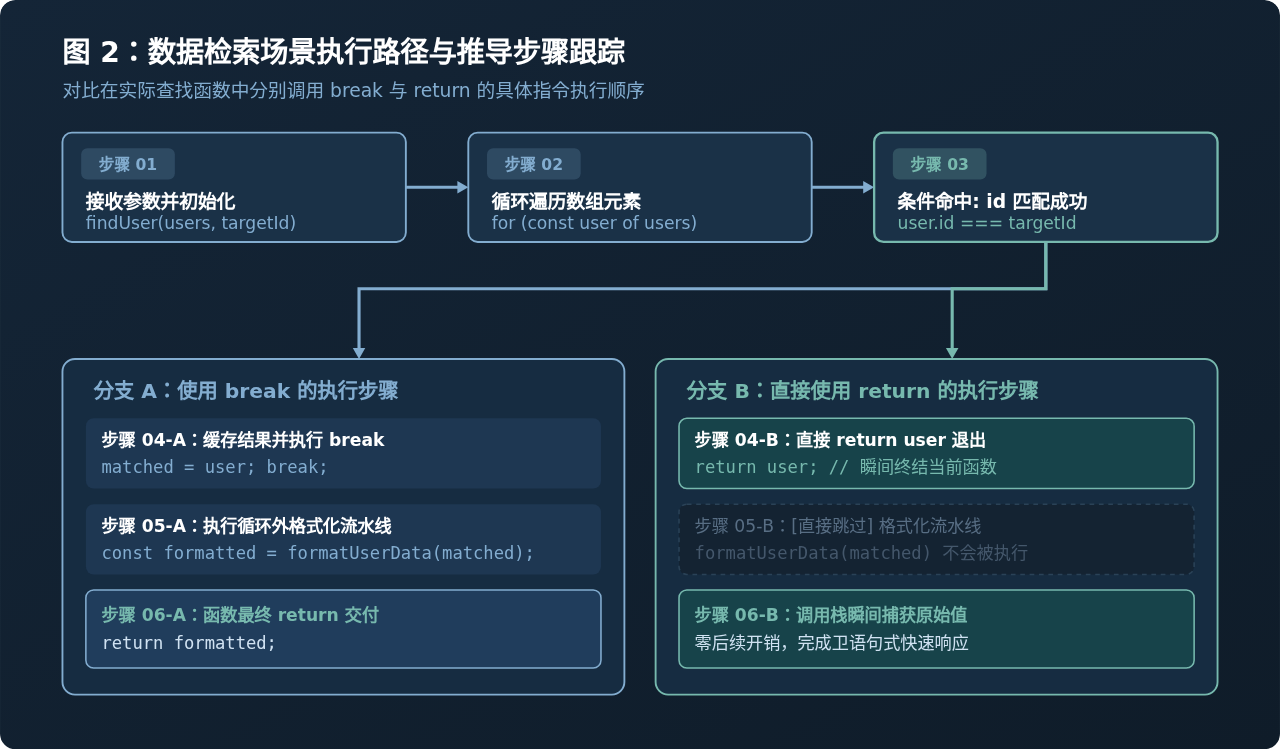
当面对二维矩阵、树形结构或多维数组检索时,return 与 break 的差异会进一步放大。因为普通的 break 存在“单层跳出”的刚性限制。
1. 单层 break 无法打断外层循环
默认情况下,在内层循环中使用 break,只会打破内层当前的扫描,控制权随后回退到外层循环,外层循环紧接着会推进到下一个迭代。如果目标是“找到一个满足条件的元素即全部停止”,单纯依赖普通 break 必须借助额外的标志位:
// 单层 break:必须手动维护标志位
function findCoordinateWithBreak(matrix, target) {
  let result = null;
  let isFound = false;

  for (let r = 0; r < matrix.length; r++) {
    for (let c = 0; c < matrix[r].length; c++) {
      if (matrix[r][c] === target) {
        result = { row: r, col: c };
        isFound = true;
        break; // 仅仅退出了内层的 c 循环!
      }
    }
    if (isFound) {
      break; // 必须再写一个 break 跳出外层的 r 循环
    }
  }

  return result;
}
2. return 的无视层级穿透力
与 break 的步步为营相比,在函数内遇到 return,解释器不会在乎你嵌套了多少层 for、while 或 do-while。它立即撤销所有循环上下文,连同函数上下文一并收束:
// return:无论嵌套多深,一行代码直接穿透全部层级
function findCoordinateWithReturn(matrix, target) {
  for (let r = 0; r < matrix.length; r++) {
    for (let c = 0; c < matrix[r].length; c++) {
      if (matrix[r][c] === target) {
        return { row: r, col: c }; // 瞬间退出 innerLoop、outerLoop 及整个函数
      }
    }
  }

  return null; // 矩阵中无匹配项
}
如果业务确实需要在退出多层循环后继续留在函数内跑后续代码,可以使用 JavaScript 的标签语句(Labeled Statements),如 break outerLoop;。但这仍然只是跳出标记的循环块,并没有脱离当前函数。
四、开发中必须注意的高频陷阱
1. Array 原型方法(forEach、map、filter)中的致命假象
现代前端开发中经常使用 forEach 替代传统 for 循环,很多初学者在此处极易产生概念混淆:
语法与行为陷阱:
• 在
• 在
• 在
forEach 的回调函数中使用 break 会直接抛出语法错误:Uncaught SyntaxError: Illegal break statement,因为回调函数本身不是一个循环语句体。• 在
forEach 的回调函数中使用 return,根本无法退出宿主外部函数,甚至连 forEach 自身的遍历都无法中断!它仅仅退出了当次回调,其效果完全等同于普通循环中的 continue。
function testForEachTrap() {
  const list = [1, 2, 3, 4, 5];

  list.forEach(item => {
    if (item === 3) {
      return; // 仅仅相当于 continue!当前轮次回调结束,下一轮继续执行!
    }
    console.log("处理项:", item);
  });

  console.log("外层函数执行完毕");
}
// 实际打印输出:处理项: 1 -> 处理项: 2 -> 处理项: 4 -> 处理项: 5 -> 外层函数执行完毕
// 第 3 项被跳过,但整个遍历和外层函数均未被中止!
如果需要在迭代中根据条件彻底跳出或立即返回结果,切勿使用 forEach,而应优先改用 ES6 的 for...of 循环,或者使用原生数组查找方法 Array.prototype.find() 或 Array.prototype.some()。
2. try...finally 结构对控制流的拦截
无论在循环内使用的是 break 还是 return,只要它们处于 try 块内部,且下方紧跟着 finally 语句块,finally 中的代码绝对会抢先执行,之后才会继续兑现 break 或 return 的转移意图:
function traceFinallyBehavior() {
  for (let i = 0; i < 3; i++) {
    try {
      if (i === 1) {
        return "来自 return 的返回值";
      }
    } finally {
      console.log("finally 块抢先执行,当前 i =", i);
    }
  }
}
// 调用结果:控制台先输出 "finally 块抢先执行,当前 i = 1",然后外部接收到返回值
五、选型决策指南与特性总结
在日常代码审查与重构过程中,可以根据以下标准快速确定选用 break 还是 return:
- 使用 return 的黄金场景:符合卫语句(Guard Clauses)或快速失败(Early Return)理念。当循环的核心目的就是为了得出一个具体的结果(例如查找、校验合法性、匹配单项),一旦得出结论,函数使命即告达成。此时直接
return能彻底消除临时中间变量(如let found = null;),降低心智负担。 - 使用 break 的黄金场景:循环仅仅是整个函数多个执行阶段中的其中一个步骤。循环的主要职责是计算或搜集必要数据,循环结束后还需要进行数据拼装、事务提交、释放句柄、格式转换或打点统计。此时必须使用
break保留后续流程的生命线。
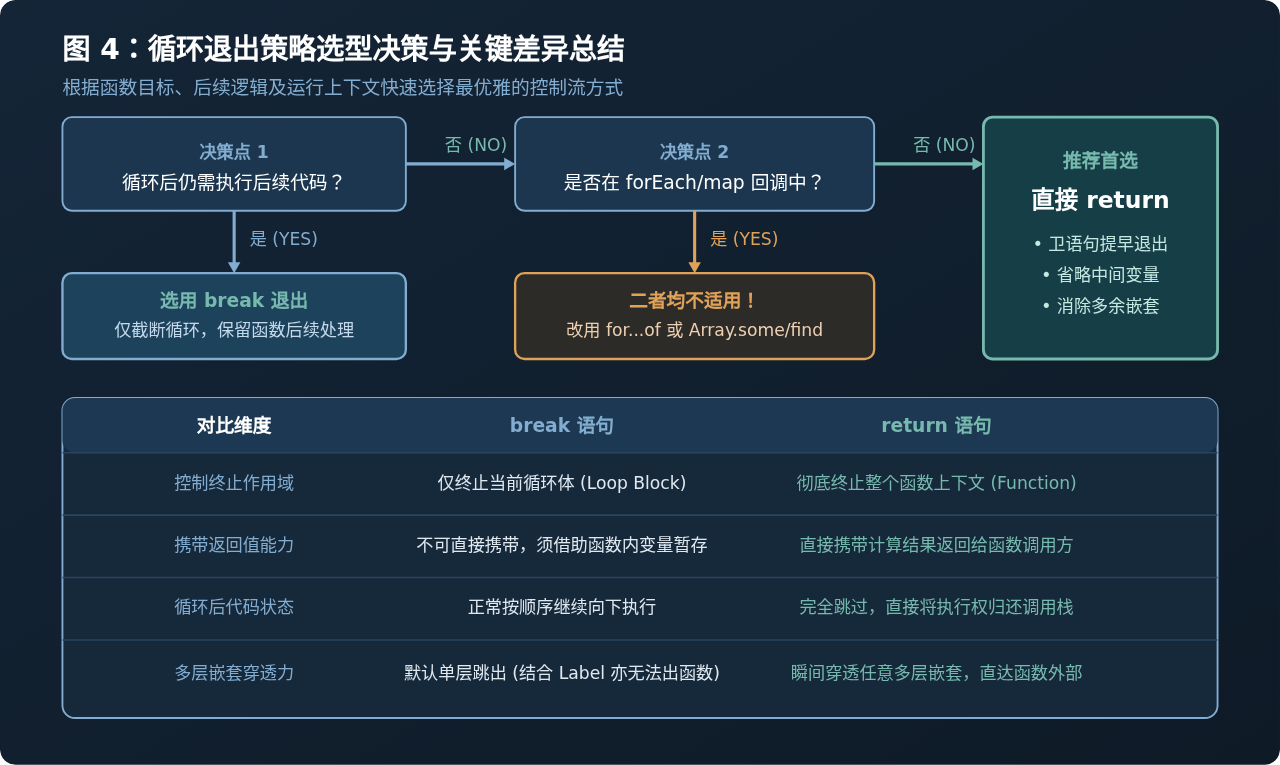
| 对比维度 | 循环内 break 退出 | 循环内 return 退出 |
|---|---|---|
| 控制流终止范围 | 仅退出当前循环体,留在当前函数中 | 退出当前循环,并立即销毁当前函数上下文 |
| 数据交付能力 | 无法直接返回,需赋值给外部临时变量 | 直接携带有价值的变量/表达式返回给调用栈 |
| 循环后代码可达性 | 完全可达,按正常流程顺序执行 | 不可达,循环后的函数级代码被直接跳过 |
| 多层嵌套穿透性 | 默认仅穿透 1 层(带标签可跳出多层循环) | 无视嵌套深度,强行穿透所有层级直达外部 |
| forEach 等回调中 | 报语法错误 (SyntaxError: Illegal break) | 仅等效于 continue,无法跳出宿主函数 |
| 典型设计范式 | 多阶段流水线处理、局部数据聚合 | 卫语句提前返回、单目标查找、快速失败 |
理解 break 与 return 的核心边界,不仅能帮助我们避免写出“代码意外被跳过”或“死循环无法截断”的逻辑缺陷,更能促使我们在设计函数时建立更清晰的数据流思维——让单一职责的小函数通过 return 提早结束,让包含组合逻辑的过程函数通过 break 精准分流。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章