
全面讲解在JavaScript中按值删除数组指定元素的实用解法,包括filter非破坏性删除、indexOf搭配splice原地删除、倒序循环防漏删机制以及对象数组与批量删除场景的最佳实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组怎么按值删除指定元素
作者:半夏
时间:2026-11-03
浏览:622
文章目录
ECMAScript 实用技巧
在 JavaScript 中,原生
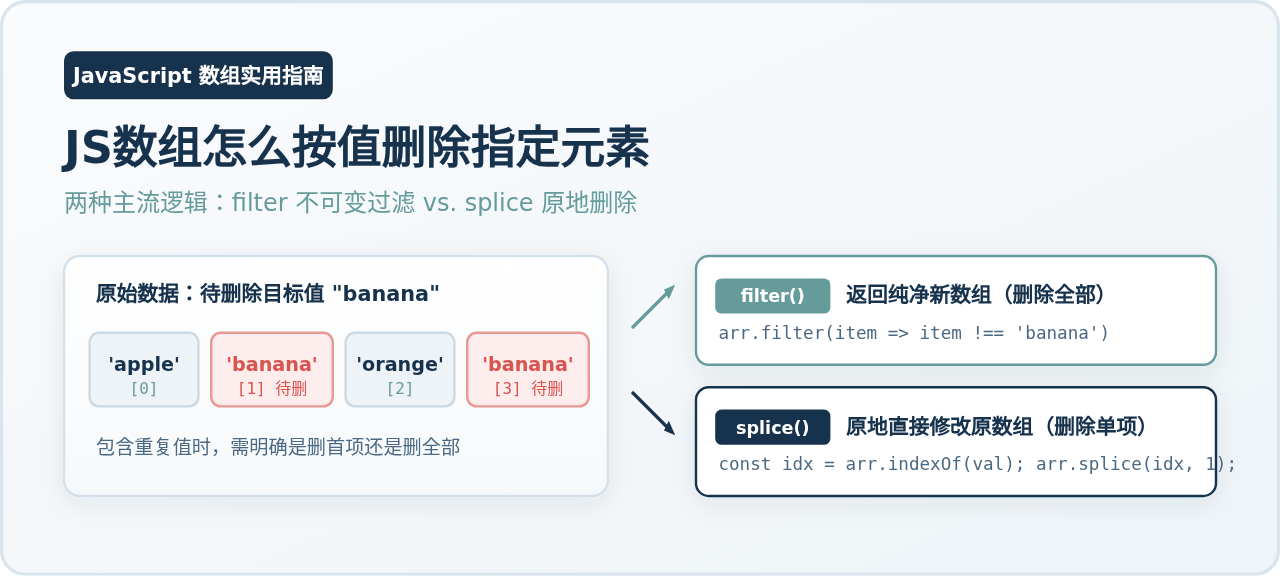
Array.prototype 并没有提供类似于 array.remove(value) 的直接按值删除方法。解决该问题的核心在于明确两点诉求:是否需要保留原数组(原地修改还是产生新数组),以及是仅删除首个匹配项还是剔除全部重复项。针对不可变场景,推荐使用 filter();针对原地修改场景,推荐使用 indexOf() 配合 splice()。
按值删除元素概览:不可变过滤与原地删除的核心路径
一、最常用方案:使用 filter() 纯函数过滤(删除全部匹配值)
在现代 JavaScript 与前端组件化开发(例如 React 或 Vue)中,不可变数据理念非常普及。如果希望在删除指定元素的同时不破坏原数组,filter() 是最简洁优雅的方法。
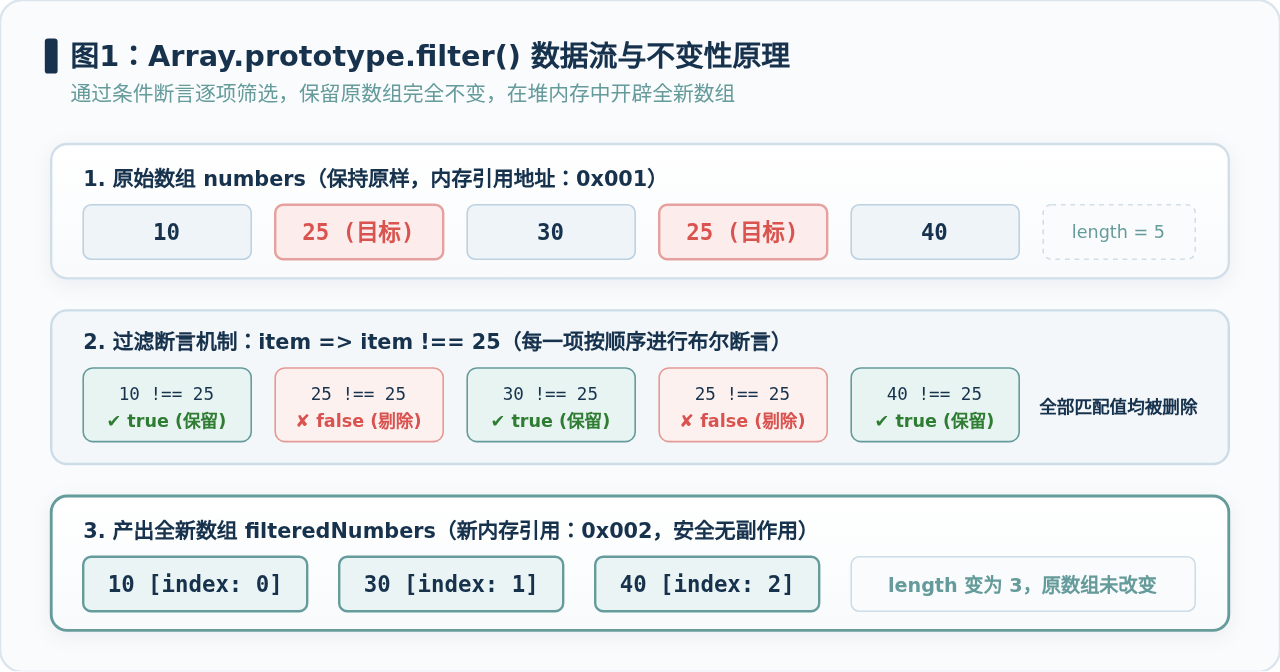
filter() 会遍历数组中的每一项,执行你传入的断言测试函数。只有返回值为 true 的元素才会被放入新数组,因此只需将测试条件写为“不等于目标值”即可过滤掉所有匹配项。
const numbers = [10, 25, 30, 25, 40];
const target = 25;

// 过滤掉所有等于 25 的项,返回新数组
const result = numbers.filter(item => item !== target);

console.log(result);   // 示例输出: [10, 30, 40]
console.log(numbers);  // 示例输出: [10, 25, 30, 25, 40] (原数组保持不变)
这段代码的操作逻辑有三个关键特点:
- 自动剔除所有重复项:如果数组中存在多个与
target相等的元素(如上例中的两个25),它们都会在一次遍历中被全部剔除。 - 原数组无副作用:原数组
numbers依然完好无损,在多模块数据共享或状态驱动视图时避免意外修改引发的数据冲突。 - 时间复杂度平稳:单次遍历完成筛选,时间复杂度为稳定的大
O(n)。
图1:Array.prototype.filter() 数据流与内存表现
二、原地修改:使用 indexOf() 搭配 splice()(删除首个匹配值)
在处理超长数据或对内存分配敏感的场景中,如果明确需要修改原数组本身,可以使用 indexOf() 定位元素位置,再调用 splice() 移除该位置上的项。
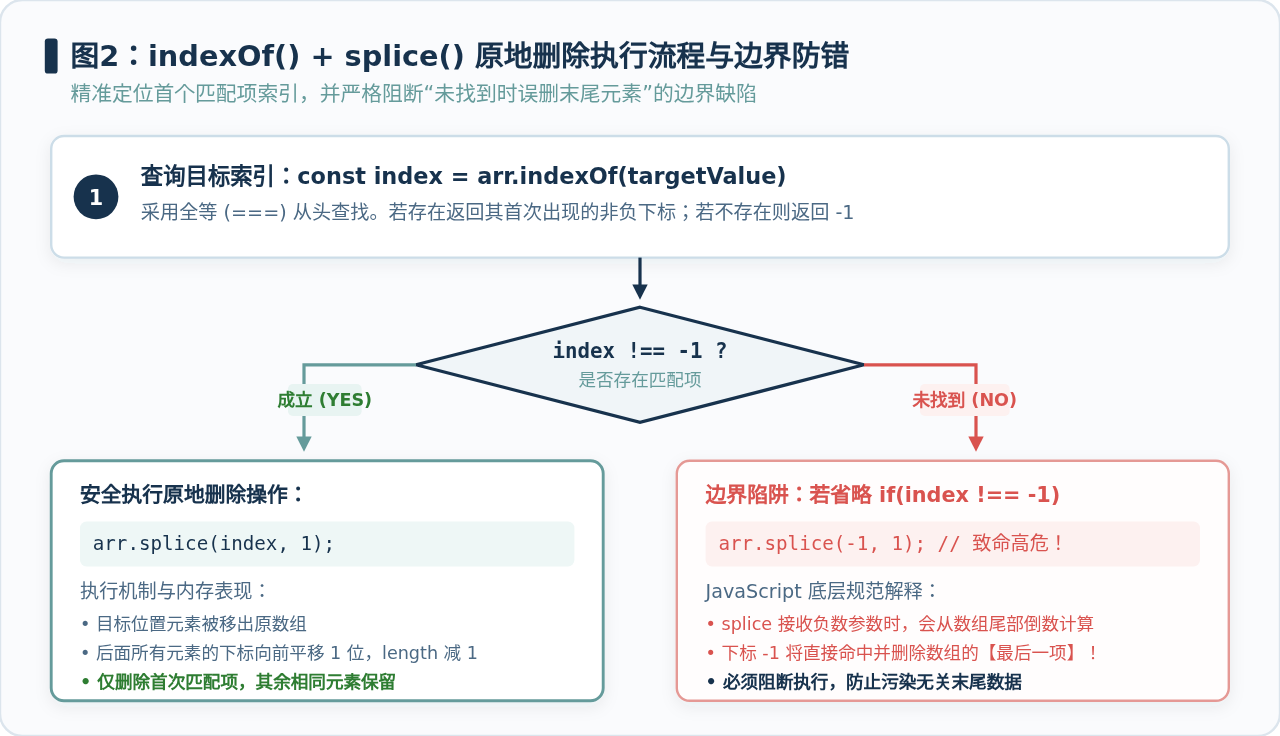
操作分为两步:首先通过 arr.indexOf(target) 获取目标值在数组中第一次出现的索引下标;随后判断该索引是否存在。只有当索引不为 -1 时,才调用 arr.splice(index, 1) 剔除该元素。
const fruits = ['apple', 'banana', 'orange', 'banana'];
const target = 'banana';

// 步骤1:查找目标值首次出现的下标
const index = fruits.indexOf(target);

// 步骤2:必须先校验索引是否存在,再执行删除
if (index !== -1) {
  fruits.splice(index, 1);
}

console.log(fruits);
// 示例输出: ['apple', 'orange', 'banana'] (仅删除了首个匹配项,第二个保留)
警惕致命陷阱:千万不要省略 index !== -1 的判断
很多初学者容易直接写出 arr.splice(arr.indexOf(target), 1)。当目标值不存在于数组中时,indexOf() 会返回 -1。在 JavaScript 规范中,splice() 接收负数参数时会转化为倒数索引,splice(-1, 1) 将会直接删除数组中的最后一项元素!这会导致难以觉察的严重脏数据问题。
图2:indexOf() 与 splice() 执行流及边界防错机制
三、原地删除全部匹配项:循环搭配 splice() 的避坑法则
当既需要原地修改原数组,又需要删除所有的相同匹配项时,很多开发者会尝试在 for 循环中边遍历边 splice,这极易引发著名的“下标平移漏删问题”。
1. 为什么正序遍历会出现漏删?
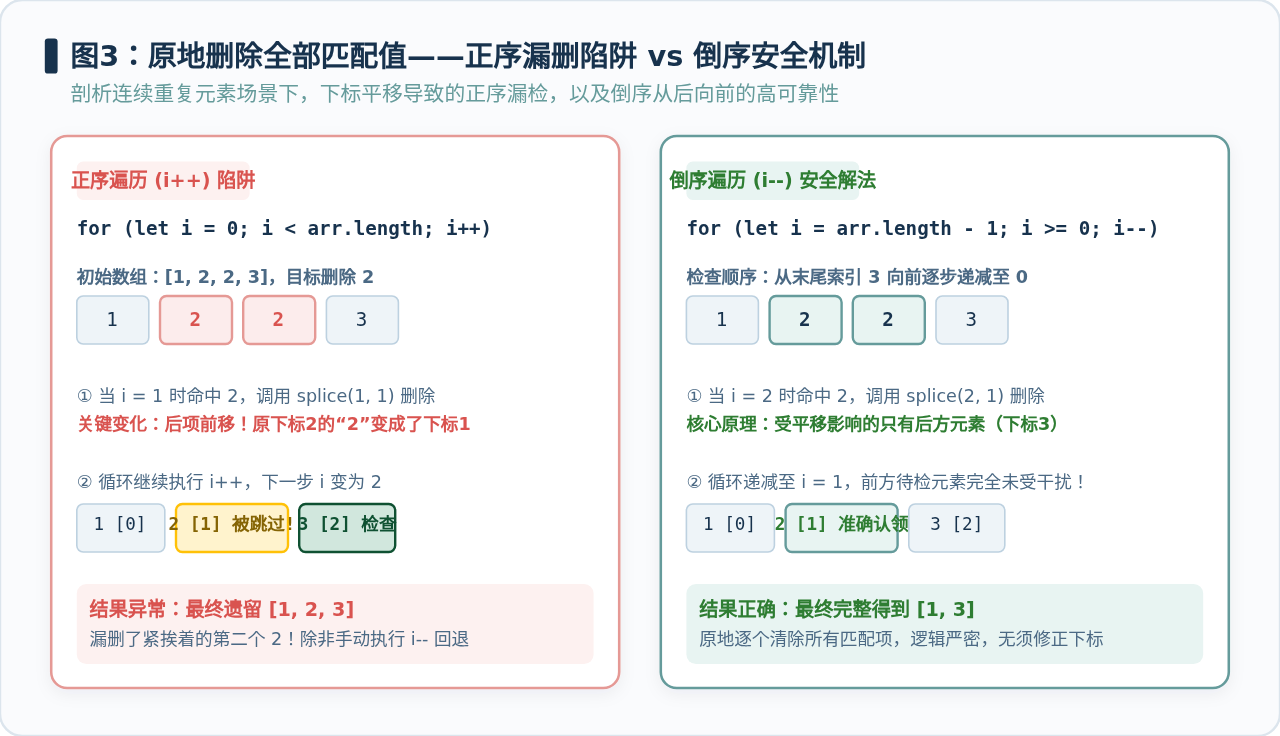
当数组存在相邻重复项(例如 [1, 2, 2, 3])时,我们在索引 i = 1 处删除了第一个 2。紧接着后面的元素会自动前移补位,第二个 2 的索引从 2 变成了 1。然而下一次循环步进 i++ 让指针移动到了 2,导致移动到索引 1 上的第二个 2 直接被跳过了。
2. 安全做法:采用倒序循环 (Reverse Loop)
解决该问题的最有效方式是从后向前进行倒序遍历。当从高索引向低索引扫描时,即便删除了某一位置的元素,受影响发生前移的只有后方的元素,而指针即将检查的前方元素的索引完全不会改变。
const scores = [60, 80, 80, 95, 80];
const targetScore = 80;

// 从后往前递减遍历,完美避开下标前移导致的漏项问题
for (let i = scores.length - 1; i >= 0; i--) {
  if (scores[i] === targetScore) {
    scores.splice(i, 1);
  }
}

console.log(scores); // 示例输出: [60, 95]
3. 替代做法:while 循环配合 indexOf
另一种直观的方式是结合 while 循环不断检索 indexOf,直到返回值变为 -1 为止:
const tags = ['js', 'css', 'html', 'css'];
let idx;

while ((idx = tags.indexOf('css')) !== -1) {
  tags.splice(idx, 1);
}

console.log(tags); // 示例输出: ['js', 'html']
图3:正序漏删机制与倒序安全遍历底层原理对比
四、进阶场景:对象数组与批量剔除
在实际业务中,数组里的元素往往不仅是基础类型数值或字符串,还可能是对象实体,或者需要根据黑名单同时移除多个指定值。
1. 对象数组:按对象属性值删除
对象属于引用类型,普通的 indexOf({ id: 1 }) 无法匹配内容相同但内存引用不同的对象。此时应借助 findIndex() 或 filter() 搭配谓词函数:
const userList = [
  { id: 101, name: 'Alice' },
  { id: 102, name: 'Bob' },
  { id: 103, name: 'Charlie' }
];

// 场景A:不可变返回新数组(推荐)
const updatedList = userList.filter(user => user.id !== 102);

// 场景B:原地删除指定 id 的对象
const targetIndex = userList.findIndex(user => user.id === 102);
if (targetIndex !== -1) {
  userList.splice(targetIndex, 1);
}
2. 批量剔除:结合 Set 实现高性能多值删除
当需要从长数组中同时剔除多个指定的值时,多次调用 splice 或对每个值做遍历比对会导致 O(n × m) 的高复杂度。借助 ES6 Set 的 has() 方法可以实现 O(1) 的查找性能,将总耗时降为 O(n):
const allItems = ['A', 'B', 'C', 'D', 'E', 'F'];
const removeList = ['B', 'D', 'F'];

// 构建哈希集合,检索复杂度为 O(1)
const removeSet = new Set(removeList);

const cleanItems = allItems.filter(item => !removeSet.has(item));

console.log(cleanItems); // 示例输出: ['A', 'C', 'E']
五、技术选型决策与全景总结
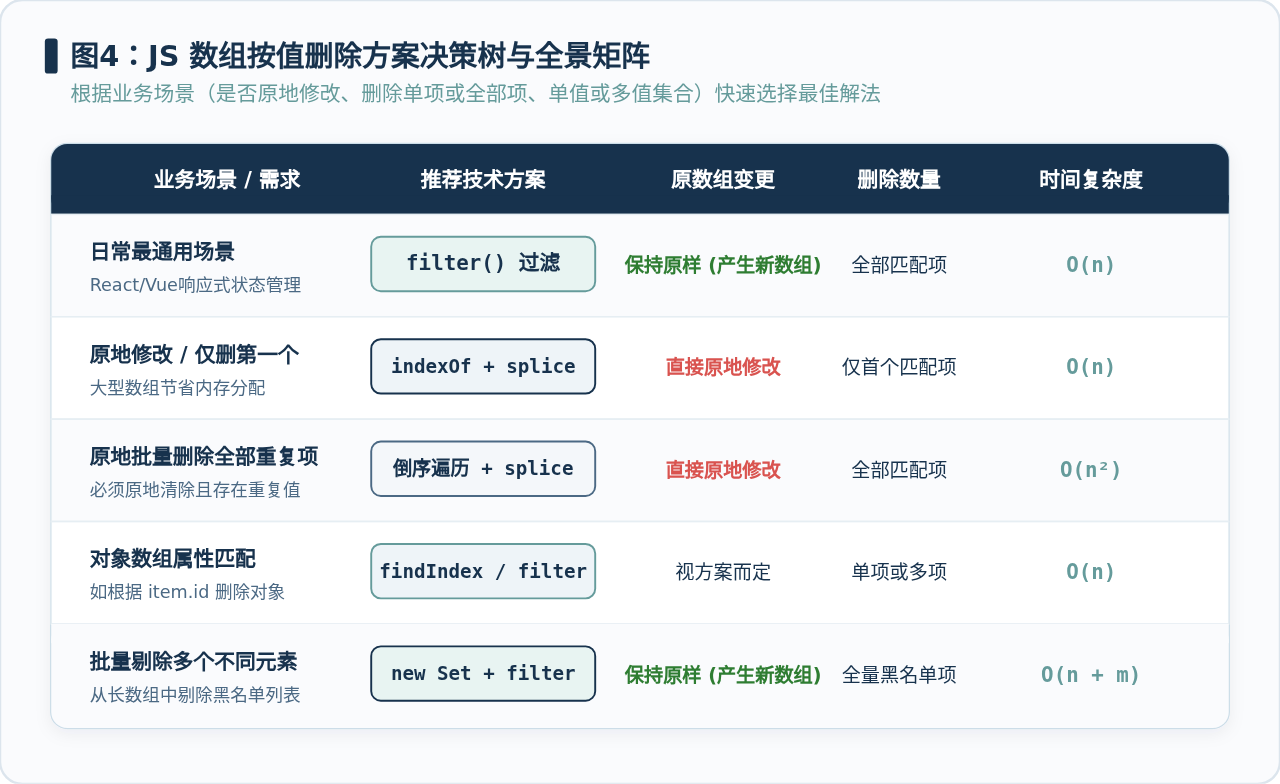
在面对不同需求时,选用哪种方案应当有清晰的判断依据。以下是按值删除常用方案的综合特性矩阵:
| 方法 | 是否改变原数组 | 删除项范围 | 时间复杂度 | 适用首选场景 |
|---|---|---|---|---|
filter() |
否(生成新数组) | 全部匹配项 | O(n) | 现代框架状态管理、不可变数据需求 |
indexOf + splice |
是(原地修改) | 仅首个匹配项 | O(n) | 明确只剔除一个首个元素、内存严格受限 |
倒序遍历 + splice |
是(原地修改) | 全部匹配项 | O(n²) | 必须原地修改且存在重复项的数据清洗 |
findIndex + splice |
是(原地修改) | 首个匹配对象 | O(n) | 复杂对象数组按属性精准删除 |
Set + filter |
否(生成新数组) | 多项批量剔除 | O(n + m) | 黑名单多元素过滤、高频大规模数据清洗 |
图4:JS 数组按值删除方案决策树与技术选型矩阵
六、容易被忽视的特殊边界情况
-
NaN 的比对缺陷:在 JavaScript 中
NaN === NaN返回false,因此[NaN].indexOf(NaN)会返回-1,导致无法通过indexOf找到NaN。若需删除NaN,应使用findIndex(Number.isNaN)或filter(item => !Number.isNaN(item))。 -
弱类型转换差异:
indexOf与filter内部使用的是严格相等全等比较(===)。如果数组中存的是数字5,而传入的目标值是字符串'5',则不会被匹配。在执行按值删除前,需确保类型一致或在回调中进行显示类型转换。 -
稀疏数组空槽(Empty Slots):对于含有空槽的稀疏数组(如
new Array(3)),filter()会自动忽略空槽,而for循环会访问到undefined。在生产中建议统一使用密集数组。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章