
深入讲解现代JavaScript中使用URLSearchParams解析和构建URL查询字符串的完整指南,包括多种初始化方式、参数增删改查、同名键处理、排序序列化、实战配合fetch及常见避坑细节。

当前位置:首页 > JavaScript 基础 > 正文
JS使用URLSearchParams解析和构建查询字符串
作者:小括号
时间:2026-11-03
浏览:100
文章目录
一、URLSearchParams 核心概念与多源初始化
在 WHATWG URL 标准中,URLSearchParams 是一个专门用于处理 URL 查询字符串的实用类。其内部维护了一个有序的键值对序列(list of name-value pairs),每个键和值都是标准的 Unicode 字符串。
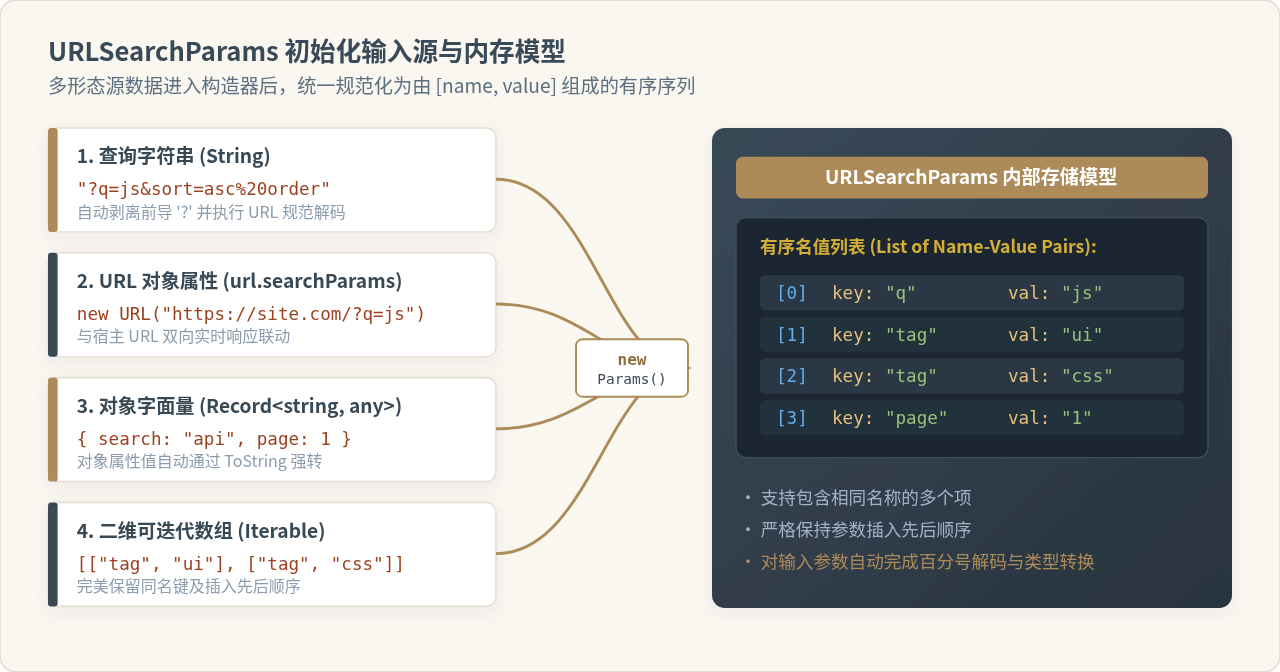
在实际编码中,很多开发者误以为必须先剥离 URL 前面的 ? 才能传入构造器,或者误以为它只能接收字符串。实际上,URLSearchParams 构造函数具备极佳的灵活性,能够无缝接收四种常见格式的数据源进行初始化。
1. 四种构造初始化方式
方式一:从查询字符串构造。可以传入带有前导问号(如 "?name=alice&age=20")或不带问号的纯查询字符串。URLSearchParams 会自动识别并剔除最前面的问号,并对百分比编码字符(如 %20、%E4%B8%AD%E6%96%87)执行标准的 application/x-www-form-urlencoded 解码。
方式二:通过 URL 对象直接获取。现代 URL 实例的 searchParams 属性就是一个 URLSearchParams 对象,两者之间是实时双向绑定的。修改 url.searchParams 会同步改变 url.href 和 url.search。
方式三:从普通对象字面量构造。传入普通对象 { keyword: 'vue', page: 1 }。对象的属性名将作为参数名,属性值会被隐式转换为字符串。
方式四:从二维键值对数组(Iterable)构造。当存在同名多值参数时,对象字面量会因键唯一性而丢失数据,而二维数组如 [['tag', 'js'], ['tag', 'web']] 则能完整保留同名键及其顺序。
// 1. 纯字符串(带或不带 '?' 均可)
const params1 = new URLSearchParams('?sort=desc&page=2');

// 2. 从已有 URL 对象直接获取(双向联动)
const url = new URL('https://api.example.com/v1/items?category=books');
const params2 = url.searchParams;

// 3. 从纯对象初始化
const params3 = new URLSearchParams({
  keyword: '前端',
  limit: 20
});

// 4. 从二维数组初始化(推荐用于包含同名多值的场景)
const params4 = new URLSearchParams([
  ['filter', 'active'],
  ['filter', 'pending']
]);
二、解析查询字符串:精确检索与高效遍历
在得到 URLSearchParams 实例后,最核心的任务便是从中提取所需的参数值。URLSearchParams 提供了专门的方法来应对单值参数、同名多值参数以及批量参数提取。
1. 常用查询与检索方法
-
get(name):获取指定键名匹配的第一个值。如果指定的键不存在,则返回null。如果一个键在 URL 中出现了多次(如?category=news&category=sports),get('category')只会返回"news"。 -
getAll(name):获取指定键名匹配的所有值组成的数组。当该键不存在时,返回空数组[]。这个方法是处理表单多选复选框或数组参数(如?id=1&id=2)的标准解决方案。 -
has(name):判断是否存在指定键名。存在返回true,否则返回false。在现代支持规范的浏览器(Chrome 117+、Firefox 112+、Node.js 18.17+)中,has(name, value)还支持传入第二个可选参数,用于精准判断是否存在特定的键值组合。
const search = '?type=article&tag=javascript&tag=web&empty=';
const params = new URLSearchParams(search);

// 1. 单值检索
console.log(params.get('type'));    // 输出: "article"
console.log(params.get('absent'));  // 输出: null
console.log(params.get('empty'));   // 输出: "" (注意:空键返回空字符串,非 null)

// 2. 多值检索
console.log(params.get('tag'));     // 输出: "javascript" (仅第一个)
console.log(params.getAll('tag'));  // 输出: ["javascript", "web"]
console.log(params.getAll('none')); // 输出: []

// 3. 存在性检查
console.log(params.has('type'));    // 输出: true
console.log(params.has('author'));  // 输出: false
2. 遍历与对象化转换
URLSearchParams 实现了标准的可迭代协议(Iterable),因此可以直接搭配现代 JavaScript 的 for...of 循环,也可以使用其内置的 forEach、keys()、values()、entries()。
如果需要将查询参数快速转换为前端常见的普通 JavaScript 对象,可以搭配 Object.fromEntries()。但必须注意:Object.fromEntries() 在遇到同名键时,后出现的键值会覆盖先出现的键值,只保留最后一条。
// 遍历所有键值对
for (const [key, value] of params) {
  console.log(`${key} = ${value}`);
}

// 快速转为普通对象 (注意:同名重复键会被覆盖)
const paramObj = Object.fromEntries(params);
console.log(paramObj);
// 结果: { type: "article", tag: "web", empty: "" }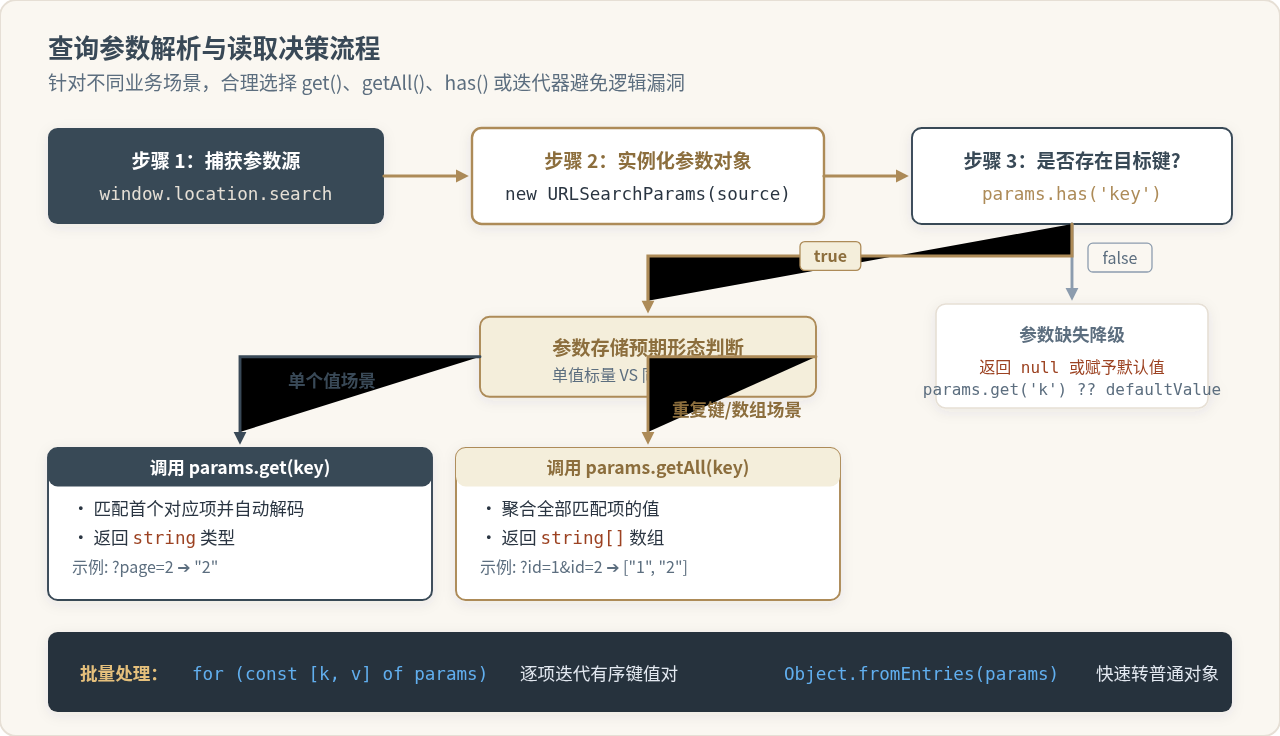
三、构建与修改查询字符串:增删改与序列化
除了解析已有参数,构建和动态更新查询字符串是 URLSearchParams 的另一大核心能力。无论是发送异步请求前追加筛选条件,还是在单页应用中改变过滤状态,都可以借助其增删改方法完成。
1. 修改参数的核心方法与行为差异
-
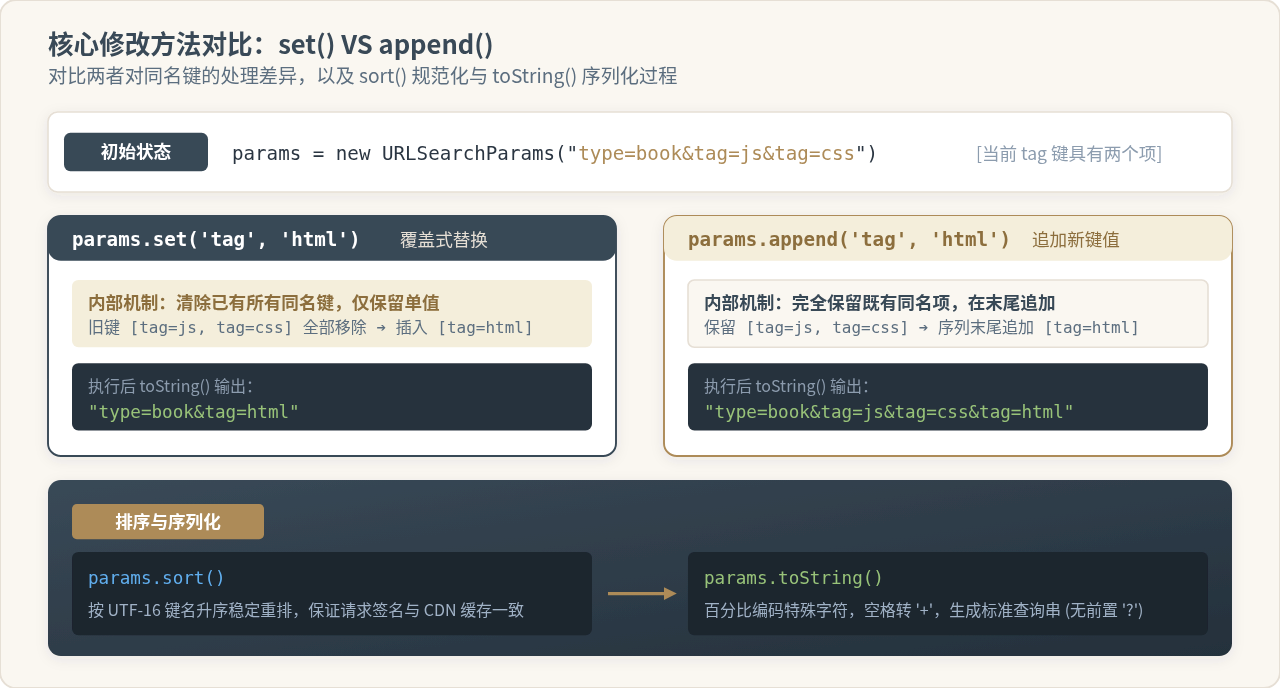
append(name, value):追加一个新的键值对到末尾。如果该键已经存在,它不会覆盖旧值,而是保留已有项并在此之后追加一个同名项。 -
set(name, value):设置指定键的值。如果该键已存在(即便有多个同名项),set()会将所有同名项全部替换为该单个值;若不存在则新增。 -
delete(name, [value]):删除指定键的所有键值对。在现代浏览器与 Node.js 中,还支持传入第二个可选参数value,仅删除指定键名且值匹配的项。 -
sort():将内部的所有键值对按其键名的 Unicode 码点进行就地稳定排序。这在微服务接口防篡改签名校验、请求缓存 Key 生成等场景中极其重要。
⚠️ 关键转折提醒:何时选 set() 何时选 append()?
许多业务 Bug 的根源在于将 append() 当作赋值方法使用。例如在分页切换时,连续调用 params.append('page', 2) 会使 URL 变成 ?page=1&page=2。对于分页、排序、搜索关键词等单值覆盖场景,必须使用 set();对于多选分类标签、权限勾选等多值追加场景,才应使用 append()。
const searchParams = new URLSearchParams();

// 1. append 追加 (支持同名多项)
searchParams.append('category', 'tech');
searchParams.append('category', 'news');
console.log(searchParams.toString());
// 输出: "category=tech&category=news"

// 2. set 覆盖 (同名项被合并为唯一定值)
searchParams.set('category', 'lifestyle');
console.log(searchParams.toString());
// 输出: "category=lifestyle"

// 3. sort 规范化排序
searchParams.set('version', '2.0');
searchParams.set('auth', 'token123');
searchParams.sort();
console.log(searchParams.toString());
// 输出: "auth=token123&category=lifestyle&version=2.0"

// 4. delete 彻底移除
searchParams.delete('auth');
console.log(searchParams.toString());
// 输出: "category=lifestyle&version=2.0"
2. 序列化输出:toString() 的底层规则
调用 params.toString() 会将内部键值对序列化为标准的查询字符串。序列化过程遵循以下规则:
- 输出结果不包含前导问号
?。如果需要拼接到 URL 末尾,需要自行补充?或直接配合URL实例使用。 - 所有键名和键值都会按照
application/x-www-form-urlencoded规范进行百分比编码。例如中文字符会被编码为形如%E4%B8%AD%E6%96%87的序列。 - 空格会被编码为加号
+,而非%20(下文第五节将专门讲解这一机制及应对策略)。
四、典型实战场景与工程联动
在实际的前端与全栈项目中,URLSearchParams 很少孤立存在,通常会与 fetch 网络请求、单页应用(SPA)路由以及 HTML 表单紧密联动。以下展示三个高频典型场景的规范代码范式。
1. 结合 fetch 与 URL 对象发起带参数的网络请求
过去发起 GET 请求时,开发者习惯手动拼接 `${endpoint}?page=${page}&keyword=${keyword}`。当某个参数包含空格、& 或中文时,如果不手动调用 encodeURIComponent 就会导致接口解析异常。配合 URL 和 URLSearchParams 可以彻底规避此类隐患。
// 优雅构建 GET 请求 URL
async function fetchArticles(keyword, page = 1, tags = []) {
  const url = new URL('https://api.example.com/v1/articles');

  // 直接利用 url.searchParams 进行操作
  url.searchParams.set('keyword', keyword);
  url.searchParams.set('page', String(page));

  // 数组参数安全追加
  tags.forEach(tag => url.searchParams.append('tag', tag));

  const response = await fetch(url.toString(), {
    method: 'GET',
    headers: { 'Accept': 'application/json' }
  });

  return response.json();
}
2. 单页应用(SPA)中同步状态到地址栏
在表格筛选、分页或 Tab 切换场景中,将筛选条件同步到浏览器地址栏能够让用户直接分享链接或刷新页面后保留状态。借助 history.pushState 或 history.replaceState,可以做到无刷新同步。
// 保持现有 URL 状态并更新特定查询参数
function updateFilterState(newFilter) {
  // 基于当前浏览器地址栏构建对象
  const currentUrl = new URL(window.location.href);

  // 批量更新参数
  Object.entries(newFilter).forEach(([key, value]) => {
    if (value === null || value === '') {
      currentUrl.searchParams.delete(key); // 清空无用参数
    } else {
      currentUrl.searchParams.set(key, value);
    }
  });

  // 无刷新更新地址栏并保留历史栈
  window.history.pushState({}, '', currentUrl.toString());
}
3. 桥接 HTML 表单 FormData
URLSearchParams 原生支持传入 FormData 实例。当需要通过 GET 请求提交整个 HTML 表单,或者需要将复杂表单序列化为查询字符串时,只需一行代码即可完成桥接。
const formElement = document.querySelector('#search-form');
const formData = new FormData(formElement);

// 一行代码将表单序列化为 URL 查询字符串
const searchParams = new URLSearchParams(formData);
console.log(searchParams.toString());
五、常见踩坑点与边界细节
尽管 URLSearchParams 极大简化了参数处理,但在特定边界场景下仍有几处容易被忽略的细节陷阱。掌握这些底层特性能帮助开发者编写出更具防御性的代码。
1. 空格编码差异:为什么是加号 + 而非 %20?
很多开发者在调用 params.toString() 时发现,字符串中的空格被编码成了 +,而标准 encodeURIComponent 会编码为 %20。
原因:URLSearchParams 遵循的是 HTML 表单提交规范(application/x-www-form-urlencoded),该规范明确规定空格必须编码为 +。绝大多数现代后端框架(Spring Boot、Express、Django、Go net/http)在解析查询字符串时均默认支持将 + 解码为空格。但如果面对某些严格要求遵循 RFC 3986(必须用 %20)的特定微服务网关或旧版 API,可通过简单的正则替换进行微调:
// 将默认的 '+' 替换为标准的 RFC 3986 '%20'
const standardQuery = params.toString().replace(/\+/g, '%20');
2. 非字符串类型的隐式强制转换
URLSearchParams 内部存储的值只接受字符串。当向 set() 或 append() 传入数字、布尔值或对象时,JavaScript 会在底层自动调用 String(value)。
⚠️ 谨防 null 和 undefined 字符串化
如果传入 null 或 undefined,它们会被转化为字符串 "null" 和 "undefined",而非被忽略!此时在 URL 中会生成形如 ?user=null&status=undefined 的参数,后端接收时往往会误判为有效字符串。在设置参数前,务必对参数值做合法性过滤。
3. Hash 路由中 searchParams 的读取陷阱
在老项目或采用 Hash 模式的前端路由(如 https://example.com/#/dashboard?userId=123)中,直接访问 window.location.search 会返回空字符串 ""。
原因:标准 URL 结构中,?search 必须位于 #hash 之前。一旦 ? 放在 # 之后,整个查询部分在浏览器底层被视为哈希片段的一部分。此时应从 window.location.hash 中截取并解析:
// 针对 Hash 路由参数的安全提取
function getHashSearchParams() {
  const hash = window.location.hash;
  const questionMarkIndex = hash.indexOf('?');
  if (questionMarkIndex === -1) return new URLSearchParams();
  return new URLSearchParams(hash.slice(questionMarkIndex));
}
六、全景总结与方法速查清单
URLSearchParams 是现代 JavaScript 处理 URL 查询参数的标准首选基础设施。它彻底摒弃了繁琐低效的正则拆解,以完备的 API 覆盖了从构造、查询、修改到输出的完整生命周期。
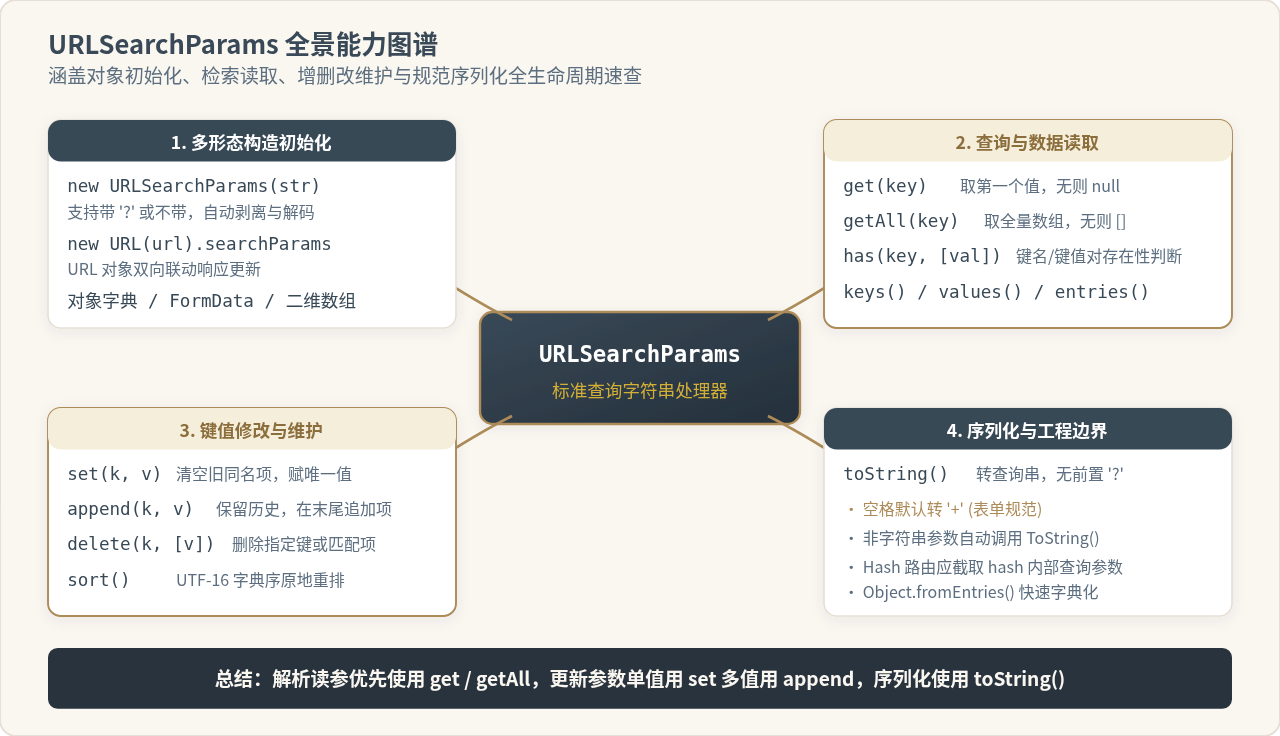
常用 API 核心行为速查表
| API 方法 | 参数 | 返回值 | 核心行为及注意事项 |
|---|---|---|---|
get(name) |
name: string |
string | null |
返回首个匹配值并自动解码;键不存在时返回 null |
getAll(name) |
name: string |
string[] |
返回所有匹配值的数组;不存在时返回空数组 [] |
has(name, [value]) |
name, [value] |
boolean |
判断键(或指定键值对)是否存在 |
set(name, value) |
name, value |
void |
覆盖式设置;若存在多个同名项,全部移除并替换为单个新值 |
append(name, value) |
name, value |
void |
追加式设置;保留既有同名项,在末尾新增同名项 |
delete(name, [value]) |
name, [value] |
void |
移除指定键名对应的所有项(支持可选精确值过滤) |
sort() |
无 | void |
将所有键值对按键名 Unicode 码点就地排序 |
toString() |
无 | string |
序列化为规范查询字符串(不含 ?,空格编码为 +) |
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章