
全面讲解JavaScript数组常用操作方法,深入剖析map、filter、reduce等核心高频API的语法规则、实战场景、不可变性原则与常见踩坑细节。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组常用方法有哪些?map/filter等基础操作教程
作者:木棉
时间:2026-11-03
浏览:540
文章目录
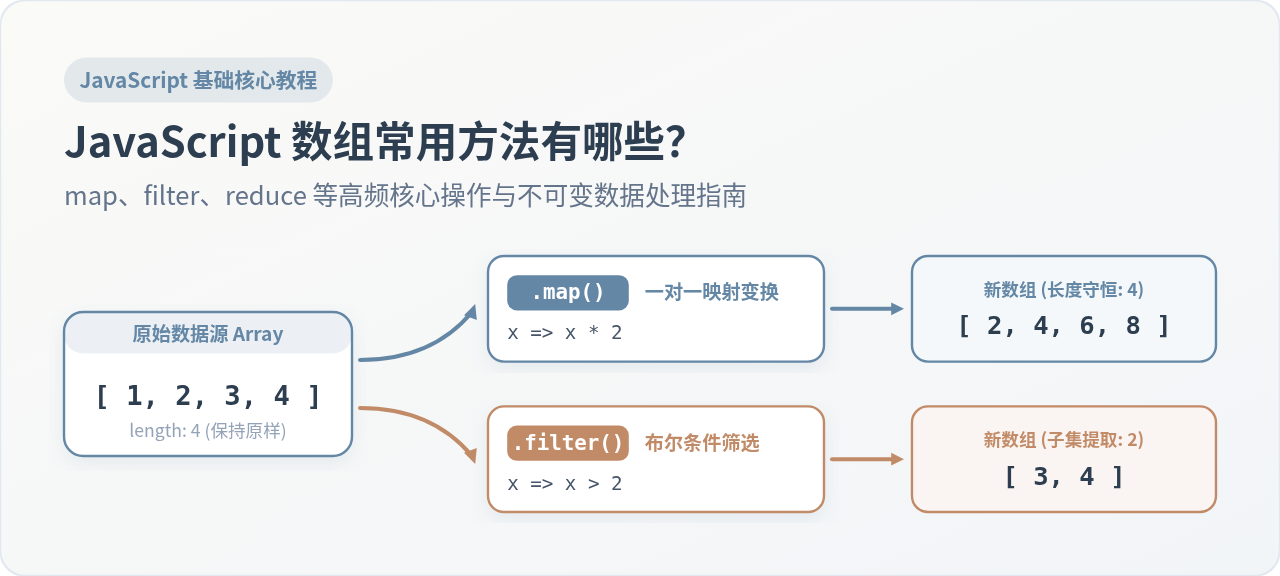
处理数据集合是 JavaScript 开发中最基础且高频的操作。要真正掌握数组方法,最核心的关键不是死记死背 API,而是理清它们的处理意图以及是否修改原数组。在现代前端与 Node.js 业务中,以 map、filter、reduce 为代表的纯函数方法构成了响应式状态管理(如 React、Vue)的数据流基础,而 splice、push 等原地修改方法则适用于队列或特定性能调优场景。本文将系统拆解这些常用数组方法的底层行为、实战场景及排错细节。
一、核心底线:区分“纯函数”与“原地修改”
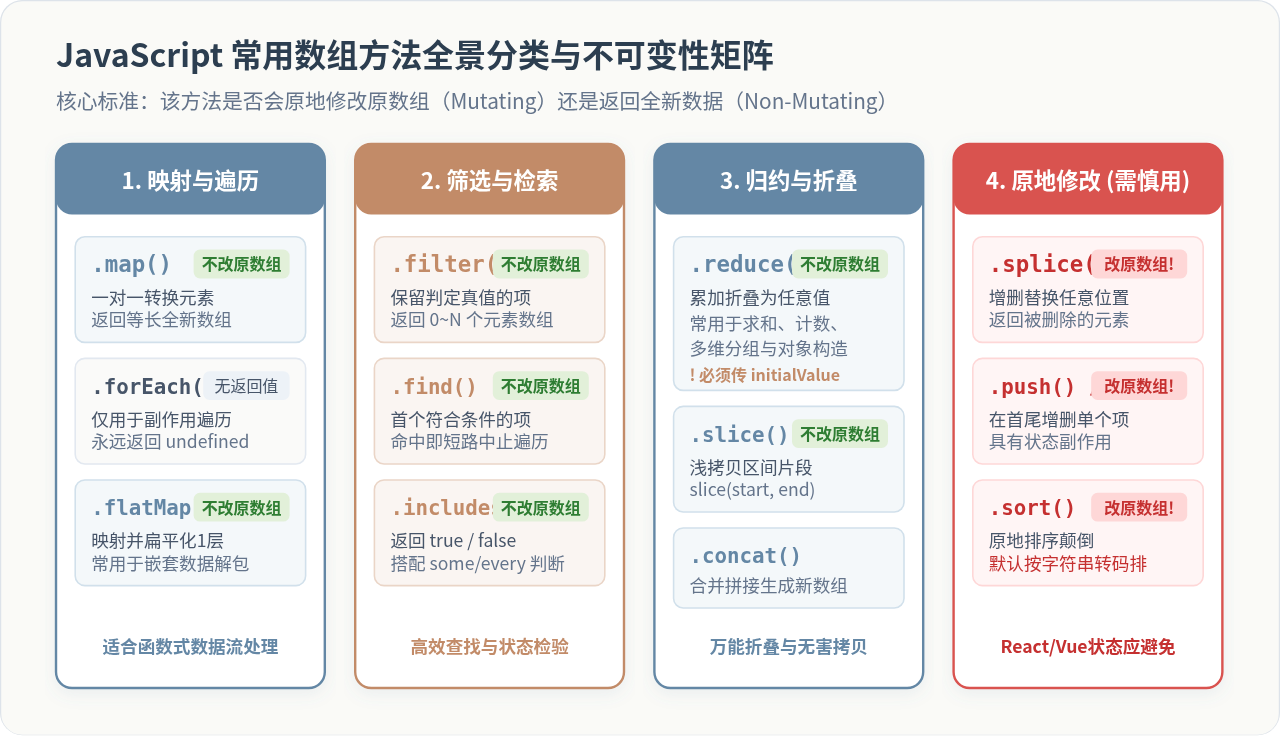
在编写 JavaScript 业务代码时,首要判断标准是:这个方法执行后,原来的数组还在不在?
JavaScript 数组方法在内存管理上分为两大阵营:
- 不可变方法(Non-Mutating,推荐主流):例如
map()、filter()、slice()、concat()、flat()等。它们不改变原始数组在堆内存中的内容,而是计算并返回一个全新的数组或结果值。这在现代数据流中是绝对推荐的编写范式。 - 原地修改方法(Mutating,慎用):例如
splice()、push()、pop()、shift()、unshift()、sort()、reverse()。它们会直接破坏原数组内部的数据索引或元素顺序。在 React 的useState中如果对原数组执行此类方法,极易导致组件无法感知变更而不触发重渲染。
二、核心双雄:map 与 filter 的数据映射与条件过滤
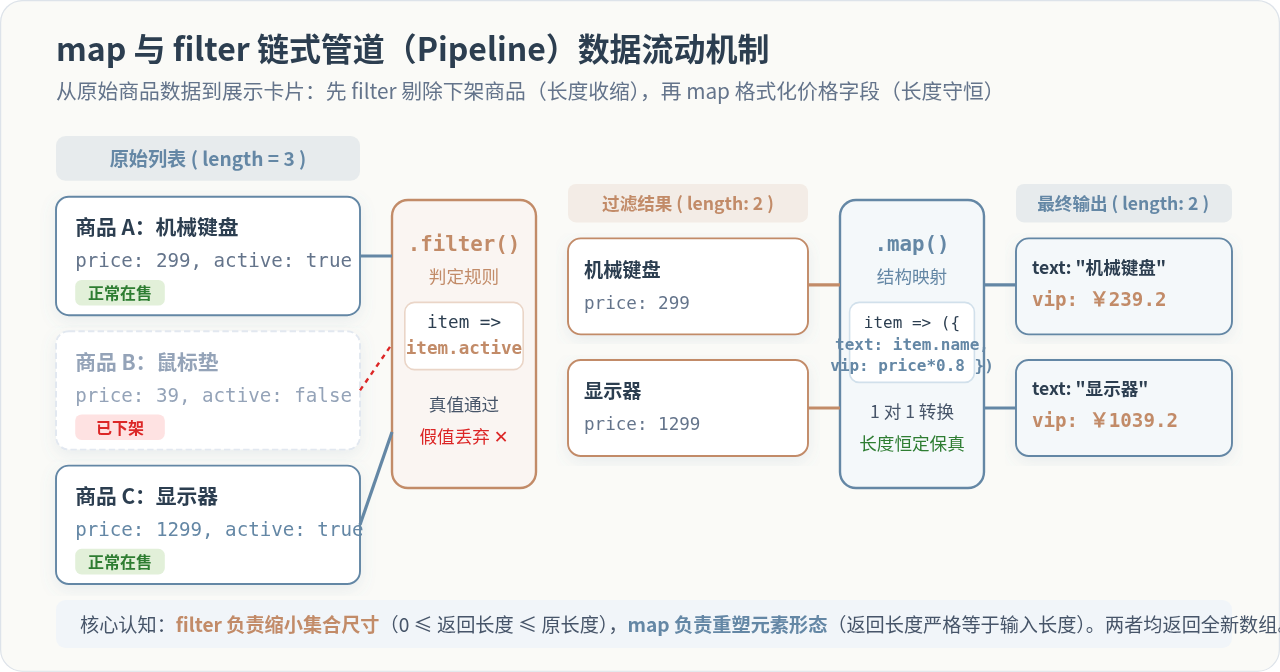
map 与 filter 是日常业务处理中最频繁搭配使用的双核工具。它们都接收一个回调函数,但分工截然不同。
1. map():一对一的元素结构转换(长度守恒)
map() 的职责是把数组里的每一个元素,按照给定的逻辑“映射”成一个新形态。输入数组有 N 个元素,输出数组就绝对严格有 N 个元素,绝不多一个,也绝不少一个。
// 语法:arr.map((item, index, array) => newItem)

// 业务场景:将后端返回的用户列表转换为前端下拉选择框需要的 { label, value } 格式
const rawUsers = [
  { id: 101, username: 'alex', role: 'admin' },
  { id: 102, username: 'bob', role: 'editor' },
  { id: 103, username: 'charlie', role: 'viewer' }
];

const selectOptions = rawUsers.map(user => ({
  label: user.username.toUpperCase(),
  value: user.id
}));

// 输出结果:长度依然为 3,结构已重塑
// [
//   { label: 'ALEX', value: 101 },
//   { label: 'BOB', value: 102 },
//   { label: 'CHARLIE', value: 103 }
// ]
⚠️ map 箭头函数常见陷阱
如果在箭头函数中直接返回对象字点量,必须用圆括号包裹对象 ({ ... }),否则 JavaScript 解析器会把花括号识别为函数体代码块,导致每项都返回 undefined。
2. filter():按布尔条件提取有效子集(尺寸收缩)
filter() 的职责是“筛选”。回调函数必须返回一个真假值(Truthy 或 Falsy)。只有当回调返回 true 时,该元素才会被拷贝到新数组中;返回 false 则被丢弃。过滤得到的新数组长度在 0 到 N 之间。
// 业务场景:从商品列表中仅保留有库存且评分大于等于 4.5 的优质商品
const products = [
  { id: 1, name: '机械键盘', inStock: true, rating: 4.8 },
  { id: 2, name: '无线鼠标', inStock: false, rating: 4.6 },
  { id: 3, name: '电竞耳机', inStock: true, rating: 4.2 }
];

const availableGoods = products.filter(item => item.inStock && item.rating >= 4.5);

// 输出结果:仅包含机械键盘 1 项
// [ { id: 1, name: '机械键盘', inStock: true, rating: 4.8 } ]
3. 管道组合:先 filter 再 map 的优雅链式流
由于两者都返回新数组,因此可以无缝进行链式调用。最佳实践顺序是:先通过 filter 剔除无效数据减少数组体量,再通过 map 转换剩余元素,这样可以减少不必要的映射计算开销。
三、全能折叠器:reduce 的状态累加与场景实践
如果说 map 和 filter 处理的是“数组到数组”的变换,那么 reduce() 处理的就是“数组到任意形态”的终极汇聚。无论是将数组折叠成一个数字、一个字符串、一个计数对象,还是一个分组映射表,reduce 都能胜任。
1. reduce 核心语法与执行心智模型
arr.reduce((accumulator, currentValue, currentIndex, array) => {
  return nextAccumulator;
}, initialValue);
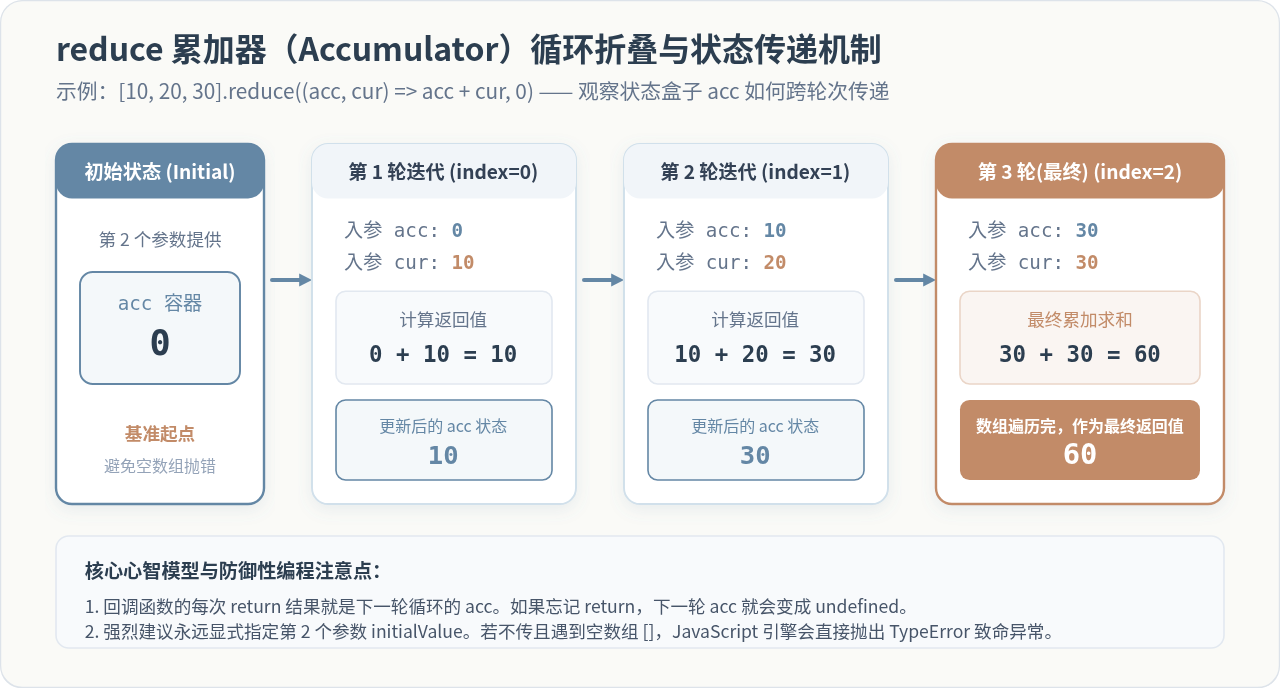
reduce 的核心在于“累加器(accumulator)”。在每一轮循环中,累加器保存着上一轮的执行结果,并将当前项(currentValue)混合进去,最后将算出的新状态返回,传递给下一轮。
2. 实战案例:商品分类聚合与购物车总价计算
// 实战场景 1:计算购物车订单含税总金额
const cart = [
  { item: '书本', price: 50, count: 2 },
  { item: '钢笔', price: 30, count: 1 },
  { item: '书包', price: 120, count: 1 }
];

const totalPrice = cart.reduce((sum, goods) => {
  return sum + goods.price * goods.count;
}, 0); // 初始值 sum = 0

console.log(totalPrice); // 250

// 实战场景 2:将扁平列表按分类归纳为哈希对象
const tasks = [
  { id: 1, title: '修复登录Bug', tag: '紧急' },
  { id: 2, title: '更新隐私协议', tag: '日常' },
  { id: 3, title: '优化加载速度', tag: '紧急' }
];

const groupedTasks = tasks.reduce((group, task) => {
  const key = task.tag;
  if (!group[key]) {
    group[key] = [];
  }
  group[key].push(task);
  return group;
}, {}); // 初始值为空对象 {}

// 输出:{ 紧急: [任务1, 任务3], 日常: [任务2] }
⚠️ 永远显式指定 initialValue 初始值
如果省略 initialValue,reduce 会默认拿数组的第 0 项作为初始累加器,并从第 1 项开始循环。当原数组恰巧为空 [] 时,未传初始值的 reduce 会直接抛出:TypeError: Reduce of empty array with no initial value,导致整段代码崩溃。
四、查找与判断:find、findIndex、includes 与 some/every
当需要从数组中检索目标、或者判断某些条件是否成立时,不需要用 filter 遍历到底。JavaScript 提供了针对性的短路检测方法:
| 方法名称 | 适用目标 | 返回值类型 | 命中行为 | 是否修改原数组 |
|---|---|---|---|---|
find(fn) |
查找对象数组中满足条件的元素 | 元素本身 / undefined |
短路(找到第 1 个即立刻停下) | 否 |
findIndex(fn) |
查找满足条件的元素下标索引 | 数字 index / -1 |
短路(找到第 1 个即停) | 否 |
includes(val) |
检查基本类型值(数字/字符串)是否存在 | true / false |
短路(严格值比较) | 否 |
some(fn) |
是否存在至少一个满足条件的元素 | true / false |
短路(只要遇 1 个 true 就停) | 否 |
every(fn) |
是否全部元素都满足特定条件 | true / false |
短路(只要遇 1 个 false 就停) | 否 |
// 场景示例:表单多文件校验
const uploadFiles = [
  { name: 'avatar.png', size: 1024 * 500 },    // 500KB
  { name: 'manual.pdf', size: 1024 * 1024 * 8 } // 8MB
];

// 校验是否所有文件都小于 5MB
const isAllUnder5MB = uploadFiles.every(file => file.size <= 5 * 1024 * 1024);
console.log(isAllUnder5MB); // false

// 快速找出第一个超大文件的名称
const oversizedFile = uploadFiles.find(file => file.size > 5 * 1024 * 1024);
console.log(oversizedFile?.name); // 'manual.pdf'
五、彻底区分:slice 与 splice 的截取与修改
slice 和 splice 仅相差一个字母,但破坏性天差地别:
- slice(start, end) —— 切片提取(纯净无害):从 start 索引提取到 end(不包含 end),原数组毫发无损。常用于数组浅拷贝
arr.slice()或分页切片arr.slice((page-1)*size, page*size)。 - splice(start, deleteCount, ...items) —— 原地增删替换(破坏性):直接切开原数组,从指定位置删除指定个数元素,并可插入新元素。它返回的是被删除的元素列表,原数组已被直接修改。
const fruits = ['苹果', '香蕉', '橘子', '草莓'];

// 1. 使用 slice(安全操作)
const part = fruits.slice(1, 3);
console.log(part);   // ['香蕉', '橘子']
console.log(fruits); // ['苹果', '香蕉', '橘子', '草莓'] (完全未变)

// 2. 使用 splice(就地修改)
const removed = fruits.splice(1, 2, '葡萄');
console.log(removed); // ['香蕉', '橘子'] (被删掉的项)
console.log(fruits);  // ['苹果', '葡萄', '草莓'] (原数组被硬生生改动了!)
六、数组操作高频踩坑点与排查建议
根据日常工程开发经验,以下是初学者甚至资深开发者最容易疏忽的细节:
- 误用 forEach 代替 map:
forEach的返回值固定是undefined。如果写出const list = arr.forEach(...),list必定是undefined。只有需要触发网络请求、打印日志等“副作用”且不关心返回值时才使用forEach。 - 在 map/filter 中意外浅拷贝修改对象属性:
map虽返回新数组外壳,但如果元素是引用类型(Object),直接写item.count = 0依然会污染原对象。正确的纯函数写法应当使用对象解构:return { ...item, count: 0 }。 - 直接调用 sort() 造成字典序误判:JavaScript 的
sort()默认将元素转成字符串比较字符编码![10, 5, 20].sort()的排序结果是[10, 20, 5]。数字排序必须显式传入比较器:arr.sort((a, b) => a - b)。
七、数组方法实战选型总结
在面对各种具体业务场景时,可以依照下面的决策指南进行秒级选择:
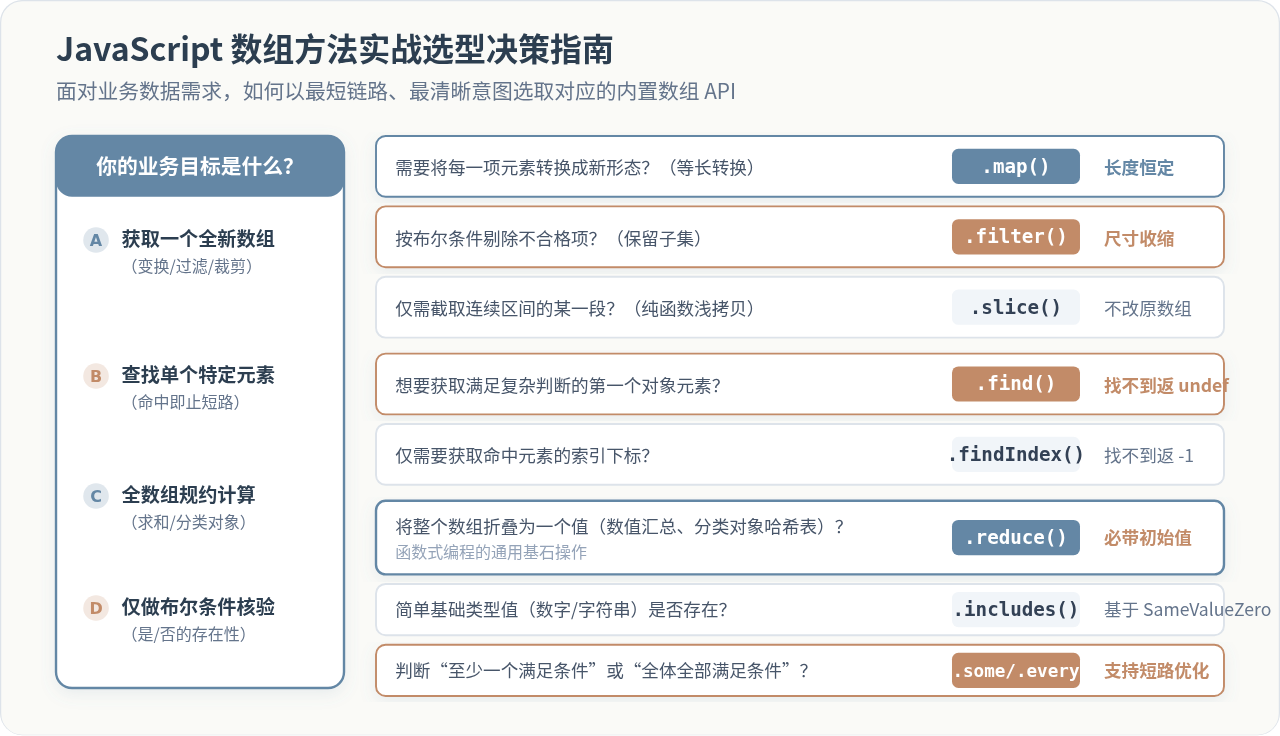
总结而言,掌握现代 JavaScript 数组操作的本质,是建立“数据流与不可变性”的编程直觉。在绝大多数业务逻辑中,优先选用 map、filter、find、slice 和 reduce 等不污染源数据的声明式方法,能够大幅降低调试成本,让代码逻辑更加清晰、健壮且易于维护。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章