
深入解析JavaScript中空格字符的转义方法,系统对比\s、\u0020与\x20的底层原理、语法归属与应用场景,帮助开发者规避字符串与正则表达式中的转义陷阱。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript字符串中空格怎么转义:\s、\u0020与\x20的区别
作者:拾光
时间:2026-11-03
浏览:420
文章目录
ECMAScript 字符解析指南
语言环境:JavaScript (ECMAScript 5+)
主题类型:字符编码与正则语法辨析
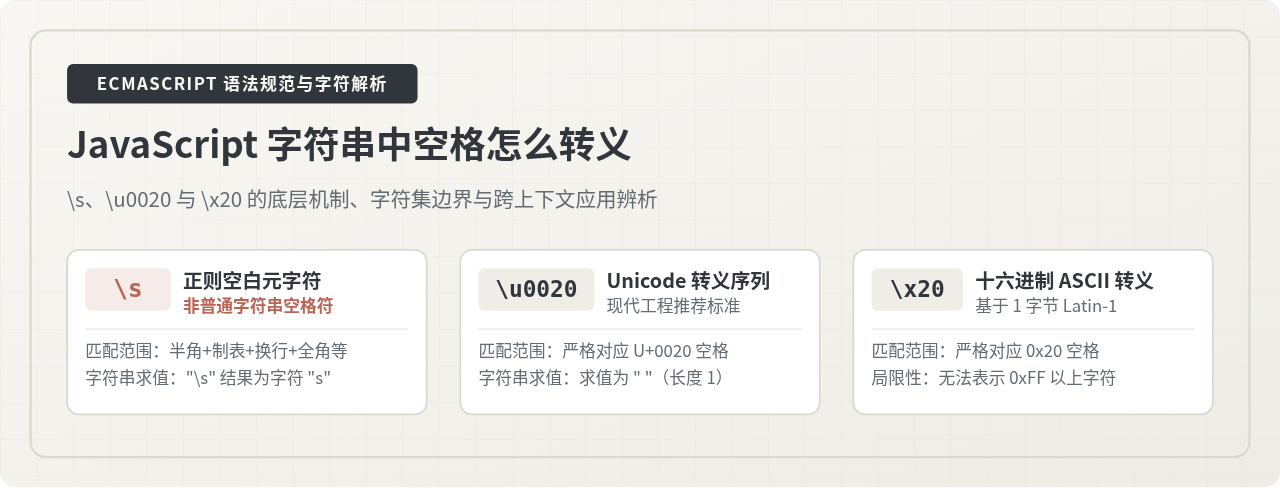
在 JavaScript 中,如果要在普通字符串字面量中表达一个常规半角空格,最合规、最高效的做法是直接按下键盘空格键(例如
"hello world"),空格在 JavaScript 普通字符串中本身不需要转义。若因防止编辑器或代码压缩工具丢损不可见字符、确保跨平台编码完全安全而需要显式转义时,正确的语法是十六进制转义 \x20 或 Unicode 转义 \u0020。初学者常犯的严重错误是写成 "\s"——在普通字符串中,"\s" 并不会转义为空格,而是会被求值为普通英文字母 "s";\s 是专属于正则表达式的元字符,且匹配的是包含制表符、换行符在内的整个空白字符集合。
一、普通字符串中的空格:为什么不需要转义与误用 \s 的后果
在 ECMAScript 规范中,空格(Unicode 码位 U+0020)是合法的源码字符,可以直接书写在单引号、双引号或反引号包裹的字符串字面量中。许多刚接触 JavaScript 的开发者因在正则表达式中频繁使用 \s,便误以为在字符串中表达空格也应当书写 \s,这会导致严重的逻辑缺陷。
1. 误写 "\s" 时的求值过程
当 JavaScript 词法分析器解析字符串字面量时,遇到反斜杠 \ 会触发转义识别。规范中定义了一套精确的有效转义字符集(如 \n 换行、\t 制表符、\r 回车等)。英文字母 s 并不在有效单字符转义列表之内。按照 ECMAScript 的 NonEscapeCharacter 语法降级规则,引擎会直接剔除反斜杠,将后面的字符原样保留。
// 错误示范:试图用 \s 转义字符串中的空格
const rawName = "user\sname";

console.log(rawName);
// 示例输出: "username" (注意:中间是字母 s,完全没有空格!)

console.log(rawName.length);
// 示例输出: 8 (预期 9 个字符,实际仅 8 个)

console.log(rawName.charCodeAt(4));
// 示例输出: 115 (字符 's' 的 ASCII 码是 115,而空格是 32)
从输出可以清楚看到,字符串里的 \s 并没有变成空格,而是退化成了普通字母 s。如果这段字符串被用于拼接用户显示名称或 SQL/API 参数,将引发隐蔽的数据异常。
2. 反斜杠加普通空格 "\ " 的行为
如果开发者写了 "hello\ world",由于空格本身同样不是特殊控制转义符,词法分析器同样会丢弃无意义的反斜杠,最终字符串结果仍然是 "hello world"。虽然结果看似正常,但这种写法属于无意义转义(Useless Escape),在 ESLint 等现代静态代码检查工具中会触发 no-useless-escape 警告规则,因此不建议书写。
3. new RegExp 构造函数中的双重转义陷阱
另一个容易混淆的场景是正则表达式动态传参。当使用 new RegExp() 动态构建正则表达式时,传入的参数首先是一个普通 JavaScript 字符串:
// 常见错误:在字符串参数中单写反斜杠
const regError = new RegExp("\s");
// 字符串字面量先行求值为 "s",实际传递给正则引擎的是 new RegExp("s")
console.log(regError.test(" ")); // 示例输出: false
console.log(regError.test("s")); // 示例输出: true

// 正确做法:对反斜杠进行双重转义
const regCorrect = new RegExp("\\s");
console.log(regCorrect.test(" ")); // 示例输出: true
console.log(regCorrect.test("s")); // 示例输出: false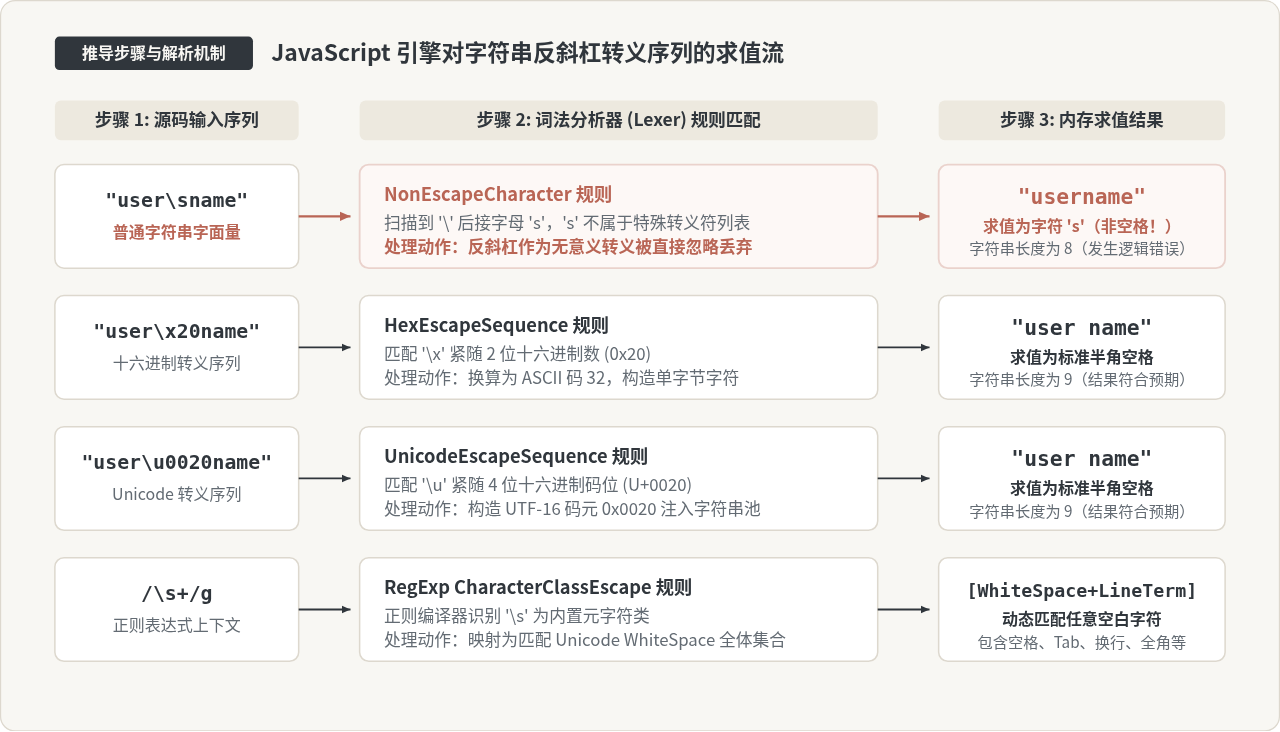
二、\x20 与 \u0020:两类显式空格转义的底层原理与异同
当确实需要在代码中显式表达空格字符时,JavaScript 提供了两种合法的字符编码转义序列:十六进制转义(\x20)与 Unicode 转义(\u0020)。
1. \x20:基于 Latin-1 的十六进制转义
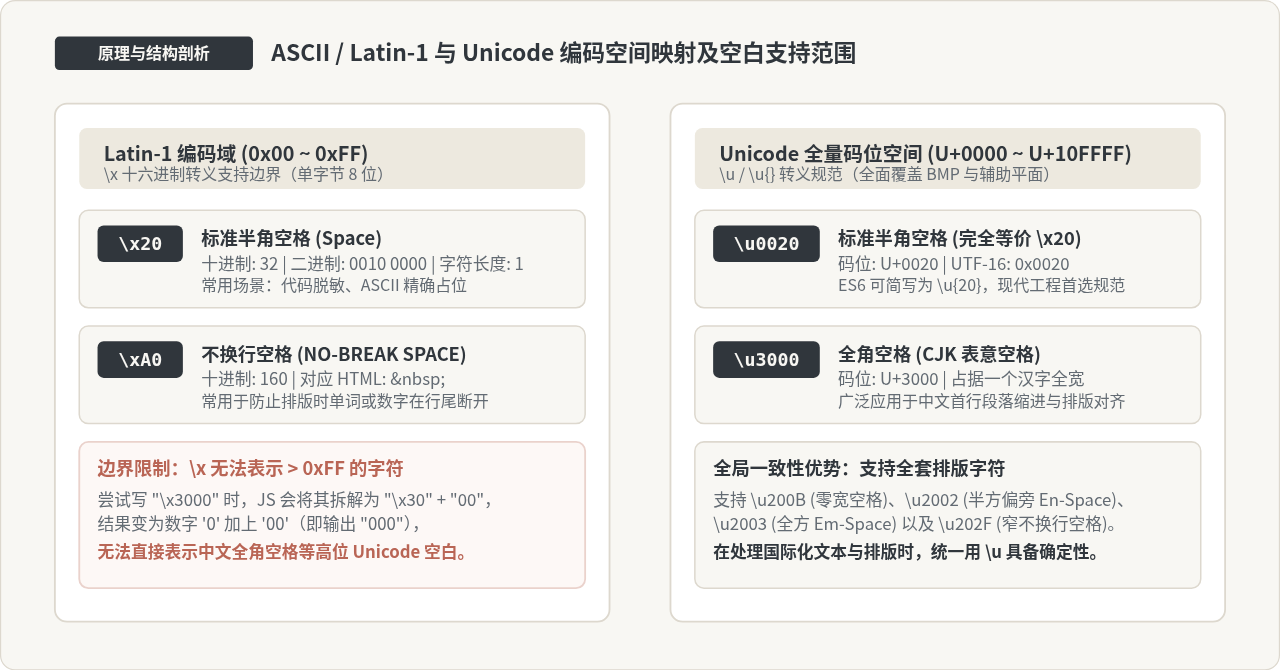
\x 转义序列源于 C 语言的 Hexadecimal Escape 语法。其规范格式为 \x 后面严格紧跟 2 位十六进制数(取值范围 00 到 FF,对应十进制 0 到 255)。半角空格在 ASCII 编码与 ISO-8859-1(Latin-1)中均为十进制 32,换算为十六进制即为 20。因此,\x20 在字符串中会被准确求值为半角空格字符。
2. \u0020:基于标准的 Unicode 转义
\u 转义序列是 ECMAScript 支持的 Unicode 转义语法。其基础格式为 \u 后面紧跟 4 位十六进制数,表示基本多语言平面(BMP)中的码位。U+0020 正是国际 Unicode 标准中分配给 ASCII Space(空格)的官方码位。在 ECMAScript 6(ES2015)中,规范引入了花括号码位语法 \u{20},允许省略前导零并支持全平面的码位值。
// 运行环境验证:Node.js 或浏览器 Console
const spaceLiteral = " ";
const spaceHex = "\x20";
const spaceUnicode = "\u0020";
const spaceES6 = "\u{20}";

console.log(spaceHex === spaceLiteral);    // 示例输出: true
console.log(spaceUnicode === spaceLiteral);// 示例输出: true
console.log(spaceHex === spaceUnicode);    // 示例输出: true
console.log(spaceES6 === spaceLiteral);    // 示例输出: true

console.log(spaceHex.length);             // 示例输出: 1
console.log(spaceUnicode.charCodeAt(0));   // 示例输出: 32
3. \x20 与 \u0020 的核心区别
虽然它们在表示标准半角空格时的求值结果完全一致,但在技术体系与扩展性上有明显的边界差异:
- 字符集容量差异:
\x只能表达 1 字节(0x00 ~ 0xFF)范围内的字符。如果遇到中文全角空格(\u3000)或零宽空格(\u200B),\x完全无法表示;而\u能够统一涵盖所有 Unicode 码位。 - 工程规范一致性:在现代大型前端项目中,推荐统一使用
\u0020(或\u{20})。统一采用 Unicode 转义体系可以避免团队成员在混用\x和\u时产生混淆,且在处理国际化排版字符时具备更强的表达一致性。
三、\s 的真正身份:正则表达式中的“空白字符族”元字符
\s 的正确应用域是正则表达式。在 ECMAScript 正则引擎中,\s 被定义为一个字符集简写元字符(CharacterClassEscape),它匹配的不是单个空格,而是所有符合 Unicode 定义的空白字符集合。
1. \s 包含的具体字符清单
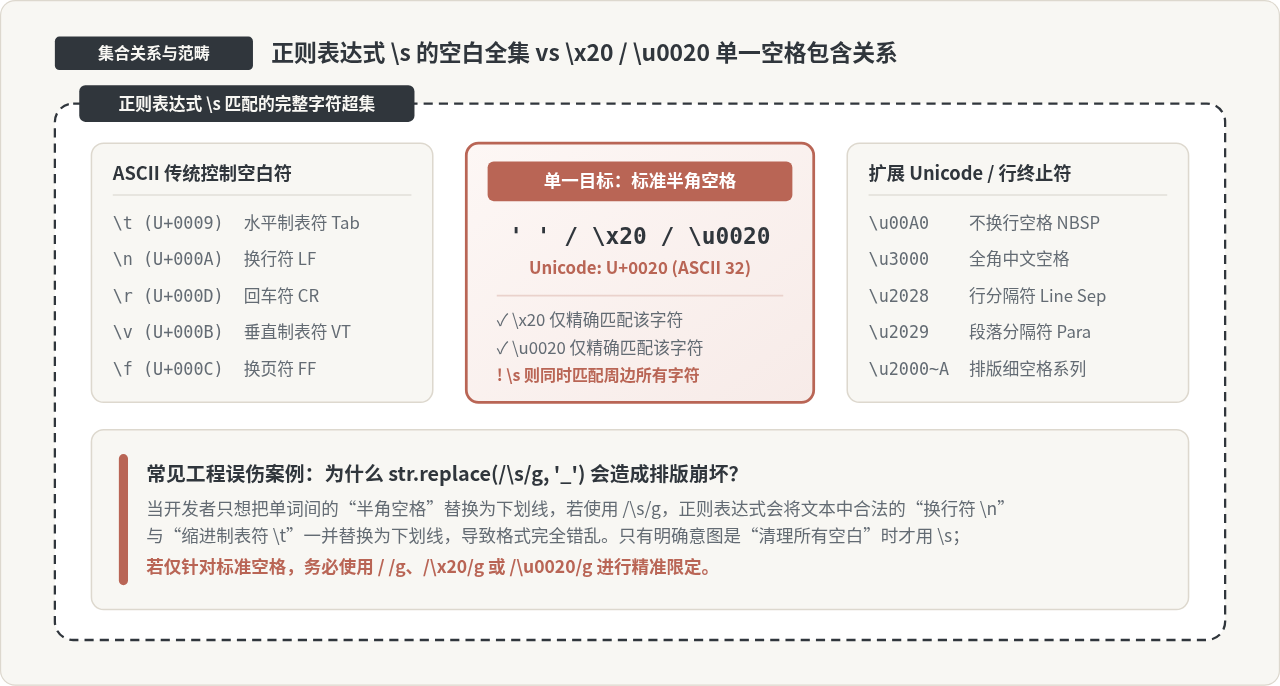
根据 ECMAScript 最新标准规范,\s 包含的字符集涵盖了以下三大类别:
- ASCII 控制空白符:水平制表符
\t(U+0009)、换行符\n(U+000A)、回车符\r(U+000D)、垂直制表符\v(U+000B)、换页符\f(U+000C)。 - 常规与扩展空格符:标准半角空格(U+0020)、不换行空格
- 行终止符(LineTerminator):行分隔符 LS(U+2028)以及段落分隔符 PS(U+2029)。
2. 误用 \s 带来的典型隐患:破坏格式结构
由于 \s 涵盖了换行符与制表符,在执行字符串替换操作时,若只想替换词间空格却误用了 \s,会带来不可挽回的格式损坏:
// 典型多行数据文本
const reportText = "Item A: 100\nItem B:\t200\nItem C: 300";

// 错误做法:误以为 \s 只是指半角空格,导致多行结构被彻底压扁
const corrupted = reportText.replace(/\s+/g, "_");
console.log(corrupted);
// 示例输出: "Item_A:_100_Item_B:_200_Item_C:_300" (换行与制表符全被替换,报表错乱)

// 正确做法:精准匹配且仅替换标准半角空格
const safeResult = reportText.replace(/ +/g, "_");
// 或使用十六进制显式限定:reportText.replace(/\x20+/g, "_")
console.log(safeResult);
/* 示例输出:
Item_A:_100
Item_B:	200
Item_C:_300
(换行与制表符完好保留,仅替换了普通空格)
*/
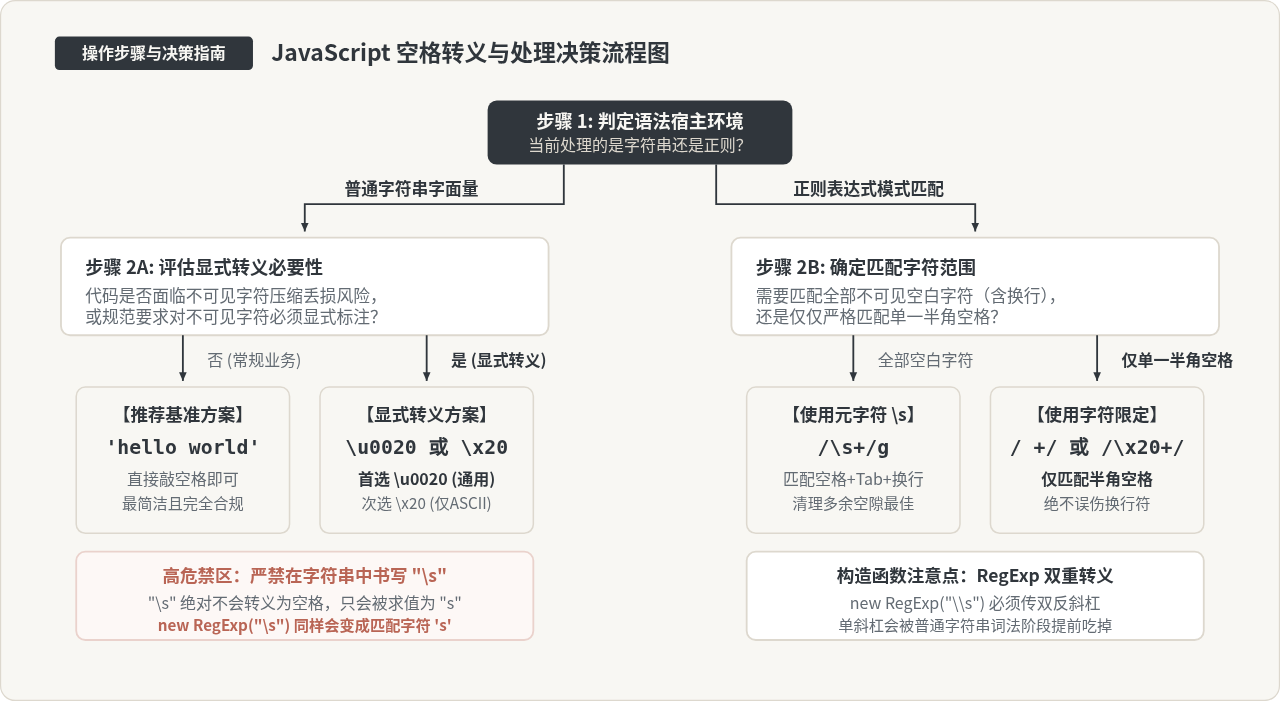
四、实战选型与决策流程
在日常 JavaScript 开发中,面对各种空格处理需求,应遵循清晰的决策步骤进行技术选型:
- 常规字符串拼接与业务展示:直接按下空格键书写
' '。这是最自然的语言特性,代码可读性最高,避免多余的转义负担。 - 代码格式化保护与特定不可见字符标识:当需要向跨团队组件传递明确的半角空格,或防止构建脚本在压缩清理时误删结尾空格时,推荐书写
\u0020(或\u{20})。 - 清理用户输入、分词与模糊空白归一化:当目标是清除表单首尾多余的空白(包含用户复制粘贴带来的制表符、全角空格等),在正则表达式中使用
\s(例如str.trim()的底层逻辑或/\s+/g)。 - 精确文本协议解析与结构化代码重构:当严格只匹配半角空格、绝不能伤及换行符和制表符时,正则表达式应书写
/ /或/\x20/。
五、全景特性总结对比
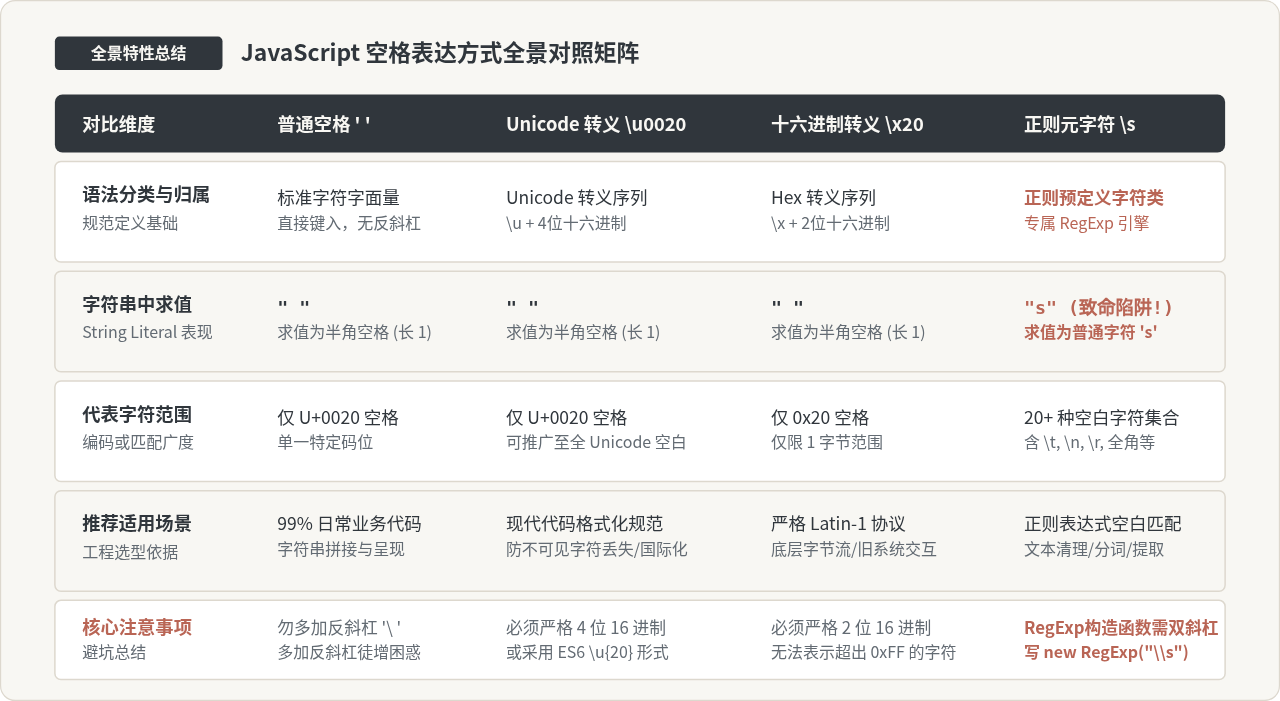
为了直观对比本文涉及的四种空格与空白表达方式,下表从底层属性、求值结果、代表范围到核心陷阱进行了全景归纳:
六、常见注意事项与排错清单
在涉及字符串转义与数据传输的实际工程场景中,还需特别警惕以下三处边界细节:
1. JSON 数据规范中的转义限制
JSON 并非 JavaScript 的完整超集。在标准 JSON 规范(RFC 8259)中,字符串只允许特定的转义符(
JSON 并非 JavaScript 的完整超集。在标准 JSON 规范(RFC 8259)中,字符串只允许特定的转义符(
\"、\\、\/、\b、\f、\n、\r、\t 以及 \uXXXX)。在 JSON 数据中,书写 "\s" 或 "\x20" 属于非法语法,调用 JSON.parse() 会直接抛出 SyntaxError: Unexpected token。在 JSON 中表达空格,只能直接键入空格,或使用 Unicode 转义 \u0020。
2. ES6 模板字符串与 String.raw 的转义保留
在模板字符串中,常规转义行为与单/双引号一致。但如果使用了
在模板字符串中,常规转义行为与单/双引号一致。但如果使用了
String.raw 标签函数,反斜杠将作为原始字符保留:
console.log(String.raw`hello\x20world`);
// 示例输出: "hello\x20world" (原始反斜杠保留,不会转义为单个空格)

console.log(String.raw`hello\sworld`);
// 示例输出: "hello\sworld" (字符长度为 12)
3. 不换行空格(NBSP)的肉眼误导排查
从网页富文本编辑器或 Word 文档中复制文本时,经常混入不换行空格
从网页富文本编辑器或 Word 文档中复制文本时,经常混入不换行空格
\u00A0(HTML 的 )。其在屏幕渲染上与普通空格完全相同,但通过严格相等判断 '\u00A0' === ' ' 会得到 false。此时若使用普通空格替换 str.replace(/ /g, '') 将无法清除它,必须使用 /\s/g 或 /\u00A0/g 才能成功匹配。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章