
详细讲解在JavaScript中对数组去重时如何严格保持元素的原始顺序。包含基础类型数组去重、对象数组按ID保序去重、Set迭代顺序规范以及规避普通对象数字键乱序陷阱的完整解决方案与代码示例。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组去重后怎么保持原始顺序?
作者:小括号
时间:2026-11-03
浏览:440
文章目录
核心方案提炼:在 JavaScript 中保持元素第一次出现的原始相对顺序进行去重,最精简高效的方案是使用 ES6 的
[...new Set(arr)];如果面对的是需要按某个属性键去重的对象数组,或是需要加入自定义清洗条件的场景,则推荐结合哈希标记维护的 filter + Set 方案。两者的执行时间复杂度均为 O(n),既能保证百毫秒级高效过滤,又从规范层面彻底杜绝了次序紊乱。
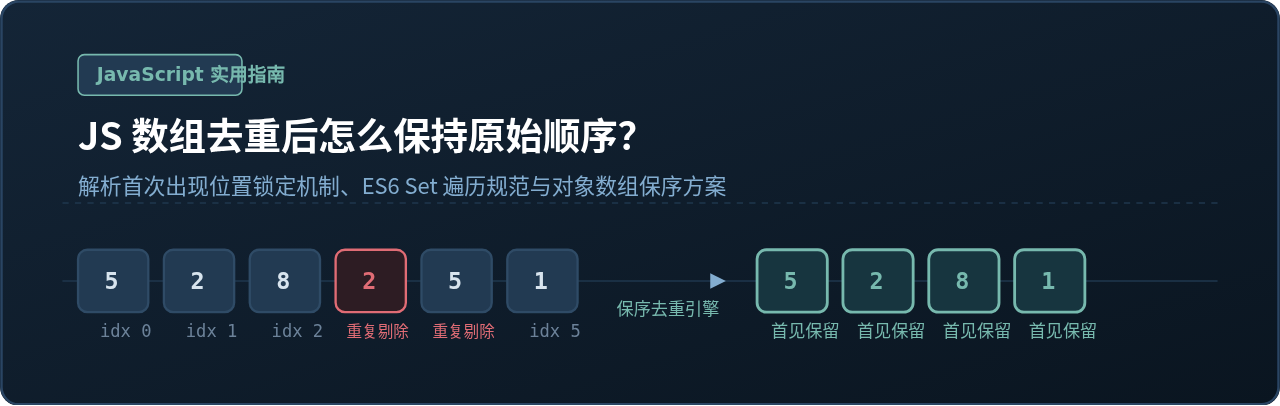
假设你正在处理一份用户浏览历史记录或按时间戳产生的操作日志:['首页', '商品详情', '购物车', '商品详情', '订单确认']。如果直接采用某些先排序再比较相邻元素的去重技巧,或者使用普通对象的属性名存储,最终得到的数组很可能会被打乱成拼音字典序或升序排列。在许多业务场景下,顺序本身就蕴含着关键的时间线、权重或操作因果关系,去重时必须严格保留元素初次登场时的相对次序。
很多开发者在刚接触数组去重时,往往只关注“重复值是否被删掉”,却忽略了“元素原有的相对位置是否被破坏”。本文将系统讲解 JavaScript 中真正能够“保序去重”的常用手段、底层原理、避坑要点以及业务中对象数组的最佳实践。
一、首选方案:ES6 Set 与扩展运算符(最简且高性能)
对于数字、字符串、布尔值等基本类型组成的数组,现代 JavaScript 提供了最简洁、性能也极高的一行代码写法:
const rawList = [5, 2, 8, 2, 5, 1];
const uniqueList = [...new Set(rawList)];

console.log(uniqueList);
// 示例输出:[5, 2, 8, 1]
// 元素 5 与 2 首次出现的位置完全锁定,后续出现的重复值被剔除,没有发生次序变动
为什么 Set 能够天然保持原数组的先后顺序?
这并非巧合,而是 ECMAScript 规范做出的明确保证。在 ES2015(ES6)标准中,Set 集合的遍历顺序被强制定义为严格按照元素被插入的次序(Insertion Order)进行迭代。
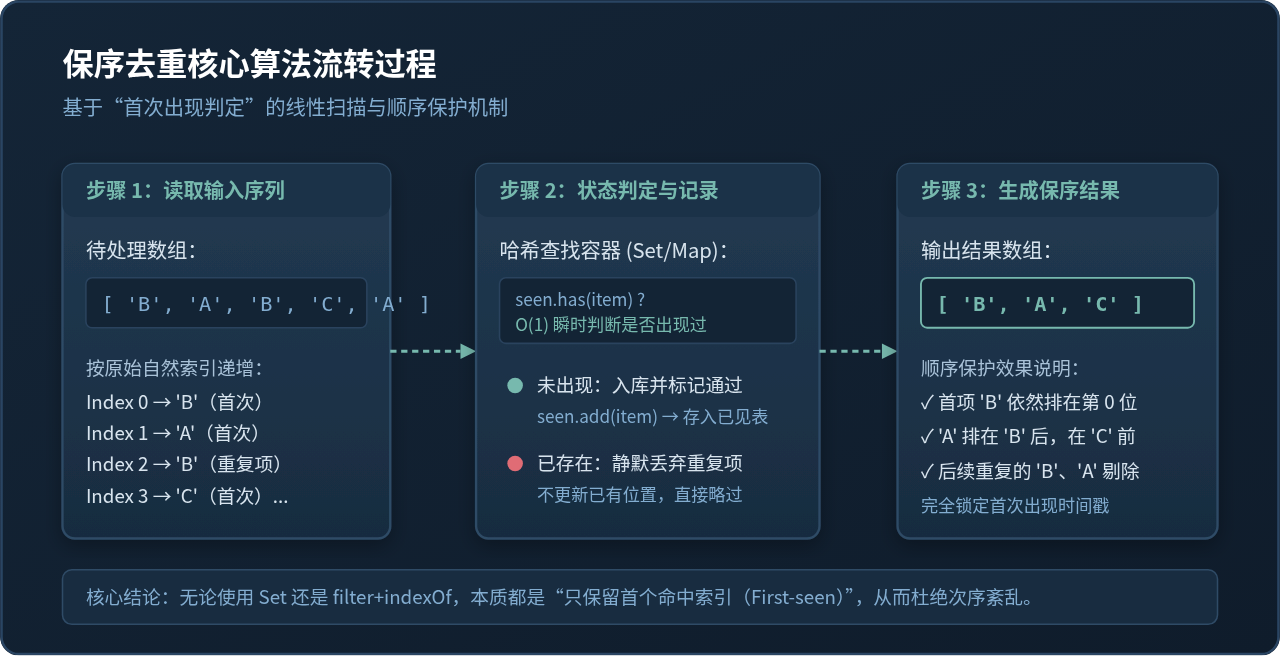
当我们把原数组传入 new Set(rawList) 时,构造函数会按照数组从下标 0 到末尾的自然顺序依次读取并插入。遇到之前没有见过的元素,Set 会将其追加到其内部链表尾部;遇到已经存在的重复元素时,Set 直接忽略本次插入,并不会调整该元素已经在内部链表中的位置。随后使用 [...set] 或 Array.from(set) 展开时,导出的序列自然与原数组中各元素首次亮相的相对次序完全一致。
二、进阶方案:filter + Set 缓存判定(兼具灵活性与 O(n) 效率)
[...new Set(arr)] 虽然写起来快捷,但在某些复杂需求下并不够灵活——例如你希望在去重的同时剔除无效空值(null、undefined),或者去重规则需要由一段动态条件决定。此时,结合 Array.prototype.filter 与一个局部的 Set 缓存集合,是工程中最稳健的组合拳:
function uniqueKeepOrder(arr) {
  const seen = new Set();
  return arr.filter(item => {
    // 基础有效性过滤与去重检查同步进行
    if (item === null || item === undefined) {
      return false;
    }
    if (seen.has(item)) {
      return false;
    }
    seen.add(item);
    return true;
  });
}

// 验证执行
const source = ['apple', null, 'banana', 'apple', 'orange', 'banana'];
const result = uniqueKeepOrder(source);
console.log(result);
// 示例输出:['apple', 'banana', 'orange']
这种写法为什么能在保持顺序的同时拥有出色的性能?
- 顺序保证:
filter本身就是从索引 0 开始单向线性遍历原数组,只有返回true的元素才会被依次推入新结果数组中。只要我们在元素首次出现时返回true,就能保证原顺序绝不被颠倒。 - 常数级查找:
seen.has(item)的时间复杂度为O(1),整个过滤流程只需要遍历原数组一次,综合时间复杂度稳定在O(n),内存额外开销为O(n)。
三、规避陷阱:普通对象键去重为什么会破坏数字顺序?
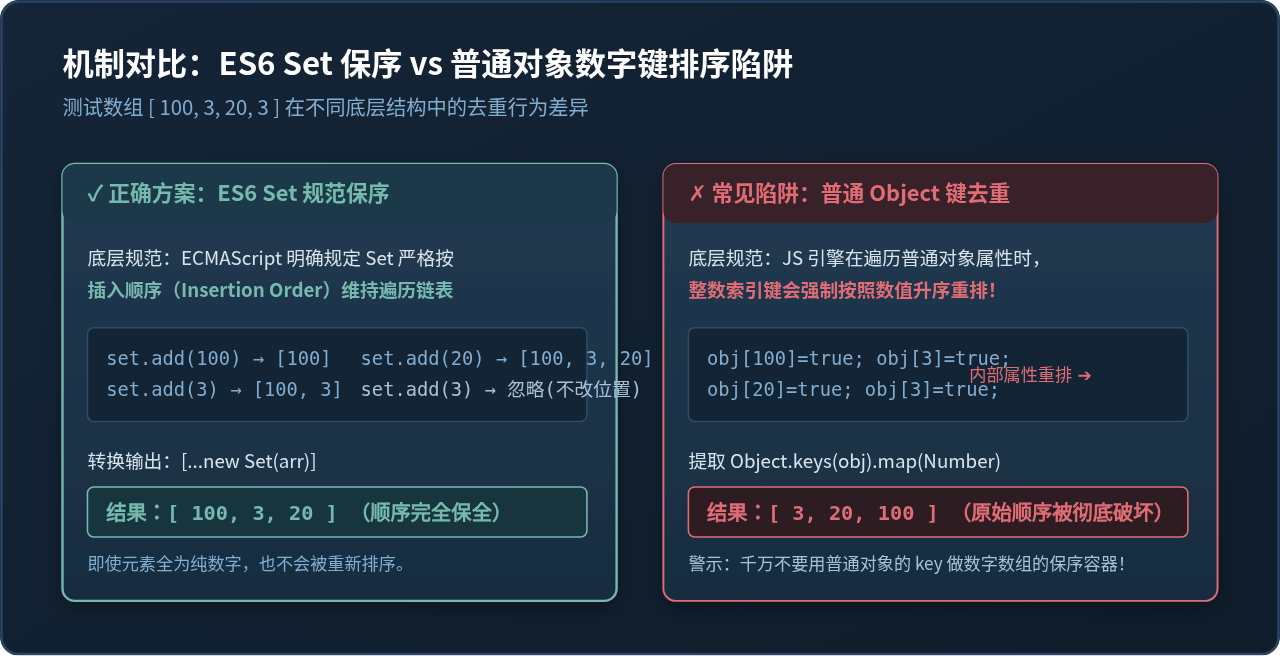
在旧版 JavaScript 教程中,常常能看到利用普通对象 {} 的键唯一性来去重的代码:把数组元素当成对象的 key 存进去,最后用 Object.keys() 拿出来。如果你的数组包含数字或纯数字字符串,这种方法会彻底摧毁原本的顺序!
// 错误示范:利用普通对象去重
const badNumbers = [100, 2, 35, 2];
const obj = {};
badNumbers.forEach(n => { obj[n] = true; });

const brokenResult = Object.keys(obj).map(Number);
console.log(brokenResult);
// 示例输出:[2, 35, 100]  —— 原始顺序 [100, 2, 35] 被完全篡改为升序!
这是因为 V8 及主流 JavaScript 引擎在实现 ECMAScript 的属性遍历规范(如 OrdinaryOwnPropertyKeys)时,规定所有可以转换为整数的属性键,必须优先按照升序排列进行遍历,随后才按插入顺序遍历普通字符串键。因此,一旦将数字作为对象的 key,取出来时就会被强制按数值从小到大重排,导致原本以 100 开头的序列变成了以 2 开头。
避坑重点:切勿使用普通字面量对象
{} 的属性键作为包含数字或顺序敏感数据的去重容器。若要维护键值对映射,请务必使用符合 ES6 规范的 Set 或 Map。
四、传统经典方案与性能警示:filter + indexOf
在 ES6 普及之前,前端代码中最为常见的保序去重写法是 filter 结合 indexOf:
const items = ['X', 'Y', 'X', 'Z', 'Y'];
const uniqueItems = items.filter((item, index) => items.indexOf(item) === index);

console.log(uniqueItems);
// 示例输出:['X', 'Y', 'Z']
运作原理解析与局限性
indexOf(item) 的运行机制是:始终从数组的下标 0 开始向前查找,并返回目标元素在整个数组中第一次出现的下标。当循环遍历到某个元素时,只有当前遍历索引 index 恰好等于其首次出现索引时,条件才成立;当遇到后续重复项时,index 变大了,但 indexOf 返回的依然是最初的下标,两者不相等,重复项随即被丢弃。这一逻辑完美契合了“保留首次出现”的保序定义。
然而该方法存在两个在生产环境中不可忽视的缺点:
- 时间复杂度高达 O(n²):外层
filter循环 n 次,每次内层indexOf又在原数组中从头扫描一次(平均 n/2 次)。当数据量从 100 增至 10,000 时,计算量从万级暴增到亿级,可能导致页面主线程严重掉帧甚至冻结。 - 无法正确处理 NaN:在 ECMAScript 的判定中,
NaN === NaN返回false,导致items.indexOf(NaN)永远返回-1。如果原数组包含NaN,filter + indexOf会直接将所有NaN滤除干净,无法保留哪怕一个。
五、高频业务攻坚:对象数组(Array of Objects)按唯一键保序去重
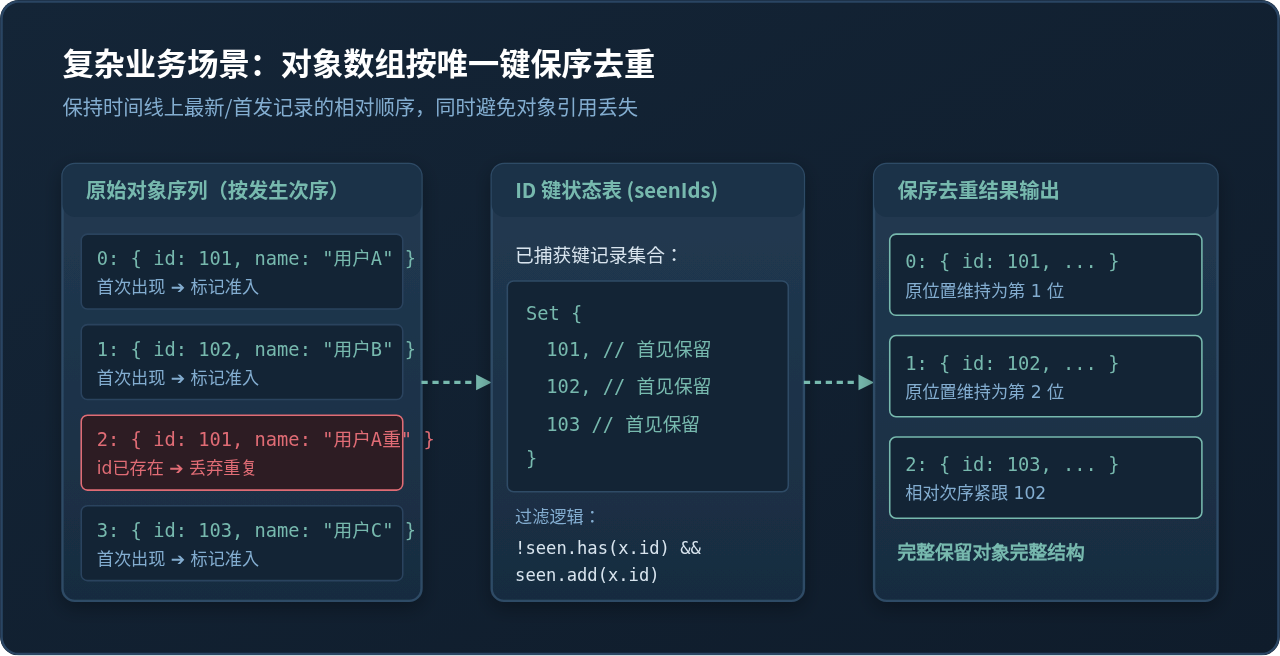
在实际业务开发中,最常遇到的往往不是简单的数字或字符串数组,而是从接口获取的由字典或对象组成的列表。例如电商购物车、审批人列表或下拉选项。因为每个对象的内存引用地址不同,new Set([{id:1}, {id:1}]) 无法识别内容层面的重复,必须按特定业务字段(如 id 或 code)去重,且必须保留先来后到的时间次序。
/**
 * 针对对象数组,按指定属性键进行保序去重(保留首次出现的对象)
 * @param {Array<Object>} list 目标对象数组
 * @param {string} key 用于判重的字段名
 * @returns {Array<Object>} 保序去重后的新数组
 */
function uniqueObjectsByKey(list, key) {
  const seenKeys = new Set();
  return list.filter(item => {
    if (!item || !Object.prototype.hasOwnProperty.call(item, key)) {
      return false;
    }
    const val = item[key];
    if (seenKeys.has(val)) {
      return false;
    }
    seenKeys.add(val);
    return true;
  });
}

// 业务调用示例
const members = [
  { id: 101, name: '张三', role: '开发' },
  { id: 102, name: '李四', role: '设计' },
  { id: 101, name: '张三(变更)', role: '开发Leader' },
  { id: 103, name: '王五', role: '测试' }
];

const deduplicatedMembers = uniqueObjectsByKey(members, 'id');
console.log(deduplicatedMembers);
/*
示例输出:
[
  { id: 101, name: '张三', role: '开发' },
  { id: 102, name: '李四', role: '设计' },
  { id: 103, name: '王五', role: '测试' }
]
原顺序完整保留:101 始终保持在第 0 位,102 紧随其后,后续冲突的 101 被阻断。
*/
如果业务要求“保留最后一次出现的记录”该怎么做?
偶尔我们也会遇到相反的需求:当存在多条相同 ID 的记录时,需要以最新的状态为准,但依然要保全其顺序。如果依然要保持“最后一次出现的位置”,一种最优雅的实现是使用 reduceRight 反向收集或结合 Map 收集后再按位置排布:
function uniqueObjectsKeepLast(list, key) {
  // 利用 Map 覆盖旧值的特性,从后往前遍历并反转,或从前往后覆盖后提取
  const map = new Map();
  // 逆向遍历确保最后一次出现的项优先被注册锁定
  for (let i = list.length - 1; i >= 0; i--) {
    const item = list[i];
    if (item && !map.has(item[key])) {
      map.set(item[key], item);
    }
  }
  // 将结果倒序还原回自然时间轴
  return Array.from(map.values()).reverse();
}
六、保序去重方案横向对比与技术选型指南
为了在实际团队协作中做出恰当的技术决策,下表对各类主流方案的核心指标进行了系统性归纳:
| 去重实现手段 | 时间复杂度 | 空间复杂度 | 保序特性 | 适用数据类型 | 推荐指数与评价 |
|---|---|---|---|---|---|
[...new Set(arr)] |
O(n) | O(n) | 严格按首次出现保序 | 基础原始值(Number/String 等) | ★★★★★ 默认首选,代码最精简规范 |
filter + Set 缓存 |
O(n) | O(n) | 严格按首次出现保序 | 原始值、清洗复合条件 | ★★★★★ 业务清洗流水线首选 |
Set / Map 提取键 |
O(n) | O(n) | 严格按首次出现保序 | 对象数组(按 ID/Key 去重) | ★★★★★ 复杂数据结构标准工程实践 |
filter + indexOf |
O(n²) | O(1) | 严格按首次出现保序 | 基础原始值(不支持 NaN) | ★★☆☆☆ 仅百项内极小规模适用,严禁用于大数组 |
普通对象属性键 |
O(n) | O(n) | 不保序(数字键强行升序) | 所有类型均有风险 | ★☆☆☆☆ 严禁使用,极易引发生产乱序 Bug |
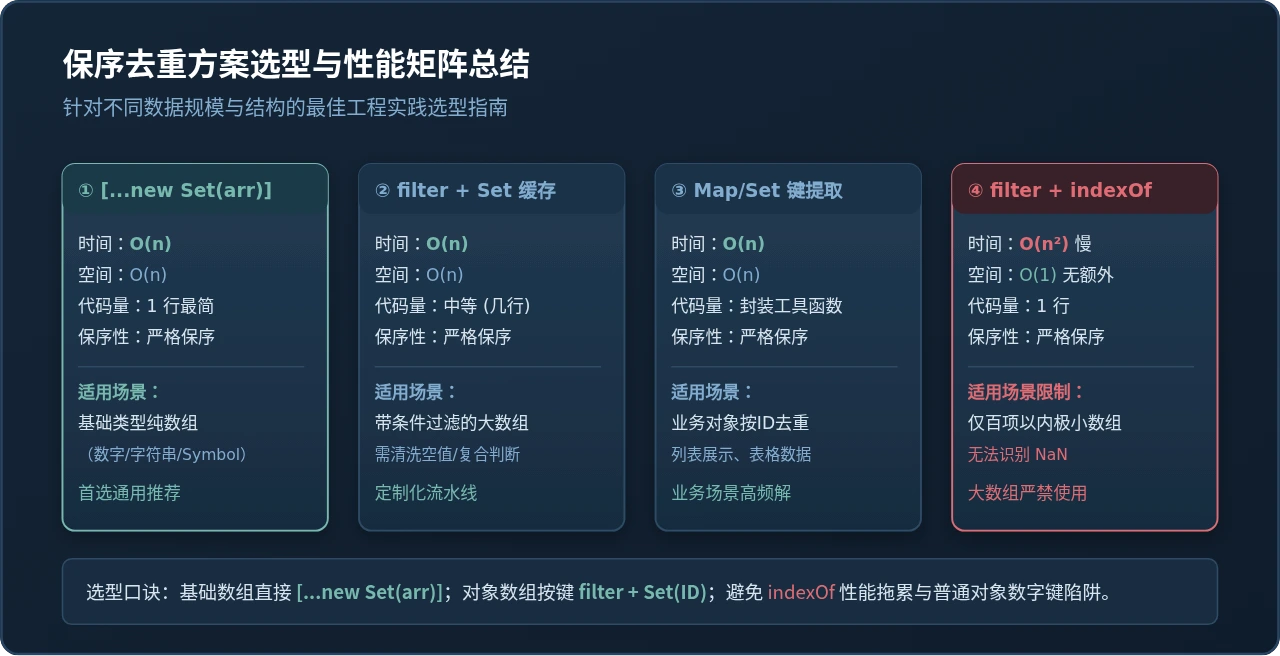
七、总结与最佳实践清单
在 JavaScript 中做到“去重且保序”,核心就在于对元素第一次出现的位置形成单向不可逆的锁定。在日常编码与代码审查中,可以遵循以下三条黄金准则:
- 基础数据无脑上 Set:对于包含数字、字符串的一维基础数组,直接使用
[...new Set(arr)]。它基于规范保证的插入次序,耗时低且代码意图一目了然。 - 对象数组提取唯一标识:对于结构化对象数组,使用
Set缓存已记录的 ID,配合filter进行单次线性扫描,确保业务对象引用的纯粹与次序稳固。 - 警惕破坏顺序的反模式:严禁先通过
sort()排序再去重,切勿使用普通对象的 key 存储数字索引,同时尽量避免在大数据集上使用indexOf导致性能退化。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章