
深入解析JavaScript正则表达式中贪婪模式与非贪婪模式的本质区别,详细剖析量词匹配逻辑、正则引擎回溯流程、最左匹配优先规则以及实际工程中的性能选型。

当前位置:首页 > JavaScript 基础 > 正文
JS正则表达式中的贪婪与非贪婪模式有什么区别
作者:异步漫步
时间:2026-11-03
浏览:652
文章目录
分类:JavaScript 进阶 / 正则表达式
核心概念:贪婪量词 · 惰性量词 · 回溯演进
运行环境:Node.js / ECMAScript 标准引擎
JavaScript 中的正则表达式量词在默认情况下是贪婪(Greedy)的,即在整体表达式能够匹配成功的前提下,量词会尽可能多地“吞噬”字符;如果在量词后追加一个问号
?,该量词就会转变为非贪婪(Non-greedy / Lazy 惰性)模式,改为在满足条件的最小单位处尽可能少地匹配字符。两者的本质区别不在于查找位置的起跑线,而在于量词对字符长度的摄取偏好以及底层正则引擎的回溯推进方向。
一、语法形态与量词对照表
在 JavaScript 正则表达式中,控制字符出现次数的符号被称为量词(Quantifier)。常见的量词包括 *、+、? 以及区间量词 {n,m}。默认状态下,这些量词均按照贪婪语义工作。要开启非贪婪模式,无需修改全局修饰符,只需直接紧随量词之后添加英文问号 ?。
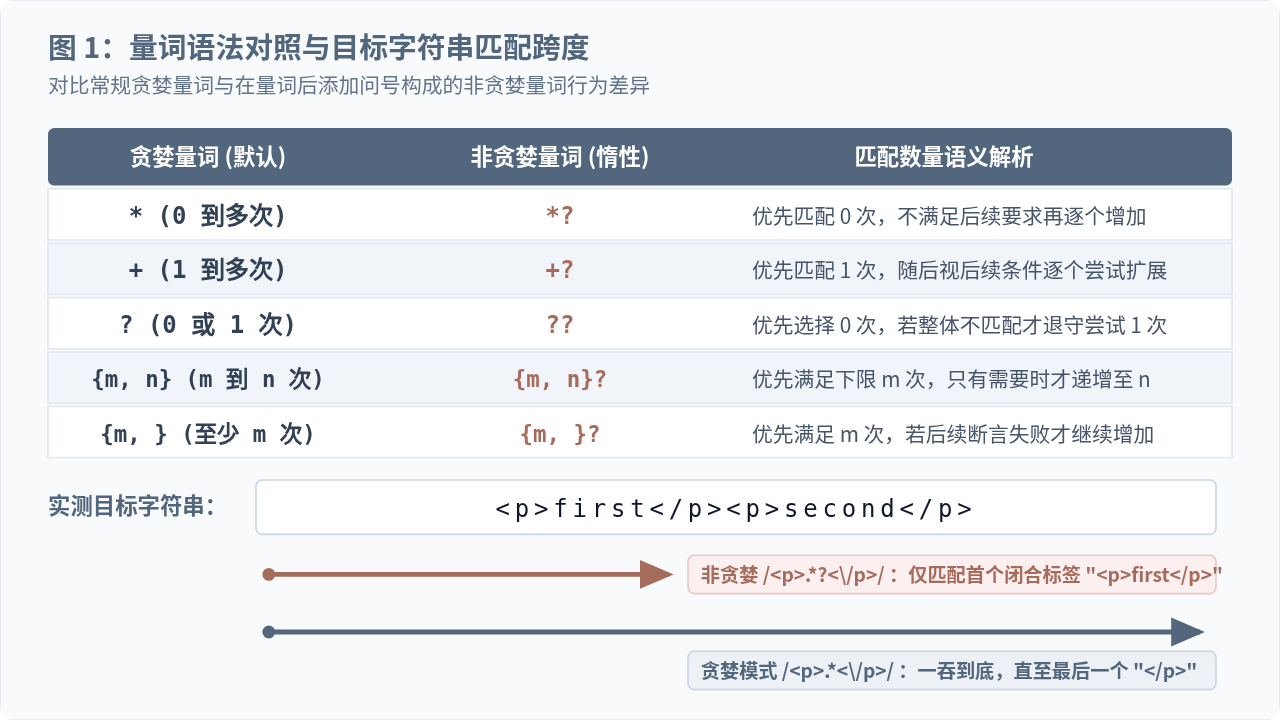
| 贪婪量词 | 非贪婪量词 | 匹配次数范围 | 贪婪模式行为偏好 | 非贪婪模式行为偏好 |
|---|---|---|---|---|
* |
*? |
0 次到多次 | 优先匹配尽可能多次,直到文本末尾 | 优先匹配 0 次,不满足后续表达式时才递增 |
+ |
+? |
1 次到多次 | 优先匹配尽可能多次 | 优先匹配 1 次,满足后方条件即刻刹车 |
? |
?? |
0 次或 1 次 | 优先匹配 1 次 | 优先匹配 0 次 |
{m,n} |
{m,n}? |
m 次到 n 次 | 优先匹配上限 n 次 | 优先满足下限 m 次 |
{m,} |
{m,}? |
至少 m 次 | 优先匹配最大可用次数 | 优先匹配 m 次 |
观察上述表格会发现一个极易让初学者困惑的符号:??。第一个问号代表“出现 0 次或 1 次”的量词,第二个问号则代表“非贪婪修饰符”。因此 ?? 的真实含义是:这是一个可以在 0 与 1 之间选择的量词,但它极其偏向于取 0 次。
二、底层执行推导:贪婪吞噬与向左回溯
要真正理解两者的差异,必须深入到正则引擎(如 V8 的 Irregexp 引擎)的内部状态变迁。很多开发者以为贪婪匹配只是“刚好截取了更长的字符串”,但实际上贪婪匹配的执行路径是“先全部吞入到底,碰壁后再一步一步向左吐出”,这个向左吐出字符以成全后续模式匹配的过程被称为回溯(Backtracking)。
考虑以下经典代码片段:
// 目标:提取 HTML 中的第一对 div 标签
const html = '<div>text</div>';
const greedyPattern = /<.*>/;
const result = html.match(greedyPattern);

console.log(result[0]);
// 实际输出示例:
// "<div>text</div>"
在上述代码中,我们的初衷可能是想捕获标签头 <div>,但实际输出却吃掉了整整一行,甚至包括了闭合标签 </div>。正则引擎的推导过程如图 2 所示:
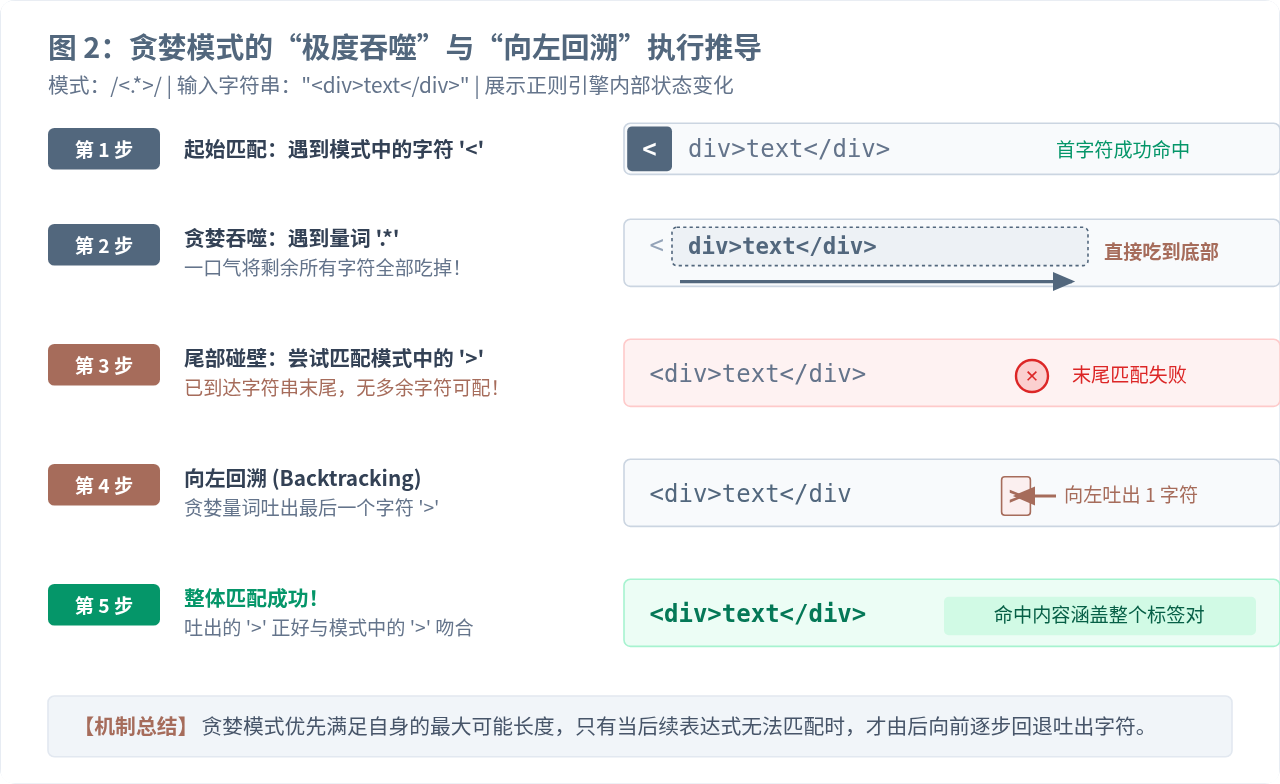
- 左侧定界符锚定:模式首先扫描到
<,命中字符串第 0 位的<。 - 通配符极度吞噬:紧接着遇到贪婪量词
.*。因为.能够匹配除换行符外的任意字符,贪婪特性会指令游标直接一路快进到字符串的最末尾(将div>text</div>全部吃掉)。 - 右侧条件碰壁:此时模式要求下一个字符必须是
>。但当前游标已经站在字符串尾端(EOF),无字符可供匹配,宣告当前尝试失败。 - 触发回溯吐字:由于贪婪量词持有可退让的字符,引擎将游标向左回退一个字符,让
.*放弃对最后一个字符>的占有。 - 再次验证并成功:被吐出的字符正好是
>,与模式末尾的>成功吻合,整个正则表达式匹配成功退出。
三、底层执行推导:非贪婪的最小尝试与逐步试探
与贪婪模式截然相反,非贪婪模式秉持“能不吃就不吃,满足即止”的原则。它在遇到量词时,首先选择量词区间的最小值;随后立刻交出控制权,让紧随其后的子表达式先行尝试。如果后续表达式匹配失败,非贪婪量词才被迫多摄入一个字符,再次交出控制权。
const html = '<div>text</div>';
const lazyPattern = /<.*?>/;
const result = html.match(lazyPattern);

console.log(result[0]);
// 实际输出示例:
// "<div>"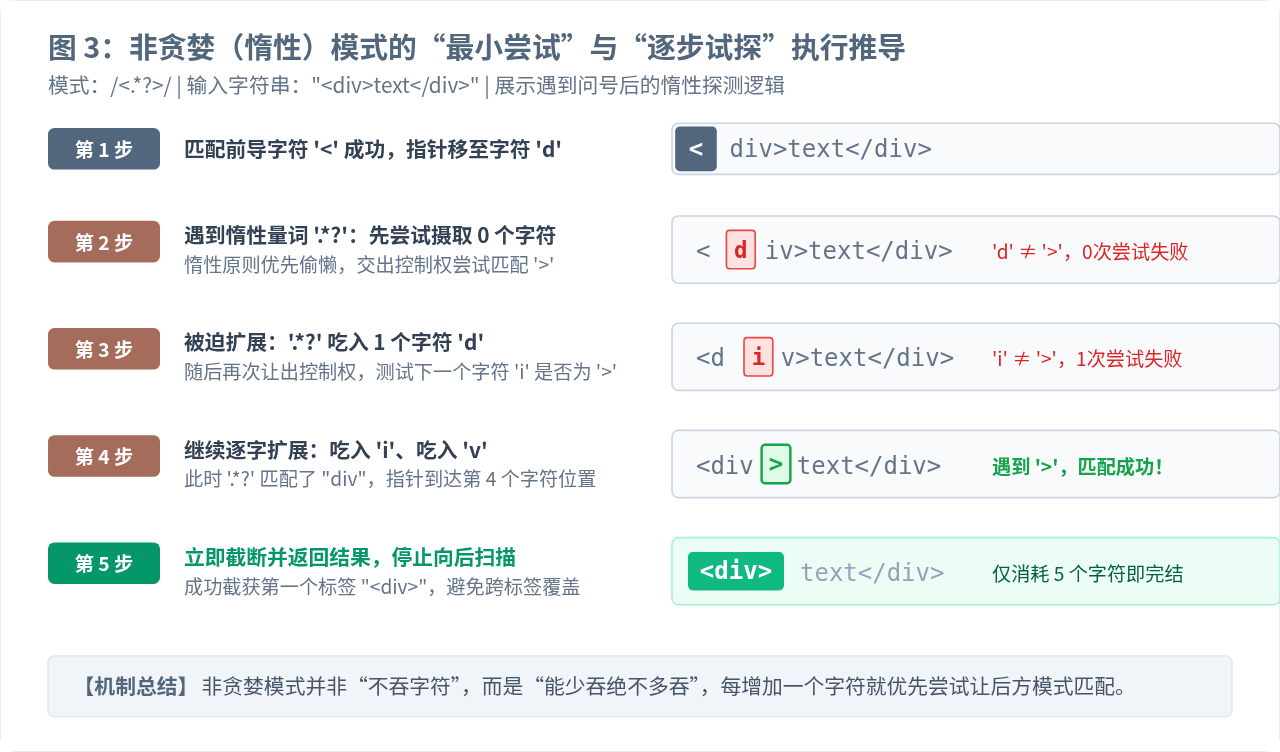
如图 3 所示,当引擎在第 0 位匹配到 < 后,紧跟着遇到 .*?:
.*?能够匹配 0 次,因此它首先选择消耗 0 个字符,立即让后续的>进行匹配。- 后续字符是
'd',与>不符,匹配失败。 .*?被迫递增匹配范围,吞入'd'(长度变为 1),再次把控制权转交给>,测试字符'i',仍不匹配。- 继续依序吞入
'i'、'v'。此时游标到达第 4 位,后续字符正是>。 >成功匹配,正则表达式整体成立,引擎直接结算并返回"<div>",不再往后多看哪怕一个字符。
四、初学者极易踩坑的“最左优先”原则
在关于非贪婪模式的讨论中,最普遍的一个误区是:“非贪婪模式会在目标字符串中寻找整体长度最短的匹配片段。”
⚠️ 必须警惕的核心铁律:最左优先(Leftmost First)
正则表达式引擎扫描字符串时,始终遵循严格的从左到右扫描顺序。引擎首要满足的是“最先开始匹配的位置”,而非“整体最短的位置”。只有在起始点完全相同的情况下,贪婪与非贪婪的长度选择才会生效。
通过下面这道经典的测试用例可以清晰验证:
const source = "a123a4b";
const pattern = /a.*?b/;
const matched = source.match(pattern);

console.log(matched[0]);
// 疑问:子串中包含两个 a,"a4b" 明显比 "a123a4b" 短得多,
// 非贪婪模式是否会返回 "a4b"?
//
// 实际输出示例:
// "a123a4b"
执行结果依然是 "a123a4b"。原因在于:引擎从左向右扫描,在索引 0 处遇到了第一个 a,此时匹配引擎已经锚定了起点。在当前起点下,.*? 逐步向右探测,直到遇到第 6 位的 b 宣告成功。引擎绝不会为了让匹配结果更短,而故意放弃已经成功建立的左侧起点去往后寻找第二个 a。
五、工程实践中的模式选型与性能权衡
虽然非贪婪模式 .*? 能够有效解决跨标签匹配的问题,但在实际工程开发(如海量日志解析、复杂富文本过滤)中,无节制地滥用非贪婪量词往往会引入意想不到的性能损耗,甚至埋下正则表达式拒绝服务攻击(ReDoS)的隐患。
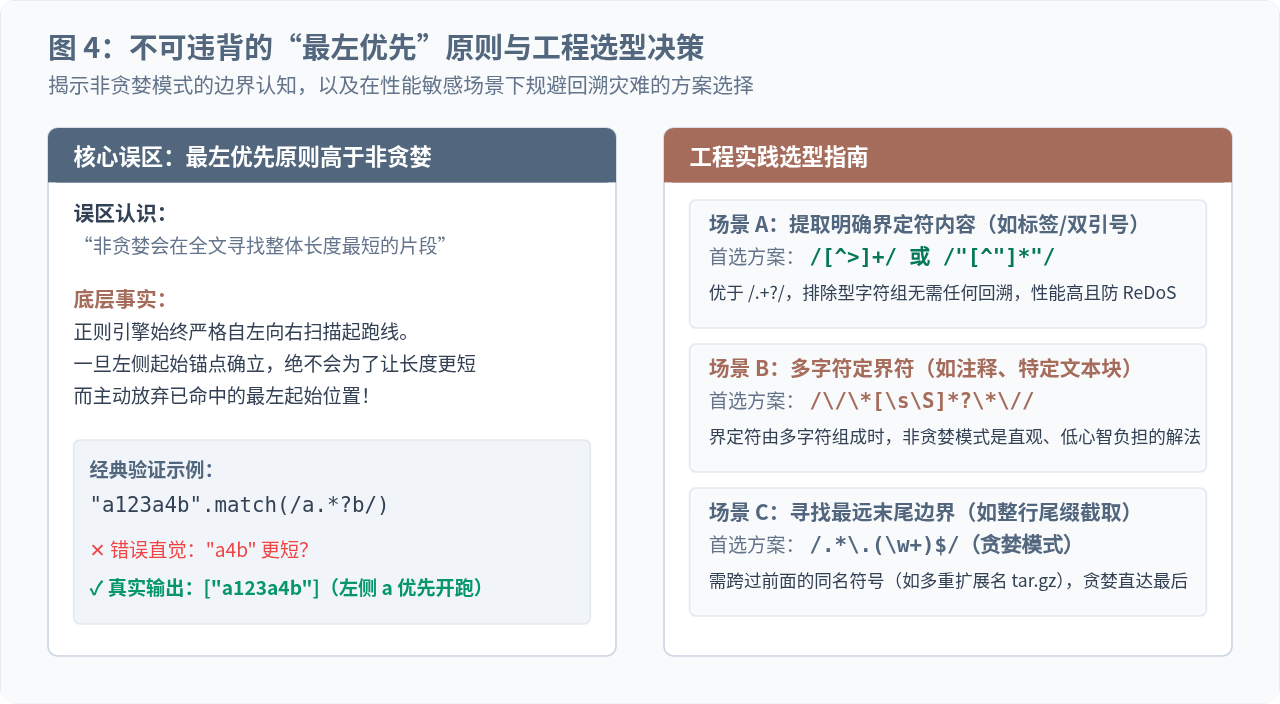
1. 为什么“排除型字符组”通常优于“非贪婪通配”?
当我们要提取闭合标签内的属性或内容时,很多人的第一反应是写 /<.*?>/g。但请注意,非贪婪模式在遇到不匹配的情况时,每前进一步都会进行一次上下文切换(尝试后方匹配 -> 失败 -> 吞入一个字符 -> 再次尝试后方匹配)。如果文本较长且闭合符号缺失,会导致大量的回溯计算。
相比之下,更健壮且高效的方案是使用排除型字符组(Negated Character Class):
// 方案 A:非贪婪通配(存在逐步试探的开销)
const regexLazy = /<[^>]*?>/g;

// 方案 B:排除型字符组(推荐最佳实践)
const regexNegated = /<[^>]*>/g;

// 性能与确定性对比:
// [^>]* 表示“只要不是 > 就全速吞噬”,当它停下时,下一个字符必然是 >(或者字符串结束)。
// 正则引擎不需要来回试探,零多余回溯,单次扫描即可完成。
2. 常见场景选型对照
-
提取单双引号内的字符串:
避免使用/"(.*)"/(会吞噬掉整行中所有引号之间的一切);
普通场景可用/"(.*?)"/;
性能最优解是/"([^"\]*(?:\.[^"\]*)*)"/(使用排除字符组,并兼顾转义字符)。 -
跨行多字符定界符(如多行注释
/* ... */):
由于定界符是由多个字符*/组合而成,单字符排除集无法表达,此时非贪婪量词是表达力最强、最简洁的工具:/\/\*[\s\S]*?\*\//g。 -
获取路径或文件名的最终扩展名:
如从archive.tar.gz中获取最后一个后缀gz。此时应当利用贪婪模式的特性:/.*\.(\w+)$/。开头的.*会贪婪吞掉前面的所有点(包括.tar),直到最后一个点才停下,从而精准捕获最终后缀。
六、总结与速记口诀
💡 核心要点速查清单
- 默认贪婪:量词不带问号,遵循“能多拿绝不少拿”,先吞到底,失败则向左逐字回溯。
- 加问号变非贪婪:量词后加
?,遵循“能少拿绝不多拿”,取最少起步,逐步向右试探。 - 最左优先是基石:正则永远先看起始位置,起跑线定下后才决定跨度大小,非贪婪不会为了更短而退后起跑线。
- 明确边界优先用排除集:提取特定符号包围的内容时,
[^x]+通常在执行效率和安全性上优于.+?。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章