

深入解析 anime.js 动画性能瓶颈,从避免强制重排与布局抖动,到多实例调度收拢与突破 DOM 极限的 Canvas 协同技巧,提供系统的性能优化与实操方案。
anime.js 性能优化:避免布局抖动与大规模动画处理技巧
作者:寒星
时间:2026-11-03
浏览:191
文章目录
JavaScript 动画与前端渲染性能
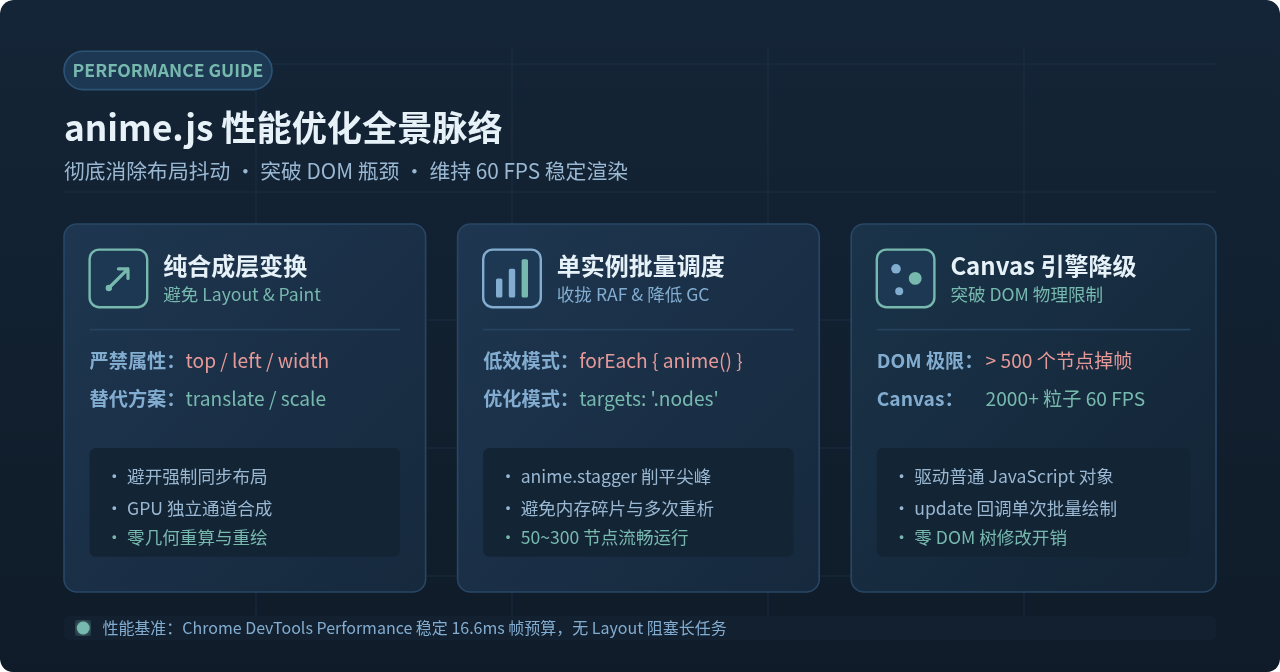
在 anime.js 动画中遇到掉帧与卡顿,其核心根源只有两个:一是修改了触发布局与重绘的几何属性,诱发了浏览器主线程的“布局抖动”;二是在元素数量达到数百时,分散创建了过多独立动画实例,导致垃圾回收停顿与计算爆炸。本文将直接说明如何将动画约束至 GPU 合成层,并提供单实例调度、stagger 分布计算以及 Canvas 架构降级的具体工程实现。
图 0:anime.js 性能优化全景图(从合成层隔离到大规模 Canvas 降级策略)
一、性能瓶颈的本质:浏览器渲染管线与布局抖动
假设你正在开发一个包含 300 个卡片节点的数据展示页。为了实现卡片浮动入场,代码中通过循环为每个元素单独调用了 anime({ targets: el, top: [100, 0], opacity: [0, 1] })。在本地开发机上看似正常,但在低配设备或稍微复杂的页面中,滚动就会变得异常生涩,Chrome DevTools 的 Performance 面板更是被大段红色的长任务(Long Tasks)占满,帧率骤跌至 20 FPS 以下。
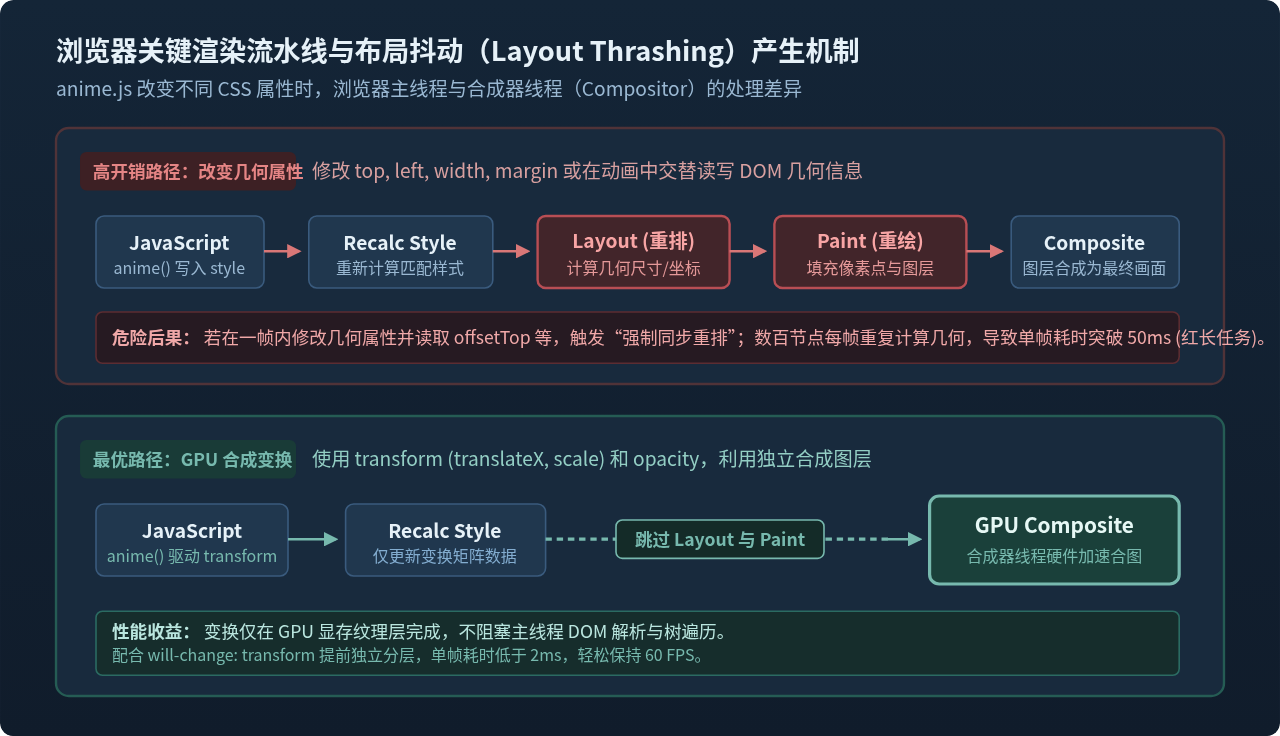
要彻底解决这个问题,必须先理解浏览器的关键渲染管线(Critical Rendering Path)。当浏览器准备在屏幕上绘制一帧时,必须经历五个核心阶段:JavaScript 执行 → Style(样式计算) → Layout(几何重排) → Paint(栅格化重绘) → Composite(图层合成)。
当你在动画中修改 top、left、margin、width 或 height 时,浏览器必须从 Layout 阶段重新计算每个元素的精确几何坐标。若动画期间的其他脚本(例如滚动监听或状态检查)在修改样式的同个帧内读取了 offsetTop、clientWidth 或 getBoundingClientRect(),浏览器为了返回准确的尺寸,就会被迫提前暂停当前脚本,立即执行一次完整的样式重析与几何运算,这就是强制同步重排(Forced Synchronous Layout)。当这种“写-读-写”在一个动画周期内密集重复时,就演变成了灾难性的布局抖动(Layout Thrashing)。
图 1:渲染管线开销对比(修改几何属性的重排重绘链路 vs 走合成器线程的极速链路)
与之相对,现代浏览器拥有独立的合成器线程(Compositor Thread)。当修改仅限于 transform(位移、缩放、旋转)与 opacity(透明度)时,浏览器既不需要计算几何尺寸(跳过 Layout),也不需要重新栅格化像素(跳过 Paint),而是直接由 GPU 对已有的图层纹理进行矩阵变换。这使得主线程在整个动画过程中处于完全空闲状态,能够稳定保持 16.6ms 以内(60 FPS)的流畅帧预算。
二、属性层优化:彻底杜绝布局抖动的重构规则
优化 anime.js 的第一步,是建立绝对的属性使用纪律。凡是涉及元素位置移动与形态变化的场景,必须 100% 替换为合成器友好的变换属性。
| 常规/低效写法(触发布局抖动) | 高性能替代写法(仅走 Composite) | 底层管线差异 | 性能评级 |
|---|---|---|---|
top: [100, 0] / left: [50, 0] |
translateY: [100, 0] / translateX: [50, 0] |
跳过 Layout 与 Paint,GPU 硬件变换 | 推荐 60 FPS |
width: [0, 200] / height: [0, 100] |
scaleX: [0, 1] / scaleY: [0, 1] |
不影响父级与兄弟元素几何排列 | 推荐 60 FPS |
margin-left: 20 |
translateX: 20 |
消除整棵 DOM 树的联动重排连锁反应 | 推荐 60 FPS |
box-shadow 阴影动态过渡 |
伪元素 ::after 预绘阴影,动画其 opacity |
避免每帧对高斯模糊算法进行 CPU 像素重绘 | 推荐 60 FPS |
1. 代码重构前后对比
以下是导致布局抖动的典型反面教材:
// ❌ 错误示范:修改几何属性,诱发连续重排与布局抖动
const items = document.querySelectorAll('.card-item');
items.forEach(el => {
  anime({
    targets: el,
    top: '+=50px',    // 触发布局重排
    left: '+=30px',   // 触发布局重排
    duration: 1000,
    easing: 'easeInOutQuad'
  });
});
改写为严格使用合成层属性的规范代码:
//  优化后:利用 transform 属性并批量交由单一选择器处理
anime({
  targets: '.card-item',
  translateY: 50,          // 仅在合成器线程更新矩阵
  translateX: 30,          // 无须重新计算几何
  duration: 1000,
  easing: 'easeInOutQuad'
});
2. will-change 的合理使用与内存边界
在 CSS 中为高频动画元素添加 will-change: transform 可以提前告知浏览器为该元素分配独立的合成图层(Compositing Layer),从而避免在动画启动瞬间产生主线程图层提升(Layer Promotion)的掉帧卡顿。
注意:避免滥用 will-change 导致“图层爆炸”
每个合成图层都会占用移动端或显卡的显存(VRAM)。如果在 300 个元素上无脑声明 will-change: transform,会导致显存暴增甚至页面崩溃。正确的做法是:只在当前参与动画的元素上激活,动画结束后在 anime.js 的 complete 回调中将其移除,或者仅赋予常驻动画的核心视口容器。
三、大规模动画技巧一:单实例调度与 stagger 批量控制
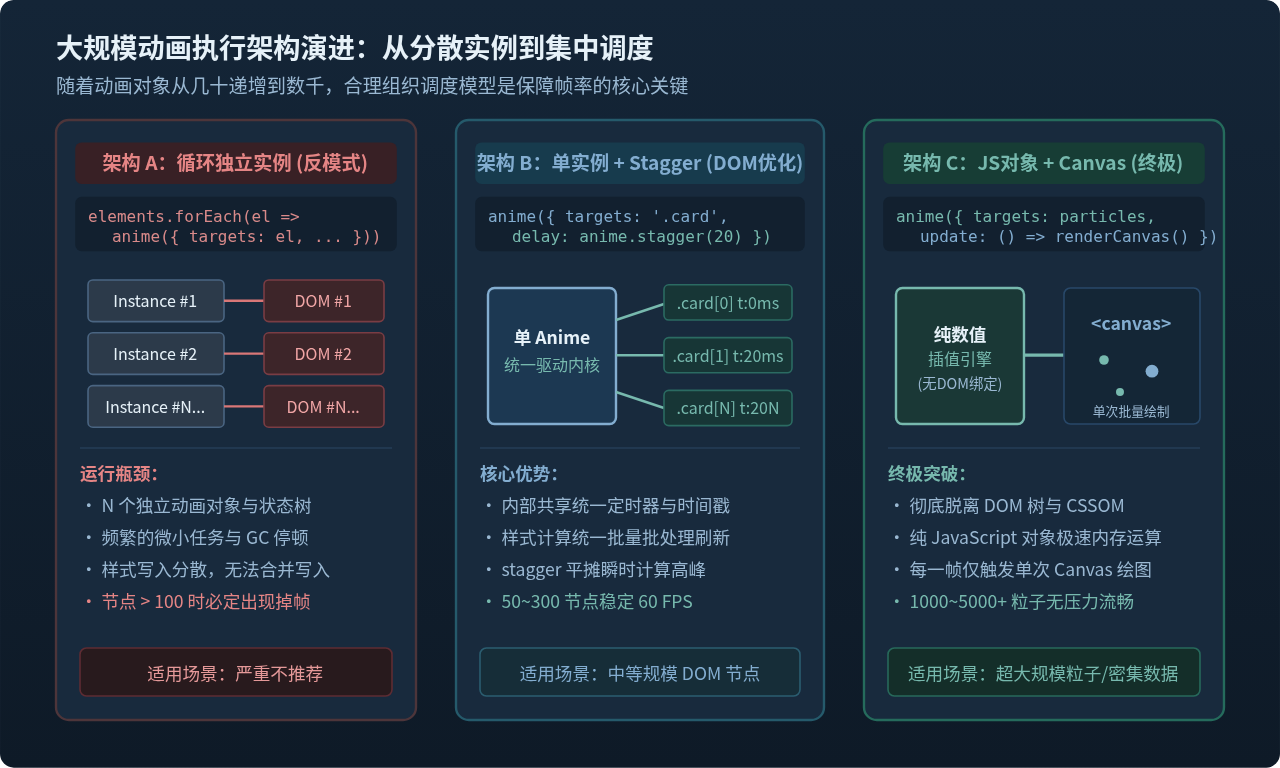
除了属性选择错误之外,另一个最普遍的性能杀手是创建过多独立 anime 实例。在处理几百个 DOM 元素时,使用 for 循环或 forEach 分别实例化 anime() 会导致灾难性的开销。
虽然 anime.js 内部依赖单根 requestAnimationFrame 循环驱动,但每个实例都会独立维护自身的补间数据结构、缓动函数解析、已完成时间计算以及属性解析队列。当创建 300 个实例时,每帧都需要遍历 300 个复杂对象,产生大量的临时微小内存分配。这不仅占满了主线程的 CPU 周期,还会频繁触发浏览器的垃圾回收机制(Garbage Collection),表现为每隔 1~2 秒就出现一次明显的界面卡死。
图 2:动画架构演进图(分散独立实例 vs 单实例 Stagger 批处理 vs 虚拟对象 Canvas 引擎)
优化方案:单一实例与 stagger 交错平摊
将全部 DOM 元素的控制器合并进一个单一的 anime 实例中。anime.js 的 targets 参数天然支持传入 CSS 选择器字符串、DOM 数组或 NodeList。
配合内置的 anime.stagger() 函数,可以为各个元素分配微小的启动延迟。这在视觉上呈现出生动自然的波浪式入场效果,在性能上则起到了至关重要的“削峰填谷”作用——它将所有元素集中在同一毫秒内的密集计算,分散到了长达数百毫秒的时间轴上,彻底避免了瞬间 CPU 满载:
//  大规模 DOM 最佳实操:单实例集中调度 + stagger 平摊
const animationInstance = anime({
  targets: '.grid-card',              // 单实例接管全部 200 个节点
  translateY: [60, 0],
  opacity: [0, 1],
  duration: 800,
  delay: anime.stagger(15, {         // 每个卡片错开 15ms,削平瞬时算力尖峰
    start: 100,
    from: 'center'                 // 从中央向四周辐射扩散
  }),
  easing: 'easeOutCubic',
  begin: (anim) => {
    // 动画启动时为所有目标挂载 will-change
    anim.animatables.forEach(a => a.target.style.willChange = 'transform, opacity');
  },
  complete: (anim) => {
    // 动画完成后释放合成层,返还 GPU 显存
    anim.animatables.forEach(a => a.target.style.willChange = 'auto');
  }
});
四、大规模动画技巧二:突破 DOM 极限——驱动虚拟对象与 Canvas 协同
当动画对象的数量进一步增加到 500、1000 甚至 3000 以上(例如粒子网格、星空背景、连线拓扑图、密集数据流时),无论如何优化 CSS 属性与调度策略,DOM 树本身的节点维护开销都会彻底击穿浏览器极限。每个 DOM 元素都附带庞大的上下文信息、样式解析链和事件系统,几千个 DOM 节点的位移会令浏览器的样式匹配引擎瘫痪。
解决超大规模动画的终极架构方案是:将 anime.js 解耦为纯粹的“数值插值计算器”,彻底放弃绑定 DOM,转由单个 HTML5 <canvas> 集中绘制。
anime.js 拥有一个极度强大但常被忽略的特性:它的 targets 可以接收任何普通的 JavaScript 对象(Plain Old JavaScript Object)。通过 anime.js 专注于计算物理曲线与属性插值,并在 update 回调中单次清除并绘制 Canvas,即可轻松驾驭数千粒子的流畅运行。
完整实操代码:1500 个高性能浮动粒子的实现
// 1. 准备 HTML 容器(页面仅保留 1 个真实的 Canvas DOM 节点)
const canvas = document.getElementById('particle-stage');
const ctx = canvas.getContext('2d');
const width = (canvas.width = window.innerWidth);
const height = (canvas.height = window.innerHeight);

// 2. 创建 1500 个内存中的普通 JavaScript 对象,脱离 DOM 树
const particleCount = 1500;
const particles = [];
for (let i = 0; i < particleCount; i++) {
  particles.push({
    x: Math.random() * width,
    y: Math.random() * height,
    radius: Math.random() * 3 + 1,
    alpha: Math.random() * 0.8 + 0.2
  });
}

// 3. 使用单个 anime.js 实例作为纯数值插值引擎
anime({
  targets: particles,
  x: (p) => p.x + (Math.random() - 0.5) * 120,
  y: (p) => p.y + (Math.random() - 0.5) * 120,
  alpha: [
    { value: 0.1, duration: 1200 },
    { value: 0.9, duration: 1200 }
  ],
  duration: 2400,
  easing: 'easeInOutSine',
  loop: true,
  direction: 'alternate',
  delay: anime.stagger(2),
  // 4. 关键:每帧仅在 update 回调中批量重绘一次 Canvas
  update: () => {
    ctx.clearRect(0, 0, width, height);
    for (let i = 0; i < particleCount; i++) {
      const p = particles[i];
      ctx.beginPath();
      ctx.arc(p.x, p.y, p.radius, 0, Math.PI * 2);
      ctx.fillStyle = `rgba(131, 173, 208, ${p.alpha})`;
      ctx.fill();
    }
  }
});
在上述实现中,1500 个粒子的全部位置变化完全在内存中进行浮点数运算,DOM 树上自始至终只有 1 个 Canvas 标签。浏览器完全不产生任何样式重算与重排,主线程的单帧消耗牢牢锁定在 4ms 内,彻底解决了大规模动画的掉帧顽疾。
五、实操工作流:Chrome DevTools 性能排查与 4 步落地
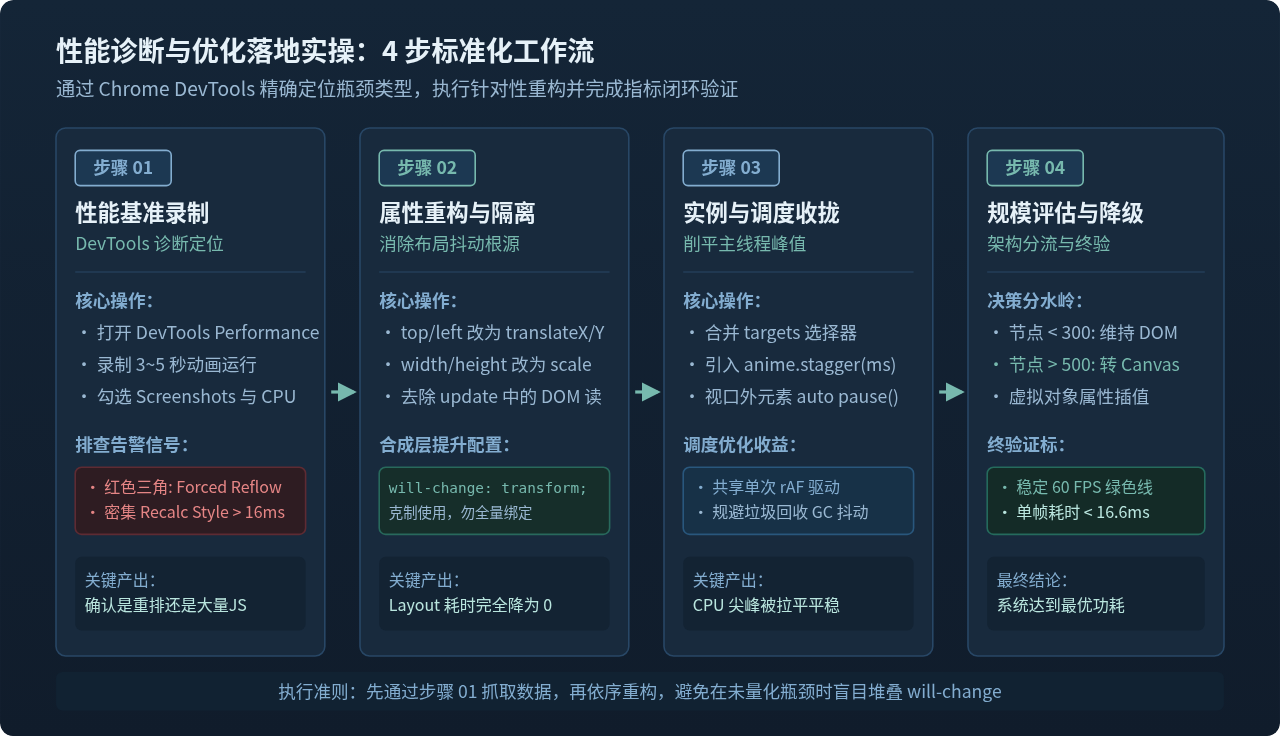
在进行性能重构时,切忌盲目猜测。遵循一套标准化的工程排查工作流,能够帮助团队在几分钟内精准找到卡顿的根源所在。
图 3:动画性能排查与 4 步优化落地流程图
-
步骤 1:录制动画性能剖析(Profiling)
按 F12 打开 Chrome 开发者工具,切换至 Performance 面板。在右上角齿轮中勾选 Screenshots,若想模拟中低端设备,可在 CPU 下拉菜单中选择 4x slowdown。点击左上角录制按钮,触发页面中的 anime.js 动画,运行 3~5 秒后停止录制。 -
步骤 2:识别警告信号与长任务(Long Tasks)
查看 Main 主线程轨道,展开上方带有黄色和红色斜杠的卡段。若出现带有红色小三角的Layout或Recalculate Style块,点击后在下方 Summary 面板中查看,若提示 "Forced reflow is a likely performance bottleneck",则直接定位到了布局抖动的具体代码行。 -
步骤 3:属性迁移与实例收拢
根据定位到的代码,依序执行前述重构:将几何属性改写为translate / scale;将分散的forEach实例合并为单选择器;加入stagger将瞬时峰值平抑至合理范围。 -
步骤 4:规模评估与渲染降级
再次录制并观察帧率(Frames)轨道。若帧率依然处于 30~45 FPS 徘徊,检查活动 DOM 数量。如果活动节点超过 300 个,立刻放弃在 DOM 上打补丁,直接转入 Canvas 虚拟对象架构。
六、总结与优化策略速查矩阵
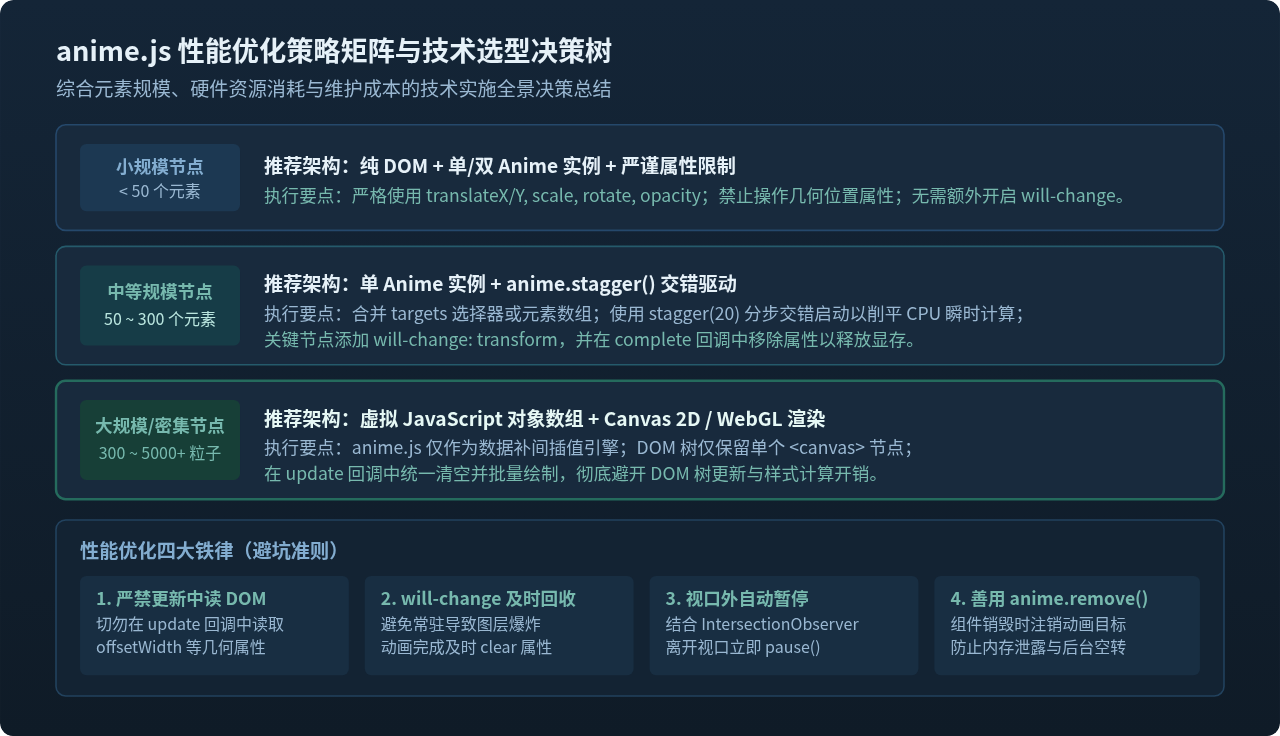
优化 anime.js 动画并不是非黑即白的非此即彼,而是根据业务场景、动画复杂度与节点规模量体裁衣的技术决策。
图 4:anime.js 性能优化策略矩阵与技术选型决策树
生产环境避坑检查清单
- 避免在 update 回调中读写 DOM:若由于业务需要必须在
update中更新进度文本,务必使用textContent赋值,切勿读取容器尺寸。 - 视口外动画自动暂停:对长页面下方的动画,使用
IntersectionObserver监听元素可见性,移出视口时调用anim.pause(),重新进入时调用anim.play(),杜绝无意义的后台空转。 - 单页应用(SPA)内存注销:在 Vue、React 或 Angular 组件卸载钩子中,必须调用
anime.remove(targets)销毁所有活跃动画,防止闭包引用导致内存泄漏。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章