
详细解析在JavaScript中利用Set集合与扩展运算符实现数组去重的最简写法、底层SameValueZero判定原理、执行步骤及引用类型边界避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组去重:使用Set实现最简写法
作者:纸飞机
时间:2026-11-03
浏览:331
文章目录
JavaScript 实用教程
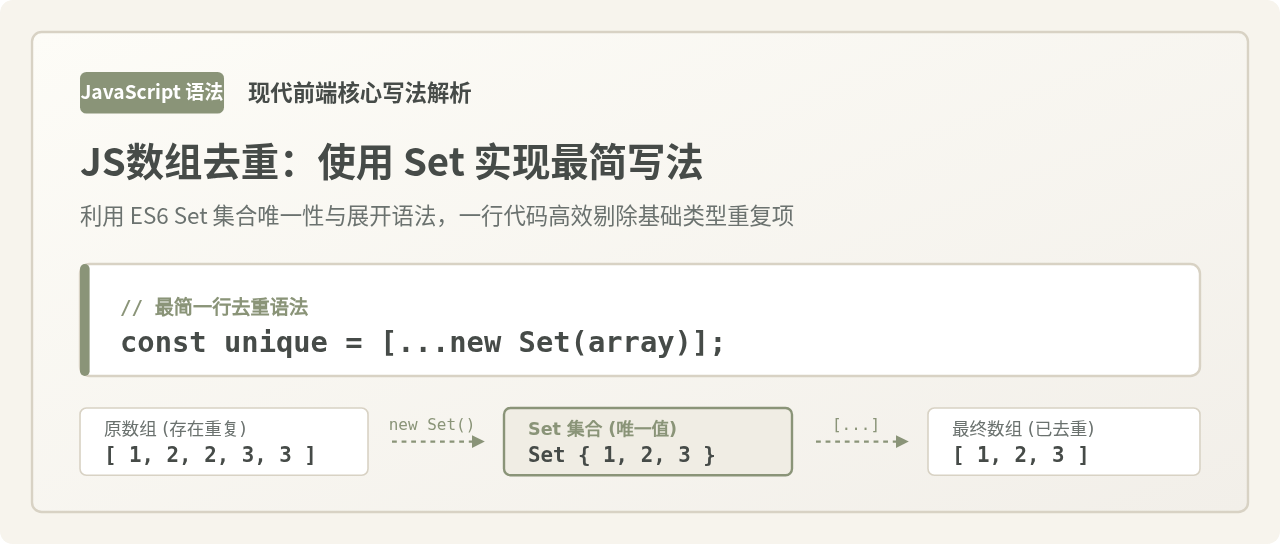
图 0:Set 数组去重核心语法与整体流转缩略图
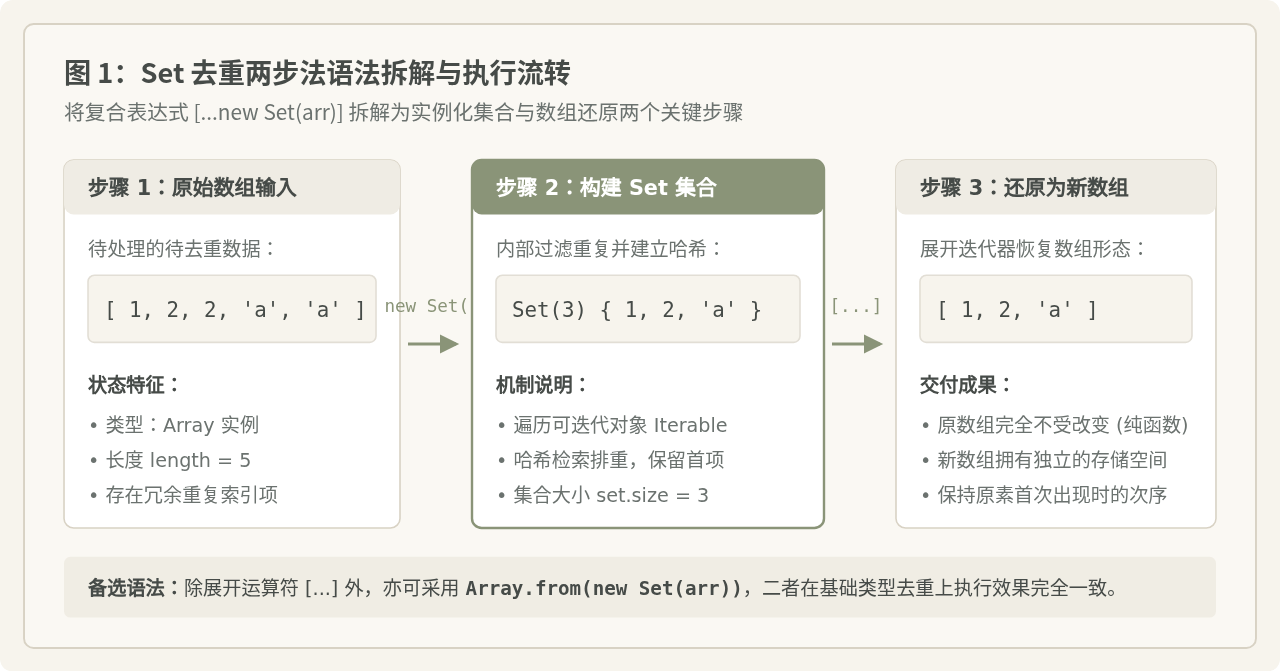
图 1:Set 去重两步法语法拆解与执行流转
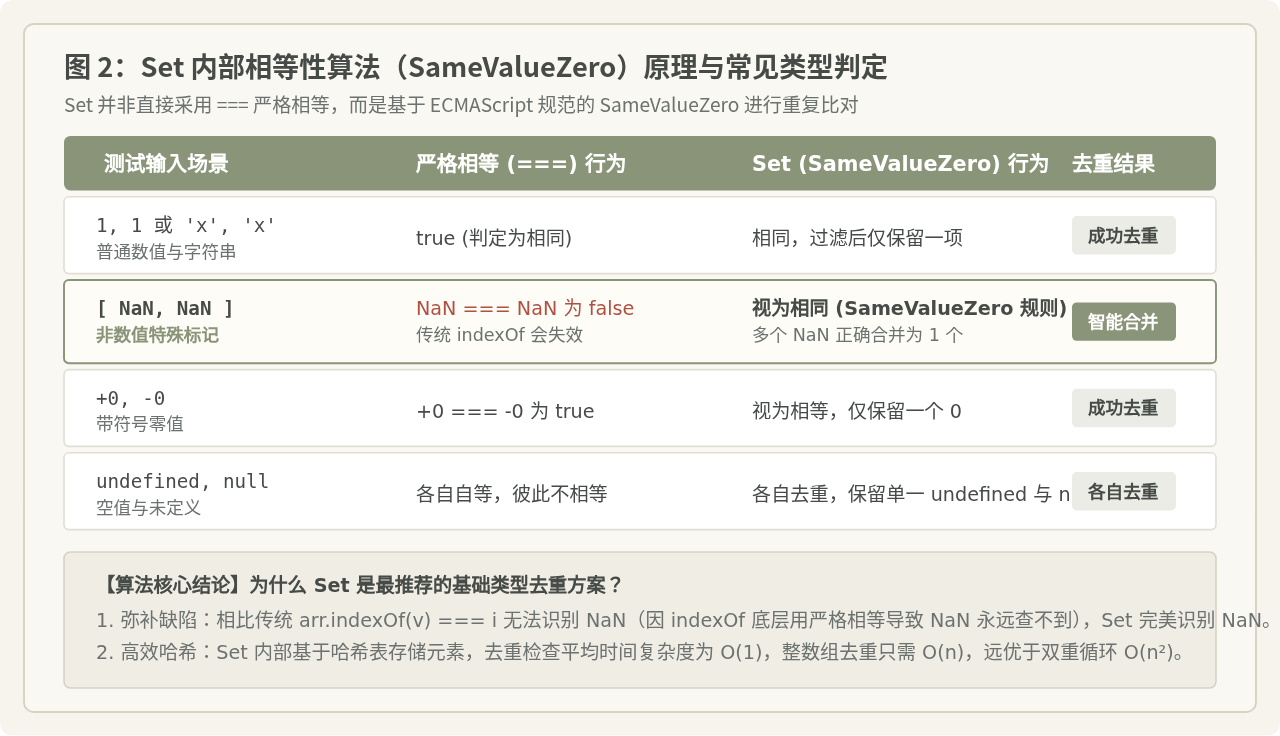
图 2:Set 内部相等性算法(SameValueZero)原理与常见类型判定
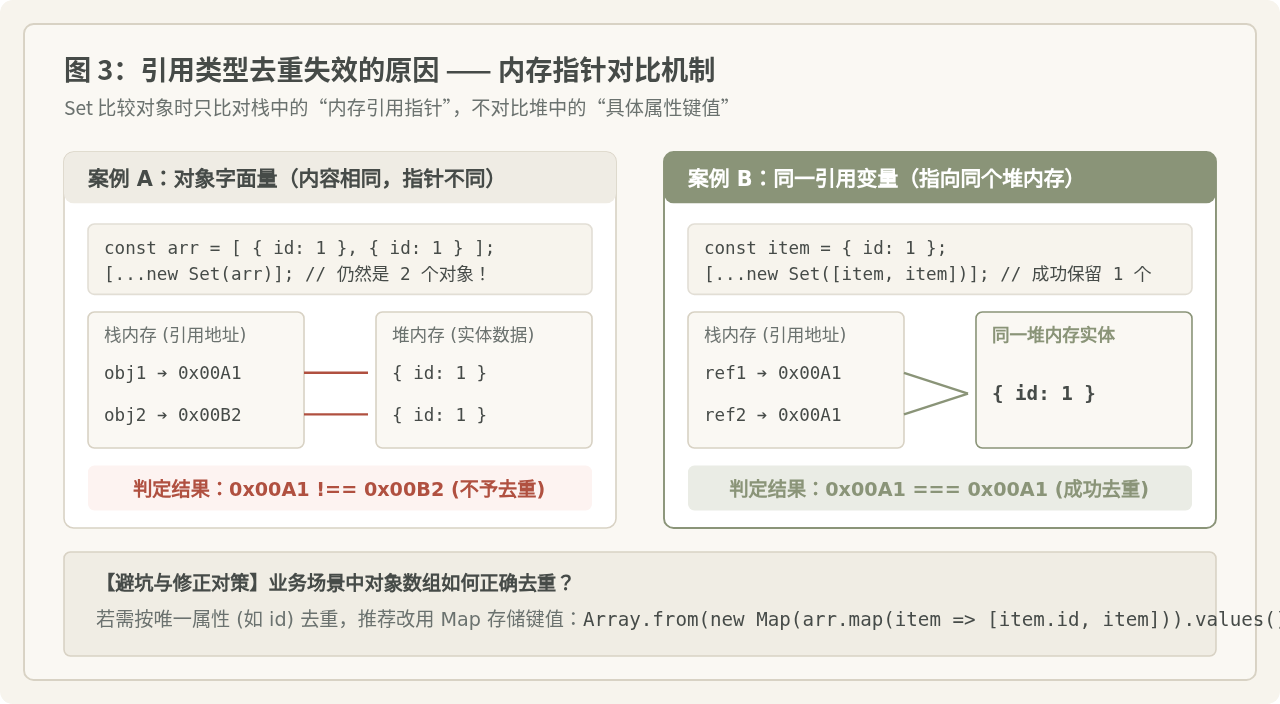
图 3:引用类型去重失效的原因 —— 内存指针对比机制
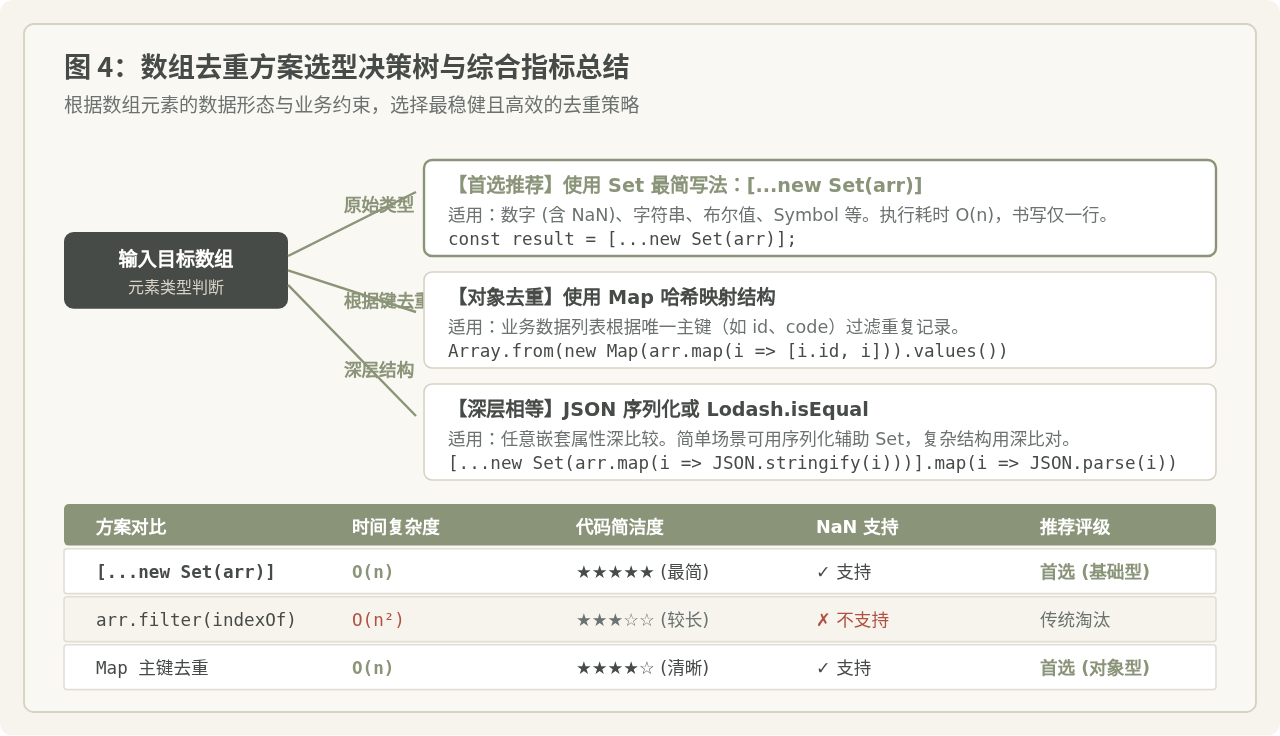
图 4:数组去重方案选型决策树与综合指标总结
在 JavaScript 中,对包含原始类型数据的数组进行去重,目前最简便且最推荐的一行写法是 const uniqueArr = [...new Set(arr)];。它通过 ES6 引入的 Set 集合天然过滤重复值,再借助扩展运算符将集合快速还原为新数组。本文将从具体写法、两步执行流程、底层比较机制到引用类型的边界限制展开完整说明。
一、最简写法与完整代码示例
在 ES6(ECMAScript 2015)发布之前,JavaScript 开发者常常使用双重循环、indexOf 过滤或对象键名映射来去除数组中的重复项。这些写法不仅代码冗长,而且容易在特殊值(如 NaN)上产生遗漏。
随着标准集合类型 Set 的引入,去重操作被精简为两项原生能力的自然衔接:
// 基础类型数组去重的最简标准写法
const rawArray = [1, 2, 2, 3, 'hello', 'hello', true, true];

// 使用 Set 去重并展开还原
const uniqueArray = [...new Set(rawArray)];

console.log(uniqueArray);
// 示例输出:[1, 2, 3, "hello", true]
除展开运算符(...)外,标准库中的 Array.from() 方法同样可以将 Set 实例直接转换为标准数组:
// 备选等效写法:通过 Array.from() 转换
const uniqueArrayAlt = Array.from(new Set(rawArray));

console.log(uniqueArrayAlt);
// 示例输出:[1, 2, 3, "hello", true]
在现代前端工程(浏览器环境及 Node.js)中,展开运算符写法更为紧凑,因此在绝大多数实际业务代码中被视作第一选择。
二、操作执行步骤与语法拆解
一行表达式 [...new Set(arr)] 的背后,实际上包含了两个阶段的操作。了解这两个阶段有助于我们理解数据形态的变化:
-
第一阶段(数组到集合):执行
new Set(arr)。Set构造函数接收一个可迭代对象(如数组),按元素出现顺序依次读取。每读取一个元素,集合内部会检查该值是否已存在;若不存在则存入,若已存在则直接丢弃。最终得到一个无重复元素的Set实例。 -
第二阶段(集合还原为数组):执行
[...setInstance]。外部的中括号[]声明了一个全新的空数组,内部的展开运算符...触发Set的迭代器协议,将集合中的元素逐一取出并放入新数组中。
值得强调的是,该操作不会对原本的 rawArray 造成任何就地修改(In-place Modification),生成的是一个全新引用的数组,完全符合函数式编程中纯函数的规范。
三、底层机制:Set 如何判断“值是否重复”?
很多初学者直觉上认为 Set 内部使用的是全等运算符 ===。这种说法在大多数基本数据上成立,但在处理某些特殊边界值时并不准确。
ECMAScript 规范明确规定:Set 内部采用的是 SameValueZero(零值相等)算法来判定两个键是否相同。这带来了两个关键的实际差异:
1. 对 NaN 的正确处理
在 JavaScript 的常规逻辑中,NaN === NaN 返回 false。如果使用传统的 arr.filter((item, index) => arr.indexOf(item) === index) 写法,由于 indexOf 无法通过全等匹配到 NaN,会导致 NaN 在过滤过程中被彻底丢弃或产生异常。
而在 SameValueZero 规则下,NaN 被视为与自身相等。因此,Set 能够准确将多个 NaN 合并为一个:
const nanList = [NaN, 1, NaN, 2];
const result = [...new Set(nanList)];

console.log(result);
// 示例输出:[NaN, 1, 2] (成功去重且保留了唯一 NaN)
2. 对 +0 与 -0 的归并
在 SameValueZero 算法中,正零 +0 与负零 -0 被视为相等。传入包含正负零的数组,去重后仅保留一个 0。
四、易混淆认知与关键边界辨析
在日常开发交流中,常有人提出“只要是数组去重,直接写 [...new Set(arr)] 就可以解决一切问题”。这种说法看似合理,但如果缺乏对数据类型的辨析,在实际业务中极易引发 bug。
1. 引用类型对象无法按内容去重
Set 对所有非原始类型(如普通对象 Object、数组 Array、函数 Function)进行相等性检查时,比对的是它们的内存引用指针,而不是对象内部的属性键值。
// 陷阱示例:字面量对象具有相同的键值,但在堆中分配了不同的内存地址
const users = [
  { id: 1, name: 'Alice' },
  { id: 1, name: 'Alice' }
];

const filtered = [...new Set(users)];
console.log(filtered.length);
// 示例输出:2 (去重失败,两个对象仍然存在)针对对象数组的修正方案
业务中若需要根据对象的某个主键(例如 id)去重,应当借助 Map 以主键为 key 进行哈希缓存,例如:
const uniqueUsers = Array.from(new Map(users.map(u => [u.id, u])).values());
2. 展开语法(...)与 Array.from 的取舍
虽然两者在去重结果上完全等价,但在语义和扩展性上存在微小区别:
- 展开语法
[...new Set(arr)]:代码最为简洁,符合现代 ECMAScript 语法直觉,执行开销极小,是纯粹去重时的最优选。 Array.from(new Set(arr), mapFn):支持传入第二个参数作为映射函数。如果去重的同时需要对元素进行同步清洗或格式转换,使用Array.from可以在一次遍历中完成,避免额外链式调用.map()。
五、性能复杂度与选型总结
在性能层面,Set 内部基于哈希表实现,对单个元素的检索与插入平均时间复杂度为 O(1)。对包含 n 个元素的数组完成整体去重,总时间复杂度为 O(n),空间复杂度为 O(n)。
相比于早期双重循环或 filter + indexOf 的 O(n²) 耗时,在面对千级、万级元素的大数组时,Set 写法不仅代码简短,运行速度通常有数十倍乃至上百倍的提升。
| 去重方案 | 代码形态 | 时间复杂度 | 适用数据类型 | 优缺点评析 |
|---|---|---|---|---|
| Set 展开语法 | [...new Set(arr)] |
O(n) | 基础类型(数字、字符串、布尔等) | 写法最简,原生支持 NaN,性能极高 |
| Map 键值映射 | new Map(arr.map(x => [x.key, x])).values() |
O(n) | 对象数组(按单一属性) | 准确按指定字段过滤,业务首选 |
| 传统 filter + indexOf | arr.filter((v, i) => arr.indexOf(v) === i) |
O(n²) | 基础类型(不含 NaN) | 语法陈旧,大数组性能差,丢失 NaN |
结论
对于所有由基础类型(数字、字符串、布尔、Symbol 等)构成的 JavaScript 数组,const unique = [...new Set(arr)]; 是兼顾语法简洁度、可读性与执行效率的最优解法。遇到对象数组时,应根据业务主键选用 Map 结构进行针对性排重。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章