
深入解析 JavaScript Array.prototype.filter() 的基础语法、回调函数三参数规范、真假值(Truthy/Falsy)判定机制、浅拷贝内存模型及典型实践应用与避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript Array.filter() 基础语法与返回值详解
作者:函数茶馆
时间:2026-11-02
浏览:316
文章目录
JavaScript 标准库核心参考
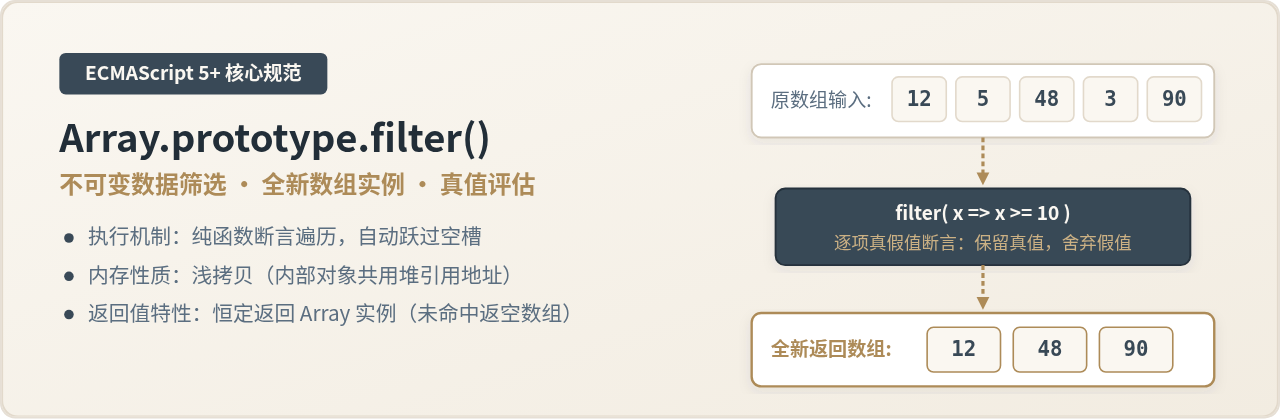
图 0:Array.prototype.filter() 数据流与执行模型全景
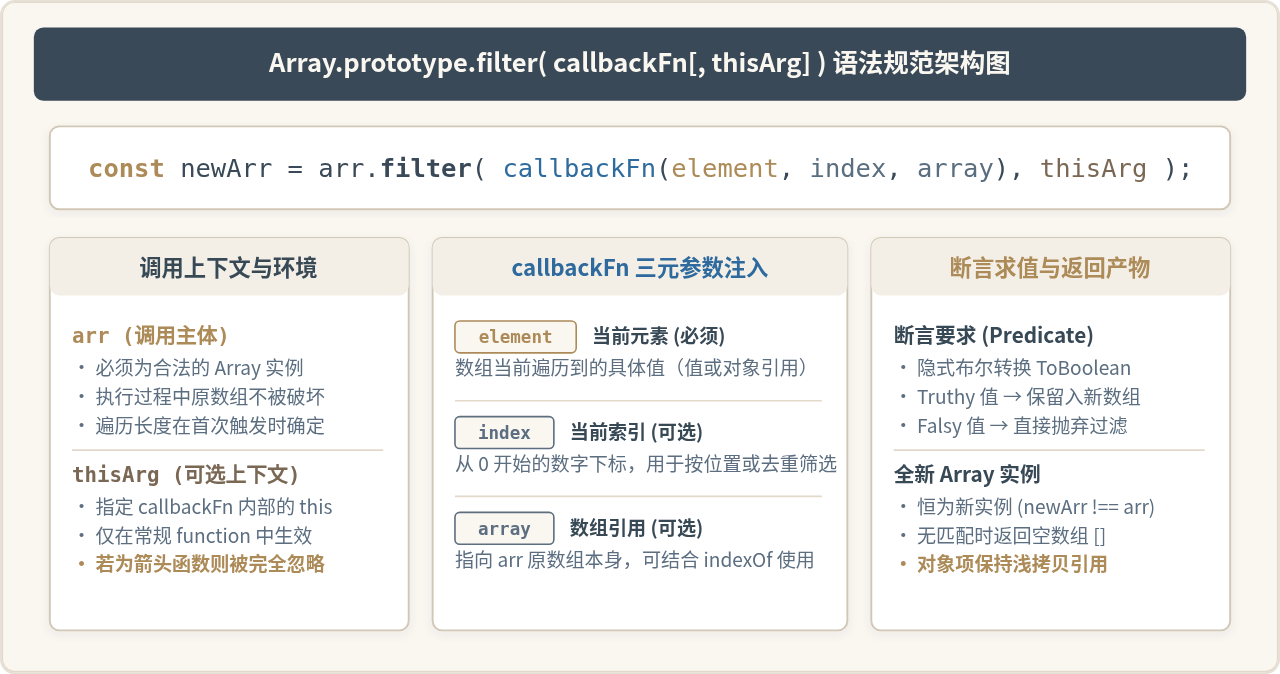
图 1:Array.prototype.filter() 语法结构与回调参数分配关系
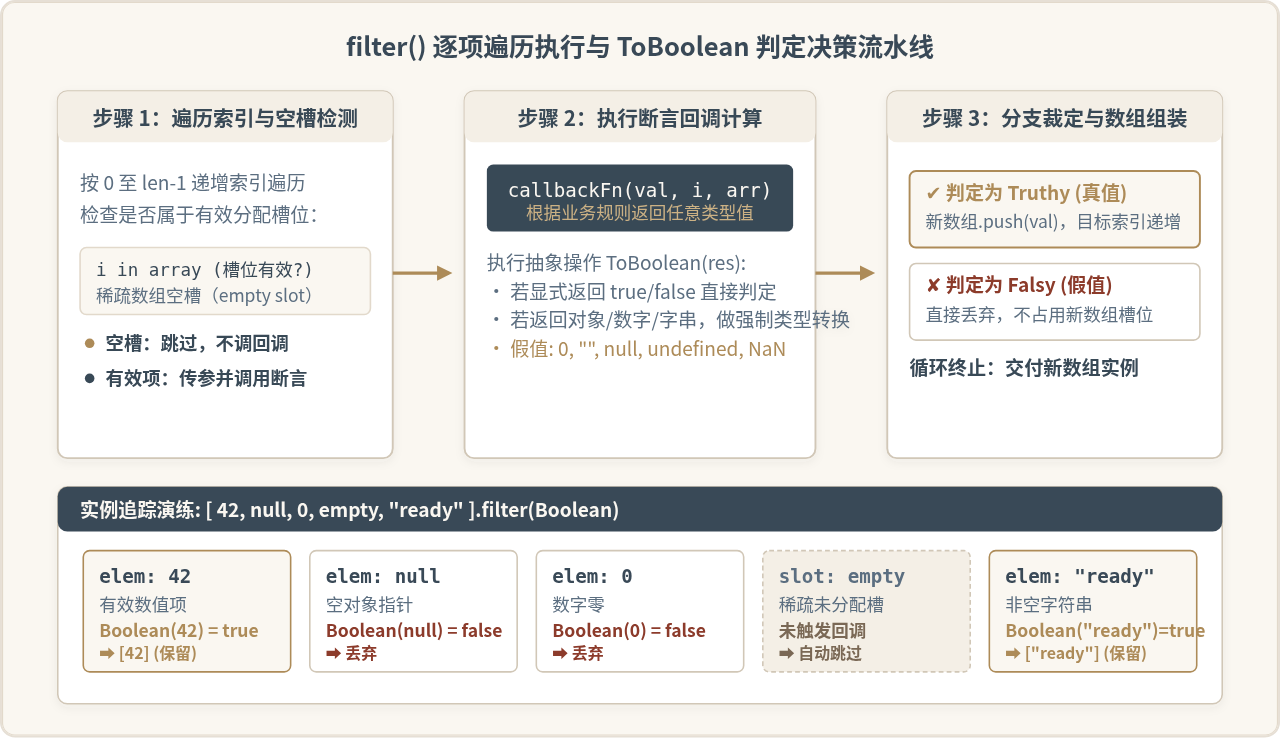
图 2:元素逐项遍历与 ToBoolean 判定决策流水线
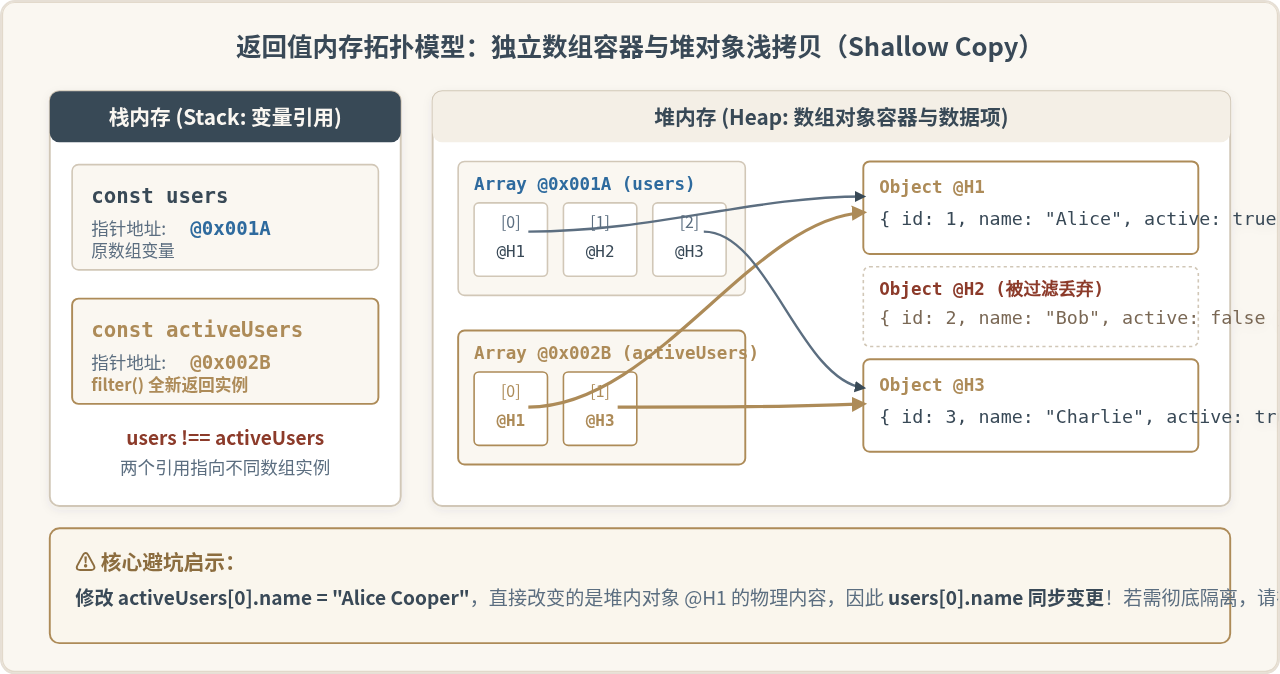
图 3:返回值内存拓扑模型——新旧数组引用与堆对象浅拷贝关系
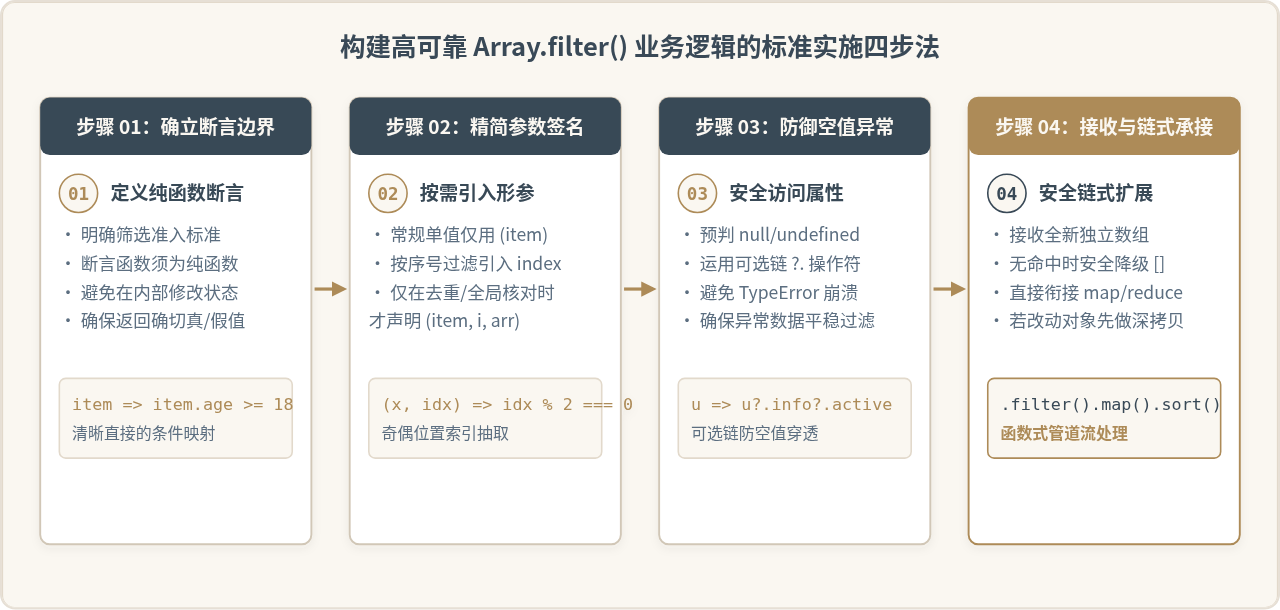
图 4:构建稳定 filter() 业务逻辑的标准实施四步法
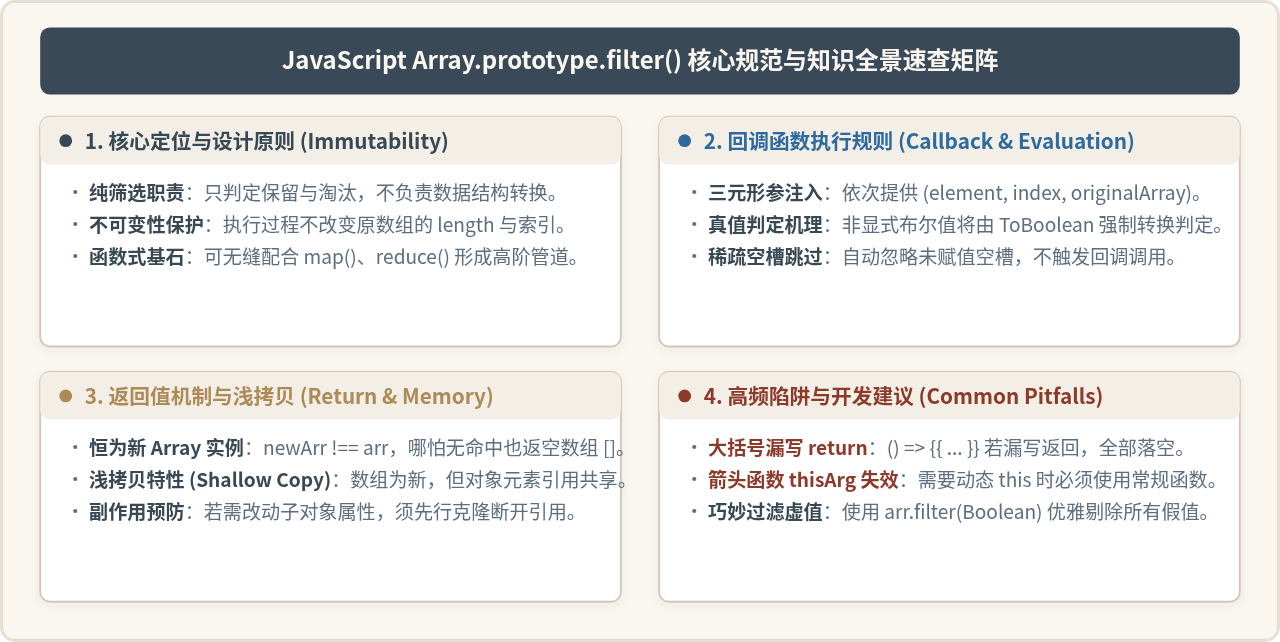
图 5:JavaScript Array.prototype.filter() 核心特性与技术规范总结
Array.prototype.filter() 是 JavaScript 中处理集合数据时最核心的高阶迭代方法之一。它的功能是测试数组中的每一个元素,并返回一个包含所有通过测试(断言函数返回真值)元素的新数组。原数组在整个执行过程中保持不变。本文将系统拆解该方法的语法参数规范、真假值判定逻辑、浅拷贝返回值机制及常见避坑技巧。
一、基础语法规范与参数解析
Array.prototype.filter() 属于 ECMAScript 5 (ES5) 规范引入的数组原型方法。它接收一个回调测试函数以及一个可选的上下文对象,语法形式如下:
let newArray = array.filter(callbackFn(element[, index[, array]])[, thisArg]);
在执行时,filter() 会按升序索引顺序依次为数组中的每个有效元素调用一次 callbackFn。如果该回调函数针对某个元素计算后返回“真值”(Truthy),该元素就会被复制并存入返回结果中;若返回“假值”(Falsy),则直接跳过该元素。
| 参数名称 | 类型 / 性质 | 职责与细节说明 |
|---|---|---|
callbackFn |
必须提供 Function | 为原数组中每个元素执行的断言测试函数。接收三个实参:当前元素、当前索引、原数组引用。返回值转换为布尔真值时保留该元素。 |
element |
形参一 Any | 当前正在处理的数组项。该项是原数组当前索引位置的值。 |
index |
形参二 Number | 当前正在处理元素的索引下标(从 0 开始自增)。常用于位置过滤或结合 indexOf 进行去重。 |
array |
形参三 Array | 调用 filter 方法的原数组实例本身。可用于在回调内部进行全局数组比对或范围核查。 |
thisArg |
可选参数 Any | 执行 callbackFn 时绑定的 this 值。注意:若回调采用 ES6 箭头函数编写,箭头函数的词法绑定机制会导致 thisArg 被完全忽略。 |
基础使用示例:标准函数与箭头函数写法
在现代 JavaScript 开发中,filter() 常与 ES6 箭头函数配合使用,使过滤逻辑极为简明:
// 原始数据:一组数字分数
const scores = [65, 42, 88, 59, 93, 74];

// 示例 1:常规函数写法,过滤出及格(>= 60)的分数
const passingScores = scores.filter(function(score) {
    return score >= 60;
});
// passingScores 示例输出: [65, 88, 93, 74]

// 示例 2:使用 ES6 箭头函数单行隐式返回
const highScores = scores.filter(score => score >= 80);
// highScores 示例输出: [88, 93]
二、执行流程与真假值(Truthy / Falsy)判定逻辑
理解 filter() 的核心在于掌握它的判定规则。许多初学者误以为 callbackFn 必须严格返回布尔值 true 或 false。实际上,JavaScript 内部会对回调函数的返回值执行抽象布尔转换 ToBoolean(returnValue)。
换言之,只要回调函数返回的内容在 JavaScript 中属于“真值”(Truthy),该元素就被判定为有效并保留;只要返回“假值”(Falsy),元素即被丢弃。
JavaScript 中的假值(Falsy)清单
在 JavaScript 中,只有以下 8 个值在布尔上下文中会被评估为 false:
false、0、-0、0n(BigInt 零)、""(空字符串)、null、undefined 和 NaN。除此以外的所有值(包括空对象 {{}}、空数组 []、非零负数)皆为真值。
稀疏数组(Sparse Arrays)中的空槽处理
filter() 具有自动跳过“未分配索引”(空槽 empty slots)的机制。在稀疏数组中,未赋值的索引槽位不会触发 callbackFn 的执行,且结果数组中不会保留空槽。
// 构造一个长度为 5 但带有空槽的稀疏数组
const sparseList = [10, , 30, , 50];

// 对稀疏数组调用 filter
const denseList = sparseList.filter(item => item > 0);

// 回调函数仅对索引 0、2、4 执行了 3 次
// denseList 示例输出: [10, 30, 50](空槽被完全压平剔除)
实用技法:使用 Boolean 构造函数快速清洗无效数据
由于 filter() 依赖真值机制,将全局内置对象 Boolean 直接作为回调函数传递,可以一行代码过滤掉数组中的所有虚值(包括 null、undefined、空字符串和 0):
const rawInputs = ["Apple", "", null, "Banana", undefined, 0, NaN, "Orange"];

// 将 Boolean 构造函数作为断言函数
const validInputs = rawInputs.filter(Boolean);

// validInputs 示例输出: ["Apple", "Banana", "Orange"]
三、返回值深度机制与浅拷贝内存模型
关于 filter() 的返回值,有两项关键特征直接决定了程序的稳定性和内存安全性:
- 返回值恒为全新的 Array 实例:即使原数组中没有一个元素满足条件,
filter()也会返回一个空数组[],而绝非null或undefined。这意味着开发者无需进行空指针判空,即可安全地链式调用后续数组操作。 - 引用类型元素的浅拷贝(Shallow Copy):新数组是一个独立容器,但若原数组中存放的是对象或数组,新数组仅复制该对象的内存引用地址。新旧两个数组在物理堆内存中引用的是同一批对象!
浅拷贝副作用警示
如果通过新数组修改了其内部对象的某个属性,原数组对应对象的属性将同步发生变化。若业务场景要求不可变性(Immutability),应在过滤后或过滤前执行深克隆,或通过结构重构产生新对象。
// 演示浅拷贝的内存联动表现
const users = [
    { id: 1, name: "Alice", active: true },
    { id: 2, name: "Bob", active: false },
    { id: 3, name: "Charlie", active: true }
];

// 过滤活跃用户
const activeUsers = users.filter(user => user.active);

// 验证数组实例独立性
console.log(activeUsers === users); // 示例输出: false (栈内存地址不同)

// 修改新数组中首个对象的属性
activeUsers[0].name = "Alice Cooper";

// 原数组对应元素同时受到改变!
console.log(users[0].name); // 示例输出: "Alice Cooper"
四、典型场景实操与四步实施指南
在实际业务开发中,合理运用 filter() 的多参数能力,可以优雅完成多样化的数据整理任务。建议按照标准四步法展开实现:
场景 1:复杂业务对象的多条件组合筛选
在电商、权限或报表系统中,经常需要同时验证价格区间、库存状态和分类标签:
const inventory = [
    { sku: "A101", category: "Book", price: 45, stock: 12 },
    { sku: "B202", category: "Electronics", price: 499, stock: 0 },
    { sku: "C303", category: "Book", price: 120, stock: 5 },
    { sku: "D404", category: "Stationery", price: 15, stock: 80 }
];

// 筛选条件:属于 Book 品类且当前有现货(stock > 0)
const availableBooks = inventory.filter(item => {
    const isBook = item.category === "Book";
    const inStock = item.stock > 0;
    return isBook && inStock;
});
// availableBooks 示例输出: 包含 A101 和 C303 的新数组
场景 2:巧用 index 与 array 实现数组原地去重
借助 filter() 暴露的第 2 和第 3 个参数,结合 indexOf() 只返回首次出现下标的特性,可以高效剔除基础类型数组中的重复项:
const tags = ["vue", "react", "angular", "react", "svelte", "vue"];

// 当且仅当当前项的索引等于该值在数组中第一次出现的索引时保留
const uniqueTags = tags.filter((item, index, self) => {
    return self.indexOf(item) === index;
});

// uniqueTags 示例输出: ["vue", "react", "angular", "svelte"]
五、常见错误陷阱与核心要点总结
开发者在日常使用 filter() 时,常见以下几个典型编码陷阱:
- 陷阱一:箭头函数块级大括号遗漏 return。当使用
() => {{ ... }}语法包裹函数体时,若未显式编写return语句,函数默认返回undefined(假值),导致过滤后的结果恒为空数组[]。 - 陷阱二:混淆 filter 与 map 的职责。
filter()的职责是“选出谁”,不能“改造谁”。如果期望修改元素的内容或格式,应在filter()之后链式调用map(),而非在filter回调内进行属性篡改。 - 陷阱三:试图在回调中通过变动原数组影响遍历。
filter()处理的元素范围在第一次调用callbackFn之前就已经确立。在遍历开始后追加到原数组的新元素不会被filter()访问。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章