

深入讲解在JavaScript中如何使用Web Crypto API的crypto.getRandomValues方法生成密码学安全的随机字符串,包含Hex、Base64URL与自定义字符集实现,并剖析拒绝采样避免模偏差的底层原理。
JS怎么用crypto.getRandomValues生成安全随机字符串
作者:极速慢跑
时间:2026-11-02
浏览:628
文章目录
在 JavaScript 中生成用于安全敏感场景(如认证 Token、重置密码凭据、CSRF 防护令牌、OAuth State 等)的随机字符串时,不能使用常规的
Math.random()。标准的解决方案是调用 Web Crypto API 提供的 crypto.getRandomValues() 方法,直接从操作系统底层的密码学安全伪随机数生成器(CSPRNG)获取高质量熵,填充到类型化数组(TypedArray)中,再将这些随机字节编码为目标字符串。本文将演示 crypto.getRandomValues() 的核心机制、三种常见随机串生成方式(十六进制、Base64URL、自定义字符集),并深入解释如何通过拒绝采样消除“模偏差”,确保生成的字符串具备真正的密码学安全性。
一、为什么不能用 Math.random():伪随机与 CSPRNG 的本质差异
很多初学者在编写生成随机字符串的代码时,习惯随手写下 Math.random().toString(36).substring(2)。这种做法在展示动画、测试数据填充或简单的前端组件唯一 Key 等非敏感场景下尚可应付,但若用于生成 Token、Session ID、短信验证码或重置密码链接,会带来致命的安全漏洞。
Math.random() 的核心缺陷在于其算法实现属于普通的伪随机数生成器(PRNG)。现代浏览器(如 Chrome 的 V8 引擎)通常采用 xoroshiro128+ 算法。该算法虽然执行速度极快且在统计学上分布均匀,但它在设计上完全不具备“抗预测性”。xoroshiro128+ 的内部状态仅由 128 位状态组成,且算法完全可逆。攻击者只要截获连续生成的 5 到 8 次浮点数输出,就能在数毫秒内通过逆向计算还原当前 JavaScript 虚拟机的内部种子状态,进而完全推算出系统随后产生的所有所谓“随机”凭证。
相比之下,crypto.getRandomValues() 属于密码学安全伪随机数生成器(CSPRNG)。它不依赖应用层的简单数学递推,而是由运行时直接接入操作系统的内核熵池(在 Linux/macOS 下为 /dev/urandom,在 Windows 下为 BCryptGenRandom)。这些熵源由计算机硬件时钟的微秒级抖动、键盘敲击、鼠标轨迹、硬件中断及网络数据包等物理噪声持续滋养。此外,底层 CSPRNG 算法具备严格的“向前保密”与“向后保密”特性——即使攻击者在某一瞬间获知了当前内存状态,也无法推算出此前或未来的任何输出。
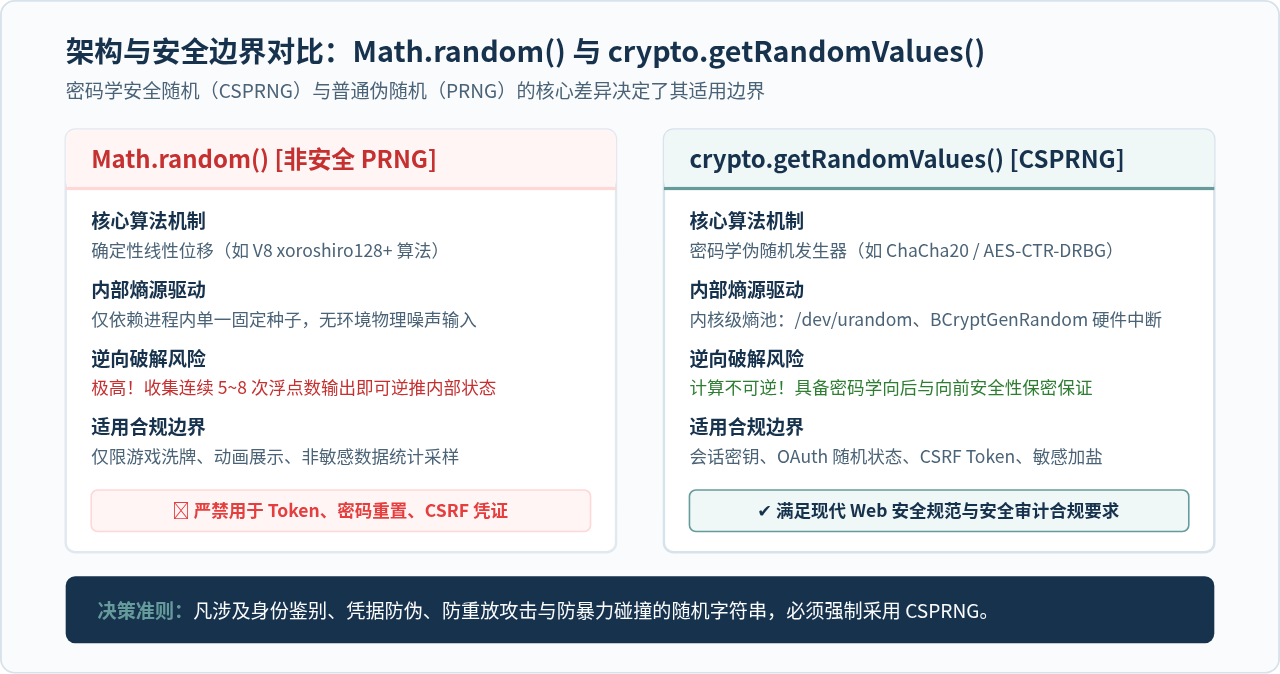
图 1:Math.random() 与 crypto.getRandomValues() 的系统架构与安全模型边界比对
在环境兼容性方面,Web Crypto API 是当今主流前端与后端运行时的通用标准:
- 现代浏览器:原生挂载在全局对象上,通过
window.crypto.getRandomValues直接调用。 - Node.js 运行时:Node.js 从 v15.0.0 开始引入 Web Crypto 标准,并在 v19.0.0+ 将
crypto作为全局对象直接暴露。在所有现代 Node.js、Deno 和 Cloudflare Workers 中,均可直接通过全局统一的crypto.getRandomValues或globalThis.crypto.getRandomValues进行跨平台调用。
二、核心用法:生成十六进制(Hex)安全随机字符串
生成安全随机字符串的基本工作流包含四个阶段:创建类型化数组缓冲区、调用底层 CSPRNG 就地填充真随机字节、将字节编码映射为目标字符、校验并输出不可变字符串。
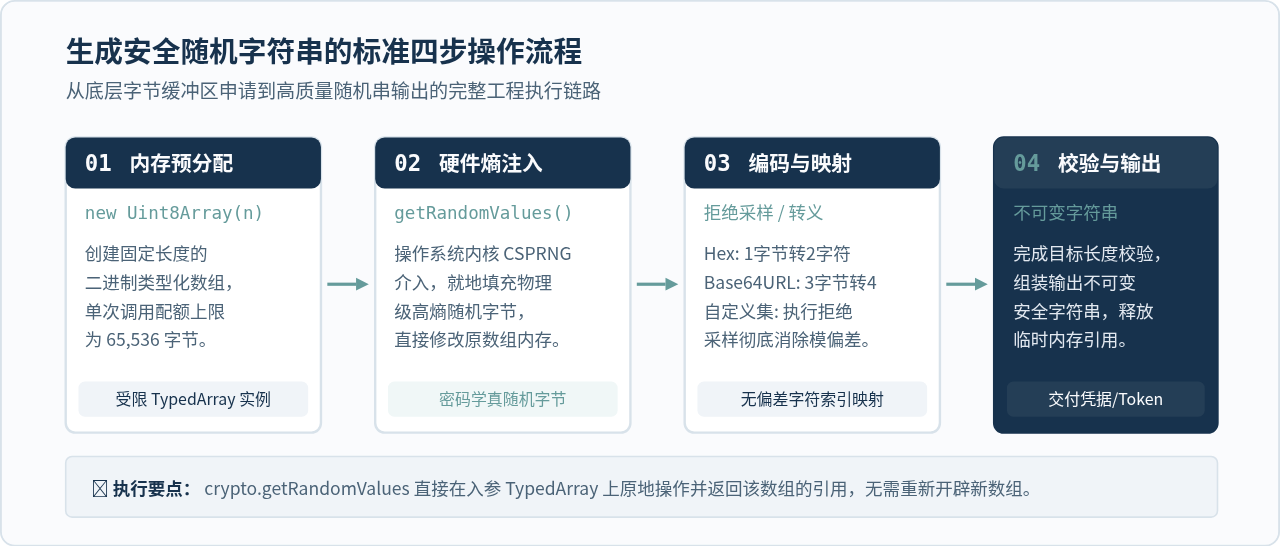
图 2:基于 crypto.getRandomValues 生成安全随机字符串的标准四步操作流程
十六进制(Hex)是技术实现中最推荐、最不容易引入人为漏洞的随机串格式。十六进制中每个字符对应半个字节(4 位),2 个十六进制字符严格代表 1 个字节(8 位,0x00 至 0xFF)。这意味着 16 字节的熵恰好转换为 32 字符的 Hex 字符串,完全不涉及任何模运算,天然具备绝对均匀的概率分布。
crypto.getRandomValues() 接受一个整数类型化数组(如 Uint8Array),并在该数组的原地(In-Place)修改内存,将系统熵写入其中,同时返回该数组的引用。下面是生成十六进制随机字符串的完整跨平台实现代码:
/**
 * 生成密码学安全的十六进制随机字符串
 * @param {number} byteLength 随机熵的字节数(默认 16 字节,即 128 位熵,输出 32 位 Hex 字符串)
 * @returns {string} 对应的十六进制随机字符串
 */
function generateSecureHex(byteLength = 16) {
  if (!Number.isInteger(byteLength) || byteLength <= 0) {
    throw new TypeError('byteLength 必须为大于 0 的整数');
  }

  // 1. 分配指定字节长度的 Uint8Array 缓冲区
  const buffer = new Uint8Array(byteLength);

  // 2. 使用底层 CSPRNG 原地填充随机字节
  (globalThis.crypto || window.crypto).getRandomValues(buffer);

  // 3. 将每个字节转换为 2 位十六进制字符并拼接
  return Array.from(buffer, byte => byte.toString(16).padStart(2, '0')).join('');
}

// 示例调用:
console.log('16 字节 Hex Token (32 字符):', generateSecureHex(16));
console.log('32 字节 Hex 密钥 (64 字符):', generateSecureHex(32));
控制台示例输出(实际每次输出均为高熵独立随机串):
16 字节 Hex Token (32 字符): a3f88d1844b201f92e9d57a90b84f3c032 字节 Hex 密钥 (64 字符): 7e502c38d49a04a589cfbc615d8f6d7293b6e82a611732a3922cfbda2780e5b1
在上述代码中,padStart(2, '0') 是不可或缺的关键细节。若某个字节的值小于 16(例如 0x05),其 toString(16) 只会返回单一字符 "5"。如果不进行补零对齐,输出的字符串长度就会发生动态缩水,不仅会破坏固定长度的格式协议,还会丢失原本的字节边界。
三、进阶场景:指定字符集与消除“模偏差”(Modulo Bias)
在实际业务中,我们经常遇到对字符格式有特殊限制的场景。例如生成只包含大小写字母与数字(共 62 个字符)的验证码、或者排除易混淆字符(如 0/O、1/l/I)的人工阅读口令。在这些场景中,很多开发者习惯写出如下的转换逻辑:
// ❌ 存在模偏差(Modulo Bias)安全隐患的错误写法:
function badRandomString(length, charset) {
  const bytes = new Uint8Array(length);
  crypto.getRandomValues(bytes);
  return Array.from(bytes, b => charset[b % charset.length]).join('');
}
1. 什么是模偏差?为什么它会削弱密码安全性?
Uint8Array 中每个字节的取值范围为 0 到 255,共有 256 个完全等概率的离散状态。假设我们的字符集长度为 62(a-zA-Z0-9),我们在数学上执行整数除法:256 ÷ 62 = 4 余 8(即 256 = 4 × 62 + 8)。
这 8 个余数会导致严重的分布失衡:
- 字符索引 0 至 7(前 8 个字符):每个字符分别对应 5 个可能的字节输入(例如索引 0 对应字节值 0, 62, 124, 186, 248)。其出现的绝对概率为
5 / 256 ≈ 1.9531%。 - 字符索引 8 至 61(剩余 54 个字符):每个字符仅对应 4 个可能的字节输入(例如索引 8 对应字节值 8, 70, 132, 194)。其出现的绝对概率为
4 / 256 ≈ 1.5625%。
计算两者概率比值:(5/256) / (4/256) = 1.25。也就是说,前 8 个字符的出现几率整整比其它字符高出 25%!在密码分析学中,这种非均匀的概率倾斜被称为“模偏差(Modulo Bias)”。攻击者通过对海量生成的 Token 进行统计采样,可以准确识别出字符频率的偏斜特征,从而大幅压缩暴力猜解与字典攻击所需的搜索熵空间。
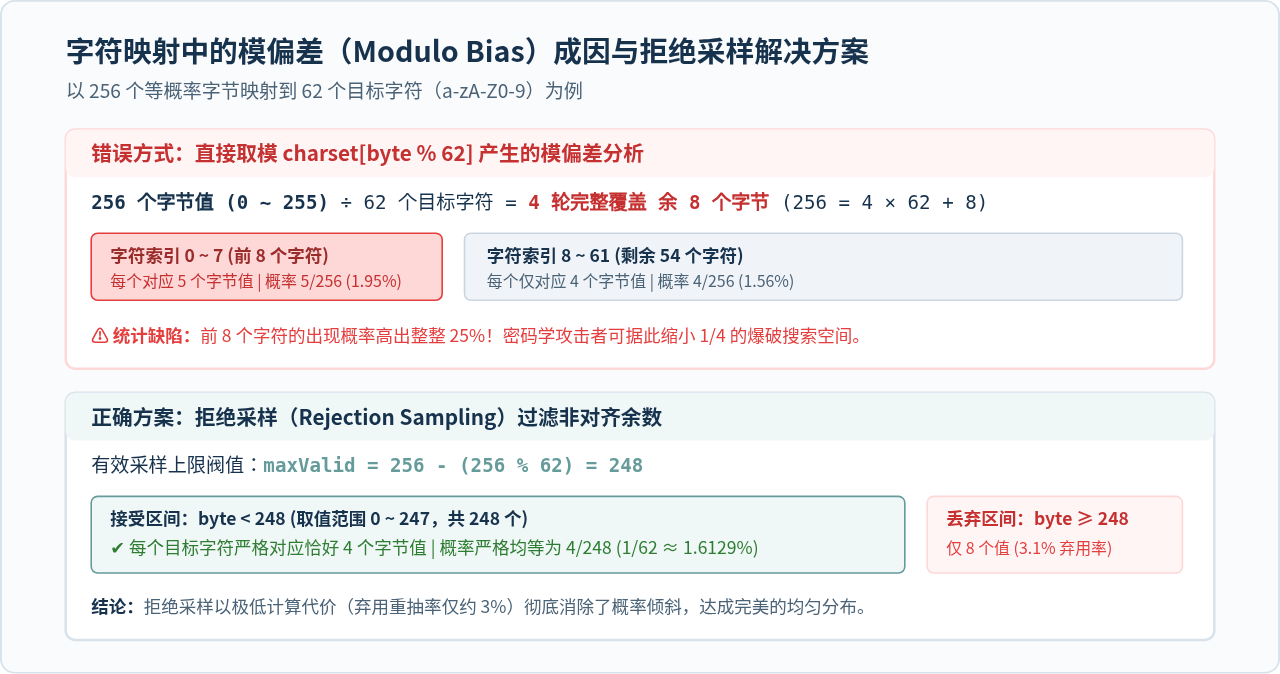
图 3:模偏差(Modulo Bias)产生的数学机理与拒绝采样过滤逻辑
2. 拒绝采样(Rejection Sampling)的实现与优化
要彻底根除模偏差,最标准、数学上完全严谨的做法是拒绝采样(Rejection Sampling)。其原理十分直接:找出小于 256 且能够被字符集长度整除的最大上限 maxValid = 256 - (256 % charset.length)。对于 62 个字符的情况,maxValid = 256 - 8 = 248。
在采样过程中:
- 如果随机抽到的字节小于 248(取值 0 至 247),则保留该字节并执行取模。在此区间内,每个字符都严格平分 4 个字节,概率严格相等(
4 / 248 = 1 / 62)。 - 如果抽到的字节落在 248 至 255 之间,则直接丢弃该字节,重新抽取下一个字节。
由于被丢弃的字节仅占总空间的 8 / 256 = 3.125%,每次重抽的开销极低。为了避免每次重抽都单独调用一次 crypto.getRandomValues 带来的系统调用上下文切换损耗,工程上我们采用“分块预拉取(Buffered Chunking)”策略,一次性申请一批字节并按需消费。以下是生产级、无模偏差的安全字符串生成函数:
/**
 * 基于拒绝采样生成无模偏差的自定义字符集安全随机字符串
 * @param {number} length 生成字符串的目标长度
 * @param {string} charset 候选字符集(长度不得超过 256)
 * @returns {string} 严格密码学安全且分布均匀的随机字符串
 */
function generateSecureString(
  length,
  charset = 'ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789'
) {
  if (!Number.isInteger(length) || length <= 0) {
    throw new TypeError('length 必须为大于 0 的整数');
  }
  if (typeof charset !== 'string' || charset.length === 0) {
    throw new TypeError('charset 必须为非空字符串');
  }
  const charsetLength = charset.length;
  if (charsetLength > 256) {
    throw new RangeError('单个字节采样模式下,charset 长度不能超过 256');
  }

  // 计算最大对齐有效上限:消除不平衡的尾数区间
  const maxValidByte = 256 - (256 % charsetLength);

  const resultChars = [];
  // 考虑约 3%~10% 的丢弃冗余,每次按需批量预拉取,避免逐次系统调用
  const chunkSize = Math.max(length, 32);
  const buffer = new Uint8Array(chunkSize);

  let cursor = chunkSize; // 初始标记为已耗尽,触发初次填充

  while (resultChars.length < length) {
    if (cursor >= chunkSize) {
      (globalThis.crypto || window.crypto).getRandomValues(buffer);
      cursor = 0;
    }

    const randomByte = buffer[cursor++];
    // 拒绝采样核心过滤判定:
    if (randomByte < maxValidByte) {
      resultChars.push(charset[randomByte % charsetLength]);
    }
    // 若 randomByte >= maxValidByte 则直接丢弃,进入下一轮循环补抽
  }

  return resultChars.join('');
}

// 示例调用:
console.log('默认 62 字符集 Token (24 字符):', generateSecureString(24));

// 易读字符集(排除易混淆的 0, O, 1, I, l)
const readableCharset = '23456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnpqrstuvwxyz';
console.log('易读安全口令 (16 字符):', generateSecureString(16, readableCharset));
控制台示例输出:
默认 62 字符集 Token (24 字符): p9X2zW8kLmN4qR1vT7bY3cE6易读安全口令 (16 字符): 7kM3eP9sB4uX8yRw
四、高效紧凑:生成 URL 安全的随机字符串(Base64URL)
当随机字符串用于 OAuth 流程中的 state、防跨站请求伪造的 CSRF Token 或 URL 路径参数时,十六进制由于每个字符仅携带 4 位熵,往往导致字符串较长;而自定义字符集若包含特殊符号则需要进行 URL 编码。此时,Base64URL(RFC 4648 §5)是行业公认的最佳实践。
Base64URL 使用 64 个安全字符(A-Z、a-z、0-9、- 和 _),每个字符严格表达 6 位二进制熵(6 bits/char)。相较于十六进制,它能用缩短 25% 的字符长度承载同等强度的熵值,并且绝不包含在 URL 或 HTTP Header 中具有特殊语法的符号(如 +、/ 和 =)。
以下是生成 Base64URL 安全随机串的通用函数:
/**
 * 生成符合 RFC 4648 规范的 Base64URL 安全随机字符串
 * @param {number} byteLength 随机熵的原始字节数(建议至少 16 字节 / 128 位熵)
 * @returns {string} URL 安全的高熵随机字符串
 */
function generateSecureBase64Url(byteLength = 32) {
  if (!Number.isInteger(byteLength) || byteLength <= 0) {
    throw new TypeError('byteLength 必须为大于 0 的整数');
  }

  const buffer = new Uint8Array(byteLength);
  (globalThis.crypto || window.crypto).getRandomValues(buffer);

  // 区分浏览器与 Node.js 运行时的二进制编码支持
  let base64String = '';
  if (typeof Buffer !== 'undefined') {
    // Node.js 环境:直接借助 Buffer 的 base64url 格式
    base64String = Buffer.from(buffer).toString('base64');
  } else {
    // 浏览器环境:将二进制字节转为二进制字符串后调用 btoa
    let binary = '';
    const len = buffer.byteLength;
    for (let i = 0; i < len; i++) {
      binary += String.fromCharCode(buffer[i]);
    }
    base64String = btoa(binary);
  }

  // 转换为符合 RFC 4648 的 Base64URL:替换 '+' 为 '-',替换 '/' 为 '_',并剔除末尾填充符 '='
  return base64String
    .replace(/\+/g, '-')
    .replace(/\//g, '_')
    .replace(/=+$/, '');
}

// 示例调用:
console.log('32 字节 Base64URL Token (43 字符):', generateSecureBase64Url(32));
控制台示例输出:
32 字节 Base64URL Token (43 字符): Y2JkNGU0M2Y5NmFiODcwZDJjYmQ4NDQyZmE3MTI5ZGY
五、核心限制与工程避坑指南
在将 crypto.getRandomValues 引入工业级生产系统时,必须严格遵守以下关键边界约束与最佳实践:
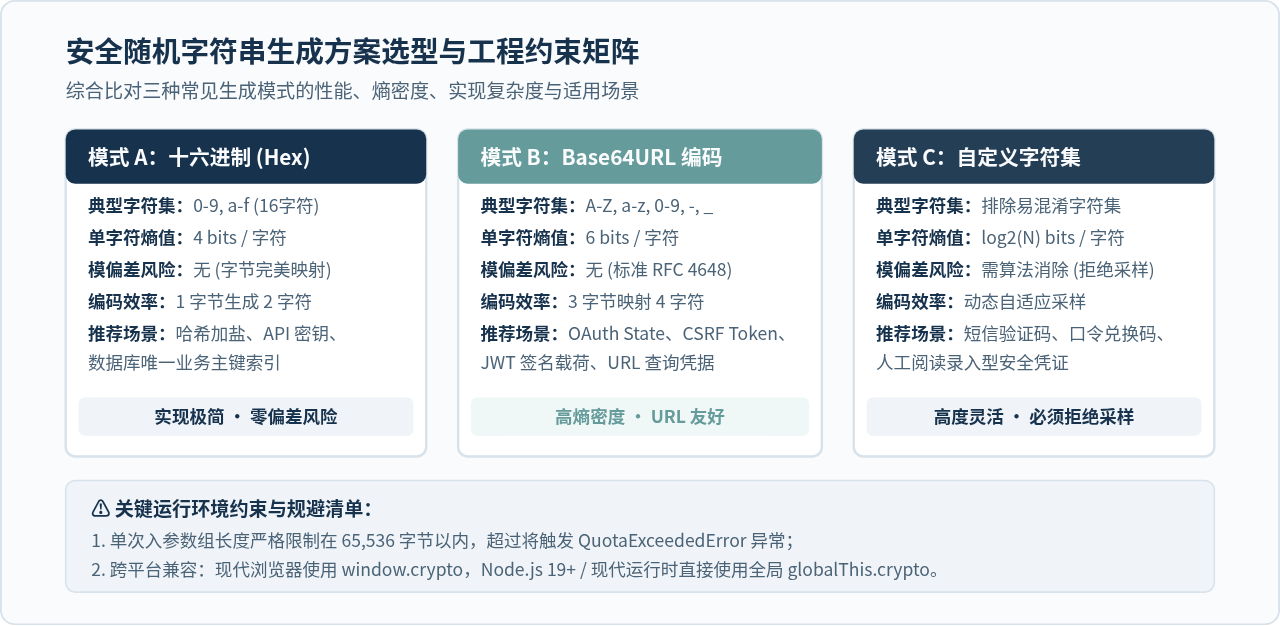
图 4:三种随机串生成模式的技术选型与关键约束决策矩阵
1. 65,536 字节单次输入配额(QuotaExceededError)
根据 W3C Web Cryptography API 规范,crypto.getRandomValues() 单次传入的类型化数组其字节长度绝不能超过 65,536 字节(即 64 KiB)。若传入长度超过该阈值的数组,引擎将立即同步抛出 QuotaExceededError DOMException 异常:
// ❌ 错误示范:超出单次配额限制将触发崩溃
try {
  const hugeBuffer = new Uint8Array(65537);
  crypto.getRandomValues(hugeBuffer);
} catch (err) {
  console.error(err.name); // 输出: QuotaExceededError
}
如果业务确实需要一次性生成超过 64 KiB 的随机数据块,必须使用循环分块(Chunking)方式,每次处理不超过 65,536 字节:
function fillLargeSecureRandom(targetArray) {
  const MAX_BYTES = 65536;
  const totalLength = targetArray.byteLength;
  for (let offset = 0; offset < totalLength; offset += MAX_BYTES) {
    const currentChunkSize = Math.min(MAX_BYTES, totalLength - offset);
    // 创建底层 ArrayBuffer 的切片视图,就地填充
    const view = new Uint8Array(targetArray.buffer, targetArray.byteOffset + offset, currentChunkSize);
    (globalThis.crypto || window.crypto).getRandomValues(view);
  }
  return targetArray;
}
2. 类型化数组类型选择
crypto.getRandomValues() 支持所有整数型类型化数组,包括 Int8Array、Uint8Array、Uint8ClampedArray、Int16Array、Uint16Array、Int32Array、Uint32Array 以及 BigInt 类型的 BigInt64Array、BigUint64Array。但请注意:它不支持 Float32Array 和 Float64Array。如果传入浮点型数组,规范要求抛出 TypeMismatchError 异常。
3. 熵与安全强度的合理估算
生成随机字符串的目的本质上是构建抗暴力枚举的搜索空间:
| 应用场景 | 推荐原始熵量 | 推荐编码模式 | 输出长度 | 抗碰撞安全性说明 |
|---|---|---|---|---|
| 常规会话 Session ID / CSRF Token | 128 bits (16 字节) | Hex 或 Base64URL | 32 位 Hex / 22 位 Base64URL | 基于生日悖论,需生成 264 个凭证才存在 50% 碰撞几率,对常规 Web 应用绝对安全 |
| 长期 API 密钥 / OAuth Refresh Token | 256 bits (32 字节) | Base64URL | 43 位 Base64URL | 达到当代顶级对称加密(如 AES-256)同一级别的抗暴力穷举强度 |
| 高频交易 Nonce / 短时重放防御 | 96~128 bits | Hex | 24~32 位 Hex | 配合服务端时效缓存(TTL),满足超高并发下的无碰撞要求 |
| 人工短信 / 邮件动态验证码 | 约 30~40 bits | 自定义纯数字或大写字母 | 6~8 字符 (拒绝采样) | 必须配合服务端的严格尝试频次限制(如最多试错 5 次后作废) |
4. 内存开销与垃圾回收(GC)优化
在每秒处理上万次请求的高性能服务端(如 Node.js 网关层),频繁通过 new Uint8Array(n) 申请微型短命数组会引发 V8 垃圾回收器(Scavenger GC)的剧烈抖动。在高频生成固定长度 Token 的生产服务中,建议在模块层复用一个共享的定长缓冲区(单线程环境)或采用对象池(Object Pool)技术,从根本上杜绝不必要的内存碎片分配。
安全开发总结
在 JavaScript 中生成安全随机字符串的铁律是:永远不要在安全敏感路径使用 Math.random()。对于机器交换凭据,优先使用 crypto.getRandomValues 配合十六进制或 Base64URL 编码;对于面向用户的自定义字符集,必须搭配拒绝采样算法消除模偏差。借助现代 Web Crypto 标准,开发者能够以清晰、规范且高性能的方式,为系统构筑牢固的密码学基石。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章