
深入解析JavaScript中Array.prototype.sort()排序结果经常不符合直觉的核心原因,涵盖默认UTF-16字典序机制、数值比较函数写法、原数组突变副作用以及多语言排序解决方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
为什么JavaScript数组sort排序结果不符合预期?
作者:拾光
时间:2026-11-02
浏览:410
文章目录
在 JavaScript 开发中,直接调用
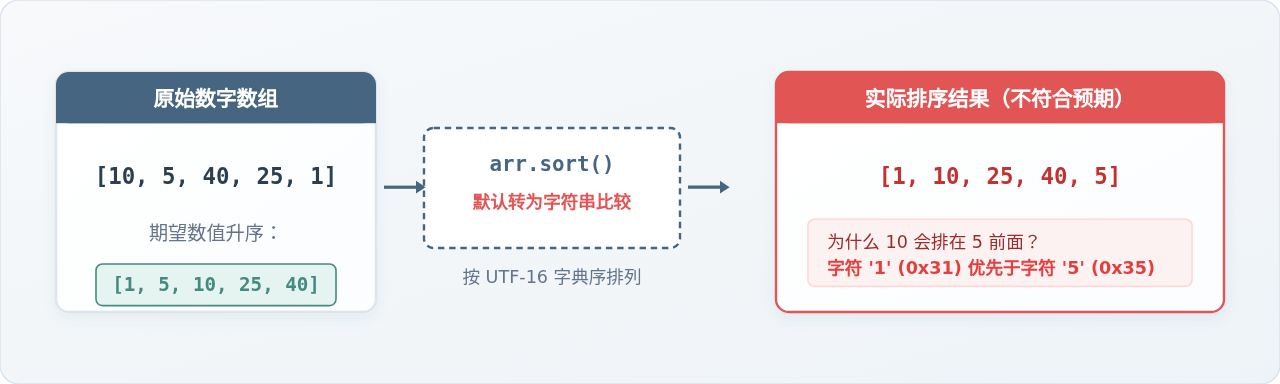
array.sort() 对数字进行排序时,常常会出现 10 排在 5 前面的反直觉现象。其核心原因在于:ECMAScript 规范规定无参的 sort() 会先将所有数组元素转换为字符串,再按照 UTF-16 码元顺序(字典序)逐字符进行升序排列,同时该方法会直接修改原数组。只要掌握比较函数(compareFunction)的执行原理并规避常见副作用,就能彻底避免排序失控。
一、直击现象:令初学者困惑的排序“异常”
许多开发者在刚接触 JavaScript 时,习惯于像使用其他编程语言一样,直接调用数组自带的排序方法对一组数字进行整理。然而,实际运行得到的结果往往与期望大相径庭。请观察以下典型的代码示例:
// 声明一组无序数字
const scores = [10, 5, 40, 25, 1000, 1];

// 直接调用原生 sort 方法
scores.sort();

console.log(scores);[ 1, 10, 1000, 25, 40, 5 ]
从数学大小来看,数字 5 显然小于 10,40 也小于 1000。然而在实际输出中,10 与 1000 紧紧跟在 1 之后,而 5 却被孤零零地甩到了整个数组的最末尾。这并非 JavaScript 运行环境的 Bug,而是完全符合语言标准规范但违背数学常识的既定行为。
二、原理深究:为什么会按“字典序”排列?
根据 ECMAScript 规范定义,当调用 Array.prototype.sort() 时,如果未显式提供比较函数(compareFunction),引擎会执行如下内置操作:
- 遍历需要比较的数组元素,对每一个元素调用内置抽象操作
ToString(),将其强制转换为字符串。 - 以字符串为基准,依次比对每个字符对应的 UTF-16 码元(Code Unit)数值大小。
- 只要在前面的字符位置上判断出大小差异,便立即决定二者的排列次序,而不再考虑字符串的整体长度或对应的实际数值。
以数字 10 与 5 为例:转换为字符串后分别为 "10" 与 "5"。比对首先从索引 0 开始,字符 "1" 的 UTF-16 编码为十六进制 0x0031(十进制 49),而字符 "5" 的 UTF-16 编码为十六进制 0x0035(十进制 53)。因为 49 小于 53,引擎判定字符串 "10" 应当排在字符串 "5" 之前。同理,"1000" 的首字符同样是 "1",因而也会排在 "25" 和 "5" 的前面。
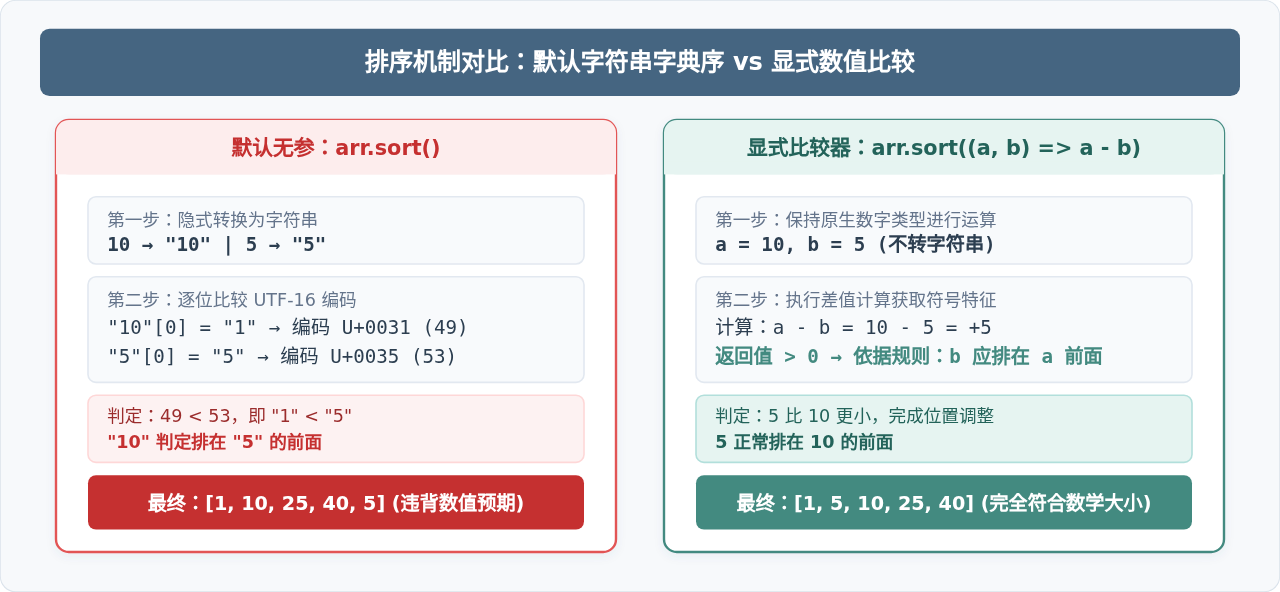
正是这种“数值到字符串的隐式转换”,切断了数值之间的大小逻辑,让算法变成了在字典里查单词的逻辑。
三、标准修复:传递明确的比较函数(compareFunction)
要恢复我们所期望的数值升序或降序排列,必须向 sort() 方法传递一个自定义的比较函数。比较函数接收两个待比较的元素参数 (a, b),并根据返回值来确定它们的先后关系。
1. 基础数字升序与降序
对于常见的常规有限数值数组,最简明的做法是使用两数相减的结果作为返回值:
const numbers = [10, 5, 40, 25, 1000, 1];

// 升序排列:较小的数字排在前
numbers.sort((a, b) => a - b);
console.log(numbers);
// 示例输出: [ 1, 5, 10, 25, 40, 1000 ]

// 降序排列:较大的数字排在前
numbers.sort((a, b) => b - a);
console.log(numbers);
// 示例输出: [ 1000, 40, 25, 10, 5, 1 ]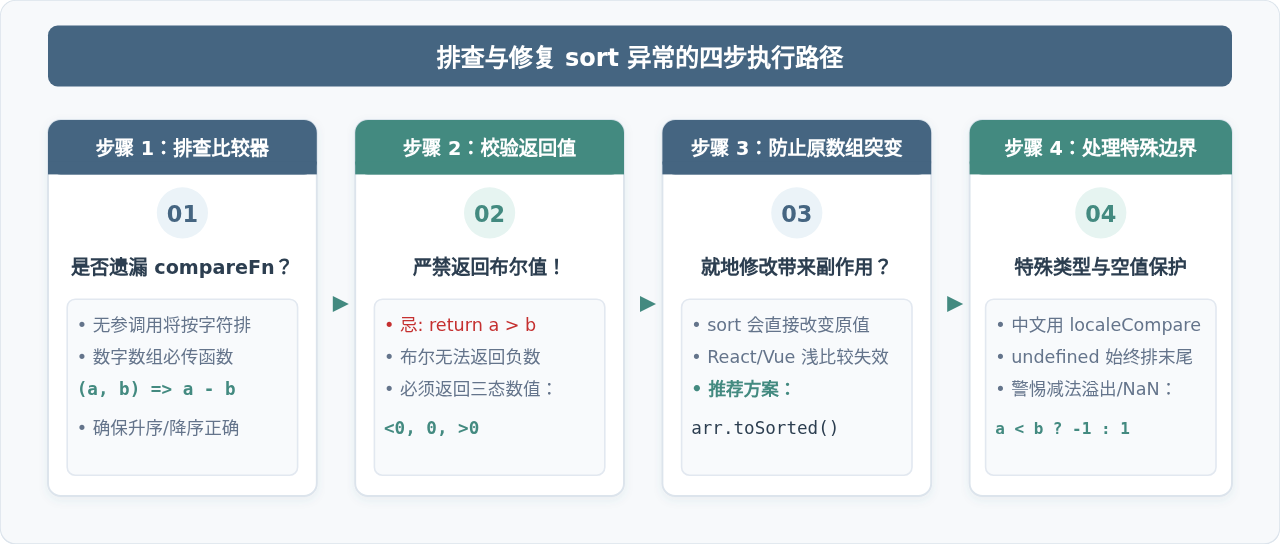
提示:排查排序故障时,应先确认是否遗漏了比较函数,随后检查比较器返回值是否满足负数/零/正数规范,最后检查原数组引用与特殊边界值。
四、内部机制:比较函数的三态返回值约定
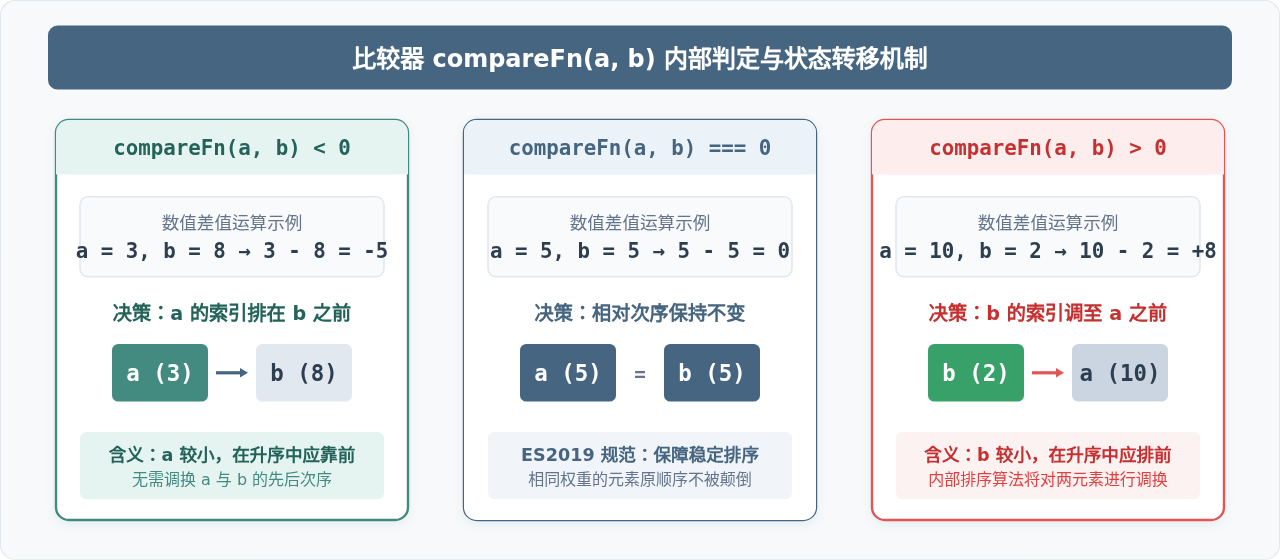
JavaScript 的排序算法(在主流浏览器和 Node.js 现代版本中普遍使用高效且稳定的 Timsort 算法)完全依赖比较函数的返回值符号来决策位置调度,而非依赖布尔值。规范严格规定:
| compareFn(a, b) 返回值 | 算法判定结论 | 元素的最终相对位置 |
|---|---|---|
| 小于 0(负数,例如 -1) | a 应该排在 b 之前 | 保持或调换使得 a 的索引小于 b |
| 等于 0(严格为 0) | a 与 b 的排序权重完全相等 | 保持两者的原相对位置不变(稳定排序) |
| 大于 0(正数,例如 1) | b 应该排在 a 之前 | 调换位置使得 b 的索引小于 a |
致命陷阱:千万不要返回布尔值!
很多开发者误写出
很多开发者误写出
arr.sort((a, b) => a > b)。在 JavaScript 中,当 a > b 成立时返回 true(在算术判定中被视作 1,代表大于 0);但当 a <= b 时返回 false(被视作 0,代表相等)。由于该函数永远不可能返回小于 0 的负数,算法无法获知“a 小于 b”的状态,最终导致排序算法被打乱,输出完全不可预测的混乱顺序。
五、不可忽视的四大衍生隐患与应对方案
除了未传入比较函数之外,在实际生产项目中,开发者还经常踩入以下四种引发业务 Bug 的排序陷阱:
1. 就地突变(In-Place Mutation)污染源数据
Array.prototype.sort() 是一个具有破坏性的就地修改方法。它不仅在原数组内存上直接进行重排,而且返回的也是原数组的引用。这在 React、Vue 等倡导单向数据流与不可变状态(Immutability)的框架中极易导致组件不更新或状态污染:
const originalList = [3, 1, 2];
const sortedList = originalList.sort((a, b) => a - b);

console.log(originalList === sortedList); // true(引用完全相同)
console.log(originalList); // [1, 2, 3](原数组已被强行篡改!)推荐修复策略:在现代 ECMAScript(ES2023+)中,建议优先使用非破坏性方法 toSorted(),它会创建并返回一个排序后的崭新数组;若需兼容旧运行环境,可使用扩展运算符 [...arr].sort(...) 进行浅拷贝防护。
2. 极大数值相减溢出与 NaN 陷阱
简写形式 (a, b) => a - b 虽然便捷,但存在两处边界隐患:
- 数值溢出:当数组中混合存在接近
Number.MAX_VALUE的极大值与极小负数时,直接做减法可能发生数值溢出变成Infinity或精度丢失。 - NaN 传染:如果数组中混入了非数字类型、
undefined或NaN,减法运算将返回NaN。根据规范,比较器返回NaN会被视作无法比较,导致该项周边所有元素的排列次序失控。
稳健的防御性写法:
function safeNumericSort(a, b) {
  if (Number.isNaN(a)) return 1;
  if (Number.isNaN(b)) return -1;
  if (a < b) return -1;
  if (a > b) return 1;
  return 0;
}
3. 中文字符串排序不符合拼音顺序
很多开发者尝试对包含中文名字的数组进行排序,发现依然不如人意:
const cityList = ["北京", "上海", "广州", "深圳"];
cityList.sort();
console.log(cityList);
// 示例输出: [ '上海', '北京', '广州', '深圳' ]
// 原因:默认按汉字的 Unicode 码点大小排序,而非拼音的首字母 A-Z!标准解决方案:使用原生国际化 API String.prototype.localeCompare(),并指定中文区域语言代码:
cityList.sort((a, b) => a.localeCompare(b, "zh-Hans-CN"));
console.log(cityList);
// 正确按拼音排序: [ '北京' (B), '广州' (G), '上海' (S), '深圳' (S) ]
4. 数组包含 undefined 或稀疏空位
规范特意规定:无论比较函数如何编写,数组中的所有 undefined 元素都会在排序开始前被直接提取,并在排序结束时被强制排在整个数组的最末端;比较函数根本不会被应用于 undefined。如果你的业务逻辑希望将未定义项置于头部,必须在排序前先行过滤或做单独的分组归纳。
六、总结与开发速查决策
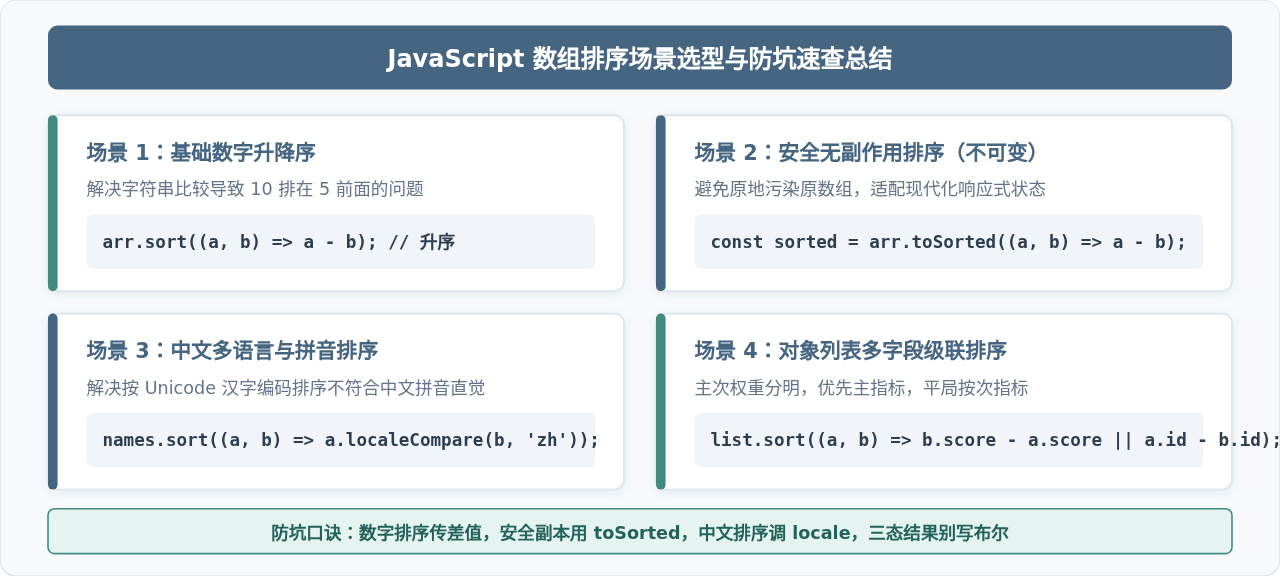
回顾全文,JavaScript 数组 sort() 结果之所以屡屡不符合预期,根源在于默认的字符串转换与字典序比较规则。只要在编写代码时恪守以下三条核心准则,即可从容应对各种复杂的数据排序需求:
- 凡排数字,必传函数:只要数组元素包含数值类型,绝不依赖无参调用,始终传入
(a, b) => a - b或防御性三元比较器。 - 三态数值,拒绝布尔:比较函数的返回结果必须是负数、0 或正数,切勿返回布尔表达式。
- 善用 toSorted,远离突变:在状态驱动的应用中优先选用
arr.toSorted(),确保源数据纯净无副作用。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章