
本文深入讲解JavaScript中如何使用findIndex方法按条件获取数组元素索引,包含语法结构、执行原理、常见业务场景代码示例、避坑指南及与其他检索方法的选型对比。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS中findIndex怎么按条件获取数组元素索引
作者:拾光
时间:2026-11-02
浏览:69
文章目录
JavaScript 核心 API 指南
1. 必须使用
适用标准:ECMAScript 2015 (ES6) 及以上
阅读时长:约 6 分钟
类型:语法与实战应用
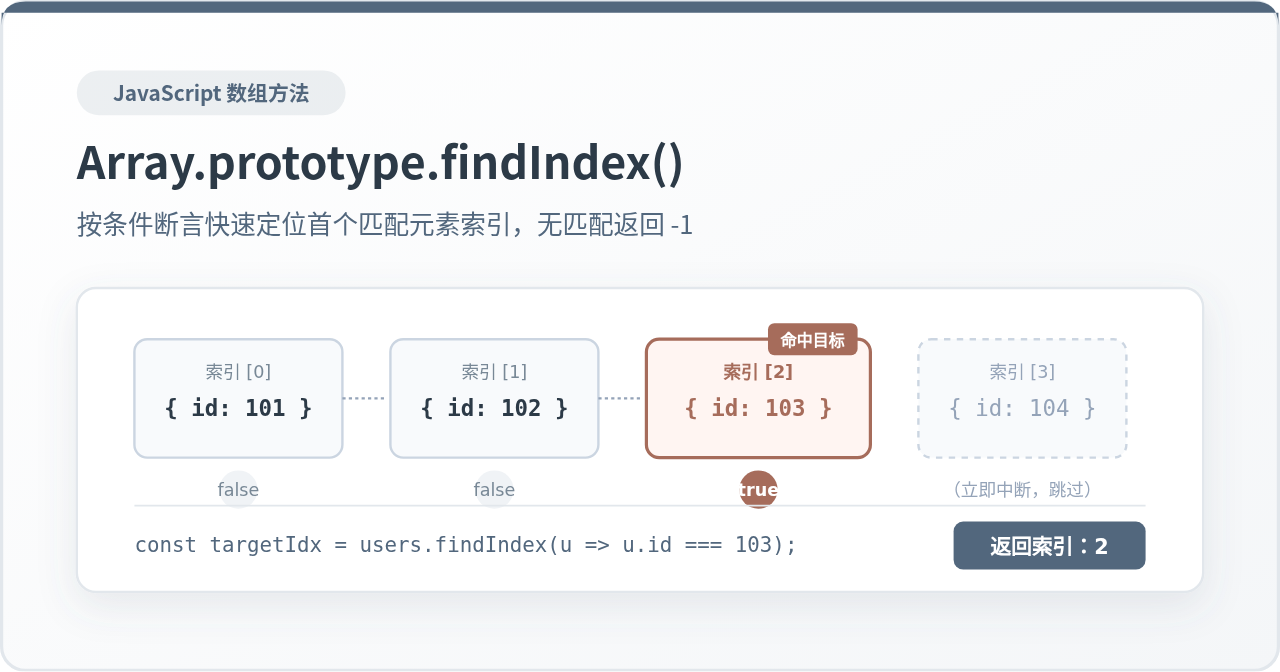
在 JavaScript 中,若要根据自定义条件查找数组中符合条件的元素索引,标准做法是使用 Array.prototype.findIndex() 方法。它接收一个测试回调函数,从索引 0 开始逐个对数组元素进行断言计算,一旦某个元素使回调函数返回真值(truthy),该方法便立刻停止后续遍历,并直接返回该元素的索引数值(从 0 开始);若遍历整个数组均无任何元素满足条件,则统一返回 -1。
一、findIndex 的核心语法与参数结构
在 ES6 之前,开发者若要在数组中查找元素索引,往往使用 indexOf()。然而 indexOf() 仅支持严格相等比较(===),只能处理基础类型的值比对,面对对象属性比对或动态范围判断时无能为力。findIndex() 正是为解决这一问题而设计的谓词检索方法。
该方法的完整调用签名如下:
const targetIndex = array.findIndex(function(element, index, array) {
  // 返回布尔值:true 表示找到匹配目标,false 表示继续往下查找
  return element.status === 'active';
}, thisArg);
回调函数接收三个按位置传递的参数:
element:当前正在被测试的数组元素。index(可选):当前正在被测试的元素在数组中的索引位置(0, 1, 2...)。array(可选):调用findIndex方法的原数组引用。thisArg(可选):执行回调函数时用作this上下文的对象。
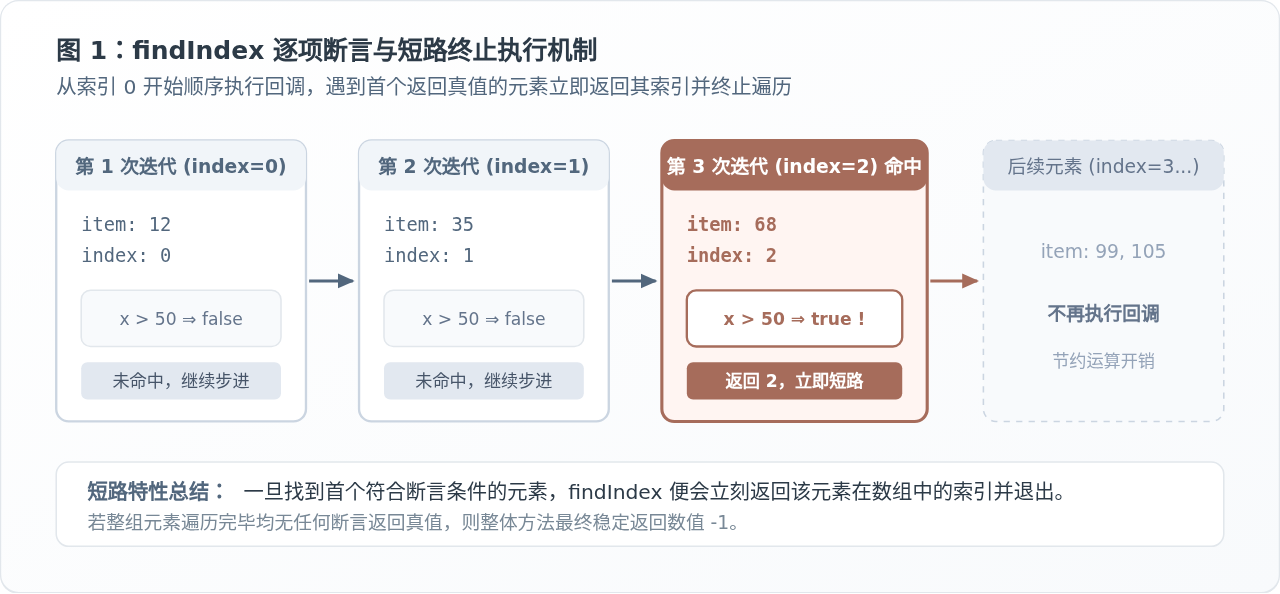
图 1:findIndex 逐项执行断言回调及提前短路机制
findIndex() 具备短路执行(Short-circuiting)特性:如图 1 所示,一旦在索引 2 处计算出 true,引擎就会即刻中断遍历并返回数值 2,后续索引为 3 和更靠后的元素绝不会再触发回调计算。这在处理高开销的断言计算或大型数组时,具有明显的性能优势。
二、核心业务场景与完整代码示例
场景 1:在对象数组中按特定属性查找索引
这是日常业务开发中最典型的使用场景。例如在管理系统中,我们拿到一个用户 ID,需要定位该用户在列表中的位置以便进行就地修改或删除:
// 模拟用户列表数据
const userList = [
  { id: 101, name: '张伟', department: '技术部' },
  { id: 102, name: '王芳', department: '财务部' },
  { id: 103, name: '李娜', department: '运营部' },
  { id: 104, name: '赵强', department: '市场部' }
];

// 查找 id 等于 103 的员工在数组中的位置
const targetId = 103;
const matchIndex = userList.findIndex(user => user.id === targetId);

console.log(matchIndex);
// 示例输出: 2
场景 2:数值或字符串的范围与动态逻辑匹配
当数据为基础类型,但判断逻辑并非“全等”而是“大于某个阈值”、“满足正则表达式”或“符合特定位运算”时,同样使用 findIndex:
const sensorReadings = [24.2, 28.5, 31.0, 45.8, 52.3, 36.1];

// 寻找首个超过报警阈值 40 度的读数索引
const alertIndex = sensorReadings.findIndex(temp => temp > 40);

console.log(alertIndex);
// 示例输出: 3 (对应数值 45.8)
场景 3:结合 index 参数实现相对位置检索
回调函数的第二个参数 index 可以参与条件计算。例如,寻找数组中位于索引 2 之后、且属性为真值的第一个元素:
const tasks = [
  { title: '初始化', done: true },
  { title: '编译源码', done: true },
  { title: '代码检查', done: false },
  { title: '单元测试', done: true }
];

// 仅在下标大于 1 的范围内查找首个已完成的任务
const lateDoneIndex = tasks.findIndex((task, idx) => idx > 1 && task.done);

console.log(lateDoneIndex);
// 示例输出: 3
场景 4:查找 NaN 所在位置
在 JavaScript 原生规则中,NaN === NaN 的结果为 false,因此经典的 indexOf(NaN) 会永远返回 -1,无法定位。而 findIndex 配合 Number.isNaN 能够精确找到 NaN 所在的索引:
const mixedData = [10, 20, NaN, 40];

console.log(mixedData.indexOf(NaN));
// 示例输出: -1 (无法通过 indexOf 检索)

const nanIndex = mixedData.findIndex(val => Number.isNaN(val));
console.log(nanIndex);
// 示例输出: 2 (精准定位)
三、获取索引后的规范操作流程与避坑指南
获取索引本身只是中间步骤,通常后续还需要进行原数组的更新(替换)或删除操作。在这个流程中,有两项至关重要的规范要求:
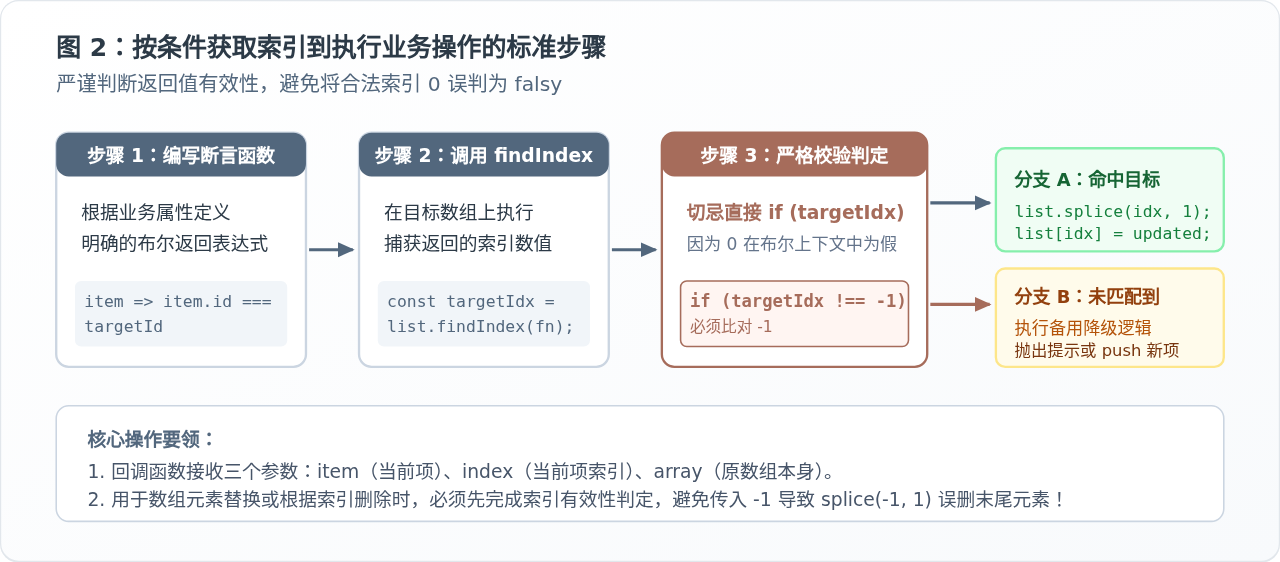
图 2:从条件检索到安全执行业务操作的标准步骤流
1. 必须使用 !== -1 严谨判断
初学者最容易犯的隐蔽 Bug 是使用 if (index) 进行布尔判断:
⚠️ 危险反模式:布尔隐式转换
当匹配的目标恰好是数组的第一项(索引为 0)时,JavaScript 会将数值
if (arr.findIndex(...)) { ... }当匹配的目标恰好是数组的第一项(索引为 0)时,JavaScript 会将数值
0 转换为布尔假值 false,导致该分支直接被跳过!正确的判断方式永远是显式对比:if (index !== -1)。
2. 防止 splice(-1, 1) 误删末尾数据
在数组删除逻辑中,若没有对 -1 做拦截就直接传给 splice,array.splice(-1, 1) 会被解释为“从数组末尾倒数第一个元素开始删除”,导致原本因找不到目标无需删除的代码,误将末尾元素删除了。
规范的安全删除与替换代码示例如下:
function removeProductById(productList, targetId) {
  // 第一步:按条件获取目标索引
  const targetIndex = productList.findIndex(item => item.id === targetId);

  // 第二步:严格校验是否命中
  if (targetIndex !== -1) {
    // 命中后安全删除 1 项
    productList.splice(targetIndex, 1);
    console.log(`成功删除索引为 ${targetIndex} 的商品`);
    return true;
  } else {
    console.warn(`未找到 ID 为 ${targetId} 的商品,无需处理`);
    return false;
  }
}
四、JavaScript 数组查找系列方法对比与选型指南
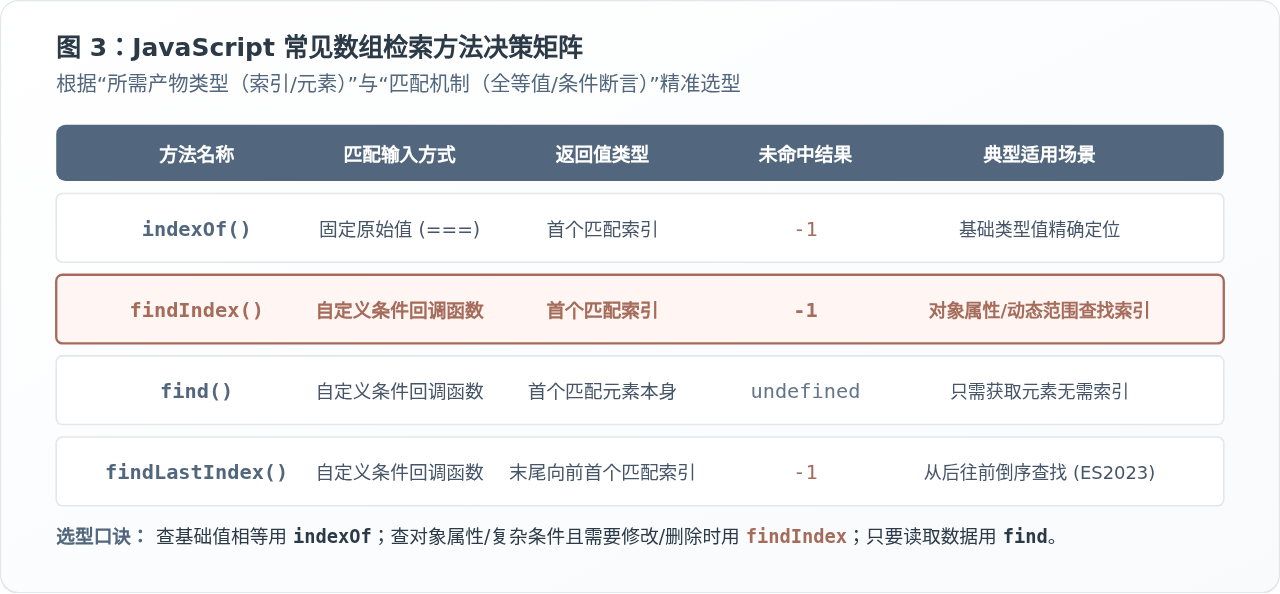
JavaScript 针对数组检索提供了多个配套 API,开发者应根据业务所需要的产物形式与匹配维度进行精准选择:
图 3:数组查找系列 API 特性与选型决策维度
| 方法 | 输入匹配条件 | 返回值(命中) | 未命中返回值 | 适用场景 |
|---|---|---|---|---|
indexOf |
静态值(=== 全等) |
首个元素索引(0 到 n-1) | -1 |
基础类型(数字、字符串)值存在性与下标获取 |
findIndex |
断言回调函数(谓词) | 首个元素索引(0 到 n-1) | -1 |
对象数组、复杂条件计算下的元素索引定位 |
find |
断言回调函数(谓词) | 首个匹配的元素本身 | undefined |
仅需读取对象或数据本身,不涉及就地替换或删除 |
findLastIndex |
断言回调函数(谓词) | 从后往前首个匹配的索引 | -1 |
ES2023 新增特性,需要获取最后一次出现的索引 |
filter |
断言回调函数(谓词) | 所有匹配元素组成的新数组 | [](空数组) |
需要获取全部满足条件的项,而非仅定位单个 |
五、底层特性与边界行为总结
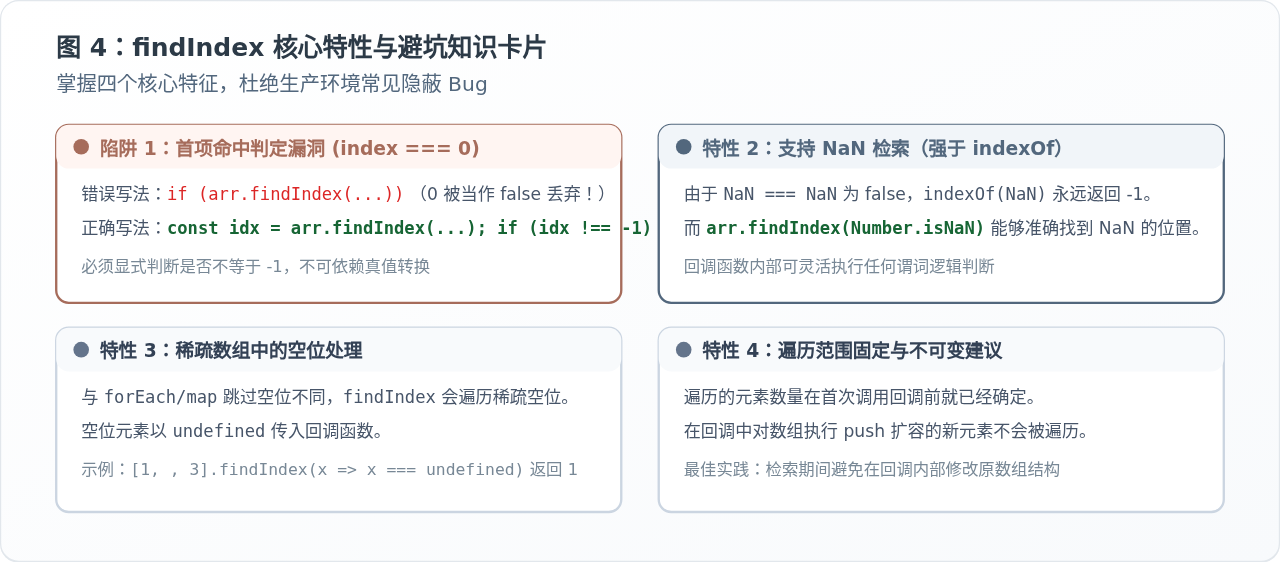
图 4:findIndex 底层机制与关键避坑卡片
在深度使用 findIndex 时,还需要了解以下三个规范层面的底层特征:
-
稀疏数组(Sparse Arrays)的处理:
传统的数组迭代方法(如
forEach、map)会自动跳过未赋值的空洞(empty slots)。但findIndex不会跳过空洞,它会为数组中的每一个索引都触发一次回调,未分配值的索引对应的element为undefined。 -
遍历长度在调用初始即已固定:
当
findIndex首次执行前,数组的长度(length)属性就已经被缓存。如果回调函数在执行过程中调用push为数组追加新元素,新追加的元素不会被本次findIndex访问。 -
纯函数原则:
尽量保证传递给
findIndex的回调函数是无副作用的纯函数,避免在断言回调内部去调用pop、shift或修改数组结构,以免导致遍历指针偏移引发难以追踪的竞态异常。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章