
针对JavaScript中对象数组缺乏唯一ID字段时的深度去重问题,系统讲解原生引用判重失效原因、规范化键排序序列化法与递归深度比对法,提供完整生产级代码与性能选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS对象数组没有唯一ID时怎么深度去重
作者:函数茶馆
时间:2026-11-02
浏览:184
文章目录
技术讲解
JavaScript进阶
适用场景:数据分析 / 表单合并 / 多维过滤配置
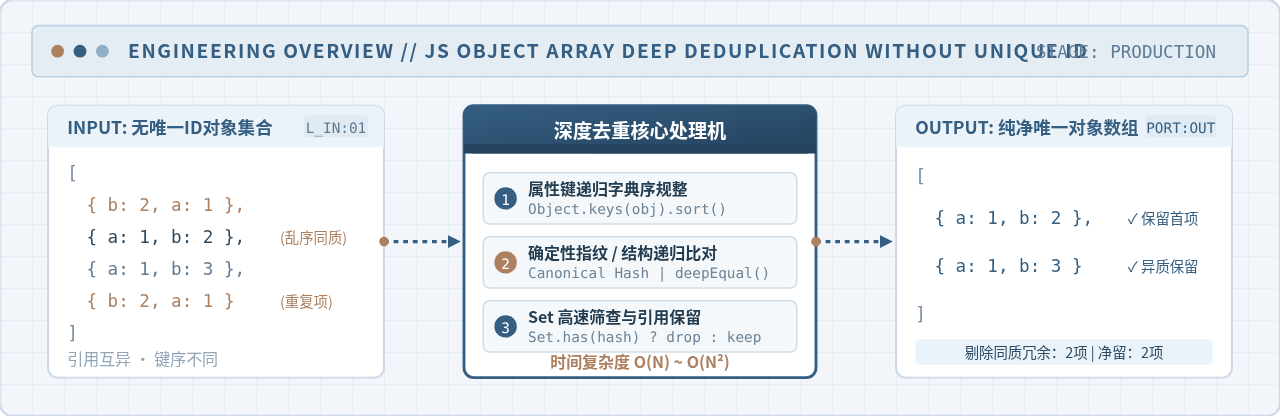
在前端交互或后端数据聚合中,若对象数组包含 id 或 uuid 等唯一标识,通过 Map 即可轻易完成去重。但在多列过滤条件、动态表单配置、三维坐标点集合或原始日志排重等业务场景中,对象往往缺乏唯一标识,两个对象是否重复必须取决于它们内部所有键值是否在结构与深层数据上完全一致。解决无 ID 对象数组深度去重的核心路径主要有两种:规范化键排序序列化法(将对象递归排序后生成确定性哈希文本,借助 Set 达成 O(N) 高性能过滤,适合绝大多数常规数据)与递归深度比对法(通过严谨的 deepEqual 算法逐项验证,解决 Date、RegExp、NaN 等特殊类型的精准保真)。本文将逐一讲解其核心原理、实现步骤、边界处理与工程选型。
一、为什么常规去重手段对无ID对象数组无效
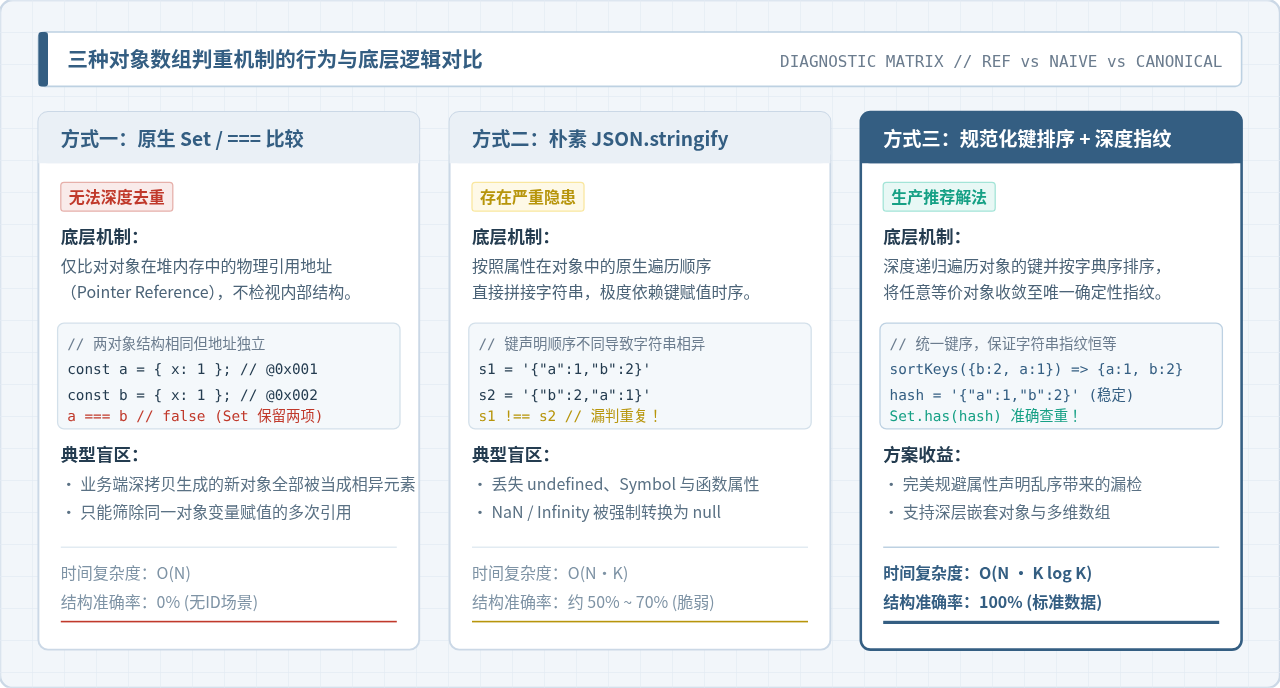
初学者在遇到对象去重时,往往会尝试使用 ES6 的 new Set(arr) 或者直接写 JSON.stringify 进行转换过滤。但这两种方式在无 ID 对象去重时都存在严重缺陷。
首先是 Set 与全等操作符 ===。JavaScript 规范规定,对象属于引用类型。两个字面量内容完全相同的对象(例如 { x: 1 } 与 { x: 1 }),它们在底层堆内存中分配的是两个独立的内存地址指针。Set 在执行去重判断时采用 SameValueZero 比较算法,比较的是引用地址而非内部属性。因此,通过深拷贝或接口多次请求产生的相同内容对象,在 Set 中均被判定为独立元素,去重彻底失效。
其次是直接调用原生 JSON.stringify。JavaScript 规范(ECMAScript 2015+)中,JSON.stringify 遍历对象属性的顺序严格依赖属性被创建或写入对象的时序。如果两个对象内部包含完全一致的键值对,但定义顺序不同(例如 { a: 1, b: 2 } 与 { b: 2, a: 1 }),原生序列化得到的结果分别为 '{"a":1,"b":2}' 和 '{"b":2,"a":1}'。字符串比对不相等,直接造成去重漏判(假阴性)。此外,原生 JSON.stringify 还会吞掉 undefined、函数以及 Symbol,并将 NaN 强制转为 null,存在不可逆的类型抹平隐患。
二、方案一:规范化键排序序列化法(高效 O(N) 推荐方案)
规范化键排序序列化法是生产中最推荐的方案。它的核心思路是:在将对象序列化为唯一特征串之前,先递归遍历对象,将其自身的所有键名按照字典序(Alphabetical Order)进行稳定排序。这样,无论原对象在何处、以何种属性顺序创建,经过规范化转换后,都能输出恒等一致的确定性指纹字符串(Canonical Fingerprint),配合 Set 实现 O(N) 复杂度的快速筛查。
1. 算法执行流程与步骤
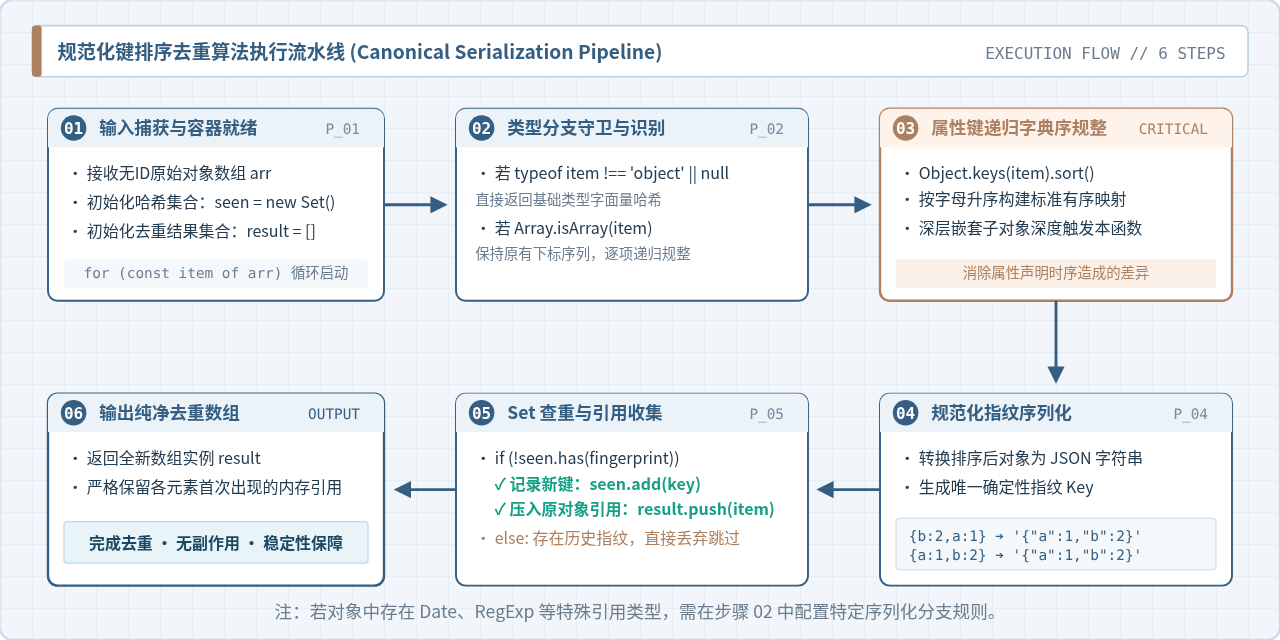
该流水线主要由以下 6 个步骤组成:
- 接收输入与初始化容器:准备原始对象数组,并创建
seen = new Set()缓存已记录的指纹,以及result = []存放首个入选的原对象。 - 类型分支守卫:检查当前遍历节点。如果是基础类型或
null,直接返回其对应的值;如果是数组,则保持数组原有的索引顺序并递归规整内部成员。 - 属性键递归字典序规整:提取对象所有自身可枚举键
Object.keys(),通过sort()执行字典升序排序,构造一个键序统一的新镜像对象。 - 规范化指纹生成:对排好序的确定性结构执行序列化,得到唯一的字符串签名。
- Set 高速查重:检查
seen.has(fingerprint)。若不存在,则将指纹加入seen并将原始对象压入result;若已存在,直接丢弃。 - 输出结果:遍历完毕后返回纯净数组,保留各对象的首次引用。
2. 生产级完整代码实现
canonicalDedupe.jsES6+ 标准实现
/**
 * 递归将对象的属性键按字典序排序,生成确定性规范化对象
 * @param {*} value 待规整的数据
 * @returns {*} 排序规整后的数据副本
 */
function canonicalize(value) {
  // 1. 处理 null 与非对象基本类型
  if (value === null || typeof value !== 'object') {
    return value;
  }

  // 2. 处理 Date 与 RegExp 等特殊内置对象(按需保留自身值)
  if (value instanceof Date) {
    return value.toISOString();
  }
  if (value instanceof RegExp) {
    return value.toString();
  }

  // 3. 处理数组:保持原始下标顺序,递归规整数组项
  if (Array.isArray(value)) {
    return value.map(canonicalize);
  }

  // 4. 处理纯对象:提取所有自身可枚举键并字典序排序
  const sortedKeys = Object.keys(value).sort();
  const sortedObj = {};
  for (const key of sortedKeys) {
    sortedObj[key] = canonicalize(value[key]);
  }

  return sortedObj;
}

/**
 * 对象数组无ID深度去重(规范化键排序法)
 * @template T
 * @param {T[]} array 待去重的对象数组
 * @returns {T[]} 去重后的纯净数组(保留首项引用)
 */
function dedupeByCanonicalSort(array) {
  if (!Array.isArray(array) || array.length <= 1) {
    return Array.isArray(array) ? [...array] : [];
  }

  const seen = new Set();
  const result = [];

  for (let i = 0; i < array.length; i++) {
    const item = array[i];
    // 生成排序后的确定性 JSON 指纹
    const canonicalItem = canonicalize(item);
    const fingerprint = JSON.stringify(canonicalItem);

    if (!seen.has(fingerprint)) {
      seen.add(fingerprint);
      result.push(item); // 严谨保留原对象引用
    }
  }

  return result;
}
3. 执行验证示例
通过包含属性倒序、多层嵌套、数组嵌套的复杂无 ID 数组进行执行验证:
example.js示例执行与结果对比
// 构造测试数据:对象顺序颠倒、嵌套子对象、数组字段
const testList = [
  { name: 'Filter_A', params: { min: 10, max: 100 }, tags: ['js', 'web'] },
  { params: { max: 100, min: 10 }, name: 'Filter_A', tags: ['js', 'web'] }, // 重复项(键乱序)
  { name: 'Filter_B', params: { min: 10, max: 100 }, tags: ['js', 'web'] }, // 异质项
  { name: 'Filter_A', params: { min: 10, max: 100 }, tags: ['web', 'js'] }, // 数组顺序不同,判定为相异
  { params: { min: 10, max: 100 }, tags: ['js', 'web'], name: 'Filter_A' }  // 重复项
];

const cleaned = dedupeByCanonicalSort(testList);

console.log('原始长度:', testList.length); // 示例输出:5
console.log('去重后长度:', cleaned.length); // 示例输出:3
console.log(JSON.stringify(cleaned, null, 2));
注意事项:在数组字段比对中,
['js', 'web'] 与 ['web', 'js'] 通常被判定为不同数据,因为数组是有序列表(Index-based sequence)。如果业务要求数组内容无序相等,需要在 canonicalize 中额外对特定字段的数组执行排序。
三、方案二:递归深度比对法(高精度逐项比对)
在某些严苛的运行时环境中,对象可能包含无法被 JSON 正确表达的数据类型(例如 NaN、undefined 作为属性值保留、BigInt、循环引用标记等),此时直接转换字符串会产生类型失真或抛出 TypeError。针对此类场景,需要使用纯结构递归比对函数 deepEqual(a, b) 对数组进行两两校验。
1. 递归深度比对分支逻辑
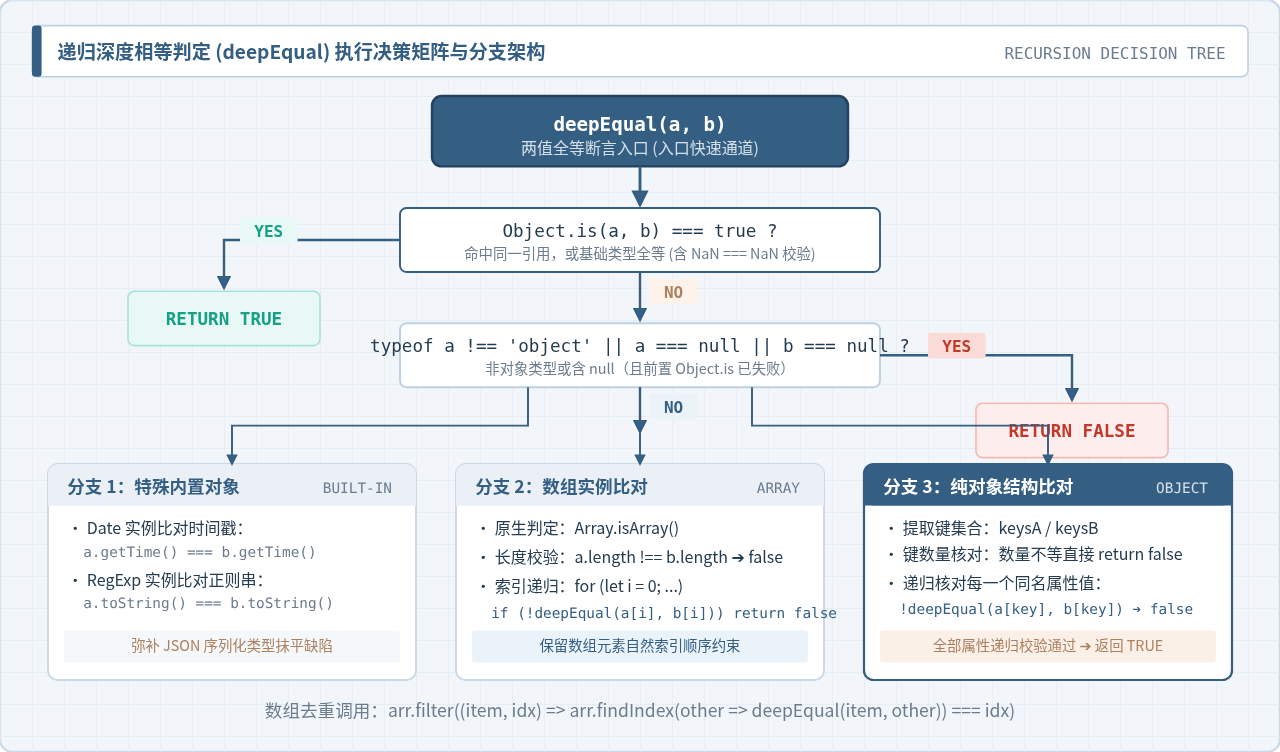
一个健壮的 deepEqual 算法必须按照严密的分支路径进行求值:
- 全等与快速路径:先通过
Object.is(a, b)快速判断。若为同一引用或基本类型同值(包括NaN === NaN),直接返回true。 - 非对象与空值截断:如果任一变量不属于
object类型,或存在null,且前序Object.is已经失败,则两者必不相等,直接返回false。 - 内置对象实例分支:针对
Date校验时间戳数值a.getTime() === b.getTime();针对RegExp校验字符串序列a.toString() === b.toString()。 - 数组实例分支:核对
length,若长度一致则遍历索引下标逐项递归比较。 - 普通对象分支:获取双方自身属性集合,比对属性数量,并递归确保每一个属性在对方对象上均存在且值完全深度相等。
2. 递归深度比对代码实现
deepEqualDedupe.js递归比对实现
/**
 * 递归判断两个任意类型变量是否深度全等
 * @param {*} a 比较对象A
 * @param {*} b 比较对象B
 * @returns {boolean} 是否深度相等
 */
function deepEqual(a, b) {
  // 1. 快速通道:引用相同或基础类型相同(支持 Object.is 对 NaN 的精确判定)
  if (Object.is(a, b)) return true;

  // 2. 拦截 null、基础类型及类型不同场景
  if (typeof a !== 'object' || a === null || typeof b !== 'object' || b === null) {
    return false;
  }

  // 3. 构造函数 / 原型差异拦截
  if (a.constructor !== b.constructor) return false;

  // 4. 特殊内置对象处理
  if (a instanceof Date) {
    return a.getTime() === b.getTime();
  }
  if (a instanceof RegExp) {
    return a.toString() === b.toString();
  }

  // 5. 数组比对
  if (Array.isArray(a)) {
    if (a.length !== b.length) return false;
    for (let i = 0; i < a.length; i++) {
      if (!deepEqual(a[i], b[i])) return false;
    }
    return true;
  }

  // 6. 普通对象比对
  const keysA = Object.keys(a);
  const keysB = Object.keys(b);

  if (keysA.length !== keysB.length) return false;

  for (let i = 0; i < keysA.length; i++) {
    const key = keysA[i];
    // 确保键名存在于 b 中,并且属性值递归深度相等
    if (!Object.prototype.hasOwnProperty.call(b, key)) return false;
    if (!deepEqual(a[key], b[key])) return false;
  }

  return true;
}

/**
 * 基于 deepEqual 的数组深度去重
 * @template T
 * @param {T[]} array 待去重数组
 * @returns {T[]} 去重后结果
 */
function dedupeByDeepEqual(array) {
  if (!Array.isArray(array) || array.length <= 1) {
    return Array.isArray(array) ? [...array] : [];
  }

  return array.filter((item, index, self) => {
    // 查找当前项在数组中首次出现的匹配索引
    const firstIndex = self.findIndex(other => deepEqual(item, other));
    return firstIndex === index;
  });
}
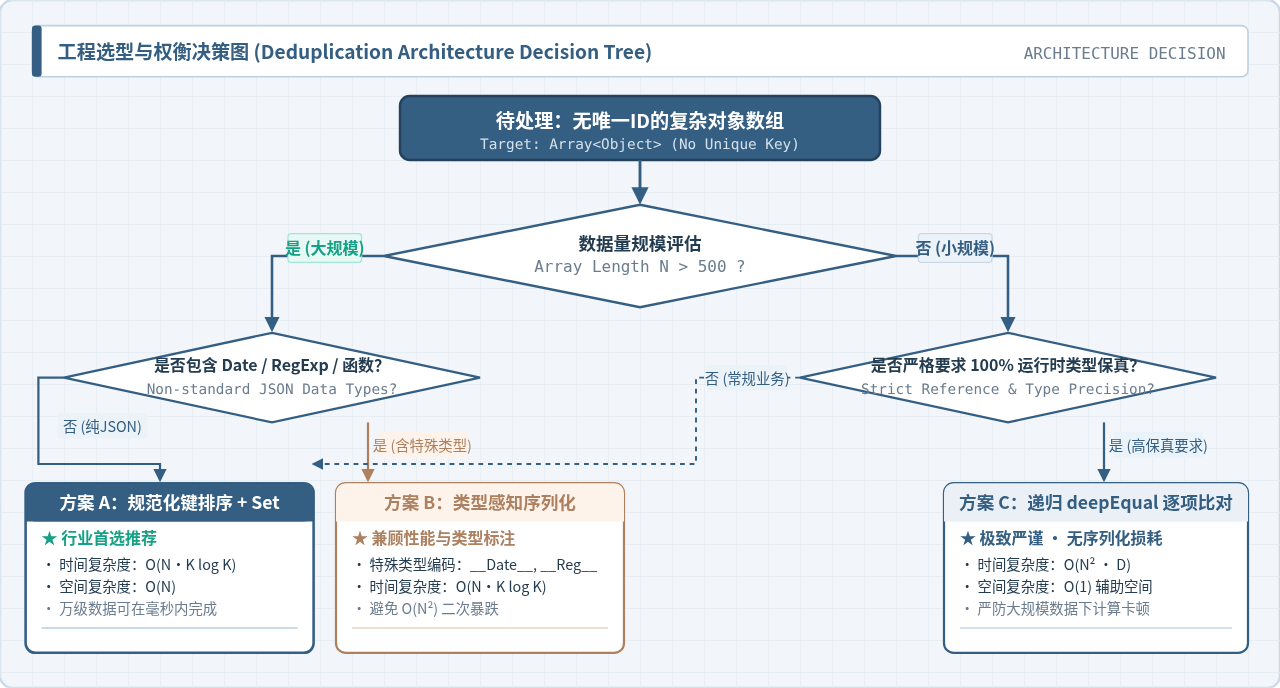
四、两种去重方案的技术选型与性能权衡
在面对不同的业务数据量级和数据结构时,必须合理选择去重方案。下表对规范化键排序序列化与递归深度比对进行了多维度对比:
| 指标维度 | 方案一:规范化键排序序列化法 | 方案二:递归 deepEqual 逐项比对法 |
|---|---|---|
| 时间复杂度 | O(N · K log K),接近线性时间 |
O(N² · D),随元素量呈平方级暴增 |
| 空间复杂度 | O(N),需要 Set 维护字符串指纹 |
O(1) 额外辅助空间(不计递归调用栈) |
| 类型支持度 | 标准 JSON 类型友好,非 JSON 类型需转换 | 支持所有 JavaScript 内部对象、NaN 与复杂引用 |
| 大数据表现 (N > 1000) | 极佳,万级数据可在数十毫秒内完成 | 严重卡顿,千级数据触发百万次递归调用 |
| 适用场景 | 表单筛选集、API 列表排重、配置去重(推荐) | 包含特殊对象、严格类型判定、数据量小于 200 项 |
五、生产实践中的关键避坑点
在实际工程中实施无 ID 深度去重时,以下几个边界情况极易引发隐藏 Bug,需要特别关注:
1. 属性值为 undefined 与缺失键的区别
在原生对象中,{ a: undefined } 与 {} 在直接访问时 obj.a 均返回 undefined,但它们在结构语义上完全不同。'a' in obj 会分别返回 true 与 false。使用 JSON.stringify 时,值为 undefined 的属性会被直接略去,导致两者被误判为相同对象。如果业务对 undefined 敏感,应使用 deepEqual,或者在规范化排序函数中将 undefined 显式编码为特殊占位标记(例如 __UNDEFINED__)。
2. 原型继承属性与 Symbol 属性
Object.keys() 仅能获取对象自身的、可枚举的字符串键。如果对象继承了原型链属性,或者使用了 Symbol 作为键名(例如 Symbol('id')),Object.keys() 将无法读取它们。若需完整覆盖,需要结合 Object.getOwnPropertySymbols() 以及 Reflect.ownKeys() 进行键名获取。
3. 循环引用导致调用栈溢出(Stack Overflow)
如果无 ID 对象数组中的对象存在双向引用(例如 a.parent = b; b.child = a;),无论是 canonicalize 还是 deepEqual 都会陷入无限递归,最终抛出 Maximum call stack size exceeded 错误。如果数据源存在循环引用的可能性,应在递归函数中使用 WeakSet 记录已经访问过的对象引用,并在二次进入时直接返回,防止死循环。
性能建议:在千万级前端交互中,永远不要在
Array.prototype.filter 中嵌套调用未做哈希缓存的 deepEqual。一旦数组长度超过 500,必须优先采用规范化键排序序列化法,通过一次性构建索引哈希集合实现极速判重。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章