

深入解析JavaScript控制流平坦化混淆的底层原理,系统介绍基于Babel AST静态语法树遍历、分发器提取、基本块重排置换以及动态Trace符号执行的高级反混淆实战思路。
遇到控制流平坦化混淆怎么办?JS高级反混淆思路解析
作者:沉舟
时间:2026-10-30
浏览:291
文章目录
遇到控制流平坦化(Control Flow Flattening)混淆时,最直接有效的解决方案是通过 AST(抽象语法树)静态分析技术定位包装在
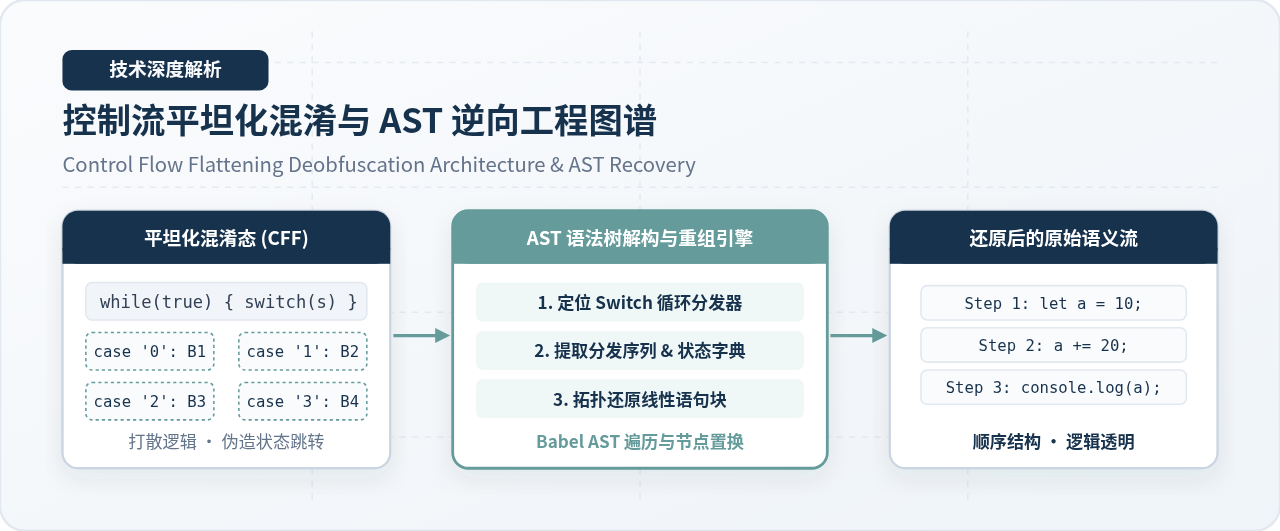
while-switch 结构中的分发器,解析其状态转移数组或初始状态序列表,提取各个 case 基本块内的有效语句并剔除控制跳步语句,最后将整个分发循环结构平铺替换为重排后的顺序代码块;若遇到条件跳转复杂变种,则配合轻量符号执行与控制流图(CFG)完成拓扑还原。
一、控制流平坦化的运作机制与特征识别
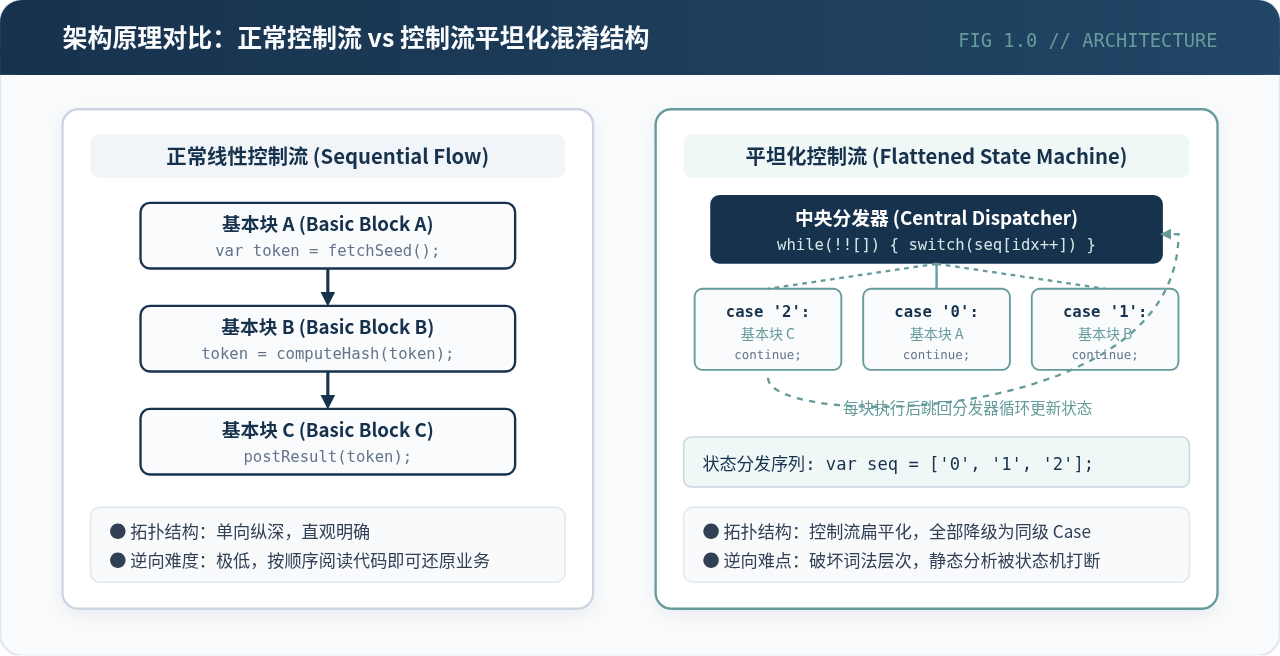
控制流平坦化是一种极具欺骗性的代码混淆手法,常见于 JavaScript Obfuscator 等主流前端防护工具中。它的核心目的,是破坏原本自上而下或具备清晰分支嵌套的代码拓扑结构,将一段函数或逻辑中的所有基本执行块(Basic Blocks)强行拉平到同一个维度。
在未平坦化前,正常的业务代码呈现自然的树状或链式流向:声明变量、计算参数、发起网络请求。而平坦化处理后,混淆器会引入一个状态机分发器(Dispatcher),将原本顺序执行的语句分别塞入各个 case 分支,并在外部包裹一个无限循环。
// 原始业务逻辑示例
function authenticate(user, token) {
  const seed = fetchSeed(user);
  const signature = signToken(seed, token);
  sendAuthHeader(signature);
  return true;
}

// 经控制流平坦化混淆后的典型代码形态
function authenticate(user, token) {
  var dispatcher = "3|1|0|2".split("|");
  var stepIndex = 0;
  var seed, signature;

  while (true) {
    switch (dispatcher[stepIndex++]) {
      case "0":
        sendAuthHeader(signature);
        continue;
      case "1":
        signature = signToken(seed, token);
        continue;
      case "2":
        return true;
      case "3":
        seed = fetchSeed(user);
        continue;
    }
    break;
  }
}
从上面的对比可以清晰看出,平坦化混淆代码必然具备以下四个特征结构:
- 分发状态序列(Dispatch String / Array):如
"3|1|0|2".split("|"),用于显式规定执行流程中各块的到达顺序; - 状态索引游标(State Cursor):如
stepIndex++,在每次循环迭代时驱动分发器取用下一个状态值; - 外层循环容器(While Loop):通常为
while (true)、while (!![])或for (;;); - 分支基本块(Switch-Case Blocks):各个
case对应真正的业务语句,结尾通常跟随continue回到循环顶层。
二、为什么传统调试与直读分析会失效
面对这类混淆,直接阅读代码或使用浏览器单步调试往往事倍功半,主要原因在于:
- 词法连续性断裂:上下文变量的定义与使用被分散在不同的
case块内,阅读时视线必须在数十个毫无规律的数字或哈希case之间来回跳跃; - 单步调试陷入循环陷阱:在 DevTools 中按 F10 单步执行时,每走一步都会跳回
while循环顶部和switch条件判断处,产生大量的机械冗余跳转; - 死代码与虚假分支(Bogus Control Flow):混淆器往往会掺杂永远不会被执行的假
case,例如在"3|1|0|2"中故意加入case "4": debugger;,诱导逆向分析人员在无意义的代码路径上浪费时间。
三、核心解法:基于 Babel AST 的静态模式识别与自动还原
要从根本上消除平坦化,最高效的手段并不是在运行时动态 hook,而是利用 Babel 对代码进行静态 AST(Abstract Syntax Tree)分析与节点重构。只要分发序列是静态可推导的,我们就可以完全还原出混淆前的顺序代码。
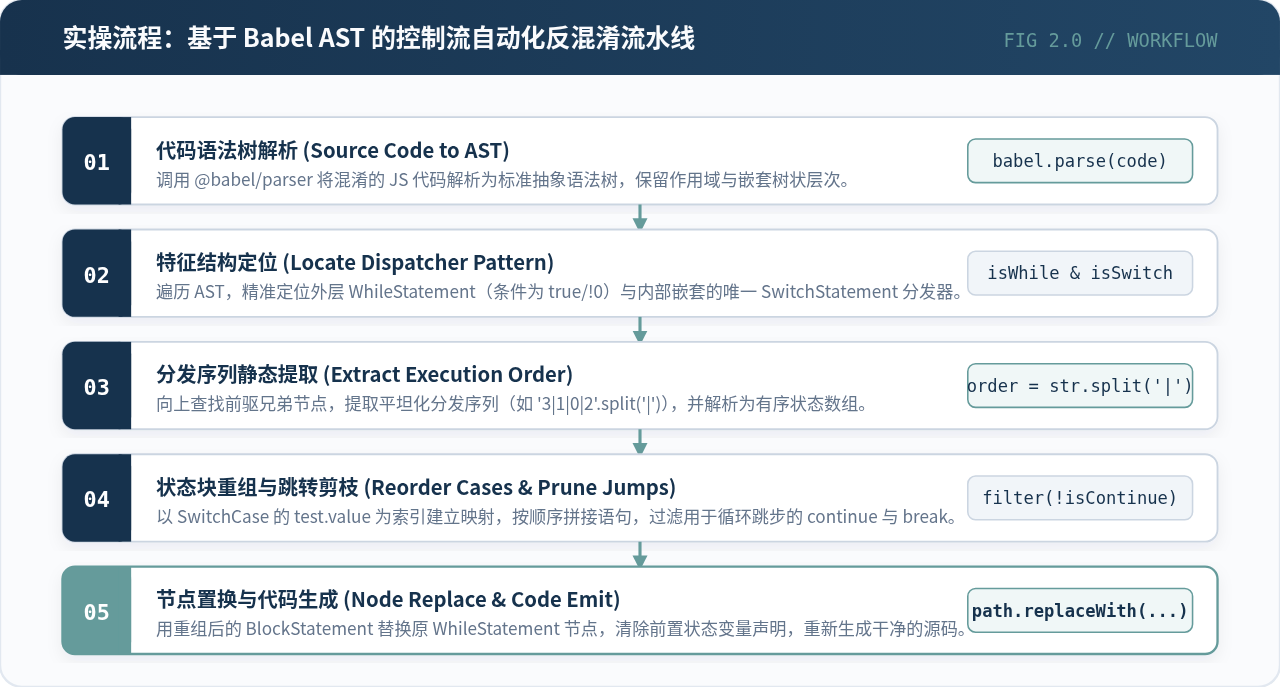
自动化还原五步操作流程
- 解析代码生成 AST:利用
@babel/parser将待处理的混淆 JS 脚本解析为树状结构; - 定位 While-Switch 结构特征:使用
@babel/traverse遍历语法树,找到包含SwitchStatement的WhileStatement节点; - 提取并求值分发序列:回溯分发器引用的变量(如
dispatcher),获取其初始化的字符串或数组字面量,计算出真实的执行顺序序列; - 建立 Case 映射表并重新排序:遍历
SwitchStatement的所有cases,将test.value作为键、有效语句作为值存入字典。按照步骤三提取出的执行序列拼接各块语句,同时剔除用于跳转的ContinueStatement与BreakStatement; - 节点替换与代码生成:使用
@babel/types创建重组后的语句列表(或 BlockStatement),替换原来的WhileStatement,并清除已无用的分发变量声明节点,最后由@babel/generator导出干净源码。
完整的 Babel 反混淆还原脚本
下面是一个经过工程验证的独立反混淆脚本。它演示了如何精准识别并自动平铺还原平坦化代码:
const parser = require("@babel/parser");
const traverse = require("@babel/traverse").default;
const generate = require("@babel/generator").default;
const t = require("@babel/types");

function deobfuscateControlFlow(sourceCode) {
  // 1. 将混淆源码解析为 AST
  const ast = parser.parse(sourceCode, { sourceType: "script" });

  // 2. 遍历 AST 寻找平坦化循环特征
  traverse(ast, {
    WhileStatement(path) {
      const { node, parentPath } = path;

      // 验证 while 条件是否为 true 或类似恒真表达
      if (!t.isBooleanLiteral(node.test, { value: true }) &&
          !t.isUnaryExpression(node.test, { operator: "!" })) {
        return;
      }

      // 检查循环体内部是否只包含唯一的 Switch 语句
      const body = node.body;
      if (!t.isBlockStatement(body) || body.body.length !== 1) return;
      const switchNode = body.body[0];
      if (!t.isSwitchStatement(switchNode)) return;

      // 3. 提取 switch 辨别式中所使用的分发器变量
      const discriminant = switchNode.discriminant;
      // 匹配形如: dispatcher[stepIndex++]
      if (!t.isMemberExpression(discriminant)) return;
      const arrayIdent = discriminant.object;
      if (!t.isIdentifier(arrayIdent)) return;

      // 在当前作用域中查找分发数组的声明节点
      const binding = path.scope.getBinding(arrayIdent.name);
      if (!binding || !binding.path.isVariableDeclarator()) return;

      const init = binding.path.node.init;
      let orderArray = [];

      // 提取形如 "3|1|0|2".split("|") 的字面量
      if (t.isCallExpression(init) &&
          t.isMemberExpression(init.callee) &&
          t.isStringLiteral(init.callee.object) &&
          init.callee.property.name === "split" &&
          init.arguments.length > 0 &&
          t.isStringLiteral(init.arguments[0])) {
        const rawStr = init.callee.object.value;
        const separator = init.arguments[0].value;
        orderArray = rawStr.split(separator);
      } else if (t.isArrayExpression(init)) {
        // 匹配直接声明的数组字面量 ['3', '1', '0', '2']
        orderArray = init.elements.map(el => el.value.toString());
      } else {
        return; // 复杂动态计算暂跳过
      }

      // 4. 将所有的 SwitchCase 块按索引提取成映射字典
      const caseMap = new Map();
      for (const switchCase of switchNode.cases) {
        if (!switchCase.test || !t.isStringLiteral(switchCase.test)) continue;
        const caseKey = switchCase.test.value;

        // 过滤掉末尾的 continue 与 break 语句
        const validStatements = switchCase.consequent.filter(stmt => {
          return !t.isContinueStatement(stmt) && !t.isBreakStatement(stmt);
        });
        caseMap.set(caseKey, validStatements);
      }

      // 按分发序列拼装出真正的顺序语句列表
      const restoredStatements = [];
      for (const stepKey of orderArray) {
        const stmts = caseMap.get(stepKey);
        if (stmts) {
          restoredStatements.push(...stmts);
        }
      }

      // 5. 将整个 WhileStatement 替换为顺序执行语句列表
      path.replaceWithMultiple(restoredStatements);

      // 清除多余的状态变量声明(如 var dispatcher = ...)
      binding.path.remove();
    }
  });

  // 6. 生成还原后的标准代码
  return generate(ast, { jsescOption: { minimal: true } }).code;
}
⚠️ 操作注意事项与避坑提醒
在提取分发序列时,务必注意作用域(Scope)安全。混淆代码中可能存在多个同名
dispatcher 变量,必须使用 path.scope.getBinding(name) 准确绑定到当前循环所在的作用域,切忌在全局进行粗暴的文本正则替换,以免破坏同名的非混淆业务变量。
四、进阶应对:动态状态跳转与虚假分支变种
在面对一些深度混淆或商业加固方案时,分发序列可能并不是简单的静态常量字符串,而是引入了动态跳转:某个 case 内部包含 if (condition) state = 5; else state = 8;,直接由运行时变量驱动状态变更。
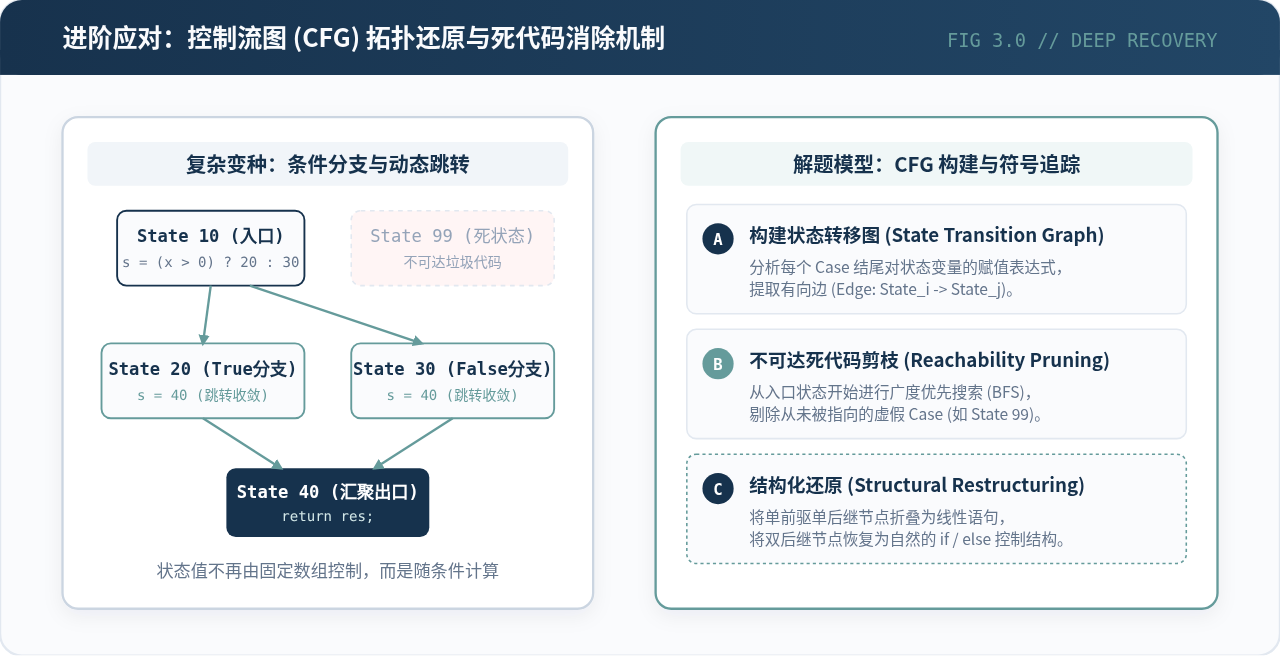
针对这类复杂变种,单纯的静态数组切片无法直接推导,通常需要采取以下两种升级策略:
1. 控制流图(CFG)重构与拓扑排序
将每个 case 视为控制流图的一个节点(Node),分析节点尾部对状态变量的赋值表达式,从而建立节点之间的有向边(Directed Edge):
- 单后继节点:若节点 A 无条件转移到节点 B,直接将 A 与 B 顺序拼接为一个连续基本块;
- 双后继节点:若节点内部存在三元运算符或条件判断,将其恢复为自然的
if (...) { ... } else { ... }语法结构; - 不可达节点消除:从入口状态节点(Initial State)出发进行图遍历(BFS/DFS),所有无法被任何有效边到达的
case均为混淆器注入的虚假死代码(Dead Code),在重构阶段直接丢弃。
2. 动态 Trace 记录真实执行流
若状态计算引入了复杂的按位异或、环境参数加密或哈希查找,静态分析算法的编写成本会急剧增加。此时更具性价比的做法是利用 Node.js 虚拟机沙箱(如 vm2)或浏览器 DevTools 协议,在 switch 入口处植入插桩探针:
// 在 switch 前注入日志探针,动态录制状态转移踪迹
console.log("[CFF-TRACE] State:", dispatcher[stepIndex]);
通过传入测试数据触发目标功能,记录下一组完整的状态运行轨迹。结合动态 Trace 轨迹,我们即可反向指导 AST 引擎仅重组真正被激活的代码路径。
五、技术总结与反混淆决策矩阵
控制流平坦化虽然在视觉和调试层面上造成了极大的阅读阻碍,但其本质并没有改变代码的基本语义单元。在实际进行逆向分析与代码解混淆时,选择恰当的技术路径能够大幅提升工作效率:
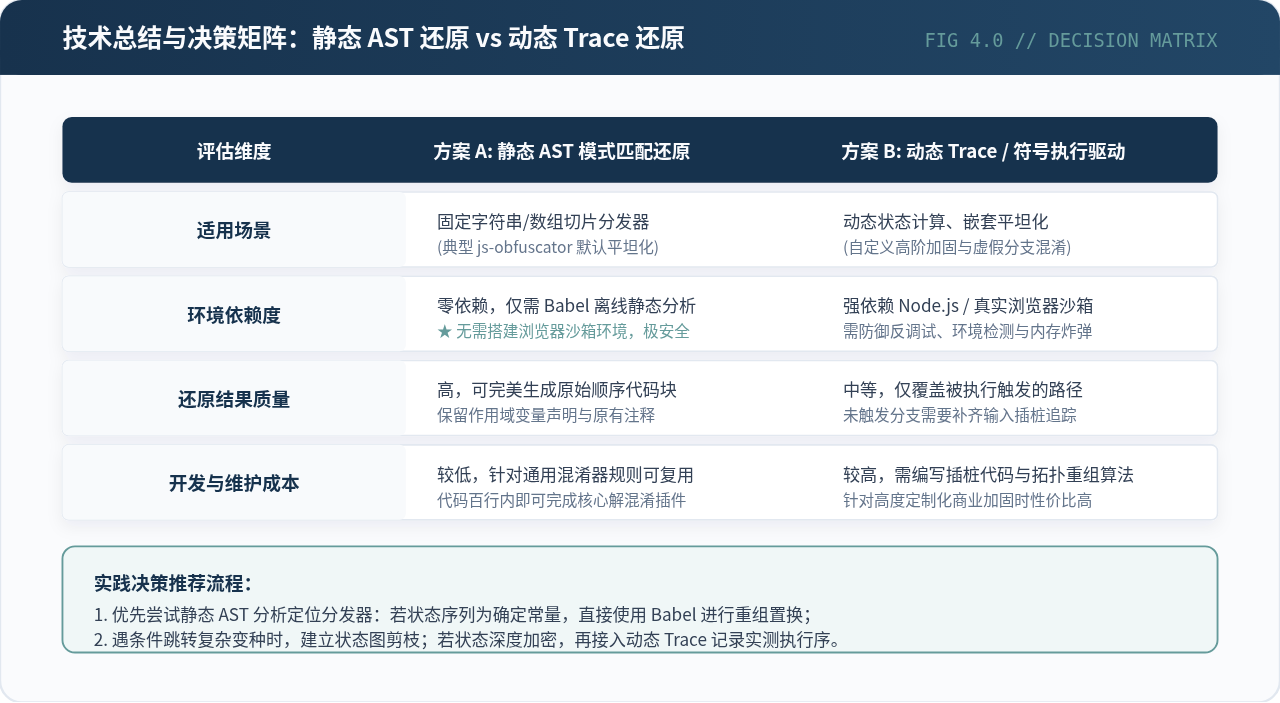
在面对具体反混淆任务时,建议遵循以下工程化流程:
- 第一阶段(特征确认):格式化(Beautify)代码,观察是否存在高频出现的
while-switch循环及分发状态数组; - 第二阶段(静态优先):如果分发数组为静态切片,直接运行上文提供的 Babel AST 脚本进行自动化重组,几毫秒内即可得到清晰的可读源码;
- 第三阶段(变种攻坚):若遇到动态分支或虚假死分支,先利用状态有向图进行可达性剪枝;面对复杂环境依赖时,再辅以动态插桩 Trace,两相结合即可彻底瓦解控制流平坦化防护。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章