

深入解析如何通过代码压缩、智能合并与代码分割、CDN边缘加速三大核心策略提升JavaScript文件加载速度,包含Terser混淆、Brotli预压缩配置、Webpack/Vite拆包及HTTP长效缓存实战。
怎么优化js文件加载速度:压缩、合并与CDN加速
作者:性能诊所
时间:2026-10-30
浏览:534
文章目录
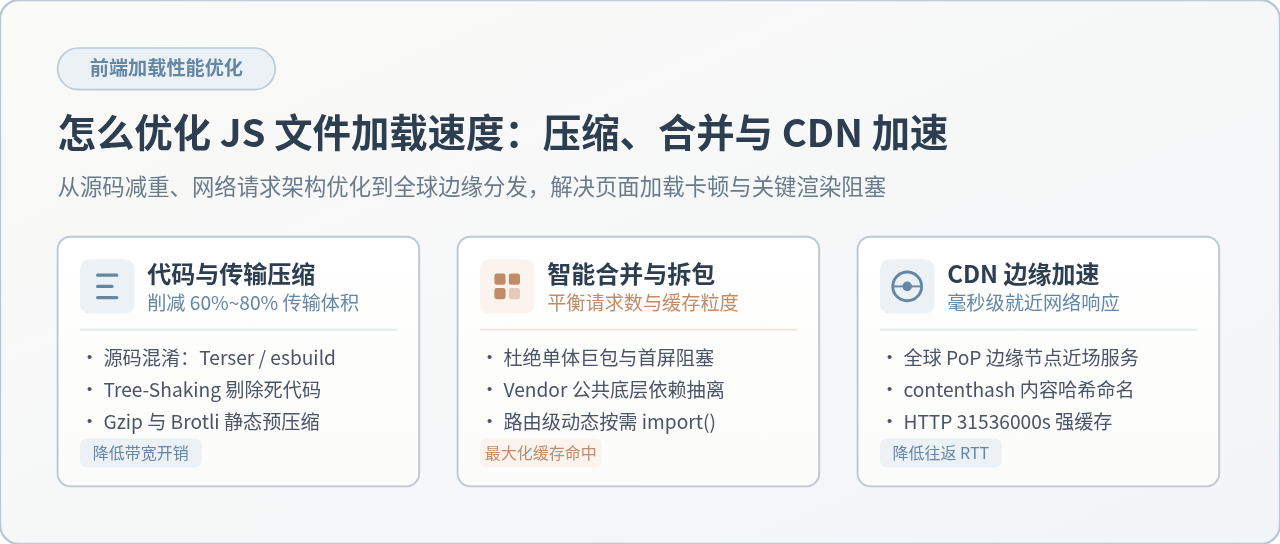
JavaScript 文件加载过慢通常源于三个层面的物理开销:源码体积过大导致的网络下载与语法解析耗时、HTTP 请求组织不合理带来的排队等待与缓存失效、以及用户与服务器物理距离过远产生的多次往返延迟。要系统性提升 JS 文件的加载性能,最有效且通用的路径是从传输体积、请求架构与分发网络三个维度协同优化:使用代码混淆结合传输层 Gzip/Brotli 实现高倍率压缩,运用分层代码拆分(Code Splitting)替代盲目合并以平衡并发与长期缓存,最后借助 CDN 边缘节点实现就近响应与基于内容哈希的长效强缓存。本文将依次剖析这三项技术的运作原理、具体的工程化配置方法及优化效果的验证手段。
一、JavaScript 加载为什么会阻塞页面?
在深入优化之前,必须先理解浏览器处理 JavaScript 的底层机理。浏览器在渲染网页时,主线程会自上而下逐行解析 HTML 并构建 DOM 树。当解析器遇到普通的 <script src="..."></script> 标签时,会默认暂停后续 HTML 的解析,必须等到该脚本文件在网络中彻底下载完毕,并由 JavaScript 引擎完成语法解析(Parse)、编译与执行之后,才会恢复 DOM 树的构建过程。这种现象被称为“解析阻塞”(Parser Blocking)。
这种阻塞带来了两重延时消耗:
- 网络传输消耗:包括客户端向服务器建立 TCP 连接与 TLS 握手的时间、首字节响应时间(TTFB),以及在带宽限制下逐步下载大体积脚本文件的时长。文件体积越大、物理网络距离越远,阻塞时间越长。
- 主线程编译与执行消耗:下载完成后,JavaScript 引擎(如 V8)需要将代码转化为抽象语法树(AST)并编译为字节码或机器码。体积庞大且复杂的代码段会导致主线程长时间处于忙碌状态,期间用户无法与页面进行任何交互,造成肉眼可见的白屏与点击无响应。
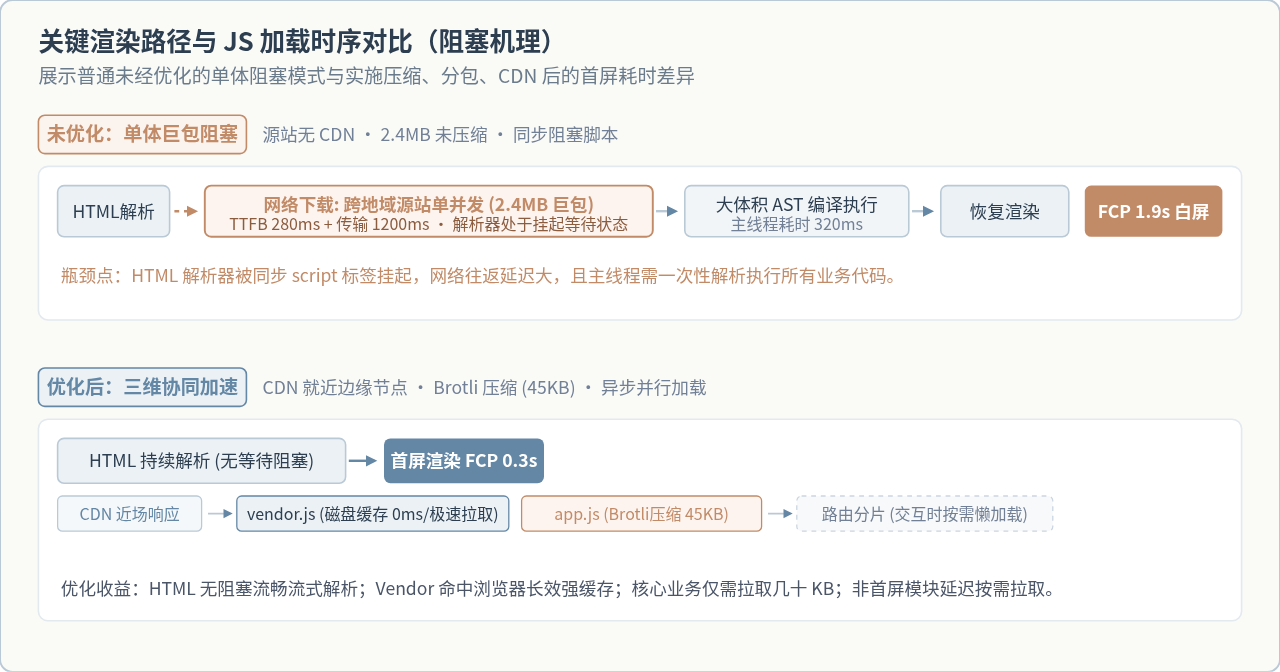
如图 1 所示,优化前的单体大文件让渲染树挂起近 2 秒;而在实施压缩、拆包及 CDN 边缘分发后,关键脚本体积骤降,网络请求就近并行完成,使得关键渲染路径得以流畅流式推进。
二、第一步:代码压缩——消减文件传输体积
代码压缩是所有前端工程化构建中最基础也是收益最直观的环节。要让脚本文件尽可能轻量,通常需要经历两个阶段的压缩:源码级混淆压缩与传输层数据压缩。
1. 源码级混淆压缩(Minification & DCE)
编写代码时为了便于人类阅读和团队协作,源码中包含大量的空格、制表符、换行、中文与英文注释以及语义化的长变量名(例如 currentUserProfileInformation)。对浏览器引擎而言,这些信息在运行期均是无用的语法开销。
源码级压缩工具(如 Terser、esbuild、SWC)通过解析源码的 AST 语法树,执行以下三项核心处理:
- 移除语法冗余:剥离全部注释、空白行与缩进。
- 变量与函数名混淆(Mangling):在保证作用域引用正确的前提下,将数十个字符的长变量名重命名为
a、b、c等单字符,极大缩减字符总量。 - 死代码消除(Dead Code Elimination / Tree-Shaking):结合 ES 模块(ESM)的静态导入导出特性,分析并在产物中剔除从未被调用过的函数、常量与组件分支,同时剥离
process.env.NODE_ENV !== 'production'下的调试逻辑。
在现代化构建工具中,这通常是默认开箱即用的,但了解底层配置有助于排查未生效的情况。以 Webpack 5 为例:
// webpack.config.js
const TerserPlugin = require('terser-webpack-plugin');

module.exports = {
  mode: 'production',
  optimization: {
    minimize: true,
    minimizer: [
      new TerserPlugin({
        terserOptions: {
          compress: {
            drop_console: true, // 生产环境剔除 console 日志
            drop_debugger: true, // 剔除 debugger
            pure_funcs: ['console.log'] // 移除无副作用的日志调用
          },
          format: {
            comments: false // 移除所有注释
          }
        },
        extractComments: false // 不额外抽取 LICENSE.txt
      })
    ]
  }
};
如果使用构建速度更快的 Vite / Rollup,默认内置了基于 Go 语言编写的 esbuild,在保证产物精简的同时大幅加快构建速度:
// vite.config.ts
import { defineConfig } from 'vite';

export default defineConfig({
  build: {
    minify: 'esbuild', // 或选用 'terser'
    target: 'es2018',  // 合理的编译目标平台,避免注入过厚冗余的 Polyfill
    chunkSizeWarningLimit: 500
  }
});
2. 传输层压缩:Gzip 与 Brotli 静态预压缩
源码混淆压缩后的 JS 文件虽然去除了空格与长变量,但它仍然是符合 JavaScript 语法的纯文本文件,内部存在大量高频重复出现的保留字(如 function、return、const 等)。这类文本结构非常契合基于字典替换的无损数据压缩算法。
现代主流压缩算法主要有两类:
- Gzip:基于 DEFLATE 算法(LZ77 与哈夫曼编码的结合),历史悠久,兼容所有浏览器,通常可将 JS 文本体积进一步缩减 60%~75%。
- Brotli(br):由 Google 开发的新一代压缩算法,内置专为 Web 优化的静态常用词典,在相同解压速度下,其压缩率比 Gzip 还要高出 15%~25%。现代浏览器在发送请求时,如果包含请求头
Accept-Encoding: gzip, deflate, br,即可优先接收 Brotli 格式。
关键警惕:动态压缩 vs 静态预压缩
很多团队只在 Nginx 中开启
最佳实践:在本地 CI/CD 构建打包阶段预先生成
很多团队只在 Nginx 中开启
gzip on; 或 brotli on;,让服务器在每个用户请求到达时实时执行压缩计算。对于高并发场景或采用高压缩等级(如 Brotli 11 级)时,实时压缩会剧烈消耗服务器 CPU,导致 TTFB 响应延迟反而飙升。最佳实践:在本地 CI/CD 构建打包阶段预先生成
.gz 和 .br 静态文件(静态预压缩),服务端仅需读取已压缩完成的文件并直接输出。
在前端构建流程中生成预压缩文件:
// vite.config.ts
import { defineConfig } from 'vite';
import viteCompression from 'vite-plugin-compression';

export default defineConfig({
  plugins: [
    // 生成 Gzip 预压缩文件
    viteCompression({
      verbose: false,
      algorithm: 'gzip',
      ext: '.gz',
      threshold: 10240 // 大于 10KB 的文件才压缩
    }),
    // 同时生成更高压缩比的 Brotli 预压缩文件
    viteCompression({
      verbose: false,
      algorithm: 'brotliCompress',
      ext: '.br',
      threshold: 10240
    })
  ]
});
随后在 Nginx 中配置静态模块支持,优先输出预生成的压缩文件:
# nginx.conf (http 或 server 块)
gzip_static on;          # 命中 .gz 文件直接发送
gzip_proxied any;
gzip_types application/javascript text/javascript;

# 若已编译 ngx_brotli 模块
brotli_static on;        # 优先命中 .br 文件
brotli_types application/javascript text/javascript;
三、第二步:合理合并与代码分割——避免极端打包
在文件体积完成压缩后,下一个核心问题是:这些代码应该组织成几个文件提供给浏览器?
1. 为什么“全部合并打成一个包”不再是最佳选择?
在十年前的 HTTP/1.1 时代,浏览器对同一域名的并发 TCP 连接数通常限制为 6 个。如果页面加载三四十个零散的 JS 模块,网络连接就会排队阻塞,因此诞生了将全站代码打包成单个 bundle.js 的做法。
但在现代生产环境中,盲目将所有代码合并为一个单体大包会带来严重缺陷:
- 首屏体积超标:用户仅访问登录页,却被迫下载并解析了后台仪表盘、图表库、复杂富文本编辑器等完全用不到的代码。
- 缓存击穿与雪崩:单体包把基础框架(React/Vue/Lodash)与日常业务代码揉在一起。当开发者仅仅修复了一行文案或某个小组件,整个 2.5MB 的
bundle.[hash].js指纹哈希就会改变,导致所有回访用户本地原本已经缓存的 2.5MB 资源全部失效重跑网络。
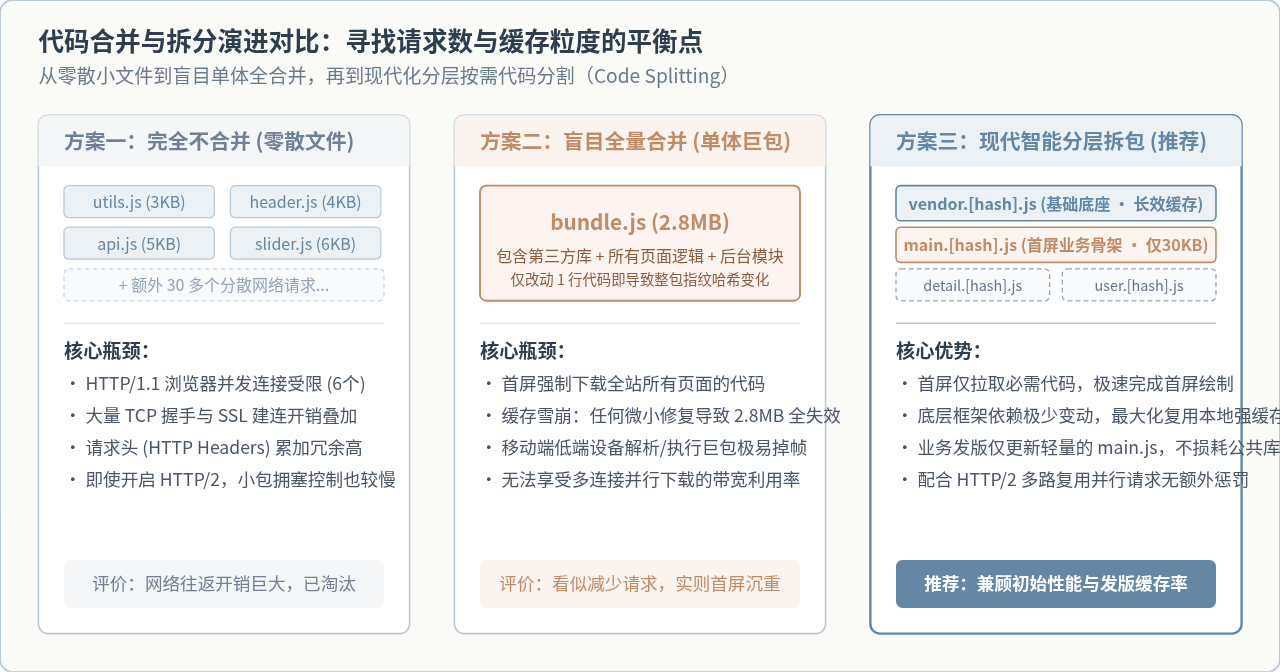
2. 现代拆包策略:分层划分与按需加载(Code Splitting)
合理的合并策略应当是“该拆的拆,该聚的聚”,将资源划分为三个生命周期明确的层次:
- 基础底座层(Vendor Chunk):包含
vue、react、axios等第三方开源库。这些库在几个月甚至一年内都不会变动,将其单独打包并赋予长效缓存,只要用户访问过一次,后续即可永久命中本地磁盘缓存。 - 首屏骨架层(Main / App Chunk):仅包含首屏渲染必需的路由定义、全局状态与核心入口逻辑,通常体积仅有几十 KB,保证首次解析与加载极速完成。
- 异步路由与按需模块(Async Route Chunks):利用 ES2020 的动态导入语法
import('./views/Dashboard.vue')。当用户真正点击跳转到该路由时,前端路由管理器才会动态拉取对应的分片文件,未访问的页面永不提前加载。
在 Webpack 5 中通过 optimization.splitChunks 实现分层抽离:
// webpack.config.js
module.exports = {
  optimization: {
    runtimeChunk: 'single', // 提取 Webpack 运行时清单,避免模块增减影响其他 hash
    splitChunks: {
      chunks: 'all',
      maxInitialRequests: 5, // 首屏并发关键请求数上限
      minSize: 20000,        // 小于 20KB 的模块不单独拆包,避免碎文件膨胀
      cacheGroups: {
        // 核心框架独立打成 vendor
        defaultVendors: {
          test: /[\\/]node_modules[\\/](react|react-dom|vue|vue-router|pinia)[\\/]/,
          name: 'vendor-framework',
          priority: 20,
          reuseExistingChunk: true
        },
        // 其他第三方库归集
        commons: {
          test: /[\\/]node_modules[\\/]/,
          name: 'vendor-libs',
          priority: 10,
          reuseExistingChunk: true
        }
      }
    }
  }
};
四、第三步:CDN 边缘加速与长效缓存——缩短物理传输延迟
即使用户需要下载的代码已经被精简至 50KB,若用户身在新加坡或伦敦,而服务器部署在北京的单机房机房中,光信号在光纤中的物理往返与跨国路由跳转也会产生 200ms~400ms 的网络 RTT 延迟。要抹平物理距离带来的网络等待,必须引入 CDN(Content Delivery Network,内容分发网络)。
1. CDN 边缘就近响应与 Anycast 路由
CDN 的核心机制是在全球各地的数据中心部署成百上千个边缘 PoP(Point of Presence)节点。当用户发起针对静态 JS 资源的请求时:
- 智能 DNS 解析或 Anycast BGP 路由会自动将用户的请求引导至地理距离最近、网络负载最低的边缘服务器。
- 如果该边缘节点已经缓存了该文件(Cache Hit),节点会在几十毫秒内直接将数据返回给客户端,完全无需回源到业务源站。
- 如果边缘节点未命中缓存,由 CDN 内部高速骨干网回源拉取并缓存,后续该区域的所有用户均能共享边缘命中。
2. 文件哈希指纹与“永不变更”的强缓存体系
CDN 能发挥极致效能的前提,是合理的 HTTP 缓存策略配合。在没有文件名哈希(Hash)机制之前,开发者往往不敢对静态资源设置长时间缓存,担心修复 bug 发版后用户浏览器无法感知更新。
现代工程化给出的标准方案是:内容哈希命名 + 差分缓存设计:
- JS 静态文件注入内容哈希(contenthash):构建工具根据文件内容摘要计算出哈希值并追加在文件名中(例如
main.a8b3cd.js)。只要代码没有变动,哈希值永久不变;只要修改了一个字符,哈希值立刻刷新为一个全新的文件名。 - JS 静态文件设置 1 年长效强缓存:由于文件名变了即视为新资源,旧文件直接弃用,因此可以放心为 CDN 与浏览器配置最高时效的强缓存响应头:
Cache-Control: public, max-age=31536000, immutable
其中immutable关键字告知浏览器:在缓存有效期内,即使用户主动点击刷新,也无需向服务器发送 304 验证,直接从本地disk cache瞬间直出。 - 入口 HTML 文件使用协商缓存:
index.html必须配置Cache-Control: no-cache。用户每次进入页面时,浏览器都会先向服务器确认 HTML 是否有更新。一旦有新版本发布,新 HTML 中引用的就是带有新哈希的main.f4e2a1.js,浏览器立刻去拉取新包,而未修改的vendor.99a8b1.js继续从本地磁盘秒级读取。
3. CDN 跨域与安全配置(CORS 与 SRI)
当静态 JS 托管在独立的 CDN 域名(例如 static.yourdomain.com)时,需要补充两项关键配置:
- 跨域头配置:浏览器在收集错误堆栈(
window.onerror)或使用 Web Worker 加载脚本时要求遵循同源策略。CDN 节点必须配置响应头Access-Control-Allow-Origin: *,否则前端监控系统捕获到的将全是一行无意义的Script error.。 - 子资源完整性校验(SRI: Subresource Integrity):如果引用了公共 CDN 托管的第三方脚本库,可以在 HTML 标签上附带
integrity哈希指纹(如integrity="sha384-...")。一旦 CDN 节点遭到恶意劫持或篡改,浏览器在执行前发现哈希不匹配会立即拒绝运行,筑牢安全防线。
五、落地流水线:构建、优化与分发全流程步骤
将上述三种手段串联起来,一个标准的前端工程化发布流程通常包含以下五个阶段:
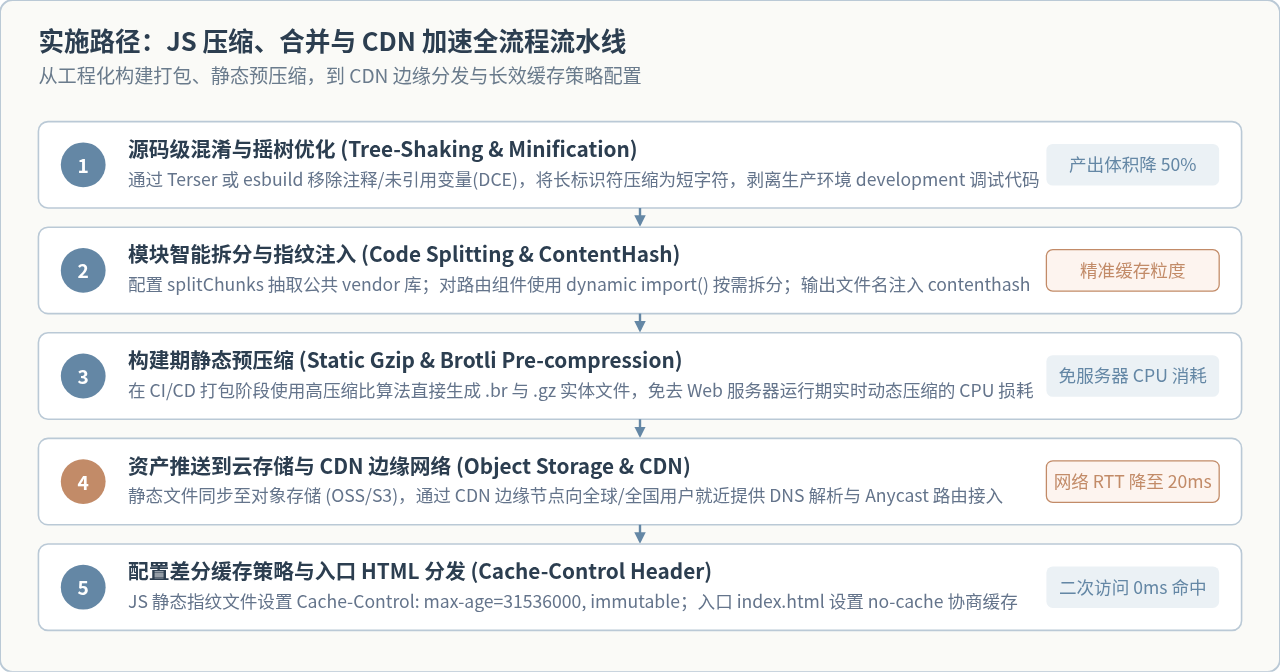
- 第一阶段:执行生产编译混淆。运行构建指令,构建工具解析模块依赖图谱,执行 Tree-Shaking 剪枝,并通过 Terser / esbuild 移除注释并缩短变量名。
- 第二阶段:分层拆包与文件指纹生成。依据配置抽离稳定的
vendor-[hash].js与核心入口main-[hash].js,路由组件生成按需分片。 - 第三阶段:静态预压缩产物生成。在本地或流水线中生成
.br与.gz镜像文件,避免服务器运行时动态压缩浪费算力。 - 第四阶段:静态资源上传云存储与 CDN 预热。通过 CI 脚本将带有哈希的静态文件同步至云对象存储(OSS/S3),并在 CDN 控制台或通过 API 触发关键公共包的节点预热。
- 第五阶段:Web 容器缓存规则生效。在 Nginx / 网关层完成配置,区分 HTML(协商缓存)与 JS(1 年强缓存 + brotli_static 开启),完成最终闭环。
六、效果验证:如何确认优化真正生效?
配置完成后,需要通过标准浏览器开发者工具进行实操验证:
- 检查传输压缩标识:打开 Chrome DevTools 的 Network 面板,勾选
Use large request rows。观察 JS 文件的 Size 列:上方数字代表网络实际传输字节数(Transfer Size),下方数字代表浏览器解压后的真实代码字节数(Resource Size)。若传输大小仅为资源大小的 20%~30%,并在 Response Headers 中看到Content-Encoding: br或gzip,证明传输压缩生效。 - 检查 CDN 节点与响应延迟:在 Response Headers 中检查是否存在 CDN 服务商的命中标识(如
X-Cache: HIT from ...或cf-cache-status: HIT)。查看 Waterfall(瀑布流)中的 Waiting for server response (TTFB),正常 CDN 边缘节点响应通常在 10ms~30ms 以内。 - 验证长效强缓存:关闭
Disable cache选项,对页面执行常规刷新(F5)。此时所有带有哈希的 JS 文件状态码应显示为200 OK (from disk cache)或(from memory cache),Time 耗时显示为0 ms,表明完全没有产生网络流量。 - 检查代码覆盖率(Coverage 工具):在 DevTools 的 More tools 中打开 Coverage 面板录制首屏。若首屏下载的 JS 中未执行的红色比率低于 25%,说明代码分割良好;若红色未执行代码超过 60%,说明存在首屏未拆解的大型非必要依赖,需进一步优化。
七、常见误区与避坑指南
在实际项目落地过程中,以下几个典型误区极易导致优化适得其反:
- 误区一:代码拆得越细越好。虽然 HTTP/2 支持多路复用,但如果把几百个微小函数分别拆成上百个几百字节的
.js文件,过多的小包会导致压缩算法无法跨函数利用字典匹配(压缩率急剧下降),且浏览器解析器初始化每个微脚本均有固定开销。首屏的关键请求数量建议控制在 4 到 8 个 为宜。 - 误区二:在 Nginx 中开启 Brotli 11 级动态压缩。Brotli 算法支持 1~11 级,其中 11 级的计算复杂度极高。如果未做静态预压缩而在网关层动态开启 11 级,服务器 CPU 会瞬间被拉满到 100%,导致首字节延迟上升数秒。若只能使用动态压缩,建议选择 CPU 与压缩率均衡的 4~6 级。
- 误区三:HTML 入口文件配置了强缓存。如果不小心给
index.html也加上了max-age=31536000,用户浏览器将永远读取本地旧的 HTML,导致新发布的带有新哈希的 JS 文件永远无法被用户拉取到,只能等待本地缓存过期或用户手动强制清理浏览器数据。 - 误区四:忽略了未加 defer/async 的第三方监控与统计脚本。自身构建的应用 JS 优化得再好,若在
<head>中直接同步引入了一个第三方统计或广告 SDK,其漫长下载同样会死锁浏览器的关键渲染路径。所有非首屏关键脚本必须声明defer或async属性。
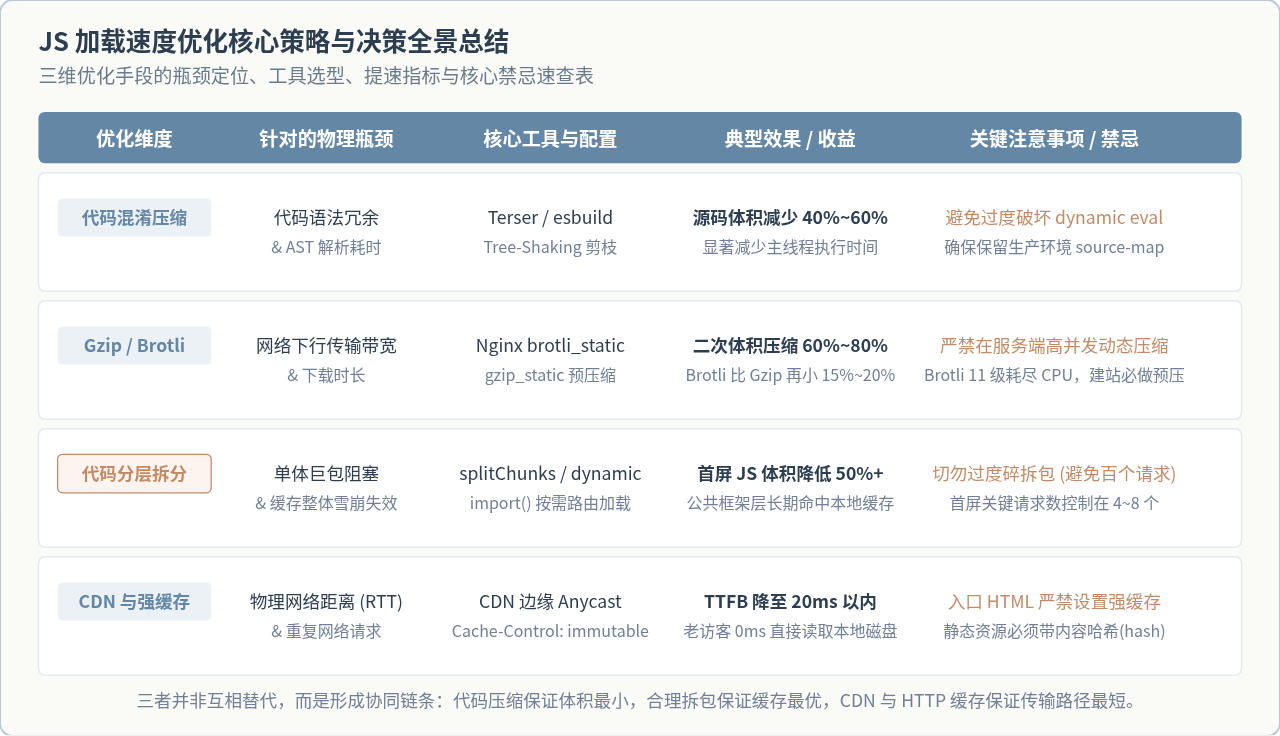
八、核心策略总结与选型速查
JavaScript 性能优化并非单一工具的单打独斗,而是从工程构建到网络传输各环节环环相扣的系统工程。压缩关注“单个文件的物理质量”,合并与拆分关注“请求集合的结构与缓存生命周期”,CDN 加速则解决“物理世界的长途跋涉”。三者协同,方能实现首屏毫秒级渲染与极佳的用户交互体验。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章